

Il y a trois ans, Viktor Tarnavski et Alexei Milovidov de Yandex sur scène HighLoad++ , ont montré à quel point ClickHouse est bon et comment il fonctionne sans ralentir. Et sur la scène voisine se trouvait Alexandre Zaïtsev avec parlant de la migration vers ClickHouse une autre base de données analytique, concluant que ClickHouse, bien sûr, c'est bon, mais pas très pratique. Quand en 2016, l'entreprise LifeStreet, où travaillait alors Alexandre, a migré son système d'analytique multi-pétabytes vers ClickHouse, c'était un captivant « chemin de briques jaunes », rempli de dangers inconnus — ClickHouse il ressemblait alors à un champ de mines.
Trois ans plus tard, ClickHouse c'est devenu beaucoup mieux — pendant ce temps, Alexandre a fondé l'entreprise Altinity, qui non seulement aide à migrer vers ClickHouse des dizaines de projets, mais améliore également le produit lui-même avec ses collègues de Yandex. Maintenant, ClickHouse ce n'est plus une promenade insouciante, mais ce n'est plus non plus un champ de mines.
Alexandre travaille sur des systèmes distribués depuis 2003, développant de grands projets sur MySQL, Oracle. et VerticaLors de la HighLoad++ 2019, Alexandre, l'un des pionniers de l'utilisation de ClickHouse, a expliqué ce qu'est cette base de données aujourd'hui. Nous apprendrons les principales caractéristiques ClickHouse: ce qui la distingue des autres systèmes et dans quels cas elle est plus efficace à utiliser. À l'aide d'exemples, nous explorerons les pratiques récentes et validées par des projets pour la construction de systèmes sur ClickHouse.
Rétrospective : que s'est-il passé il y a 3 ans
Il y a trois ans, nous avons migré l'entreprise LifeStreet sur ClickHouse d'une autre base de données analytique, et la migration de l'analytique du réseau publicitaire se déroulait comme suit :
- Juin 2016. Nous avons lancé notre projet dans OpenSource, est apparu ClickHouse et c'est là que tout a commencé ;
- Août. Proof Of Concept : un grand réseau publicitaire, une infrastructure et 200-300 téraoctets de données ;Octobre. Les premières données de production ;
- Décembre. Charge produit complète — 10-50 milliards d'événements par jour.
- Juin 2017. Migration réussie des utilisateurs vers
- , 2,5 pétaoctets de données sur un cluster de 60 serveurs. ClickHouseAu cours de la migration, nous avons de plus en plus compris que
c'est un bon système, avec lequel il est agréable de travailler, mais c'est un projet interne de Yandex. Donc, il y a des nuances : Yandex s'occupera d'abord de ses propres clients internes, puis de la communauté et des besoins des utilisateurs externes, et ClickHouse, à l'époque, ne correspondait pas au niveau entreprise dans de nombreux domaines fonctionnels. C'est pourquoi, en mars 2017, nous avons fondé la société Altinity, afin de créer ClickHouse — c'est un excellent système, avec lequel il est agréable de travailler, mais c'est un projet interne de l'entreprise Yandex. Il y a donc des nuances : Yandex s'occupera d'abord de ses propres commanditaires internes, puis des communautés et des besoins des utilisateurs externes. À l'époque, ClickHouse n'atteignait pas encore le niveau entreprise dans plusieurs domaines fonctionnels. C'est pourquoi, en mars 2017, nous avons fondé la société Altinity pour faire ClickHouse encore plus rapide et pratique non seulement pour Yandex, mais aussi pour d'autres utilisateurs. Et maintenant, nous :
- formons et aidons à construire des solutions sur ClickHouse de manière à ce que les clients n'aient pas d'échecs, et pour que la solution fonctionne finalement ;
- Nous assurons un support 24/7 ClickHouse-d'installations ;
- Nous développons nos propres projets écologiques ;
- Nous nous engageons activement dans le ClickHouse, répondant aux demandes des utilisateurs qui souhaitent voir certaines fonctionnalités.
Et bien sûr, nous aidons à la migration vers ClickHouse avec MySQL, Vertica, Oracle, Greenplum, Redshift et d'autres systèmes. Nous avons participé à divers types de migrations, et toutes ont été réussies.
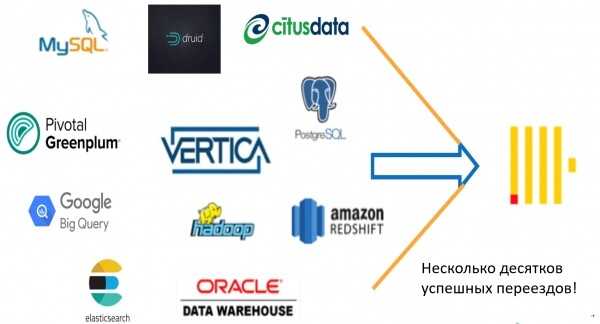
Pourquoi migrer vers ClickHouse
Ne ralentit pas ! C'est la principale raison. ClickHouse — une base de données très rapide pour différents scénarios :
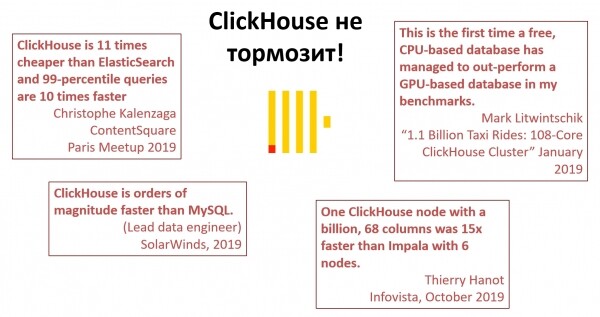
Citations aléatoires de personnes qui travaillent depuis longtemps avec ClickHouse.
Scalabilité. Avec une autre base de données, vous pouvez atteindre de bonnes performances sur un seul serveur, mais ClickHouse vous pouvez mettre à l'échelle non seulement verticalement, mais aussi horizontalement, simplement en ajoutant des serveurs. Tout ne fonctionne pas aussi parfaitement qu'on le souhaiterait, mais ça fonctionne. Vous pouvez faire croître le système avec la croissance de l'entreprise. Il est important que nous ne soyons pas limités par une solution pour le moment et qu'il y ait toujours du potentiel pour se développer.
Portabilité. Il n'y a pas d'attachement à quelque chose de spécifique. Par exemple, avec Amazon Redshift il est difficile de migrer ailleurs. Mais ClickHouse peut être installé sur votre ordinateur portable, serveur, déployé dans le cloud, aller dans Kubernetes — il n'y a pas de restrictions sur l'exploitation de l'infrastructure. C'est pratique pour tout le monde, et c'est un grand avantage dont ne peuvent se vanter de nombreuses autres bases de données similaires.
Flexibilité. ClickHouse ne s'arrête pas à quelque chose de spécifique, comme Yandex.Metrica, mais se développe et est utilisé dans de plus en plus de projets et d'industries différents. Il peut être élargi en ajoutant de nouvelles fonctionnalités pour résoudre de nouvelles tâches. Par exemple, il est considéré comme inapproprié de stocker des logs dans une base de données, donc cela a donné lieu à Elasticsearch. Mais grâce à la flexibilité de ClickHouse, il est également possible de stocker des logs, et c'est souvent même mieux que dans Elasticsearch — dans ClickHouse cela nécessite 10 fois moins de matériel.
Gratuit Open Source. Il n'est nécessaire de payer pour rien. Vous n'avez pas à négocier pour obtenir la permission d'installer le système sur votre ordinateur portable ou serveur. Il n'y a pas de paiements cachés. En même temps, aucune autre technologie de base de données Open Source ne peut rivaliser en vitesse avec ClickHouse. MySQL, MariaDB, Greenplum — tous sont beaucoup plus lents.
Communauté, dynamisme et fun. ClickHouse une excellente communauté : des meetups, des chats et Alexey Milovidov, qui nous enthousiasme tous avec son énergie et son optimisme.
Migration vers ClickHouse
Pour passer à ClickHouse d'autre chose, il faut juste trois choses :
- Comprendre les limitations ClickHouse et pour quoi il n'est pas adapté.
- Exploiter les avantages de la technologie et ses points forts.
- Expérimenter. Même en comprenant comment cela fonctionne ClickHouse, il n'est pas toujours possible de prédire quand cela sera plus rapide, quand cela sera plus lent, quand ce sera mieux et quand ce sera pire. Alors, essayez.
Le problème de la migration
Il y a juste un « mais » : si vous migrez vers ClickHouse d'autre chose, alors généralement quelque chose ne se passe pas comme prévu. Nous nous sommes habitués à certaines pratiques et éléments qui fonctionnent dans notre base de données préférée. Par exemple, toute personne travaillant avec des bases de données SQLconsidère un ensemble de fonctionnalités comme essentielles :
- transactions ;
- contraintes ;
- consistance ;
- index ;
- UPDATE/DELETE ;;
- NULLs ;;
- millisecondes ;
- conversions automatiques de types ;
- jointures multiples ;
- partitions arbitraires ;
- outils de gestion de cluster.
Cet ensemble est requis, mais il y a trois ans, ClickHouse il n'y avait aucune de ces fonctionnalités ! Maintenant, il reste moins de la moitié de ce qui n'était pas encore réalisé : transactions, contraintes, consistance, millisecondes et conversions de types.
Et surtout — certains standards et pratiques ne fonctionnent pas ou fonctionnent différemment de ce à quoi nous sommes habitués. Tout ce qui apparaît dans ClickHouse est conforme à « ClickHouseClickHouse way», c'est-à-dire que les fonctionnalités diffèrent des autres bases de données. Par exemple :Les index ne sélectionnent pas, mais sautent.
- ne sont pas synchrones, mais asynchrones.
- UPDATE/DELETE ; Il y a des jointures multiples, mais il n'y a pas de planificateur de requêtes. Comment sont-elles alors exécutées, cela reste un mystère pour les gens du monde des bases de données.
- Les scénarios ClickHouse
En 1960, le mathématicien américain d'origine hongroise
Wigner E. P. a écrit un article intitulé « The unreasonable effectiveness of mathematics in the natural sciences» sur le fait que le monde qui nous entoure est étrangement bien décrit par des lois mathématiques. Les mathématiques sont une science abstraite, et les lois physiques exprimées sous forme mathématique ne sont pas triviales, etil a souligné que c'est très étrange. a écrit un article intitulé « De mon point de vue,
c'est tout aussi étrange. En reformulant Wigner, on pourrait dire : l'incroyable efficacité ClickHouse dans une grande variété d'applications analytiques ! ClickHouse Par exemple, prenons
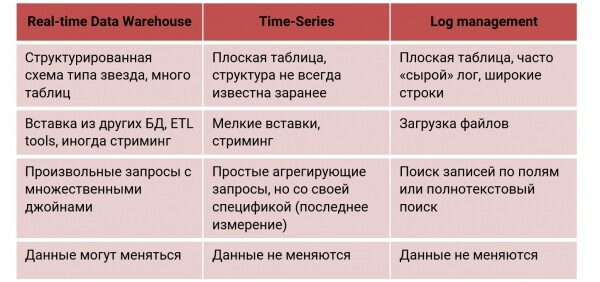
un entrepôt de données en temps réel. Real-Time Data Warehouse, dans lequel les données sont chargées pratiquement de manière continue. Nous souhaitons recevoir des requêtes avec un délai de seconde. S'il vous plaît — utilisons ClickHouse, car c'est pour ce scénario qu'il a été conçu. ClickHouse c'est exactement ainsi qu'il est utilisé non seulement dans le web, mais aussi dans l'analyse marketing et financière, AdTech, ainsi que dans Fraud detection. Dans Entrepôt de données en temps réel une structure complexe de type « étoile » ou « flocon » est utilisée, avec de nombreuses tables de JOIN (parfois multiples), et les données sont généralement stockées et modifiées dans certains systèmes.
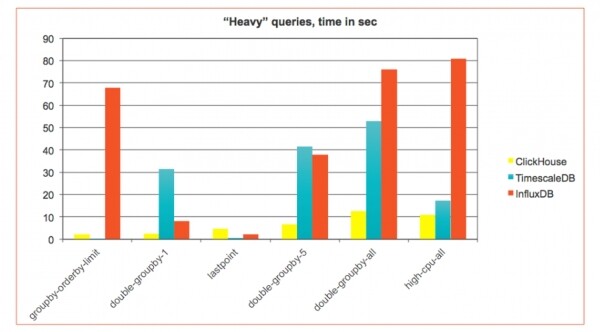
Prenons un autre scénario — Séries temporelles: surveillance des dispositifs, des réseaux, statistiques d'utilisation, Internet des objets. Ici, nous rencontrons des événements assez simples ordonnés dans le temps. ClickHouse ce qui n'était pas initialement conçu pour cela, mais a bien fonctionné, donc de grandes entreprises l'utilisent ClickHouse comme stockage pour les informations de surveillance. Pour étudier si ClickHouse convient aux séries temporelles, nous avons fait un benchmark basé sur l'approche et les résultats InfluxDB et TimescaleDB — bases de données spécialisées séries temporelles , même sans optimisation pour de telles tâches, dépasse aussi sur d'autres terrains : , que ClickHousenormalement utilisée une table étroite — quelques petites colonnes. La surveillance peut générer beaucoup de données, — des millions d'enregistrements par seconde, — et elles arrivent généralement par petites insertions (
Dans séries temporelles streaming). C'est pourquoi un autre scénario d'insertion est nécessaire, et les requêtes elles-mêmes — avec leur spécificité.en temps réel Gestion des logs
. Le stockage des logs dans la base de données — c'est généralement mauvais, mais danscela peut se faire avec quelques commentaires, comme décrit ci-dessus. Beaucoup d'entreprises utilisent ClickHouse exactement pour cela. Dans ce cas, une table large et plate est utilisée, où nous stockons les logs en entier (par exemple, sous forme de ClickHouse ), soit nous les découpons en morceaux. Les données sont généralement chargées par gros lots (fichiers), et nous cherchons selon un certain champ. JSONPour chacune de ces fonctions, des bases de données spécialisées sont généralement utilisées.
un seul peut faire tout cela et si bien qu'il les dépasse en performance. Examinons maintenant en détail ClickHouse le scénario, et comment bien le « préparer » séries temporelles pour ce scénario. ClickHouse Séries temporelles
En ce moment, c'est le scénario principal pour lequel
est considéré comme une solution standard. ClickHouse Séries temporelles séries temporelles — un ensemble d'événements ordonnés dans le temps, représentant les changements d'un processus au fil du temps. Par exemple, cela peut être la fréquence cardiaque sur une journée ou le nombre de processus dans un système. Tout ce qui donne des intervalles temporels avec des mesures spécifiques est séries temporelles:
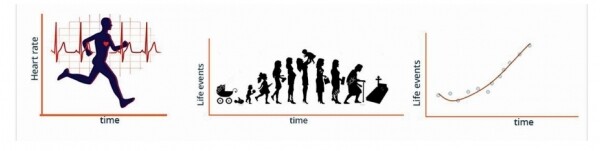
La plupart de ce type d'événements provient de la surveillance. Il peut s'agir non seulement de la surveillance web, mais aussi d'appareils réels : voitures, systèmes industriels, IoT, productions ou taxis sans conducteur, dans le coffre desquels Yandex place déjà ClickHouse-serveur.
Par exemple, il existe des entreprises qui collectent des données des navires. Toutes les quelques secondes, des capteurs d'un porte-conteneurs envoient des centaines de mesures différentes. Les ingénieurs les étudient, construisent des modèles et essaient de comprendre à quel point le navire est utilisé efficacement, car un porte-conteneurs ne doit pas rester inactif une seconde. Toute inactivité signifie une perte d'argent, il est donc crucial de prévoir la route de manière à ce que les arrêts soient minimaux.
On observe actuellement une croissance des bases de données spécialisées qui mesurent séries temporelles. Sur le site DB-Engines de différentes manières, et elles peuvent être consultées par types :
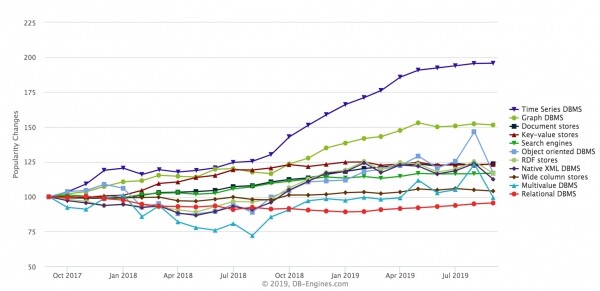
Le type à la croissance la plus rapide est time-series.Cependant, les bases de données graphiques croissent, mais time-series.elles croissent plus rapidement depuis ces dernières années. Parmi les exemples typiques de cette catégorie de bases de données, nous trouvons InfluxDB, Prometheus, KDB, TimescaleDB (basée sur PostgreSQL), des solutions de Amazon. ClickHouse où il peut également être utilisé, et il est utilisé. Voici quelques exemples publics.
Un des pionniers est la société CloudFlare (CDN-fournisseur). Ils surveillent leur CDN via ClickHouse (DNS-requêtes, . L'augmentation de la performance de Nginx est due à l'utilisation d'une architecture asynchrone gérée par événements, contrairement à un modèle multithread. Cela, combiné à un haut niveau de parallélisme, permet à Nginx de traiter les requêtes avec une mémoire minimale. Cela fait de Nginx une excellente solution pour les serveurs web, qu'il s'agisse de gros ou de petits volumes de trafic. Nginx est une solution mature et entièrement documentée, permettant une configuration facile selon vos besoins. Les développeurs utilisent également Nginx comme proxy inverse pour-requêtes) avec une énorme charge — 6 millions d'événements par seconde. Tout passe par Kafka, envoyé à ClickHouse, qui permet de voir en temps réel les tableaux de bord des événements dans le système.
Comcast — l'un des leaders des télécommunications aux États-Unis : internet, télévision numérique, téléphonie. Ils ont créé un système de gestion similaire CDN dans le cadre de Open Source du projet Apache Traffic Control pour travailler avec leurs énormes données. ClickHouse est utilisé comme backend pour l'analyse.
Percona ils ont intégré ClickHouse dans leur PMM,pour stocker la surveillance de divers MySQL.
Exigences spécifiques
Les bases de données de type time-series ont des exigences spécifiques.
- Insertion rapide depuis de nombreux agents.Nous devons insérer des données très rapidement depuis plusieurs flux. ClickHouse le fait bien car toutes ses insertions ne bloquent pas. Toute insert — c'est un nouveau fichier sur le disque, et de petites insertions peuvent être mises en mémoire tampon de différentes manières. Dans ClickHouse il est préférable d'insérer des données par gros paquets plutôt qu'une ligne à la fois.
- Schéma flexible. Il y a séries temporelles nous ne connaissons généralement pas la structure des données avec certitude. On peut construire un système de surveillance pour une application spécifique, mais alors il est difficile de l'utiliser pour une autre application. Pour cela, un schéma plus flexible est nécessaire. ClickHouse, ce qui permet de le faire, même si c'est une base fortement typée.
- Stockage efficace et « oubli » des données. En général, dans séries temporelles un volume colossal de données, il faut donc les stocker de manière maximale efficace. Par exemple, dans InfluxDB une bonne compression — c'est son atout principal. Mais au-delà du stockage, il faut aussi savoir « oublier » des données anciennes et effectuer un downsampling — calcul automatique des agrégats.
- Requêtes rapides sur des données agrégées. Parfois, il est intéressant de voir les 5 dernières minutes avec une précision à la milliseconde, mais pour des données mensuelles, une granularité minute ou seconde peut ne pas être nécessaire — des statistiques globales suffisent. Un tel support est indispensable, sinon une requête sur 3 mois prendra beaucoup de temps même dans ClickHouse.
- Des requêtes du type «dernier point, à date du». Ce sont des requêtes typiques pour séries temporelles regardons la dernière mesure ou l'état du système à un moment donné t. Pour les bases de données, ce ne sont pas les requêtes les plus agréables, mais il faut aussi savoir les exécuter.
- « Assemblage » de séries temporelles. séries temporelles — il s'agit d'une série temporelle. S'il y a deux séries temporelles, souvent il faut les assembler et les corréler. Ce n'est pas pratique à faire dans toutes les bases de données, surtout avec des séries temporelles non alignées : ici — un ensemble de points temporels, là — d'autres. On peut calculer des moyennes, mais s'il y a tout de même un trou, c'est problématique.
Regardons comment ces exigences sont respectées dans ClickHouse.
Configuration
Dans ClickHouse un schéma pour séries temporelles peut être réalisé de plusieurs manières, selon le degré de régularité des données. On peut construire un système sur des données régulières, lorsque toutes les métriques sont connues à l'avance. Par exemple, c'est ce que a fait CloudFlare avec la surveillance CDN — c'est un système bien optimisé. On peut construire un système plus général qui surveille l'ensemble de l'infrastructure, différents services. Dans le cas de données irrégulières, nous ne savons pas ce que nous surveillons à l'avance — et c'est probablement le cas le plus général.
Données régulières. Colonnes. Le schéma est simple – des colonnes avec les types nécessaires :
CREATE TABLE cpu (
  created_date Date DEFAULT today(),
  created_at DateTime DEFAULT now(),
  time String,
  tags_id UInt32,
  /* join to dim_tag */
  usage_user Float64,
  usage_system Float64,
  usage_idle Float64,
  usage_nice Float64,
  usage_iowait Float64,
  usage_irq Float64,
  usage_softirq Float64,
  usage_steal Float64,
  usage_guest Float64,
  usage_guest_nice Float64
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
C'est une table ordinaire qui surveille une certaine activité liée à la charge du système (user, system, idle, nice). Simple et pratique, mais peu flexible. Si nous voulons un schéma plus flexible, nous pouvons utiliser des tableaux.
Données irrégulières. Tableaux:
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  )
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);

SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FROM ...
Structure Imbriqué — ce sont deux tableaux : metrics.name et metrics.value. Ici, nous pouvons stocker des données de surveillance arbitraires, comme un tableau de noms et un tableau de valeurs à chaque événement. Pour une optimisation ultérieure, au lieu d'une telle structure, nous pouvons en créer plusieurs. Par exemple, une pour float-la valeur, une autre pour int-la valeur, parce que int nous voulons stocker de manière plus efficace.
Mais cette structure est plus difficile à interroger. Il faudra utiliser une construction spéciale et des fonctions spécifiques pour extraire d'abord l'indice, puis le tableau :
SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FROM ...Mais cela fonctionne quand même assez rapidement. Une autre façon de stocker des données irrégulières est de le faire par lignes.
Données irrégulières. Lignes. Dans cette méthode traditionnelle, sans tableaux, les noms et les valeurs sont stockés ensemble. Si un appareil envoie 5 000 mesures à la fois, 5 000 lignes sont générées dans la base de données :
CREATE TABLE cpu_rlc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metric_name LowCardinality(String),
  metric_value Float64
) ENGINE = MergeTree(created_date, (metric_name, tags_id, created_at), 8192);


SELECT
    maxIf(metric_value, metric_name = 'usage_user'),
    ...
FROM cpu_r
WHERE metric_name IN ('usage_user', ...)
ClickHouse ce qui gère cela — il a des extensions spéciales ClickHouse SQL. Par exemple, maxIf — une fonction spéciale qui calcule le maximum d'une métrique sous certaines conditions. On peut écrire plusieurs de telles expressions dans une seule requête et calculer immédiatement la valeur pour plusieurs métriques.
Comparons les trois approches :
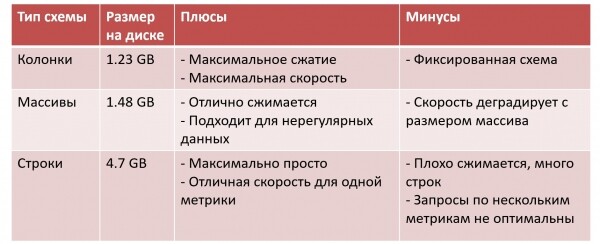
Ici, j'ai ajouté « Taille des données sur le disque » pour un ensemble de données de test. Dans le cas des colonnes, nous avons la plus petite taille des données : compression maximale, vitesse optimale des requêtes, mais nous devons tout fixer en même temps.
Dans le cas des tableaux, c'est un peu moins bien. Les données se compressent toujours bien et nous pouvons stocker un schéma irrégulier. Mais ClickHouse — une base de données en colonnes, et lorsque nous commençons à tout stocker dans un tableau, elle se transforme en base de données de type ligne, et nous payons pour la flexibilité avec de l'efficacité. Pour chaque opération, il faudra lire tout le tableau en mémoire, puis trouver l'élément désiré — et si le tableau grandit, la vitesse diminue.
Dans l'une des entreprises qui utilise cette approche (par exemple, ), les tableaux sont découpés en morceaux de 128 éléments. Les données de plusieurs milliers de métriques d'un volume de 200 To de données/jour ne sont pas stockées dans un seul tableau, mais dans 10 ou 30 tableaux avec une logique spéciale pour le stockage.
L'approche la plus simple — avec des chaînes de caractères. Mais les données se compressent mal, la taille de la table devient grande, et lorsque les requêtes touchent plusieurs métriques, ClickHouse fonctionne de manière non optimale.
Schéma hybride
Supposons que nous avons choisi un schéma avec un tableau. Mais si nous savons que la majorité de nos tableaux de bord montrent uniquement les métriques utilisateur et système, nous pouvons matérialiser ces métriques en colonnes au niveau de la table comme suit :
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  ),
  usage_user Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_user')],
  usage_system Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_system')]
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Lors de l'insertion ClickHouse il les comptera automatiquement. Cela permet de combiner l'agréable à l'utile : le schéma est flexible et général, mais nous avons extrait les colonnes les plus utilisées. Je précise que cela n'a pas nécessité de modifier l'insertion et ETL, qui continue à insérer des tableaux dans la table. Nous avons simplement fait ALTER TABLE, ajouté quelques colonnes et nous avons obtenu un schéma hybride et plus rapide, que l'on peut utiliser immédiatement.
Codecs et compression
Pour séries temporelles il est important de savoir à quel point vous emballez bien les données, car le volume d'informations peut être très grand. Dans ClickHouse il existe un ensemble d'outils pour obtenir un effet de compression de 1:10, 1:20, voire plus. Cela signifie que des données non compressées d'un volume de 1 To sur le disque occupent entre 50 et 100 Go. Une taille plus petite est bénéfique, car les données peuvent être lues et traitées plus rapidement.
Pour atteindre un niveau élevé de compression, ClickHouse il prend en charge les codecs suivants :
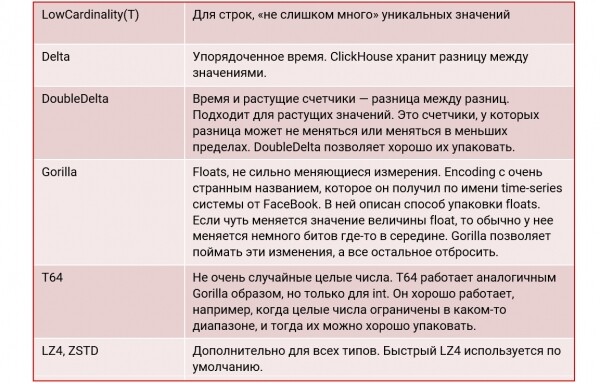
Exemple de tableau :
CREATE TABLE benchmark.cpu_codecs_lz4 (
    created_date Date DEFAULT today(),
    created_at DateTime DEFAULT now() Codec(DoubleDelta, LZ4),
    tags_id UInt32,
    usage_user Float64 Codec(Gorilla, LZ4),
    usage_system Float64 Codec(Gorilla, LZ4),
    usage_idle Float64 Codec(Gorilla, LZ4),
    usage_nice Float64 Codec(Gorilla, LZ4),
    usage_iowait Float64 Codec(Gorilla, LZ4),
    usage_irq Float64 Codec(Gorilla, LZ4),
    usage_softirq Float64 Codec(Gorilla, LZ4),
    usage_steal Float64 Codec(Gorilla, LZ4),
    usage_guest Float64 Codec(Gorilla, LZ4),
    usage_guest_nice Float64 Codec(Gorilla, LZ4),
    additional_tags String DEFAULT ''
)
ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Ici, nous définissons le codec DoubleDelta dans un cas, et dans l'autre — Gorilla, et nous ajoutons impérativement encore LZ4 de la compression. En conséquence, la taille des données sur le disque diminue considérablement :
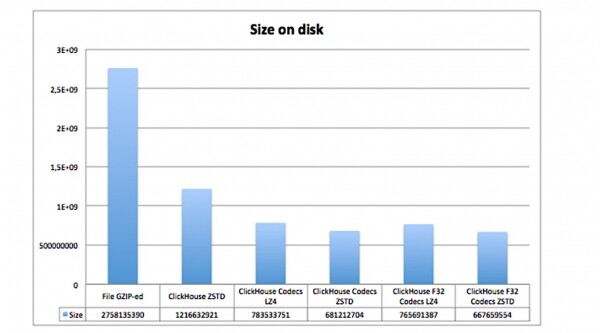
Voici combien d'espace occupent les mêmes données, mais avec différents codecs et compressions :
- dans un fichier GZIP sur le disque ;
- dans ClickHouse sans codecs, mais avec compression ZSTD ;
- dans ClickHouse avec codecs et compression LZ4 et ZSTD.
Il est évident que les tables avec codecs occupent beaucoup moins d'espace.
La taille compte
Il est également important le bon type de données :
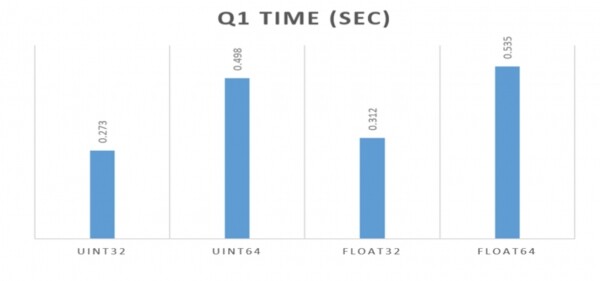
Dans tous les exemples ci-dessus, j'ai utilisé Float64. Mais si nous avions choisi Float32, cela aurait été encore mieux. Cela a été bien démontré par les gars de Percona dans l'article lié ci-dessus. Il est essentiel d'utiliser le type le plus compact adapté à la tâche : ce n'est pas seulement une question de taille sur le disque, mais aussi de rapidité des requêtes. ClickHouse il est très sensible à cela.
Si vous pouvez utiliser int32 au lieu de int64, attendez-vous à un gain de performance presque double. Les données occupent moins de mémoire, et toute l'arithmétique fonctionne beaucoup plus rapidement. ClickHouse à l'intérieur, c'est un système très typé, qui utilise au maximum toutes les capacités fournies par les systèmes modernes.
Agrégation et Vues matérialisées
L'agrégation et les vues matérialisées permettent de créer des agrégats pour différents cas d'utilisation :
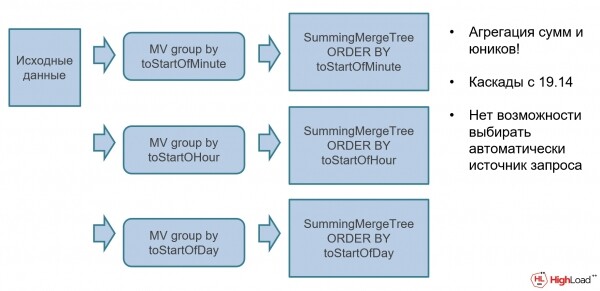
Par exemple, vous pouvez avoir des données source non agrégées, sur lesquelles il est possible de superposer différentes vues matérialisées avec une sommation automatique via un moteur spécial. SummingMergeTree (SMT). SMT — est une structure de données agrégée spéciale qui calcule les agrégats automatiquement. Les données brutes sont insérées dans la base de données, elles sont automatiquement agrégées, et il est immédiatement possible d'utiliser des tableaux de bord.
TTL — «oublie» les anciennes données
Comment «oublier» les données qui ne sont plus nécessaires ? ClickHouse peut le faire. Lors de la création de tables, il est possible de spécifier TTL des expressions : par exemple, que les données par minute sont conservées pendant un jour, les données journalières pendant 30 jours, et que les données hebdomadaires ou mensuelles ne sont jamais touchées :
CREATE TABLE aggr_by_minute
…
TTL time + interval 1 day

CREATE TABLE aggr_by_day
…
TTL time + interval 30 day

CREATE TABLE aggr_by_week
…
/* pas de TTL */
Multi-niveau — nous séparons les données par disques
En développant cette idée, les données peuvent être stockées dans ClickHouse différents endroits. Supposons que nous voulions conserver les données chaudes de la dernière semaine sur un disque local très rapide, SSDalors que les données plus historiques sont stockées ailleurs. Dans ClickHouse cette configuration, c'est possible :
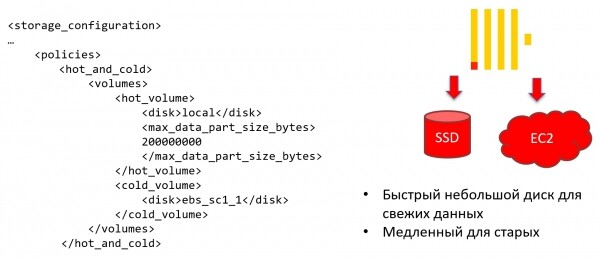
Il est possible de configurer la politique de stockage (storage policy) de sorte que ClickHouse les données soient automatiquement transférées dans un autre stockage lorsque certaines conditions sont atteintes.
Mais ce n'est pas tout. Au niveau d'une table spécifique, il est possible de définir des règles sur quand les données passent effectivement à un stockage froid. Par exemple, les données restent sur un disque très rapide pendant 7 jours, et tout ce qui est plus ancien est transféré sur un disque lent. Cela est avantageux car cela permet de maintenir le système à des performances maximales tout en contrôlant les coûts et en n'investissant pas des ressources dans des données froides :
CREATE TABLE
...
TTL date + INTERVAL 7 DAY TO VOLUME 'cold_volume',
    date + INTERVAL 180 DAY DELETE
Fonctionnalités uniques ClickHouse
Presque tout dans ClickHouse possède ces «petits plus», mais ils sont atténués par l'exclusivité — ce qui n'est pas présent dans d'autres bases de données. Par exemple, voici quelques-unes des fonctionnalités uniques ClickHouse:
- Tableaux. Il y a ClickHouse un excellent support pour les tableaux, ainsi que la possibilité d'effectuer des calculs complexes sur ceux-ci.
- Structures de données agrégées. C'est l'un des «atouts» ClickHouse. Bien que les gars de Yandex disent que nous ne voulons pas agréger des données, tout le monde agrège dans ClickHouse, car c'est rapide et pratique.
- Vues matérialisées. Avec des structures de données agrégées, les vues matérialisées permettent de faire un résumé pratique en temps réel .
- SQL de ClickHouse. C'est une extension du langage SQL avec quelques fonctionnalités supplémentaires et exclusives que l'on trouve uniquement dans ClickHouse. Auparavant, cela ressemblait à une extension d'une part, et à un inconvénient d'autre part. Maintenant, presque tous les inconvénients par rapport à SQL 92 ont été éliminés, c'est maintenant seulement une extension.
- Lambda– expressions. En existe-t-il encore dans d'autres bases de données?
- ML- support. Cela existe dans différentes BDs, de manière mieux ou moins bien suivant le cas.
- Code ouvert. Nous pouvons étendre ClickHouse ensemble. Actuellement, il y a environ 500 contributeurs, et ce nombre continue d'augmenter. ClickHouse Il existe de nombreuses façons ingénieuses de réaliser la même chose avec des requêtes.
Par exemple, il est possible de retourner la dernière valeur d'une table de trois manières différentes pour
Dans ClickHouse (il y en a aussi une quatrième, mais elle est encore plus exotique). CPU La première montre à quel point il est pratique de faire des requêtes dans
quand vous souhaitez vérifier ce qui ClickHouse se trouve dans une sous-requête. C'est ce qui me manquait personnellement dans d'autres BDs. Si je veux comparer quelque chose avec une sous-requête, dans d'autres BDs, on ne peut comparer que des scalaires, et pour plusieurs colonnes, il faut écrire tuple il est possible d'utiliser un tuple : JOIN. Il y a ClickHouse SELECT * FROM cpu WHERE (tags_id, created_at) IN (SELECT tags_id, max(created_at) FROM cpu GROUP BY tags_id)
La deuxième méthode fait la même chose, mais utilise la fonction agrégéeargMax SELECT argMax(usage_user), created_at), argMax(usage_system), created_at), ... FROM cpu:
il existe plusieurs dizaines de fonctions d'agrégation, et si l'on utilise des combinateurs, on obtenez environ mille selon les lois combinatoires. Dans ClickHouse ArgMax est l'une des fonctions qui calcule la valeur maximale : la requête renvoie la valeur usage_user , à laquelle la valeur maximale est atteinte, created_at:
SELECT now() as created_at,
       cpu.*
  FROM (SELECT DISTINCT tags_id from cpu) base
  ASOF LEFT JOIN cpu USING (tags_id, created_at)
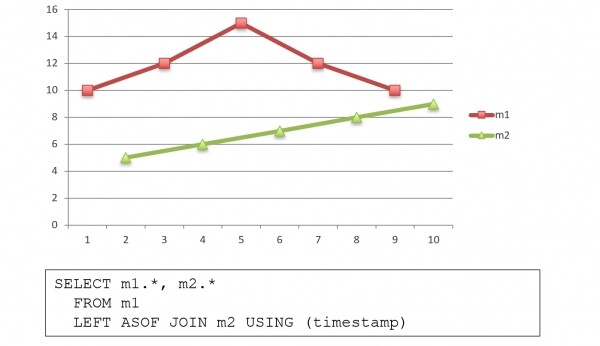
ASOF JOIN – la « jointure » de lignes à différents moments. C'est une fonction unique pour les bases de données, que l'on trouve également dans kdb+. Si deux séries chronologiques ont des moments différents, ASOF JOIN elle permet de les décaler et de les joindre dans une seule requête. Pour chaque valeur d'une série chronologique, on trouve la valeur la plus proche dans l'autre, et elles sont renvoyées sur une seule ligne :
Fonctions analytiques
Dans la norme SQL-2003 on peut écrire ainsi :
SÉLECTIONNER origine,
       horodatage,
       horodatage -LAG(horodatage, 1) OVER (PARTITIONNER PAR origine ORDRE PAR horodatage) COMME durée,
       horodatage -MIN(horodatage) OVER (PARTITIONNER PAR origine ORDRE PAR horodatage) COMME startseq_duration,
       ROW_NUMBER() OVER (PARTITIONNER PAR origine ORDRE PAR horodatage) COMME séquence,
       COUNT() OVER (PARTITIONNER PAR origine ORDRE PAR horodatage) COMME nb
  DE maTable
COMMANDER PAR origine, horodatage;
Dans ClickHouse cela ne peut pas être — il ne supporte pas la norme SQL-2003 et, probablement, ne le fera jamais. Au lieu de cela, il est ClickHouse d'usage d'écrire comme ça :
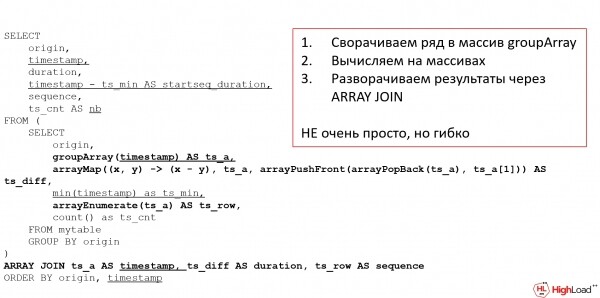
J'ai promis des lambda – les voilà !
C'est l'analogue d'une requête analytique dans la norme SQL-2003: il calcule la différence entre deux horodatage, durée, numéro de séquence — tout ce que nous considérons généralement comme des fonctions analytiques. Dans ClickHouse nous les considérons à travers des tableaux : d'abord nous plions les données en tableau, après cela nous faisons tout ce que nous voulons sur le tableau, puis nous le déroulons à nouveau. Ce n'est pas très pratique, cela demande de l'affection pour la programmation fonctionnelle, au minimum, mais c'est très flexible.
Fonctions spéciales
De plus, dans ClickHouse il y a beaucoup de fonctions spécialisées. Par exemple, comment déterminer combien de sessions se déroulent simultanément ? Une tâche typique pour la surveillance – déterminer la charge maximum d'une seule requête. Dans ClickHouse il existe une fonction spéciale pour cet objectif :
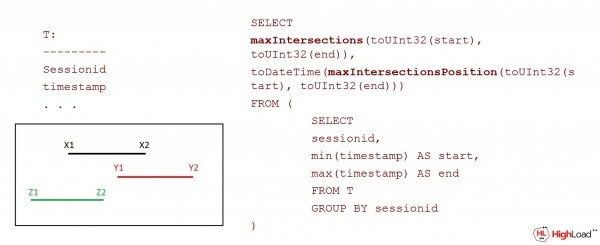
En général, pour de nombreux objectifs dans ClickHouse, il y a des fonctions spéciales :
- runningDifference, runningAccumulate, neighbor;
- sumMap(clé, valeur);
- timeSeriesGroupSum(uid, horodatage, valeur);
- timeSeriesGroupRateSum(uid, horodatage, valeur);
- skewPop, skewSamp, kurtPop, kurtSamp;
- WITH FILL / WITH TIES;
- simpleLinearRegression, stochasticLinearRegression.
Ce n'est pas une liste complète de fonctions, il y en a environ 500-600. Indice : toutes les fonctions dans ClickHouse sont disponibles dans la table système (toutes ne sont pas documentées, mais toutes sont intéressantes) :
sélectionner * de system.functions commander par nomClickHouse contient beaucoup d'informations sur lui-même, y compris tables de log, journal_requête, journal de traçage, journal des opérations sur les blocs de données (part_log), journal des métriques, et le journal système, qui est généralement écrit sur disque. Le journal des métriques est séries temporelles dans ClickHouse sur le ClickHouse: La BD elle-même peut jouer le rôle de séries temporelles base de données, ainsi, « dévorant » elle-même.
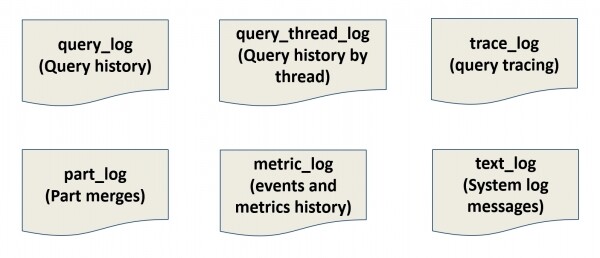
C'est aussi une chose unique — puisque nous faisons bien le travail pour séries temporelles, pourquoi ne pouvons-nous pas stocker tout ce qui est nécessaire en nous-mêmes ? Nous n'avons pas besoin de Prometheus, nous stockons tout en nous. Nous avons connecté Grafana et nous nous surveillons nous-mêmes. Cependant, si ClickHouse tombe, alors nous ne verrons pas pourquoi, — donc généralement, on ne fait pas cela.
Un grand cluster ou de nombreux petits ClickHouse
Qu'est-ce qui est mieux — un grand cluster ou plusieurs petits ClickHouse ? L'approche traditionnelle pour DWH — c'est un grand cluster, où des schémas sont alloués pour chaque application. Nous sommes allés voir l'administrateur de base de données — donnez-nous un schéma, et il nous l'a fourni :
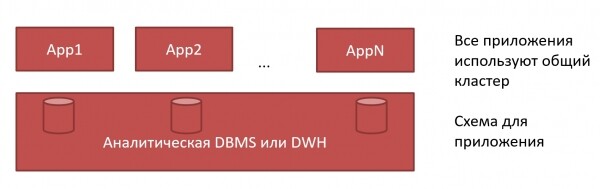
Dans ClickHouse cela peut être fait autrement. Chaque application peut avoir son propre ClickHouse:
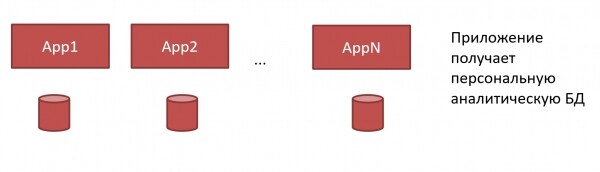
Nous n'avons plus besoin d'un grand monstre DWH et des administrateurs peu conciliants. Nous pouvons fournir à chaque application son propre ClickHouse, et le développeur peut le faire lui-même, puisque ClickHouse c'est très simple à installer et ne nécessite pas une administration complexe :
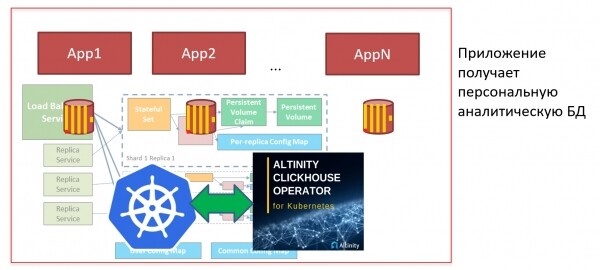
Mais si nous en avons beaucoup ClickHouse, et qu'il faut souvent l'installer, nous voulons automatiser ce processus. Pour cela, nous pouvons par exemple utiliser Kubernetes et clickhouse-l'opérateur. Dans Kubernetes ClickHouse peut être installé « d'un clic » : je peux appuyer sur un bouton, lancer le manifeste et la base est prête. Je peux immédiatement créer un schéma, commencer à charger des métriques, et dans 5 minutes, j'ai déjà un tableau de bord prêt Grafana. C'est aussi simple que ça !
Quel est le résultat ?
Alors, ClickHouse — c'est :
- Rapidement. C'est bien connu.
- Tout simplement. Un peu controversé, mais je pense que c'est difficile à apprendre, facile à combattre. Une fois que vous comprenez comment ClickHouse cela fonctionne, tout devient très simple.
- Universel. Il convient à divers scénarios : DWH, Time Series, Log Storage. Mais ce n'est pas une base de données OLTP, donc ne tentez pas d'y effectuer des insertions et des lectures courtes. C'est intéressant
- . Probablement, ceux qui travaillent avec, ont vécu de nombreux moments intéressants tant dans le bon que dans le mauvais sens. Par exemple, une nouvelle version est sortie, tout a cessé de fonctionner. Ou quand vous avez travaillé sur une tâche pendant deux jours, mais après une question dans le chat Telegram, la tâche a été résolue en deux minutes. Ou lors de la conférence, dans la présentation d'Alesha Milovidov, une capture d'écran de ClickHousea interrompu la diffusion ClickHouse . Ce genre de choses arrive constamment et rend notre vie avec HighLoad++brillante et intéressante ! ClickHouse La présentation peut être visionnée
La tant attendue rencontre des développeurs de systèmes à forte charge se tiendra .
les 9 et 10 novembre à Skolkovo. Ce sera enfin une conférence en présentiel (bien que dans le respect de toutes les mesures de précaution), car l'énergie de HighLoad++ ne peut pas être emballée dans le format en ligne. Pour la conférence, nous trouvons et vous montrons des cas sur les capacités maximales des technologies : HighLoad++ a été, est et sera le seul endroit où l'on peut en deux jours comprendre comment Facebook, Yandex, VKontakte, Google et Amazon sont organisés.
Pour la conférence, nous recherchons et vous montrons des cas sur les possibilités maximales des technologies : HighLoad++ a été, est et sera le seul endroit où, en deux jours, vous pouvez découvrir comment fonctionnent Facebook, Yandex, VKontakte, Google et Amazon.
Depuis nos réunions sans interruption depuis 2007, nous nous rencontrerons cette année pour la 14ème fois. Au cours de cette période, la conférence a décuplé, l'année dernière, l'événement phare de l'industrie a rassemblé 3339 participants, 165 intervenants, et 16 pistes simultanées.
L'année dernière, nous avons prévu 20 bus, 5280 litres de thé et de café, 1650 litres de boissons aux fruits et 10200 bouteilles d'eau. De plus, 2640 kilogrammes de nourriture, 16000 assiettes et 25000 gobelets. Au fait, avec l'argent récolté grâce au recyclage du papier, nous avons planté 100 jeunes chênes 🙂Vous pouvez acheter des billets , recevoir des nouvelles de la conférence — , et discuter — sur tous les réseaux sociaux : , , et .
Source : habr.com
