

Salut, Habr !
Dans dans cet article, nous avons discuté de la nécessité de générer des nombres aléatoires pour des participants qui ne se font pas confiance, des exigences qui sont posées à de tels générateurs de nombres aléatoires, et nous avons examiné deux approches pour leur mise en œuvre.
Dans cette partie de l'article, nous examinerons en détail une autre approche qui utilise des signatures seuil.
Un peu de cryptographie
Pour comprendre comment fonctionnent les signatures seuil, il faut connaître un peu les bases de la cryptographie. Nous utiliserons deux concepts : les scalaires, ou simplement des nombres que nous désignerons par des lettres minuscules (x, y) et les points sur une courbe elliptique, que nous désignerons par des lettres majuscules.
Pour comprendre les bases des signatures seuil, il n'est pas nécessaire de comprendre comment fonctionnent les courbes elliptiques, à part quelques notions de base :
Les points sur une courbe elliptique peuvent être additionnés et multipliés par un scalaire (la multiplication par un scalaire sera désignée par xG, bien que la notation Gx soit aussi souvent utilisée dans la littérature). Le résultat de l’addition et de la multiplication par un scalaire est un point sur la courbe elliptique.
Sachant seulement le point G et son produit avec le scalaire xG il n'est pas possible de calculer x.
Nous utiliserons également le concept de polynôme p(x) de degré k-1. En particulier, nous utiliserons la propriété suivante des polynômes : si nous connaissons la valeur p(x) pour n'importe quel k différent x (et nous n'avons plus d'informations sur p(x)), nous pouvons calculer p(x) pour n'importe quel autre x.
Il est intéressant de noter que pour tout polynôme p(x) et un certain point sur la courbe G, connaissant la valeur p(x)G pour n'importe quel k de valeurs différentes x, il est également possible de calculer p(x)G pour n'importe quel x.
Ces informations suffisent pour explorer les détails de fonctionnement des signatures seuil et comment les utiliser pour générer des nombres aléatoires.
Un générateur de nombres aléatoires basé sur des signatures seuil
Supposons que n des participants veulent générer un nombre aléatoire, et nous voulons que la participation de n'importe quel k d'entre eux soit suffisante pour générer un nombre, mais que des attaquants contrôlant k-1 ou moins de participants ne puissent prédire ou influencer le nombre généré.
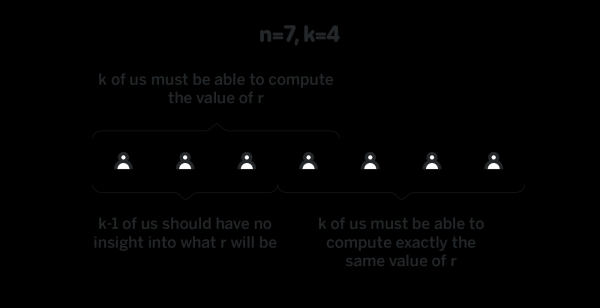
Supposons qu'il existe un polynôme p(x) de degré k-1, tel que le premier participant connaisse p(1), le deuxième sache p(2), et ainsi de suite (nle -ème sait p(n)). Supposons également que pour un certain point prédéfini G tout le monde sache p(x)G pour toutes les valeurs x. Nous allons appeler p(i) «composante privée» i-e participant (car seul i-e participant la connaît), et p(i)G «composante publique» i-e participant (car tous les participants la connaissent). Comme vous vous en souvenez, savoir p(i)G n'est pas suffisant pour reconstruire p(i).
Créer un tel polynôme de sorte que seul i-e participant et personne d'autre connaisse sa composante privée – c'est la partie la plus complexe et intéressante du protocole, et nous l'examinerons ci-dessous. Supposons qu'un tel polynôme existe, et que tous les participants connaissent leurs composantes privées.
Comment pouvons-nous utiliser un tel polynôme pour générer un nombre aléatoire ? Pour commencer, nous avons besoin d'une chaîne qui n'a pas encore été utilisée comme entrée pour le générateur. Dans le cas de la blockchain, le hachage du dernier bloc h est un bon candidat pour une telle chaîne. Supposons que les participants souhaitent créer un nombre aléatoire en utilisant h comme graine. D'abord, les participants convertissent h en un point sur la courbe en utilisant une fonction prédéfinie :
H = scalarToPoint(h)
Ensuite, chaque participant i calcule et publie Hi = p(i)H, ce qu'ils peuvent faire car ils connaissent p(i) et H. La divulgation Hi ne permet pas aux autres participants de reconstruire la composante privée i-e participant, et donc un ensemble de composantes privées peut être utilisé d'un bloc à l'autre. Ainsi, l'algorithme coûteux de création de polynôme, décrit ci-dessous, doit être exécuté une seule fois.
Lorsque k les participants ont dévoilé Hi = p(i)H, tout le monde peut calculer Hx = p(x)H pour tous x grâce à la propriété des polynômes que nous avons discutée dans la section précédente. À ce moment, tous les participants calculent H0 = p(0)H, et c'est le nombre aléatoire résultant. Notez que personne ne connaît p(0), et par conséquent, la seule façon de calculer p(0)H – est l'interpolation p(x)H, ce qui n'est possible que lorsque k les valeurs p(i)H sont connues. La divulgation d'un nombre moindre p(i)H ne fournit aucune information sur p(0)H.
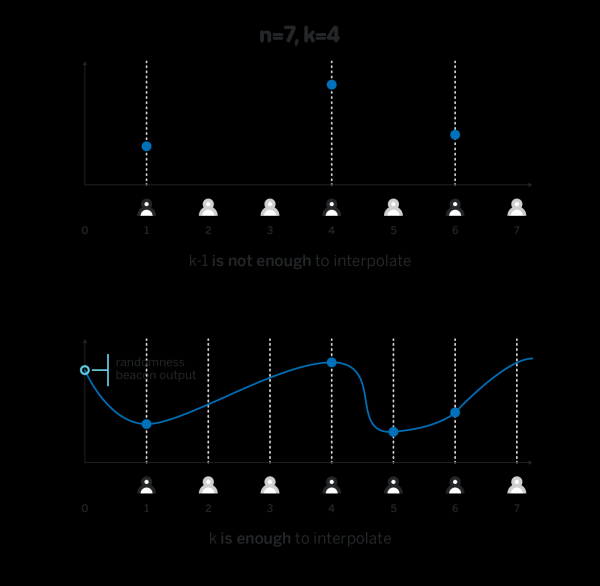
Le générateur ci-dessus possède toutes les propriétés que nous souhaitons : les attaquants ne contrôlant que k-1 participants, ou moins, n'ont aucune information ni influence sur la sortie, tandis que tous les k participants peuvent calculer le nombre résultant, et tout sous-ensemble de k participants parviendra toujours au même résultat pour la même graine.
Il y a un problème que nous avons habilement évité ci-dessus. Pour que l'interpolation fonctionne, il est important que la valeur Hi publiée par chaque participant i soit réellement égale à p(i)H. Comme personne d'autre que i-ième participant ne sait p(i), personne d'autre que i--ième participant ne peut vérifier que Salut a été réellement calculé correctement, et sans aucune preuve cryptographique de la validité Hi un attaquant peut publier n'importe quelle valeur comme Salut, et influencer arbitrairement la sortie du générateur de nombres aléatoires:
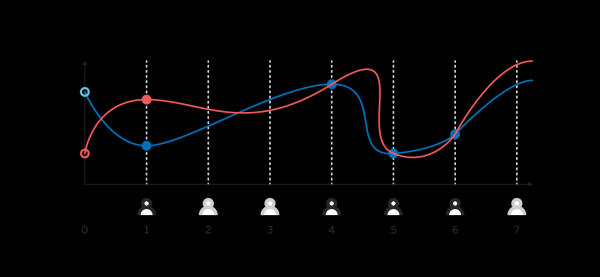 Différentes valeurs H_1 envoyées par le premier participant conduisent à différents H_0 résultants
Il existe au moins deux façons de prouver la validité Hi, nous les examinerons après avoir abordé la génération du polynôme.
Génération du polynôme
Dans la section précédente, nous avons supposé qu'il existe un tel polynôme p(x) de degré k-1 que le participant i sait p(i), et personne d'autre n'a aucune information sur cette valeur. Dans la section suivante, nous aurons également besoin que pour un certain point prédéterminé G tout le monde sache p(x)G pour tous x.
Dans cette section, nous supposerons que chaque participant dispose localement d'une certaine clé privée xi, telle que la clé publique correspondante est bien connue Xi.
Un protocole possible de génération de polynômes est le suivant :
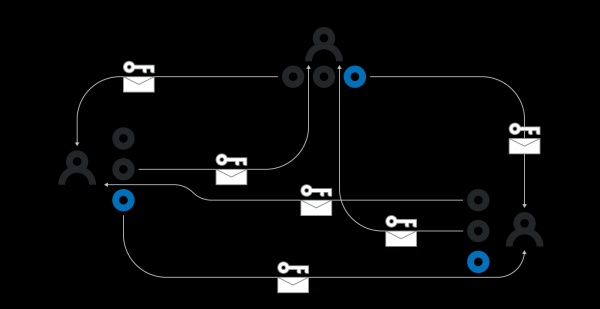
Chaque participant i crée localement un polynôme arbitraire pi(x) de degré k-1. Ils envoient ensuite à chaque participant j la valeur pi(j) chiffrée avec la clé publique Xj. Ainsi, seul i--ième et j--ième participant sait pi(j). Le participant i annonce également publiquement pi(j)G pour tous j à partir de 1 à k inclusivement.
Tous les participants utilisent un certain consensus pour choisir k les participants dont les polynômes seront utilisés. Comme certains participants peuvent être hors ligne, nous ne pouvons pas attendre que tous n les participants publient leurs polynômes. Le résultat de cette étape est un ensemble Z composé d'au moins k polynômes créés à l'étape (1).
Les participants s'assurent que les valeurs qui leur sont connues pi(j) correspondent aux pi(j)G annoncés publiquement. Après cette étape, il ne doit rester que des polynômes pour lesquels les valeurs transmises en privé Z calculent leur composante privée pi(j) correspondent aux pi(j)G annoncés publiquement.
Chaque participant j p(j) comme la somme i(j) pour tous p. Chaque participant calcule également toutes les valeurs i dans Zpi(x)G pour tous i p(x)G i(j) pour tous p(x) – dans Z.
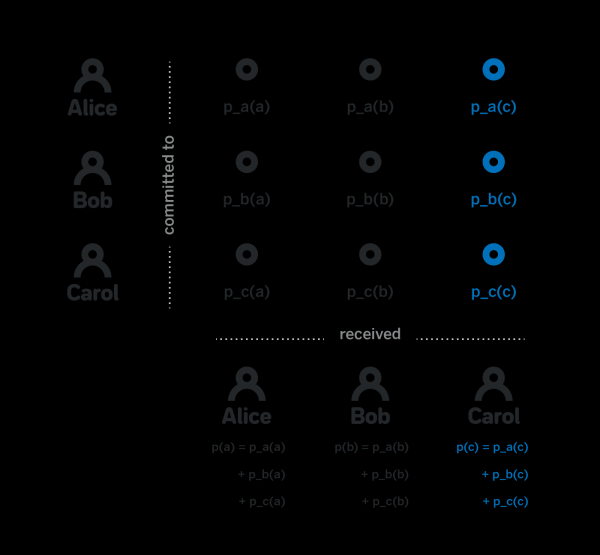
Veuillez noter que c'est réellement un polynôme de degré k-1, car c'est la somme de plusieurs i(x), chacun d'eux étant un polynôme de degré pi(x), chacun d'eux étant un polynôme de degré k-1. Ensuite, notez que bien que chaque participant j sait p(j), ils n'ont aucune information sur p(x) pour x ≠ j. En effet, pour calculer cette valeur, ils doivent connaître toutes les pi(x), et tant que le participant j ne connaît pas au moins un des polynômes choisis, ils n'ont pas assez d'informations sur p(x).
C'est tout le processus de génération de polynôme qui était nécessaire dans la section précédente. Les étapes 1, 2 et 4 ci-dessus ont une réalisation assez évidente. En revanche, l'étape 3 n'est pas si triviale.
Concrètement, nous devons pouvoir prouver que les pi(j) correspondent réellement à ceux publiés. pi(j)G annoncés publiquement. Si nous ne pouvons pas le prouver, un attaquant i peut envoyer des données corrompues à la place de pi(j) au participant, jet le participant j ne pourra pas obtenir la véritable valeur de pi(j), et ne pourra pas calculer sa composante privée..
Il existe un protocole cryptographique qui permet de créer un message supplémentaire, proofi(j), de sorte que tout participant, ayant une certaine valeur e, ainsi que proofi(j) et pi(j)G, peut localement s'assurer que e est bien pi(j), chiffré avec la clé du participant j. Malheureusement, la taille d'une telle preuve est incroyablement grande, et étant donné qu'il est nécessaire de publier O(nk) de telles preuves, il ne sera pas possible de les utiliser à cette fin.
Au lieu de prouver que pi(j) correspond à pi(j)G, nous pouvons, dans le protocole de génération de polynôme, consacrer une très longue période, pendant laquelle tous les participants vérifient les informations chiffrées obtenues, pi(j), et si le message déchiffré ne correspond pas au public pi(j)G, ils publient une preuve cryptographique que le message chiffré reçu est erroné. Prouver que le message ne correspond à pi(G) est beaucoup plus simple que de prouver qu'il correspond. Il convient de noter que cela nécessite que chaque participant apparaisse sur le réseau au moins une fois pendant le temps alloué pour créer de telles preuves, et repose sur l'hypothèse que s'ils publient cette preuve, elle atteindra tous les autres participants dans ce même temps imparti.
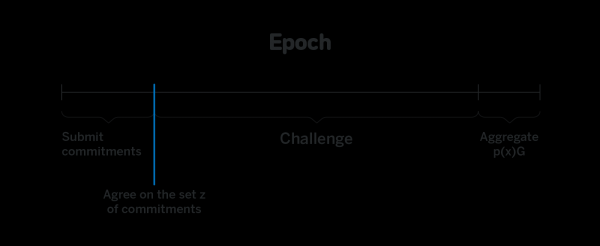
Si un participant n'est pas apparu sur le réseau pendant cette période, et qu'il avait réellement au moins une composante incorrecte, ce participant ne pourra pas participer à la génération ultérieure de nombres. Cependant, le protocole fonctionnera toujours s'il y a au moins k participants, qui ont soit seulement obtenu des composants valides, soit ont eu le temps de laisser une preuve d'invalidité.
Preuves de validité H_i
La dernière partie à discuter est comment prouver la validité des publications Hi, à savoir que Hi = p(i)H, sans divulgation p(i).
Rappelons que les valeurs H, G, p(i)G sont publiques et connues de tous. L'opération d'obtention p(i) connaissant p(i)G et G s'appelle logarithme discret, ou dlog, et nous voulons prouver que :
dlog(p(i)G, G) = dlog(Hi, H)
sans divulgation p(i). Des constructions pour de telles preuves existent, par exemple.
Avec une telle construction, chaque participant avec Salut envoie une preuve de validité selon la construction.
Lorsque le nombre aléatoire est généré, il est souvent nécessaire de l'utiliser par des participants autres que ceux qui l'ont généré. Ces participants doivent recevoir tous Salut et les preuves associées avec le nombre.
Le lecteur curieux pourrait demander : puisque le nombre aléatoire final est H0, et p(0)G – c'est une information publique, pourquoi avoir besoin d'une preuve pour chaque distinct Hi, pourquoi ne pas envoyer à la place une preuve que
dlog(p(0)G, G) = dlog(H0, H)
Le problème est qu'avec le Schnorr Protocol, il n'est pas possible de créer une telle preuve, car personne ne connaît la valeur p(0), nécessaire pour créer la preuve, et de plus, tout le générateur de nombres aléatoires est basé sur le fait que personne ne connaît cette valeur. Il est donc nécessaire d'avoir toutes les valeurs Salut et leurs preuves individuelles pour prouver la validité. H0.
Cependant, s'il y avait une opération sur les points des courbes elliptiques qui était sémantiquement semblable à la multiplication, la preuve de validité H0 serait triviale, nous pourrions simplement vérifier que
H0 × G = p(0)G × H
Si la courbe choisie supporte , une telle preuve fonctionne. Dans ce cas, H0 n'est pas seulement la sortie du générateur de nombres aléatoires que tout participant connaissant G, H et p(0)G. H0 est aussi une signature sur le message qui a été utilisé comme seed, confirmant que k et n les participants ont signé ce message. Ainsi, si seed – c'est le hachage d'un bloc dans le protocole blockchain, alors H0 – c'est à la fois une multi-signature sur le bloc, et un très bon nombre aléatoire.
En conclusion
Cet article fait partie d'une série d'articles techniques sur le blog . NEAR est un protocole blockchain et une plateforme pour le développement d'applications décentralisées, axée sur la simplicité de développement et la facilité d'utilisation pour les utilisateurs finaux.
Le code du protocole est ouvert, notre implémentation est écrite en Rust, et elle peut être trouvée .
Vous pouvez voir à quoi ressemble le développement sous NEAR et expérimenter dans l'IDE en ligne .
Pour suivre toutes les nouvelles en russe, vous pouvez visiter et dans , et en anglais sur le site officiel .
À bientôt !
Source : habr.com
