

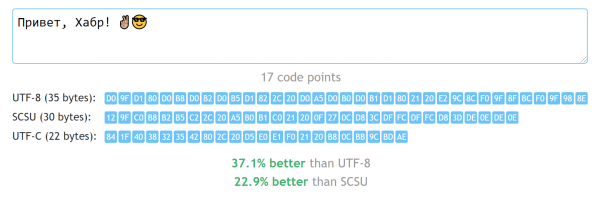
Si vous êtes développeur et que vous devez choisir une encodage, la solution presque toujours correcte sera Unicode. Le mode de représentation spécifique dépend du contexte, mais le plus souvent, il y a aussi une réponse universelle — UTF-8. Il est avantageux car il permet d'utiliser tous les caractères Unicode sans gaspiller trop de bytes dans la plupart des cas. Cependant, pour les langues qui n'utilisent pas seulement l'alphabet latin, « pas trop » signifie au moins deux bytes par caractère. Peut-on faire mieux, sans revenir à des encodages préhistoriques qui nous limitent à seulement 256 caractères disponibles ?
Je vous présente ci-dessous ma tentative de répondre à cette question et une mise en œuvre d'un algorithme relativement simple, permettant de stocker des chaînes dans la plupart des langues du monde, sans ajouter la redondance présente dans UTF-8.
Avertissement. Je vais d'abord faire quelques importantes réserves : la solution décrite n'est pas proposée comme un remplacement universel de l'UTF-8, elle convient uniquement dans un nombre restreint de cas (qui seront abordés ci-dessous), et ne doit en aucun cas être utilisée pour interagir avec des API externes (qui ne la connaissent pas non plus). Le plus souvent, pour le stockage compact de grandes quantités de données textuelles, des algorithmes de compression génériques (par exemple, deflate) seront appropriés. De plus, tout en créant ma solution, j'ai découvert un standard existant dans Unicode lui-même, qui résout le même problème — il est un peu plus complexe (et souvent moins performant), mais reste un standard accepté, et non une solution bricolée. Je vais également en parler.
À propos de Unicode et UTF-8
Pour commencer — quelques mots sur ce qu'est au juste Unicode et UTF-8.
Comme on le sait, les encodages 8 bits étaient autrefois populaires. C'était simple : 256 caractères peuvent être numérotés avec les nombres de 0 à 255, et les nombres de 0 à 255 peuvent évidemment être représentés par un seul byte. Si nous revenons aux origines, l'encodage ASCII est même limité à 7 bits, ce qui signifie que le bit le plus significatif de sa représentation byte est égal à zéro, et la plupart des encodages 8 bits sont compatibles avec lui (ils ne diffèrent que dans la « partie supérieure », où le bit le plus significatif est un).
En quoi Unicode se distingue-t-il de ces encodages et pourquoi est-il associé à plusieurs représentations concrètes — UTF-8, UTF-16 (BE et LE), UTF-32 ? Examinons cela dans l'ordre.
Le standard Unicode principal décrit uniquement la correspondance entre les caractères (et dans certains cas, les composants individuels des caractères) et leurs numéros. Et le nombre possible de numéros dans ce standard est très élevé - jusqu'à 0x00 à 0x10FFFF (1 114 112 unités). Si nous souhaitions stocker un nombre dans cette plage dans une variable, ni 1 ni 2 octets ne suffiraient. Et comme nos processeurs ne sont pas vraiment conçus pour traiter des nombres en trois octets, nous serions contraints d'utiliser 4 octets pour un seul caractère ! C'est ce qu'on appelle l'UTF-32, mais justement à cause de cette « gaspillage », ce format n'est pas populaire.
Heureusement, les caractères à l'intérieur de Unicode ne sont pas ordonnés au hasard. Leur multitude est divisée en 17 «plans», chacun contenant 65 536 (0x10000) «points de code. La notion de « point de code » ici est simplement un numéro de caractère, qui lui a été attribué par Unicode. Mais, comme mentionné précédemment, dans Unicode, non seulement des caractères individuels sont numérotés, mais également leurs composants et les annotations techniques (et parfois, le numéro ne correspond même à rien - peut-être pour un certain temps, mais cela n'est pas notre principal souci), il est donc plus correct de toujours parler du nombre de numéros, et non de caractères. Cependant, pour des raisons de concision, j'utiliserai souvent le terme « caractère », en me référant au terme « point de code ».
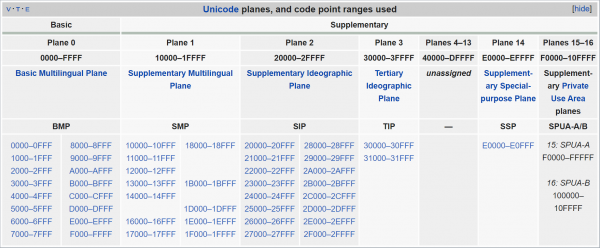
Plans de Unicode. Comme on peut le voir, la majeure partie (les plans 4 à 13) est encore inutilisée.
Ce qui est le plus remarquable, c'est que toute la principale « chair » se trouve dans le plan zéro, appelé "Plan multilingue de base". Si une ligne contient du texte dans l'une des langues modernes (y compris le chinois), vous ne sortirez pas de ce plan. Mais il n'est pas non plus possible de couper le reste de Unicode - par exemple, les émojis se trouvent principalement à la fin du plan suivant, "Plan multilingue supplémentaire" (qui s'étend de 0x10000 à 0x1FFFF). Ainsi, UTF-16 procède comme suit : tous les caractères appartenant à Plan multilingue de base, sont codés « tels quels », avec leur nombre en deux octets correspondant. Cependant, une partie des nombres dans cette plage ne désigne pas de caractères spécifiques, mais indique qu'après cette paire d'octets, il faut examiner une autre paire - en combinant les valeurs de ces quatre octets ensemble, nous obtiendrons un nombre qui couvre toute la plage autorisée de Unicode. Cette représentation est appelée « paires de substitution » - peut-être en avez-vous entendu parler.
Ainsi, UTF-16 nécessite deux ou (dans de très rares cas) quatre octets par « point de code ». C'est mieux que d'utiliser constamment quatre octets, mais la latin (et d'autres symboles ASCII) consomment ici la moitié de l'espace occupé par des zéros. UTF-8 a été conçu pour corriger cela : l'ASCII y occupe, comme auparavant, un octet ; les codes de 0x80 à 0x7FF — deux octets ; de 0x800 à 0xFFFF — trois, et de 0x10000 à 0x10FFFF — quatre. D'une part, la latin s'en sort bien : la compatibilité avec l'ASCII est revenue, et la répartition est plus uniformément « étalée » de 1 à 4 octets. Mais les alphabets autres que le latin, hélas, ne s'améliorent pas par rapport à UTF-16, et beaucoup nécessitent maintenant trois octets au lieu de deux — la plage couverte par l'enregistrement en deux octets a été réduite de 32 fois, de 0xFFFF à 0x7FF, et elle ne comprend déjà plus ni le chinois, ni, par exemple, le géorgien. L'alphabet cyrillique et encore cinq autres alphabets — hourra — sont chanceux, 2 octets par symbole.
Pourquoi cela se produit-il ? Voyons comment UTF-8 représente les codes de caractères :
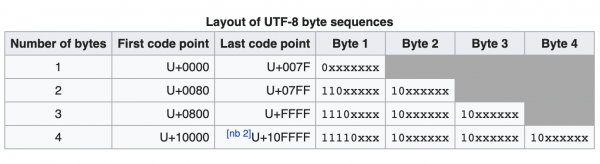
Directement pour la représentation des nombres, des bits sont utilisés ici, marqués par le symbole x. On voit que dans l'enregistrement en deux octets, il n'y a que 11 bits (sur 16). Les bits de tête ont ici seulement une fonction de service. Dans le cas de l'enregistrement en quatre octets, 21 bits sur 32 sont alloués au numéro du point de code — il semblerait qu'il aurait suffi de trois octets (qui fournissent au total 24 bits), mais les marqueurs de service consomment trop.
Est-ce mauvais ? En réalité, pas vraiment. D'une part — si nous sommes très soucieux de l'espace occupé, nous avons des algorithmes de compression qui élimineront facilement toute l'entropie et la redondance. D'autre part — l'objectif de l'Unicode était de fournir un codage aussi universel que possible. Par exemple, une chaîne codée en UTF-8 peut être confiée à un code qui fonctionnait auparavant uniquement avec l'ASCII, sans craindre qu'il y voie un symbole du domaine ASCII qui n'y est pas réellement présent (car, dans UTF-8, tous les octets commençant par un bit nul sont effectivement de l'ASCII). Et si nous voulons soudainement couper une petite queue d'une grande chaîne, sans la décoder depuis le début (ou restaurer une partie des informations après un segment endommagé) — il n'est pas difficile de trouver le décalage où commence un symbole donné (il suffit de sauter les octets ayant un préfixe binaire 10).
Pourquoi alors inventer quelque chose de nouveau ?
Cependant, il arrive parfois que des algorithmes de compression comme deflate soient mal adaptés, et qu'on souhaite obtenir un stockage compact des chaînes. Personnellement, j'ai été confronté à ce défi en réfléchissant à la construction pour un grand dictionnaire incluant des mots de diverses langues. D'une part, chaque mot est très court, donc le compresser serait peu efficace. D'autre part, l'implémentation de l'arbre que j'envisageais était conçue de manière à ce que chaque octet de la chaîne stockée génère un sommet distinct de l'arbre, donc minimiser leur nombre était très utile. Dans ma bibliothèque (tout comme dans , sur laquelle elle est basée) un tel problème se résout simplement : les chaînes, emballées dans un , y sont stockées en . Mais, comme il n'est pas difficile de le comprendre, cela fonctionne bien seulement pour un alphabet limité : on ne peut déjà plus intégrer une chaîne en chinois dans un tel dictionnaire.
Je tiens également à souligner un autre désagrément qui survient lors de l'utilisation de l'UTF-8 dans une telle structure de données. Sur l'image ci-dessus, on voit que lors de l'enregistrement d'un caractère sous forme de deux octets, les bits correspondant à son numéro ne sont pas en continu, mais interrompus par une paire de bits 10 au milieu : 110xxxxx 10xxxxxx. À cause de cela, lorsque les 6 bits de poids faible du second octet débordent (c'est-à-dire qu'il y a un dépassement 10111111 → 10000000), le premier octet change également. Ainsi, la lettre « п » est représentée par les octets 0xD0 0xBF, et la lettre suivante « р » — déjà par 0xD1 0x80. Dans l'arbre de préfixes, cela entraîne la division du sommet parent en deux – un pour le préfixe 0xD0, et l'autre pour 0xD1 (bien que tout le cyrillique pourrait être codé seulement avec le second octet).
Ce que j'ai obtenu
Confronté à ce défi, j'ai décidé de m'exercer à manipuler des bits, tout en me familiarisant un peu mieux avec la structure du Unicode en général. Le résultat a été un format de codage UTF-C (« C » pour compact), qui ne consomme pas plus de 3 octets par point de code, et permet très souvent de n'utiliser qu'un seul octet supplémentaire pour toute la chaîne codée. Cela entraîne le fait que sur de nombreux alphabets non ASCII, ce codage s'avère 30 à 60 % plus compact que l'UTF-8.
J'ai formaté des exemples d'implémentation des algorithmes de codage et de décodage sous forme de , vous pouvez les utiliser librement dans votre code. Mais je tiens à souligner qu'en un certain sens, ce format reste un « vélo », et je ne vous recommande pas de l'utiliser sans comprendre pourquoi vous en avez besoin. C'est plus une expérience qu'une véritable « amélioration de l'UTF-8 ». Néanmoins, le code est écrit de manière soignée, concise, avec de nombreux commentaires et une couverture de tests.
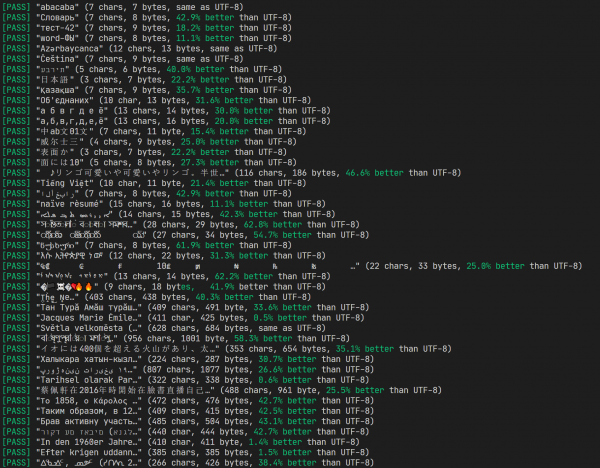
Résultat des tests et comparaison avec l'UTF-8
J'ai également créé , où vous pouvez apprécier le fonctionnement de l'algorithme, et par la suite, je vous expliquerai plus en détail ses principes et son processus de développement.
Éliminons les bits redondants
J'ai pris comme base, bien sûr, l'UTF-8. La première et la plus évidente chose que nous pouvons changer est de réduire le nombre de bits de contrôle dans chaque octet. Par exemple, le premier octet dans l'UTF-8 commence toujours par 0, ou par 11 — et le préfixe 10 n'apparaît que dans les octets suivants. Remplaçons le préfixe 11 sur 1, et nous supprimerons complètement les préfixes dans les octets suivants. Que va-t-il se passer?
0xxxxxxx — 1 octet
10xxxxxx xxxxxxxx — 2 octets
110xxxxx xxxxxxxx xxxxxxxx — 3 octets
Attendez, et où est l'enregistrement de quatre octets? Eh bien, cela n'est plus nécessaire — avec trois octets, nous avons maintenant accès à 21 bits, ce qui est largement suffisant pour tous les nombres jusqu'à 0x10FFFF.
Qu'est-ce que nous avons sacrifié ici? La chose la plus importante est la détection des limites des caractères à partir d'un emplacement aléatoire dans le tampon. Nous ne pouvons pas pointer sur un octet aléatoire et trouver le début du caractère suivant. C'est une limitation de notre format, mais en pratique, ce besoin ne se présente pas souvent. En général, nous sommes capables de parcourir le tampon depuis le début (surtout lorsqu'il s'agit de courtes chaînes).
La situation avec la couverture des langues de 2 octets s'est également améliorée : maintenant, le format à deux octets offre une plage de 14 bits, soit des codes jusqu'à 0x3FFF. Les Chinois ne sont pas chanceux (leurs idéogrammes sont principalement situés dans la plage de 0x4E00 à 0x9FFF), mais les Géorgiens et de nombreux autres peuples ont eu un peu plus de chance — leurs langues peuvent également être représentées en 2 octets par caractère.
Introduisons l'état de l'encodeur
Réfléchissons maintenant aux caractéristiques des chaînes elles-mêmes. Dans un dictionnaire, les mots sont souvent écrits avec des caractères d'un même alphabet, et cela est également vrai pour de nombreux autres textes. Il serait bon d'indiquer un alphabet une fois, puis de n'indiquer que le numéro de la lettre à l'intérieur. Voyons si la disposition des caractères dans la table Unicode peut nous aider.
Comme mentionné ci-dessus, Unicode est divisé en plans par 65536 codes chacun. Mais cette division n'est pas très utile (comme déjà mentionné, nous sommes le plus souvent dans le plan zéro). Une division plus intéressante est celle en blocs. Ces plages n'ont déjà plus de longueur fixe, et ont plus de sens — généralement, chacune regroupe des caractères d'un même alphabet.
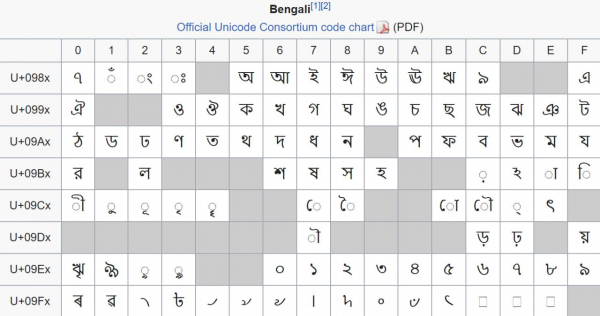
Bloc contenant des caractères de l'alphabet bengali. Malheureusement, pour des raisons historiques, c'est un exemple de conditionnement peu dense — 96 caractères sont dispersés de manière chaotique sur 128 points de code du bloc.
Le début des blocs et leur taille sont toujours multiples de 16 — c'est simplement fait pour des raisons de commodité. De plus, de nombreux blocs commencent et se terminent par des valeurs multiples de 128 ou même de 256 — par exemple, le cyrillique de base occupe 256 octets à partir de 0x0400 à 0x04FF. C'est plutôt pratique : si nous enregistrons une fois le préfixe 0x04, alors n'importe quel caractère cyrillique peut être écrit en un octet. Cependant, nous perdons ainsi la possibilité de revenir à l'ASCII (et à tout autre caractère en général). Donc, nous procédons comme suit :
- Deux octets
10yyyyyy yxxxxxxxnon seulement désignent le caractère numérotéyyyyyy yxxxxxxx, mais changent l'alphabet courant suryyyyyy y0000000c'est-à-dire que nous mémorisons tous les bits, sauf les moins significatifs 7 bits); - Un octet
0xxxxxxxest un caractère de l'alphabet courant. Il faut simplement l'ajouter au décalage que nous avons mémorisé à l'étape 1. Tant que nous n'avons pas changé d'alphabet, le décalage est égal à zéro, donc nous avons conservé la compatibilité avec l'ASCII.
De même pour les codes nécessitant 3 octets :
- Trois octets
110yyyyy yxxxxxxx xxxxxxxxdésignent le caractère numérotéyyyyyy yxxxxxxx xxxxxxxx, changent l'alphabet courant suryyyyyy y0000000 00000000(nous avons mémorisé tout, sauf les moins significatifs 15 bits), et mettent un drapeau que nous sommes maintenant en mode long lorsque nous changeons d'alphabet pour revenir à un mode à deux octets, nous réinitialiserons ce drapeau); - Deux octets
0xxxxxxx xxxxxxxxen mode long, c'est le caractère de l'alphabet courant. De même, nous l'ajoutons au décalage de l'étape 1. La seule différence est que maintenant, nous lisons deux octets (car nous avons basculé dans ce mode).
Cela semble plutôt bon : tant que nous avons besoin d'encoder des caractères d'une même plage Unicode de 7 bits, nous dépensons 1 octet supplémentaire au début et un octet pour chaque caractère.
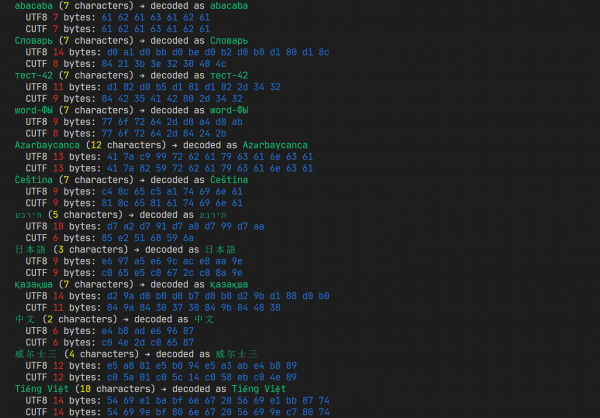
Travail d'une des premières versions. Elle dépasse déjà souvent UTF-8, mais il reste encore des améliorations à apporter.
Qu'est-ce qui s'est détérioré ? Tout d'abord, nous avons introduit un état, à savoir le décalage de l'alphabet courant et un drapeau mode long. Cela nous impose des limitations supplémentaires : maintenant, les mêmes caractères peuvent être codés différemment selon les contextes. La recherche de sous-chaînes, par exemple, devra désormais tenir compte de cela au lieu de simplement comparer des octets. Deuxièmement, une fois que nous avons changé d'alphabet, le codage des caractères ASCII a mal tourné (et cela ne concerne pas seulement l'alphabet latin, mais aussi la ponctuation de base, y compris les espaces) — ils nécessitent un changement d'alphabet en 0, c'est-à-dire un octet supplémentaire (et encore un autre pour revenir à notre base).
Un alphabet c'est bien, deux c'est mieux
Essayons de modifier légèrement nos préfixes de bits en ajoutant un troisième aux trois décrits ci-dessus :
0xxxxxxx — 1 octet en mode normal, 2 en mode long
11xxxxxx — 1 octet
100xxxxx xxxxxxxx — 2 octets
101xxxxx xxxxxxxx xxxxxxxx — 3 octets
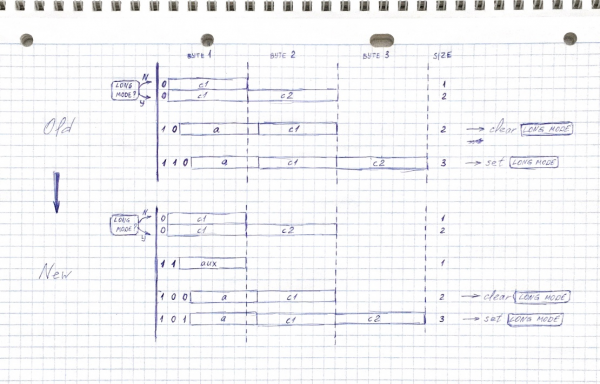
Maintenant, dans l'enregistrement sur deux octets, il y a un bit disponible de moins — les points de code allant jusqu'à 0x1FFF, pas 0x3FFF. Cependant, c'est encore nettement plus que dans les codes à deux octets de UTF-8, la plupart des langues courantes peuvent encore y tenir, la perte la plus notable — a disparu et , les Japonais sont tristes.
Quel est donc ce nouveau code 11xxxxxx? Это небольшой «загашник» размером в 64 символа, он дополняет наш основной алфавит, поэтому я назвал его вспомогательным (auxiliaire) alphabet. Lorsque nous changeons l'alphabet actuel, une partie de l'ancien alphabet devient auxiliaire. Par exemple, si nous avons changé de l'ASCII au cyrillique — dans le « stock » il y a maintenant 64 caractères, contenant l'alphabet latin, les chiffres, les espaces et la virgule (les insertions les plus fréquentes dans les textes non-ASCII). Si nous revenons à l'ASCII — l'alphabet auxiliaire deviendra la majeure partie du cyrillique.
Grâce à l'accès à deux alphabets, nous pouvons traiter un grand nombre de textes, en ayant des coûts minimaux pour le changement d'alphabets (la ponctuation nous ramènera souvent à l'ASCII, mais après cela, nous extrairons de nombreux caractères non-ASCII déjà de l'alphabet supplémentaire, sans changement supplémentaire).
Bonus : en désignant l'alphabet supplémentaire par un préfixe 11xxxxxx et en choisissant son décalage initial comme 0xC0, nous obtenons une compatibilité partielle avec CP1252. En d'autres termes, de nombreux (mais pas tous) textes d'Europe de l'Ouest codés en CP1252 apparaîtront de la même manière en UTF-C.
Cela soulève, cependant, une difficulté : comment obtenir l'alphabet auxiliaire à partir de l'alphabet principal ? On peut laisser le même décalage, mais — hélas — ici la structure de Unicode joue déjà contre nous. Très souvent, la majeure partie de l'alphabet ne se trouve pas au début du bloc (par exemple, la lettre majuscule russe « А » a le code 0x0410, bien que le bloc cyrillique commence par 0x0400). Ainsi, en prenant les 64 premiers caractères dans notre « boîte de rangement », nous pourrions éventuellement perdre l'accès à la partie terminale de l'alphabet.
Pour résoudre ce problème, j'ai manuellement parcouru certains blocs correspondant à différentes langues et j'ai indiqué pour eux le décalage de l'alphabet auxiliaire à l'intérieur du principal. J'ai même réorganisé par exception les caractères latins comme en base64.
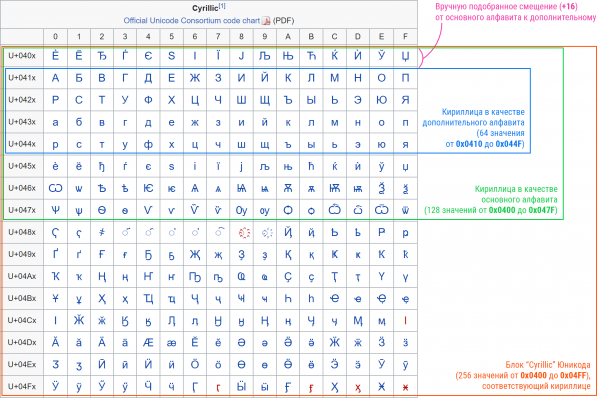
Dernières retouches
Réfléchissons enfin à où nous pourrions encore améliorer quelque chose.
Notons que le format 101xxxxx xxxxxxxx xxxxxxxx permet de coder des nombres allant jusqu'à 0x1FFFFF, tandis que l'Unicode se termine plus tôt, à 0x10FFFF. En d'autres termes, le dernier point de code sera représenté comme 10110000 11111111 11111111. Ainsi, nous pouvons dire que si le premier octet a la forme 1011xxxx UCS-4 xxxx plus de 0), il désigne autre chose. Par exemple, nous pourrions y ajouter encore 15 caractères, toujours disponibles pour être codés en un octet, mais j'ai décidé de procéder autrement.
Regardons les blocs Unicode qui nécessitent actuellement trois octets. Principalement, comme mentionné, ce sont des caractères chinois — mais il est difficile d’agir sur ceux-ci, il y en a 21 000. Mais il y a aussi l'hiragana et le katakana — et ceux-ci sont déjà moins nombreux, moins de deux cents. Et puisque nous avons évoqué les Japonais — il y a aussi des emojis (en réalité, ils sont éparpillés dans Unicode, mais les blocs principaux sont dans la plage 0x1F300 – 0x1FBFF). Si l'on considère qu'il existe maintenant des emojis qui se composent de plusieurs points de code (par exemple, l'emoji se compose de pas moins de 7 codes !), alors il est vraiment dommage de gaspiller trois octets pour chacun d'eux (7×3 = 21 octets pour un seul symbole, c'est un cauchemar).
C'est pourquoi nous choisissons quelques plages sélectionnées correspondant aux emojis, à l'hiragana et au katakana, nous les renumérotant dans une liste continue et les codant sous forme de deux octets au lieu de trois :
1011xxxx xxxxxxxx
Génial : l'emoji mentionné ci-dessus , composé de 7 points de code, occupe 25 octets en UTF-8, et nous l'avons intégré dans 14 (exactement deux octets par point de code). Au fait, Habr a refusé de le traiter (dans l'éditeur ancien et nouveau), donc j'ai dû l'insérer en tant qu'image.
Essayons encore de corriger un autre problème. Comme nous le savons, l'alphabet principal est essentiellement les 6 bits supérieurs, que nous gardons à l'esprit, et nous les collons au code de chaque symbole déchiffré suivant. Pour ce qui est des caractères chinois, qui se trouvent dans le bloc 0x4E00 – 0x9FFF, c'est soit un bit 0, soit un bit 1. Ce n'est pas très pratique : nous devrons constamment changer d'alphabet entre ces deux valeurs (c'est-à-dire dépenser trois octets). Mais remarquons que dans le mode long, nous pouvons soustraire du code le nombre de caractères que nous codons avec le mode court (après tous les subtilités mentionnées ci-dessus, cela fait 10240) — alors la plage des idéogrammes sera décalée à 0x2600 – 0x77FF, et dans ce cas, dans toute cette plage, les 6 bits les plus significatifs (sur 21) seront égaux à 0. Ainsi, les séquences d'idéogrammes utiliseront deux octets par idéogramme (ce qui est optimal pour une si grande plage), sans provoquer de changements d'alphabet.
Solutions alternatives : SCSU, BOCU-1
Les connaisseurs de Unicode, après avoir lu le titre de l'article, sont probablement impatients de rappeler qu'il existe directement parmi les normes Unicode (SCSU), qui décrit une méthode de codage très similaire à celle décrite dans cet article.
J'avoue honnêtement : j'ai découvert son existence seulement après m'être profondément plongé dans l'écriture de ma solution. Si je l'avais su dès le départ, j'aurais probablement essayé d'écrire son implémentation au lieu de concevoir ma propre approche.
Ce qui est intéressant, c'est que SCSU utilise des idées très similaires à celles auxquelles je suis arrivé moi-même (au lieu du concept « d'alphabets », il utilise des « fenêtres », et il y en a plus que je n'en ai). En même temps, ce format a aussi des inconvénients : il est un peu plus proche des algorithmes de compression que du codage. En particulier, la norme propose plusieurs façons de représentation, mais ne dit pas comment choisir l'optimale — pour cela, l'encodeur doit appliquer certaines heuristiques. Ainsi, un encodeur SCSU qui donne un bon conditionnement sera plus complexe et plus encombrant que mon algorithme.
Pour la comparaison, j'ai transféré une implémentation relativement simple de SCSU en JavaScript — en termes de code, elle s'est révélée comparable à mon UTF-C, mais dans certains cas, elle a montré des résultats de plusieurs dizaines de pourcentages pires (elle peut parfois le surpasser, mais pas de beaucoup). Par exemple, les textes en hébreu et en grec UTF-C ont été codés jusqu'à 60% mieux que SCSU (probablement en raison de leurs alphabets compacts).
Je rajoute que, en plus de SCSU, il existe également une autre méthode de représentation compacte de l'Unicode — , mais il vise la compatibilité avec MIME (ce qui n'était pas nécessaire pour moi) et utilise une approche légèrement différente pour le codage. Je n'ai pas évalué son efficacité, mais je pense qu'elle ne sera guère supérieure à celle de SCSU.
Améliorations possibles
L'algorithme que j'ai proposé n'est pas universel par conception (c'est probablement dans ce sens que mes objectifs divergent le plus de ceux du consortium Unicode). J'ai déjà mentionné qu'il a été principalement conçu pour une tâche spécifique (le stockage d'un dictionnaire multilingue dans un arbre préfixe), et certaines de ses caractéristiques peuvent mal convenir à d'autres tâches. Mais le fait qu'il ne soit pas standard peut aussi être un avantage — vous pouvez facilement l'adapter à vos besoins.
Par exemple, on peut facilement se débarrasser de l'état, rendant le codage stateless — il suffit de ne pas mettre à jour les variables offres, auxOffs et est21Bit dans l'encodeur et le décodeur. Dans ce cas, il ne sera pas possible d'emballer efficacement des séquences de caractères d'un même alphabet, mais il y aura la garantie qu'un même caractère est toujours codé avec les mêmes octets, indépendamment du contexte.
De plus, il est possible de personnaliser le codeur pour une langue spécifique, en modifiant l'état par défaut — par exemple, en se basant sur des textes russes, il serait judicieux de définir au début de l'encodeur et du décodeur offs = 0x0400 et auxOffs = 0. En particulier, cela a du sens dans le mode stateless. Dans l'ensemble, cela ressemblera à l'utilisation d'un ancien code à huit bits, tout en permettant d'incorporer des caractères de tout le Unicode si nécessaire.
Un autre inconvénient, mentionné précédemment — dans un texte volumineux encodé en UTF-C, il n'existe pas de moyen rapide de trouver la limite d'un caractère proche d'un octet arbitraire. Si vous coupez les 100 derniers octets d'un tampon codé, vous risquez d'obtenir des données corrompues, avec lesquelles il n'y a rien à faire. Le codage n'est pas conçu pour conserver des logs de plusieurs gigaoctets, mais cela peut être corrigé dans l'ensemble. Un octet 0xBF ne doit jamais apparaître comme premier octet (mais peut être second ou troisième). Ainsi, lors du codage, il est possible d'insérer une séquence 0xBF 0xBF 0xBF tous les, disons, 10 Ko — alors, en cas de besoin, il suffira de scanner la section choisie jusqu'à ce qu'un tel marqueur soit trouvé. Après le dernier 0xBF le début d'un caractère sera garanti. (Lors du décodage, il faudra bien sûr ignorer cette séquence de trois octets.)
En résumé
Si vous êtes arrivé ici, félicitations ! J'espère que vous, comme moi, avez appris quelque chose de nouveau (ou raffraîchi votre mémoire) sur le fonctionnement de l'Unicode.
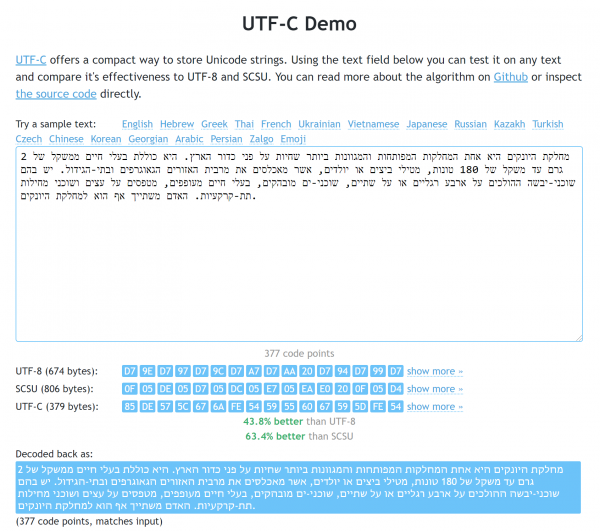
Page de démonstration. L'exemple de l'hébreu montre les avantages tant par rapport à l'UTF-8 qu'à SCSU.
Il ne faut pas considérer les recherches décrites ci-dessus comme une atteinte aux normes. Cependant, je suis globalement satisfait des résultats de mes travaux, donc je suis heureux de les : par exemple, la bibliothèque JS en version minifiée ne pèse que 1710 octets (et n'a bien sûr pas de dépendances). Comme je l'ai mentionné précédemment, son fonctionnement peut être consulté sur (où il y a aussi un ensemble de textes avec lesquels elle peut être comparée à UTF-8 et SCSU).
Enfin, je voudrais souligner à nouveau les cas où il ne faut pas utiliser UTF-C peut-être:
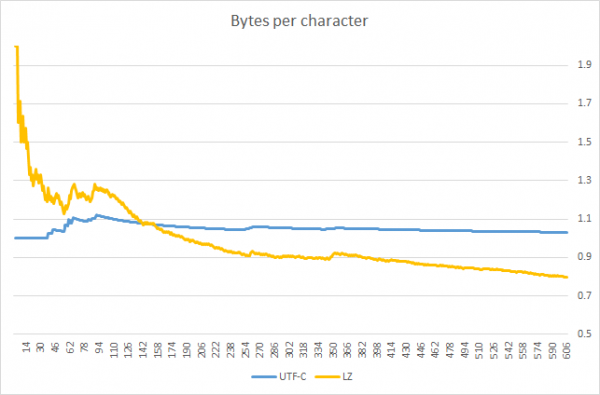
- Si vos chaînes sont assez longues (de 100 à 200 caractères). Dans ce cas, il convient de considérer l'application d'algorithmes de compression tels que deflate.
- Si vous avez besoin de transparence ASCII, c'est-à-dire que vous tenez à ce que les séquences codées ne contiennent pas de codes ASCII qui n'étaient pas dans la chaîne d'origine. Ce besoin peut être évité si, lors de l'interaction avec des API tierces (par exemple, lors du travail avec des bases de données), vous transmettez le résultat du codage comme un ensemble abstrait d'octets, et non comme des chaînes. Sinon, vous risquez de rencontrer des vulnérabilités imprévues.
- Si vous souhaitez pouvoir localiser rapidement les limites des caractères selon un décalage arbitraire (par exemple, en cas de corruption d'une partie de la chaîne). Cela peut être fait, mais uniquement en scannant la chaîne depuis le début (ou en appliquant le travail décrit dans la section précédente).
- Si vous devez effectuer rapidement des opérations sur le contenu des chaînes (les trier, rechercher des sous-chaînes, les concaténer). Pour cela, il est d'abord nécessaire de décoder les chaînes, donc UTF-C sera plus lent qu'UTF-8 dans ces cas (mais plus rapide que les algorithmes de compression). Étant donné qu'une même chaîne est toujours codée de la même manière, la comparaison exacte du décodage n'est pas nécessaire, elle peut être effectuée byte par byte.
Mise à jour : utilisateur J'ai publié un graphique soulignant la limite d'application de l'UTF-C. On y voit que l'UTF-C est plus efficace que l'algorithme de compression généraliste (variantes LZW) tant que la chaîne compressée est plus courte. ~140 caractères (en revanche, je note que la comparaison a été faite sur un seul texte ; pour d'autres langues, le résultat peut être différent).
Source : habr.com
