

Cet article aborde la problématique du nettoyage des images qui s'accumulent dans les registres de conteneurs (Docker Registry et ses alternatives) dans le contexte des pipelines CI/CD modernes pour les applications cloud native déployées sur Kubernetes. Les principaux critères de pertinence des images sont présentés, ainsi que les difficultés qui en découlent pour automatiser le nettoyage, économiser de l'espace et répondre aux besoins des équipes. Enfin, à travers un exemple d'un projet Open Source concret, nous expliquerons comment surmonter ces difficultés.
Introduction
Le nombre d'images dans le registre des conteneurs peut croître rapidement, occupant plus d'espace de stockage et, par conséquent, augmentant considérablement son coût. Pour contrôler, limiter ou maintenir une croissance acceptable de l'espace occupé dans le registre, il est courant de :
- utiliser un nombre fixe de tags pour les images ;
- nettoyer les images d'une manière ou d'une autre.
La première restriction est parfois acceptable pour de petites équipes. Si les développeurs se contentent de tags fixes (latest, main, test, boris etc.), le registre ne gonflera pas en taille et pendant longtemps, il n'est pas nécessaire de penser à un nettoyage. En effet, toutes les images obsolètes sont remplacées, et il n'y a tout simplement pas de travail de nettoyage (tout est géré par le ramasse-miettes standard).
Cependant, cette approche limite fortement le développement et est rarement applicable aux projets CI/CD modernes. L'automatisation est devenue une partie intégrante du développement, qui permet de tester, déployer et livrer de nouvelles fonctionnalités aux utilisateurs beaucoup plus rapidement. Par exemple, dans tous nos projets, un pipeline CI est automatiquement créé à chaque commit. Celui-ci construit l'image, la teste, la déploie dans divers environnements Kubernetes pour le débogage et les vérifications restantes, et si tout va bien, les modifications atteignent l'utilisateur final. Ce n'est plus une science-fusée, mais une banalité pour beaucoup — probablement pour vous également, puisque vous lisez cet article.Étant donné que la correction des bogues et le développement de nouvelles fonctionnalités se déroulent en parallèle, et que des versions peuvent être effectuées plusieurs fois par jour, il est évident que le processus de développement est accompagné d'un nombre considérable de commits, ce qui signifie —
un grand nombre d'images dans le registre. En conséquence, la question de l'organisation d'un nettoyage efficace du registre se pose avec acuité, c'est-à-dire la suppression d'images obsolètes..
Mais comment déterminer si l'image est pertinente ?
Critères de pertinence de l'image
Dans la grande majorité des cas, les critères principaux seront les suivants :
1. Le premier (le plus évident et le plus critique de tous) — ce sont les images qui sont actuellement utilisées dans Kubernetes. La suppression de ces images peut entraîner des coûts importants liés à l'arrêt de la production (par exemple, les images peuvent être nécessaires lors de la réplication) ou compromettre les efforts de l'équipe qui se consacre au débogage sur l'un des environnements. (C'est pourquoi nous avons même créé un , qui surveille l'absence de telles images dans tout cluster Kubernetes.)
2. Le deuxième (moins évident, mais toujours très important et à nouveau lié à l'exploitation) — les images qui sont nécessaires pour revenir en arrière en cas de problèmes majeurs dans la version actuelle. Par exemple, dans le cas de Helm, ce sont les images utilisées dans les versions enregistrées du déploiement. (À propos, par défaut, Helm a une limite de 256 révisions, mais est-ce que quelqu'un a vraiment besoin de conserver autant de versions ?..) En effet, nous stockons des versions dans le but de pouvoir les utiliser ultérieurement, c'est-à-dire 'revenir en arrière' si nécessaire.
3. Le troisième — les besoins des développeurs: toutes les images liées à leurs travaux en cours. Par exemple, si nous examinons un PR, il est logique de conserver l'image correspondant au dernier commit et, disons, au commit précédent : ainsi, le développeur pourra revenir rapidement à n'importe quelle tâche et travailler avec les dernières modifications.
4. Le quatrième — les images qui correspondent aux versions de notre application, c'est-à-dire qui sont le produit final : v1.0.0, 20.04.01, sierra, etc.
NB : Les critères établis ici ont été formulés sur la base de l'expérience avec des dizaines d'équipes de développement de diverses entreprises. Cependant, bien sûr, selon les particularités des processus de développement et de l'infrastructure utilisée (par exemple, Kubernetes n'est pas utilisé), ces critères peuvent différer.
Conformité aux critères et solutions existantes
Les services populaires de registre de conteneurs proposent généralement leurs politiques de nettoyage des images : vous pouvez définir les conditions dans lesquelles un tag est supprimé du registre. Cependant, les options de ces conditions sont limitées par des paramètres tels que les noms, les dates de création et le nombre de tags*.
* Dépend des implémentations spécifiques du registre de conteneurs. Nous avons examiné les capacités des solutions suivantes : Azure CR, Docker Hub, ECR, GCR, GitHub Packages, GitLab Container Registry, Harbor Registry, JFrog Artifactory, Quay.io — à la date de septembre 2020.
Cet ensemble de paramètres est tout à fait suffisant pour répondre au quatrième critère — c'est-à-dire sélectionner des images correspondant aux versions. Cependant, pour tous les autres critères, il faut opter pour une solution de compromis (une politique plus stricte ou, au contraire, plus indulgente) — selon les attentes et les possibilités financières.
Par exemple, le troisième critère — concernant les besoins des développeurs — peut être résolu en organisant des processus au sein des équipes : nomination spécifique des images, tenue de listes d'autorisation spéciales et accords internes. Mais en fin de compte, il faut cependant automatiser cela. Et si les options des solutions prêtes à l'emploi ne suffisent pas, il faut créer sa propre solution.
La situation est similaire pour les deux premiers critères : ils ne peuvent pas être satisfaits sans obtenir des données d'un système externe — celui où le déploiement des applications a lieu (dans notre cas, il s'agit de Kubernetes).
Illustration du workflow dans Git
Supposons que vous travaillez selon un schéma similaire dans Git :
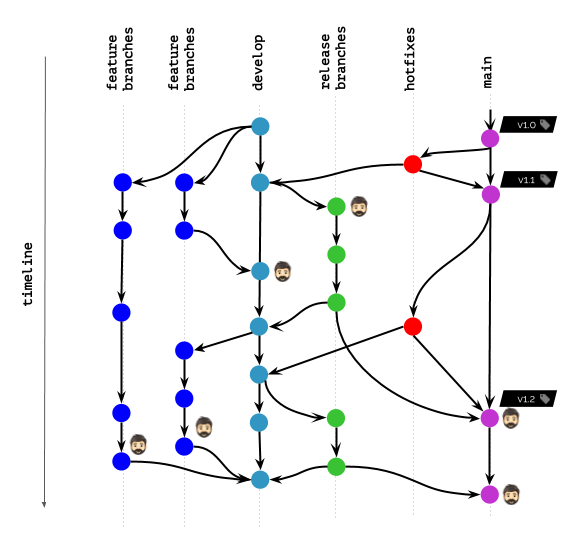
Les images des conteneurs, marquées par une icône avec une tête dans le schéma, sont actuellement déployées dans Kubernetes pour certains utilisateurs (utilisateurs finaux, testeurs, gestionnaires, etc.) ou sont utilisées par les développeurs pour le débogage et des objectifs similaires.
Que se passera-t-il si les politiques de nettoyage permettent de conserver (ne pas supprimer) les images uniquement selon des noms de tags définis?
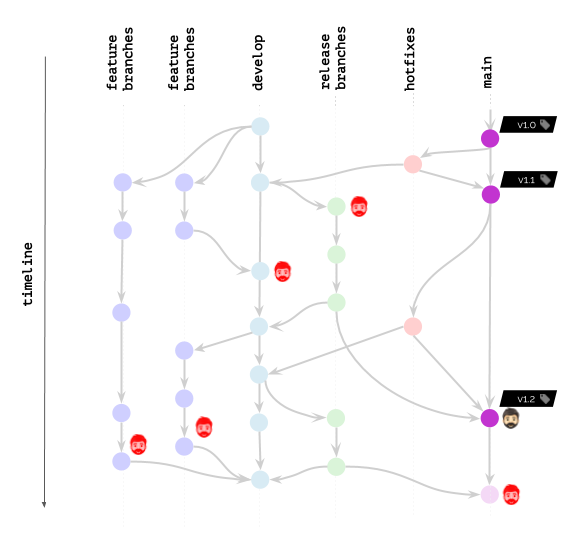
Il est évident qu'un tel scénario ne ravira personne.
Que changera si les politiques permettent de ne pas supprimer les images selon un intervalle de temps donné / le nombre de derniers commits?
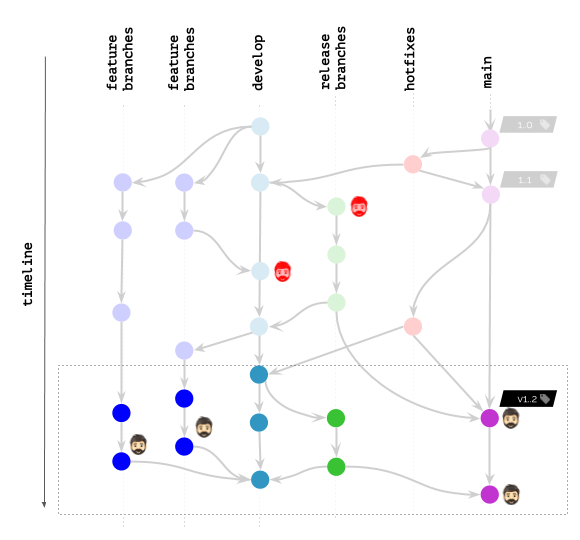
Le résultat est devenu significativement meilleur, mais reste encore éloigné de l'idéal. En effet, nous avons toujours des développeurs qui ont besoin d'images dans le registre (ou même déployées dans K8s) pour déboguer des bugs…
En résumant la situation actuelle sur le marché : les fonctionnalités disponibles dans les registres de conteneurs n'offrent pas la flexibilité nécessaire pour le nettoyage, et la principale raison en est l'absence d'interaction avec le monde extérieur. Par conséquent, les équipes qui nécessitent une telle flexibilité doivent implémenter elles-mêmes la suppression des images « de l'extérieur » en utilisant l'API de Docker Registry (ou l'API native de l'implémentation correspondante).
Cependant, nous recherchions une solution universelle qui automatiserait le nettoyage des images pour différentes équipes utilisant différents registres...
Notre chemin vers un nettoyage universel des images
D'où vient ce besoin ? Il se trouve que nous ne sommes pas un groupe de développeurs isolé, mais une équipe qui soutient plusieurs d'entre eux, en les aidant à résoudre de manière globale les questions de CI/CD. Et l'outil technique principal pour cela est l'utilitaire Open Source . Sa particularité est qu'il n'exécute pas une seule fonction, mais accompagne les processus de livraison continue à toutes les étapes : de la construction au déploiement.
La publication dans le registre* des images (immédiatement après leur construction) est une fonctionnalité évidente d'un tel utilitaire. Et puisque les images y sont stockées, si votre stockage n'est pas illimité, il faut également s'assurer de leur nettoyage ultérieur. Nous expliquerons comment nous avons réussi cela, en satisfaisant tous les critères posés.
* Bien que les registres eux-mêmes puissent être différents (Docker Registry, GitLab Container Registry, Harbor, etc.), leurs utilisateurs rencontrent les mêmes problèmes. La solution universelle dans notre cas ne dépend pas de l'implémentation du registre, car elle s'exécute en dehors des registres eux-mêmes et propose un comportement identique pour tous.
Bien que nous utilisions werf comme exemple d'implémentation, nous espérons que les approches utilisées seront utiles à d'autres équipes confrontées à des difficultés similaires.
Ainsi, nous nous sommes attaqués à l'implémentation d'un mécanisme de nettoyage des images — plutôt que d'utiliser les possibilités déjà intégrées dans les registres de conteneurs. La première étape a été l'utilisation de l'API de Docker Registry pour créer ces politiques primitives sur le nombre de balises et leur date de création (mentionnées ci-dessus). À celles-ci a été ajoutée une liste d'autorisation basée sur les images utilisées dans l'infrastructure déployée, c'est-à-dire Kubernetes. Pour cela, il suffisait de passer par l'API Kubernetes pour parcourir toutes les ressources déployées et obtenir une liste de valeurs. image.
Cette solution triviale a résolu le problème le plus critique (critère n°1), mais n'était que le début de notre parcours pour améliorer le mécanisme de nettoyage. Le prochain — et beaucoup plus intéressant — pas a été de résoudre le lien entre les images publiées et l'historique Git..
Schémas de balisage
Pour commencer, nous avons choisi une approche où l'image finale devait conserver les informations nécessaires pour le nettoyage, et nous avons construit le processus sur des schémas de balisage. Lors de la publication de l'image, l'utilisateur choisissait une option de balisage (branche-git, commit-git ou tag-git) et utilisait la valeur correspondante. Dans les systèmes CI, ces valeurs étaient définies automatiquement sur la base des variables d'environnement. En essence, l'image finale était liée à un certain élément Git, conservant les données nécessaires pour le nettoyage dans les labels.
Dans le cadre de cette approche, un ensemble de politiques a été mis en place, permettant d'utiliser Git comme la seule source de vérité :
- Lors de la suppression d'une branche/tag dans Git, les images associées étaient automatiquement supprimées du registre.
- Le nombre d'images liées aux tags et commits Git pouvait être régulé par le nombre de tags utilisés dans le schéma choisi et par le moment de création du commit lié.
Dans l'ensemble, l'implémentation obtenue satisfaisait nos besoins, mais un nouveau défi nous attendait bientôt. En effet, pendant l'utilisation des schémas de balisage basés sur les éléments Git, nous avons rencontré plusieurs inconvénients. (Comme leur description dépasse le cadre de cet article, tous ceux qui le souhaitent peuvent consulter les détails .) Ainsi, ayant décidé de passer à une approche de balisage plus efficace (balisage basé sur le contenu), nous avons dû revoir l'implémentation du nettoyage des images.
Nouvel algorithme
Pourquoi ? Lors du balisage dans le cadre du balisage basé sur le contenu, chaque tag peut correspondre à de nombreux commits dans Git. Lors du nettoyage des images, il n'est plus possible de se baser uniquement sur le commit où le nouveau tag a été ajouté au registre.
Pour le nouvel algorithme de nettoyage, il a été décidé de s'éloigner des schémas de balisage et de construire le processus sur des méta-images,chacune d'entre elles conservant une association de :
- le commit lors duquel l'image a été publiée (peu importe si l'image a été ajoutée, modifiée ou est restée la même dans le registre des conteneurs);
- et notre identifiant interne correspondant à l'image assemblée.
En d'autres termes, un lien a été établi entre les tags publiés et les commits dans Git..
La configuration finale et l'algorithme général
Les utilisateurs ont désormais accès à des politiques pour la configuration du nettoyage, qui déterminent la sélection des images pertinentes. Chaque politique est définie par :
- un ensemble de références, c'est-à-dire des tags ou des branches Git, qui sont utilisés lors du scan;
- et une limite du nombre d'images recherchées pour chaque référence de cet ensemble.
Pour illustrer, voici à quoi ressemble la configuration par défaut des politiques :
cleanup:
  keepPolicies:
  - references:
      tag: /.* /
      limit:
        last: 10
  - references:
      branch: /.* /
      limit:
        last: 10
        in: 168h
        operator: And
    imagesPerReference:
      last: 2
      in: 168h
      operator: And
  - references:
      branch: /^(main|staging|production)$/
    imagesPerReference:
      last: 10
Cette configuration contient trois politiques qui correspondent aux règles suivantes :
- Conserver l'image pour les 10 derniers tags Git (en fonction de la date de création du tag).
- Conserver au maximum 2 images publiées au cours de la dernière semaine pour au maximum 10 branches ayant été actives au cours de la dernière semaine.
- Conserver 10 images pour les branches
main,stagingetproduction.
L'algorithme final se résume aux étapes suivantes :
- Récupérer les manifestes du registre des conteneurs.
- Exclure les images utilisées dans Kubernetes, car celles-ci ont déjà été sélectionnées en interrogeant l'API K8s.
- Scanner l'historique Git et exclure les images selon les politiques définies.
- Supprimer les images restantes.
Revenons à notre illustration, voici ce que cela donne avec werf :
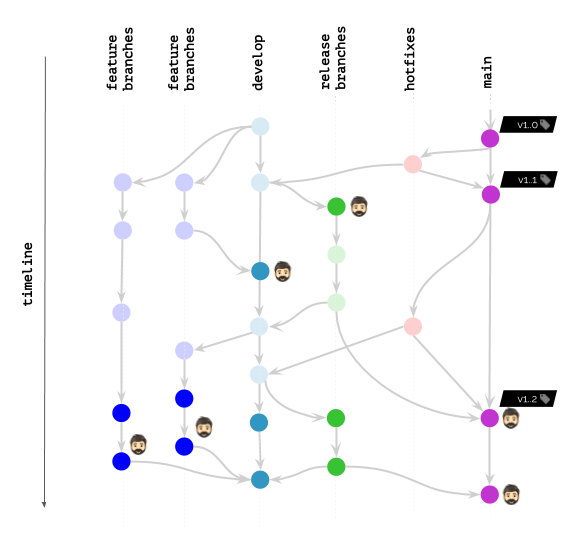
Cependant, même si vous n'utilisez pas werf, une approche similaire pour le nettoyage avancé des images — dans une forme ou une autre (selon l'approche préférée pour le balisage des images) — peut être appliquée dans d'autres systèmes/utilitaires. Il suffit de garder à l'esprit les problèmes qui se présentent et de trouver les opportunités dans votre pile qui permettent d'intégrer leur solution de manière fluide. Nous espérons que le chemin que nous avons parcouru aidera à examiner votre cas spécifique avec de nouveaux détails et réflexions.
Conclusion
- Tôt ou tard, la plupart des équipes se heurtent au problème de la saturation du registre.
- Lors de la recherche de solutions, il est essentiel de définir en premier lieu les critères de pertinence de l'image.
- Les outils proposés par les services populaires de container registry permettent d'organiser un nettoyage très simple qui ne prend pas en compte le « monde extérieur » : les images utilisées dans Kubernetes et les spécificités des flux de travail au sein de l'équipe.
- Un algorithme flexible et efficace doit avoir une compréhension des processus CI/CD et ne doit pas se limiter uniquement aux données des images Docker.
P.S.
Lisez aussi dans notre blog :
- «»;
- «»;
- «»;
- «».
Source : habr.com
