

Attendez ! Attendez ! En réalité, ce n'est pas un article de plus sur les types de sauvegardes SQL Server. Je ne vais même pas parler des différences entre les modèles de récupération ni de la manière de traiter un « log » qui s'est étendu.
Peut-être (juste peut-être), après avoir lu ce post, vous pourrez faire en sorte que la sauvegarde standard que vous effectuez soit réalisée, disons, 1,5 fois plus rapidement demain soir. Et ce, simplement en utilisant un peu plus de paramètres BACKUP DATABASE.
Si le contenu de cet article vous semblait évident, désolé. J'ai lu tout ce que Google a pu m'offrir avec la phrase « habr sql server backup », et je n'ai trouvé aucune mention concernant l'impact que l'on peut avoir sur le temps de sauvegarde à l'aide de paramètres.
Je tiens tout de suite à attirer votre attention sur le commentaire d'Alexander Gladchenko ():
Ne changez jamais les paramètres BUFFERCOUNT, BLOCKSIZE, MAXTRANSFERSIZE en production. Ils sont conçus uniquement pour la rédaction de ce genre d'articles. En pratique, vous rencontrerez des problèmes de mémoire à cause de cela.
Ce serait bien sûr incroyable d'être le plus intelligent et de publier du contenu exclusif, mais malheureusement, ce n'est pas le cas. Il existe des articles/posts en anglais et en russe (je ne sais jamais comment les qualifier correctement) consacrés à ce sujet. Voici une partie de ceux que j'ai trouvés : , , .
Alors, pour commencer, voici une syntaxe BACKUP réduite provenant de (en passant, je parlais plus haut de BACKUP DATABASE, mais tout cela s'applique également à la sauvegarde du journal des transactions et à la sauvegarde différentielle, bien que peut-être avec un effet moins évident) :
BACKUP DATABASE { database_name | @database_name_var }
  TO  [ ,...n ]

  [ WITH {
           |  [ ,...n ] } ]
[;]

 [ ,...n ]::=

--Options de l'ensemble des médias

 | BLOCKSIZE = { blocksize | @blocksize_variable }

--Options de transfert de données
   BUFFERCOUNT = { buffercount | @buffercount_variable }
 | MAXTRANSFERSIZE = { maxtransfersize | @maxtransfersize_variable }
signifie qu'il y avait quelque chose, mais je l'ai supprimé car ce n'est pas pertinent pour le sujet actuel.
Comment effectuez-vous généralement une sauvegarde ? Comment « on » vous apprend à réaliser une sauvegarde dans des milliards d'articles ? En fait, si je devais faire une sauvegarde unique d'une base de données pas très importante, je noterais automatiquement quelque chose comme ceci :
BACKUP DATABASE smth
TO DISK = 'D:Backupsmth.bak'
WITH STATS = 10, CHECKSUM, COMPRESSION, COPY_ONLY;
-- d'accord, CHECKSUM, je l'ai noté juste pour avoir l'air plus intelligent
Et, en gros, ici figurent probablement 75 à 90 % des paramètres qui sont généralement mentionnés dans les articles sur les sauvegardes. Il y a aussi INIT, SKIP, etc. Êtes-vous déjà allé sur MSDN ? Avez-vous vu qu'il y a tant d'options ? Moi aussi…
Vous avez probablement déjà compris que nous allons maintenant parler des trois paramètres qui restent dans le premier bloc de code : BLOCKSIZE, BUFFERCOUNT et MAXTRANSFERSIZE. Voici leurs descriptions issues de MSDN :
BLOCKSIZE = { blocksize | @ blocksize_variable } — indique la taille du bloc physique en octets. Les tailles prises en charge sont 512, 1024, 2048, 4096, 8192, 16 384, 32 768 et 65 536 octets (64 Ko). La valeur par défaut est de 65 536 pour les dispositifs à bande et de 512 pour les autres. En général, il n'est pas nécessaire de spécifier ce paramètre, car l'instruction BACKUP choisit automatiquement la taille du bloc adaptée au dispositif. La définition explicite d'une taille de bloc remplace le choix automatique de la taille de bloc.
BUFFERCOUNT = { buffercount | @ buffercount_variable } — définit le nombre total de tampons d'entrée-sortie qui seront utilisés pour l'opération de sauvegarde. Vous pouvez spécifier n'importe quelle valeur entière positive, mais un grand nombre de tampons peut entraîner une erreur de manque de mémoire en raison d'un espace d'adresse virtuelle excessif dans le processus Sqlservr.exe.
Le volume total d'espace utilisé par les tampons est déterminé par la formule suivante :
BUFFERCOUNT * MAXTRANSFERSIZE.
MAXTRANSFERSIZE = { maxtransfersize | @ maxtransfersize_variable } indique le plus grand volume de paquet de données en octets pour l'échange de données entre SQL Server et le support de sauvegarde. Les valeurs multiples de 65 536 octets (64 Ko) sont prises en charge, jusqu'à 4 194 304 octets (4 Mo).
Je jure que je l'ai déjà lu, mais je n'avais pas réalisé à quel point cela peut affecter les performances. De plus, il semble que j'ai besoin de faire une sorte de « coming-out » et de reconnaître que même maintenant, je ne comprends pas entièrement ce qu'ils font. Je devrais probablement lire davantage sur l'entrée-sortie tamponnée et le fonctionnement des disques durs. Un jour, je le ferai, mais pour l'instant, je peux simplement écrire un script pour vérifier comment ces valeurs affectent la vitesse à laquelle une sauvegarde est effectuée.
J'ai créé une petite base d'environ 10 Go, je l'ai mise sur un SSD, et j'ai placé le répertoire de sauvegarde sur un HDD.
Je crée une table temporaire pour stocker les résultats (pour moi, elle n'est pas temporaire afin que je puisse explorer les résultats plus en détail, mais à vous de décider) :
DROP TABLE IF EXISTS ##bt_results;

CREATE TABLE ##bt_results (
    id              int IDENTITY (1, 1) PRIMARY KEY,
    start_date      datetime NOT NULL,
    finish_date     datetime NOT NULL,
    backup_size     bigint NOT NULL,
    compressed_size bigint,
    block_size      int,
    buffer_count    int,
    transfer_size   int
);
Le principe de fonctionnement du script est simple — des boucles imbriquées, chacune changeant la valeur d'un paramètre, que j'insère dans la commande BACKUP avec ces paramètres, puis j'enregistre le dernier enregistrement de l'historique dans msdb.dbo.backupset, je supprime le fichier de sauvegarde et passe à l'itération suivante. Étant donné que les informations sur l'exécution de la sauvegarde proviennent de backupset, la précision est quelque peu perdue (il n'y a pas de fractions de seconde), mais nous allons nous en accommoder.
Tout d'abord, il faut autoriser l'utilisation de xp_cmdshell pour pouvoir supprimer les sauvegardes (n'oubliez pas de désactiver cela plus tard si vous n'en avez pas besoin) :
EXEC sp_configure 'show advanced options', 1;
EXEC sp_configure 'xp_cmdshell', 1;
RECONFIGURE;
EXEC sp_configure 'show advanced options', 0;
GO
Et donc, voici :
DECLARE @tmplt AS nvarchar(max) = N'
BACKUP DATABASE [bt]
TO DISK = ''D:SQLServerbackupbt.bak''
WITH
    COMPRESSION,
    BLOCKSIZE = {bs},
    BUFFERCOUNT = {bc},
    MAXTRANSFERSIZE = {ts}';

DECLARE @sql AS nvarchar(max);

\/\* Valeurs de BLOCKSIZE *\/
DECLARE @bs     int = 4096,
        @max_bs int = 65536;

\/* Valeurs de BUFFERCOUNT *\/
DECLARE @bc     int = 7,
        @min_bc int = 7,
        @max_bc int = 800;

\/* Valeurs de MAXTRANSFERSIZE *\/
DECLARE @ts     int = 524288,   --512KB, par défaut = 1024KB
        @min_ts int = 524288,
        @max_ts int = 4194304;  --4MB

SELECT TOP 1
    @bs = COALESCE (block_size, 4096),
    @bc = COALESCE (buffer_count, 7),
    @ts = COALESCE (transfer_size, 524288)
FROM ##bt_results
ORDER BY id DESC;

WHILE (@bs <= @max_bs)
BEGIN
    WHILE (@bc <= @max_bc)
    BEGIN
        WHILE (@ts <= @max_ts)
        BEGIN
            SET @sql = REPLACE (REPLACE (REPLACE(@tmplt, N'{bs}', CAST(@bs AS nvarchar(50))), N'{bc}', CAST (@bc AS nvarchar(50))), N'{ts}', CAST (@ts AS nvarchar(50)));

            EXEC (@sql);

            INSERT INTO ##bt_results (start_date, finish_date, backup_size, compressed_size, block_size, buffer_count, transfer_size)
            SELECT TOP 1 backup_start_date, backup_finish_date, backup_size, compressed_backup_size,  @bs, @bc, @ts
            FROM msdb.dbo.backupset
            ORDER BY backup_set_id DESC;

            EXEC xp_cmdshell 'del "D:SQLServerbackupbt.bak"', no_output;

            SET @ts += @ts;
        END

        SET @bc += @bc;
        SET @ts = @min_ts;

        WAITFOR DELAY '00:00:05';
    END

    SET @bs += @bs;
    SET @bc = @min_bc;
    SET @ts = @min_ts;
END
Si vous avez besoin d'explications sur ce qui se passe ici, n'hésitez pas à me contacter en commentaire ou en message privé. Pour l'instant, je vais juste parler des paramètres que j'insère dans BACKUP DATABASE.
Pour BLOCKSIZE, nous avons une liste « fermée » de valeurs, et j'ai eu un échec de sauvegarde avec un BLOCKSIZE < 4 Ko. MAXTRANSFERSIZE peut être n'importe quel multiple de 64 Ko — de 64 Ko à 4 Mo. Par défaut, sur mon système, c'est 1024 Ko, j'ai pris 512 — 1024 — 2048 — 4096.
C'était plus compliqué avec BUFFERCOUNT — il peut être n'importe quel nombre entier positif, mais le lien mentionne Il est également dit comment obtenir des informations sur le BUFFERCOUNT réel utilisé pour la sauvegarde — pour moi, c'est 7. Il n'était pas judicieux de le réduire, et la limite supérieure a été découverte par essai et erreur — avec BUFFERCOUNT = 896 et MAXTRANSFERSIZE = 4194304, la sauvegarde a échoué avec une erreur (comme indiquée dans le lien ci-dessus) :
Msg 3013, Level 16, State 1, Line 7 La sauvegarde de la base de données se termine de manière anormale.
Msg 701, Level 17, State 123, Line 7 Il y a une mémoire système insuffisante dans le pool de ressources ‘default’ pour exécuter cette requête.
Pour comparaison, je vais d'abord montrer les résultats de l'exécution de la sauvegarde sans spécifier de paramètres :
BACKUP DATABASE [bt]
TO DISK = 'D:SQLServerbackupbt.bak'
WITH COMPRESSION;
Eh bien, c'est une sauvegarde :
Traitement de 1070072 pages pour la base de données ‘bt’, fichier ‘bt’ sur le fichier 1.
Traitement de 2 pages pour la base de données ‘bt’, fichier ‘bt_log’ sur le fichier 1.
BACKUP DATABASE a traité avec succès 1070074 pages en 53,171 secondes (157,227 Mo/sec).
Le script lui-même, qui teste les paramètres, a fonctionné pendant quelques heures, toutes les mesures se trouvent dans . Voici un extrait des résultats, avec les trois meilleurs temps d'exécution (j'ai essayé de faire un joli graphique, mais dans le post, je vais devoir me contenter d'un tableau, et dans les commentaires a ajouté ).
SELECT TOP 7 WITH TIES
    compressed_size,
    block_size,
    buffer_count,
    transfer_size,
    DATEDIFF(SECOND, start_date, finish_date) AS backup_time_sec
FROM ##bt_results
ORDER BY backup_time_sec ASC;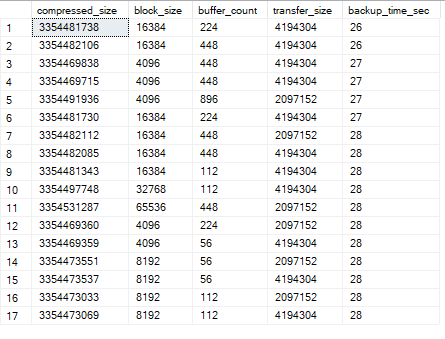
Attention, une remarque très importante dès le départ de de :
on peut affirmer avec certitude que la relation entre les paramètres et la vitesse de sauvegarde dans ces plages de valeurs est aléatoire, sans aucun schéma apparaissant. Mais s'éloigner des paramètres standard a manifestement eu un effet positif sur le résultat.
C'est-à-dire qu'en gérant simplement les paramètres standard de BACKUP, nous avons obtenu un gain dans le temps de création de la sauvegarde de 2 fois : 26 secondes, contre 53 au début. C'est pas mal, n'est-ce pas ? Mais il faut vérifier ce qui se passe avec la restauration. Et si maintenant la restauration prend 4 fois plus de temps ?
Pour commencer, mesurons combien de temps prend la restauration de la sauvegarde avec les paramètres par défaut :
RESTORE DATABASE [bt]
FROM DISK = 'D:SQLServerbackupbt.bak'
WITH REPLACE, RECOVERY;
Eh bien, vous savez déjà cela, les chemins là-bas, replace ou non, recovery ou non. Et voici comment cela se passe pour moi :
Traitement de 1070072 pages pour la base de données ‘bt’, fichier ‘bt’ sur le fichier 1.
Traitement de 2 pages pour la base de données ‘bt’, fichier ‘bt_log’ sur le fichier 1.
LA RESTAURATION DE LA BASE DE DONNÉES a traité avec succès 1070074 pages en 40,752 secondes (205,141 Mo/s).
Et maintenant j'essaierai de restaurer les sauvegardes, prises avec des BLOCKSIZE, BUFFERCOUNT et MAXTRANSFERSIZE modifiés.
BLOCKSIZE = 16384, BUFFERCOUNT = 224, MAXTRANSFERSIZE = 4194304LA RESTAURATION DE LA BASE DE DONNÉES a traité avec succès 1070074 pages en 32,283 secondes (258,958 Mo/s).
BLOCKSIZE = 4096, BUFFERCOUNT = 448, MAXTRANSFERSIZE = 4194304LA RESTAURATION DE LA BASE DE DONNÉES a traité avec succès 1070074 pages en 32,682 secondes (255,796 Mo/s).
BLOCKSIZE = 16384, BUFFERCOUNT = 448, MAXTRANSFERSIZE = 2097152LA RESTAURATION DE LA BASE DE DONNÉES a traité avec succès 1070074 pages en 32,091 secondes (260,507 Mo/s).
BLOCKSIZE = 4096, BUFFERCOUNT = 56, MAXTRANSFERSIZE = 4194304LA RESTAURATION DE LA BASE DE DONNÉES a traité avec succès 1070074 pages en 32,401 secondes (258,015 Mo/s).
L'instruction RESTORE DATABASE lors de la restauration ne change pas, ces paramètres ne sont pas spécifiés, SQL Server les détermine par rapport à la sauvegarde. Et il est visible que même lors de la restauration, il peut y avoir un gain — pratiquement 20% plus rapide (franchement, je n'ai pas passé beaucoup de temps à la restauration, j'ai testé quelques-unes des sauvegardes les plus "rapides" et j'ai constaté qu'il n'y avait pas de dégradation).
Au cas où je préciserais - ici ne sont pas décrits des paramètres optimaux pour tous. Vous ne pouvez obtenir que des paramètres optimaux pour vous-même par des tests. J'ai obtenu ces résultats, vous obtiendrez d'autres. Mais vous voyez que vos sauvegardes peuvent être "optimisées" et qu'elles peuvent vraiment être créées et restaurées plus rapidement.
Je recommande également fortement de lire la documentation dans son intégralité, car il peut y avoir des nuances spécifiques à votre système.
Puisque j'ai commencé à écrire sur les sauvegardes, je veux tout de suite parler d'une autre "optimisation" qui apparaît plus souvent que le "réglage" des paramètres (il semble que, autant que je comprends, au moins une partie des utilitaires de sauvegarde l'utilise, peut-être avec les paramètres décrits précédemment), mais elle n'a pas encore été décrite sur Habr.
Si l'on regarde la deuxième ligne de la documentation, juste en dessous de BACKUP DATABASE, nous voyons :
TO [, ... n]Que pensez-vous qu'il se passera si vous spécifiez plusieurs backup_device ? La syntaxe le permet. Mais quelque chose de très intéressant se produira — la sauvegarde sera simplement "répartie" sur plusieurs appareils. En d'autres termes, chaque "appareil" séparément sera inutilisable, si l'un est perdu, la sauvegarde entière est perdue. Mais quelle influence cette répartition aura-t-elle sur la vitesse de sauvegarde ?
Essayons de faire une sauvegarde sur deux "appareils" qui sont côte à côte dans le même dossier :
BACKUP DATABASE [bt]
TO
    DISK = 'D:SQLServerbackupbt1.bak',
    DISK = 'D:SQLServerbackupbt2.bak'
WITH COMPRESSION;
Mon Dieu, que se passe-t-il ?
Traitement de 1070072 pages pour la base de données ‘bt’, fichier ‘bt’ sur le fichier 1.
2 pages traitées pour la base de données ‘bt’, fichier ‘btlog’ sur le fichier 1.
SAUVEGARDE DE LA BASE DE DONNÉES traitée avec succès, 1070074 pages en 40,092 secondes (208,519 Mo/s).
La sauvegarde a été effectuée 25 % plus rapidement sans raison apparente ? Que se passerait-il si l'on ajoutait encore quelques appareils ?
SAUVEGARDE DE LA BASE DE DONNÉES [bt]
À
    DISQUE = 'D:SQLServerbackupbt1.bak',
    DISQUE = 'D:SQLServerbackupbt2.bak',
    DISQUE = 'D:SQLServerbackupbt3.bak',
    DISQUE = 'D:SQLServerbackupbt4.bak'
AVEC COMPRESSION;
SAUVEGARDE DE LA BASE DE DONNÉES traitée avec succès, 1070074 pages en 34,234 secondes (244,200 Mo/s).
En tout, un gain d'environ 35 % du temps de sauvegarde simplement parce que la sauvegarde est écrite directement dans 4 fichiers sur un même disque. J'ai vérifié un plus grand nombre — sur mon portable, le gain n'est pas présent, 4 appareils semblent optimaux. Pour vous — je ne sais pas, il faut vérifier. Et d'ailleurs, si vous avez ces appareils — ce sont vraiment des disques différents, félicitations, le gain devrait être encore plus considérable.
Maintenant parlons de la façon de restaurer ce bonheur. Pour cela, il faudra changer la commande de restauration et énumérer tous les appareils :
RESTORE DATABASE [bt]
DE
    DISQUE = 'D:SQLServerbackupbt1.bak',
    DISQUE = 'D:SQLServerbackupbt2.bak',
    DISQUE = 'D:SQLServerbackupbt3.bak',
    DISQUE = 'D:SQLServerbackupbt4.bak'
AVEC REPLACEMENT, RÉCUPÉRATION;
LA RESTAURATION DE LA BASE DE DONNÉES a été traitée avec succès, 1070074 pages en 38,027 secondes (219,842 Mo/s).
Un peu plus rapide, mais à peu près au même niveau, pas de manière significative. En général, la sauvegarde est plus rapide, mais la restauration se fait de la même manière — est-ce un succès ? Pour moi, c'est un succès tout à fait acceptable. C'est important, donc je le répète — si vous perdez ne serait-ce qu'un de ces fichiers — vous perdez toute la sauvegarde..
Si vous examinez les informations de sauvegarde dans le journal, affichées à l'aide des Trace Flags 3213 et 3605, vous remarquerez qu'en sauvegardant sur plusieurs appareils, au moins la quantité de BUFFERCOUNT augmente. Peut-être que l'on peut essayer de mieux ajuster les paramètres pour BUFFERCOUNT, BLOCKSIZE, MAXTRANSFERSIZE, mais je n'ai pas réussi immédiatement, et répéter un tel test pour différents nombres de fichiers m'a semblé fatigant. Et j'ai encore de la peine pour les disques. Si vous souhaitez organiser de tels tests chez vous, il n'est pas difficile de modifier le script.
Enfin, parlons du prix. Si la sauvegarde est effectuée parallèlement au travail des utilisateurs, il est essentiel de bien tester, car si la sauvegarde va plus vite — les disques sont plus sollicités, la charge sur le processeur augmente (il faut encore compresser tout cela à la volée), donc la réactivité globale du système diminue.
Les blagues mises à part, je comprends parfaitement que je n'ai rien révélé de nouveau. Ce qui est écrit ci-dessus n'est qu'une démonstration de la façon de trouver les paramètres optimaux pour effectuer des sauvegardes.
Rappelez-vous que tout ce que vous faites, vous le faites à vos propres risques. Vérifiez vos sauvegardes et n'oubliez pas de faire un DBCC CHECKDB.
Source : habr.com
