

Dans son rapport, Andreï Borodin expliquera comment ils ont pris en compte l'expérience de mise à l'échelle de PgBouncer lors de la conception du pooler de connexions. , comment ils l'ont déployé en production. De plus, nous discuterons des fonctionnalités que nous aimerions voir dans les nouvelles versions du pooler : il est important pour nous non seulement de satisfaire nos besoins, mais aussi de faire évoluer la communauté des utilisateurs. .
Vidéo :
Bonjour à tous ! Je m'appelle Andreï.
Chez Yandex, je travaille sur le développement de bases de données open source. Aujourd'hui, notre sujet porte sur le pooler de connexions.
Si vous savez comment appeler un pooler de connexions en russe, faites-le moi savoir. Je suis vraiment désireux de trouver un bon terme technique qui devrait s'établir dans la littérature technique.
Le sujet est assez complexe, car dans de nombreuses bases de données, le pooler de connexions est intégré et il n'est même pas nécessaire d'en être informé. Certaines configurations existent partout, mais cela ne fonctionne pas ainsi dans Postgres. En parallèle (à HighLoad++ 2019), il y a une présentation de Nikolai Samokhvalov sur la configuration des requêtes dans Postgres. Je comprends que les personnes ici ont déjà configuré les requêtes de manière optimale, et ce sont des personnes qui rencontrent des problèmes système plus rares liés au réseau et à l'utilisation des ressources. Parfois, cela peut être assez compliqué au niveau de la clarté des problèmes.
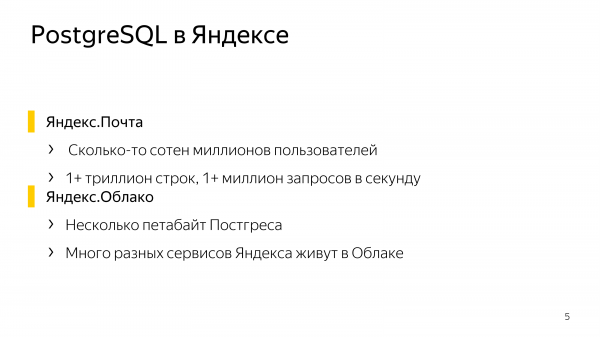
Yandex dispose de Postgres. Dans Yandex.Cloud, vivent de nombreux services de Yandex. Nous avons plusieurs pétaoctets de données, qui génèrent pas moins d'un million de requêtes par seconde dans Postgres.
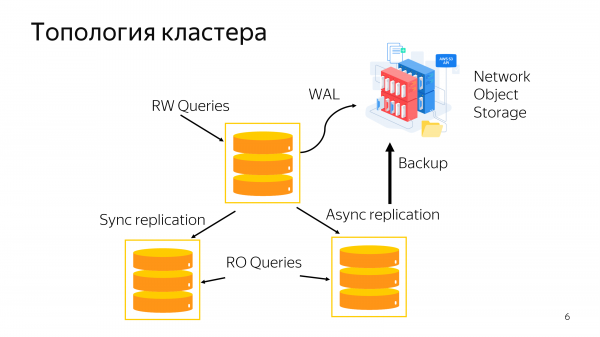
Nous fournissons un cluster assez typique à tous les services – il s'agit de la nœud principal primaire, de deux répliques ordinaires (synchrones et asynchrones), d'une sauvegarde et de la mise à l'échelle des requêtes de lecture sur la réplique.
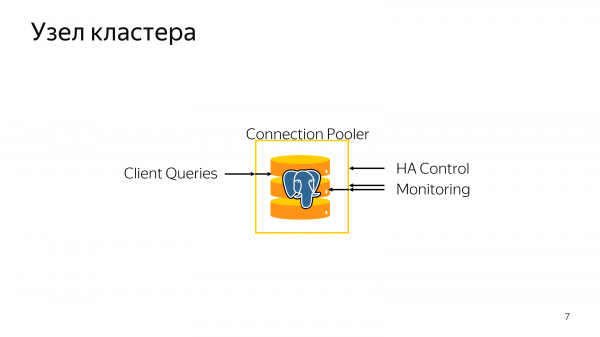
Chaque nœud du cluster est un Postgres, sur lequel, en plus de Postgres et des systèmes de surveillance, un pooler de connexions est également installé. Le pooler de connexions est utilisé pour le fencing et pour sa fonction principale.
Quelle est la fonction principale d'un pooler de connexions ?
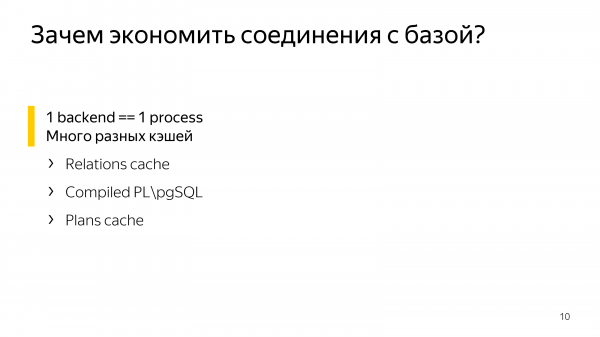
Dans Postgres, un modèle de processus est adopté pour travailler avec la base de données. Cela signifie qu'une connexion équivaut à un processus, un backend Postgres. Et dans ce backend, il y a de nombreux caches différents, qui sont assez coûteux à créer de manière distincte pour différentes connexions.
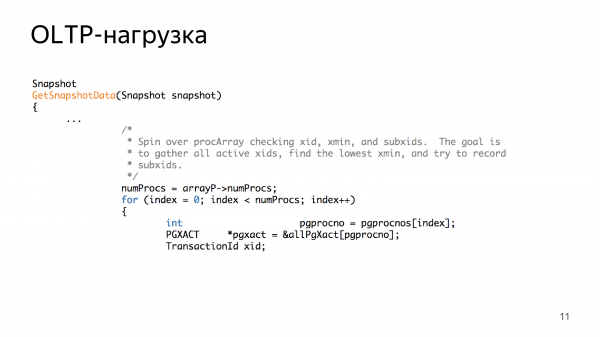
En outre, dans le code de Postgres, il y a un tableau appelé procArray. Il contient les principales informations sur les connexions réseau. Et presque tous les algorithmes de traitement de procArray ont une complexité linéaire, parcourant l'ensemble du tableau des connexions réseau. C'est une boucle assez rapide, mais avec un grand nombre de connexions réseau entrantes, cela devient un peu plus coûteux. Et quand cela devient un peu plus coûteux, au final, on peut payer un très gros prix pour un grand nombre de connexions réseau.
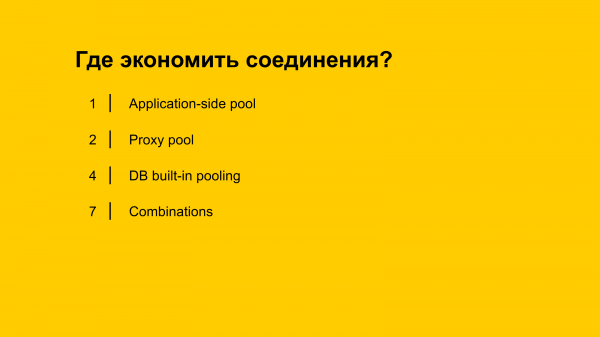
Il existe trois approches possibles :
- Du côté de l'application.
- Du côté de la base de données.
- Et entre les deux, c'est-à-dire toutes sortes de combinaisons.
Malheureusement, le pooler intégré est actuellement en cours de développement. Les amis de l'entreprise PostgreSQL Professional s'en occupent principalement. Quand il sera disponible, il est difficile de le prédire. Et en fait, l'architecte a deux solutions à choisir. C'est un pool d'application et un pool proxy.
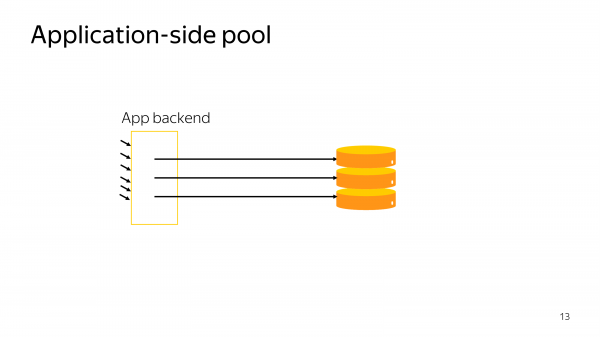
Le pool d'application est la méthode la plus simple. Et presque tous les pilotes clients vous fournissent un moyen de représenter des millions de vos connexions dans le code sous forme de quelques dizaines de connexions à la base de données.
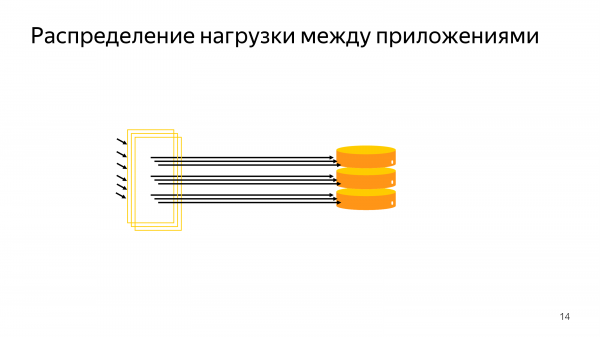
Le problème se pose lorsque, à un moment donné, vous voulez faire évoluer le backend, vous voulez le déployer sur plusieurs machines virtuelles.
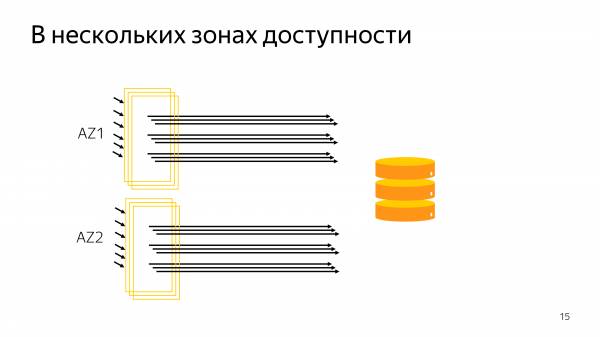
Ensuite, vous réalisez également que vous avez plusieurs zones de disponibilité, plusieurs centres de données. Et l'approche de pooling côté client conduit à de grands chiffres. De grands chiffres, c'est environ 10 000 connexions. C'est la limite qui peut fonctionner normalement.
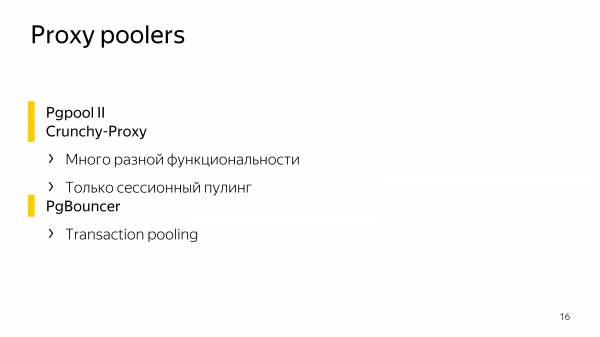
En ce qui concerne les poolers proxy, il existe deux poolers qui savent faire beaucoup de choses. Ce ne sont pas seulement des poolers. Ce sont des poolers + d'autres fonctionnalités intéressantes. Ce sont et .
Mais, malheureusement, cette fonctionnalité supplémentaire n'est pas nécessaire pour tout le monde. Et cela conduit à ce que les poolers ne prennent en charge que le pooling par session, c'est-à-dire un client entrant, un client sortant vers la base de données.
Pour nos besoins, ce n'est pas très adapté, c'est pourquoi nous utilisons PgBouncer, qui met en œuvre le pooling de transactions, c'est-à-dire que les connexions serveur sont associées aux connexions clients uniquement pendant la transaction.
Et sous notre charge, c'est vrai. Mais il y a quelques problèmes..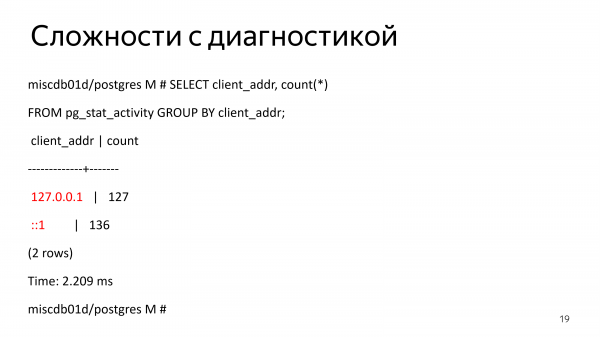
Les problèmes commencent lorsque vous voulez diagnostiquer une session, car toutes les connexions entrantes sont locales. Elles proviennent toutes du loopback et il devient difficile de tracer la session.
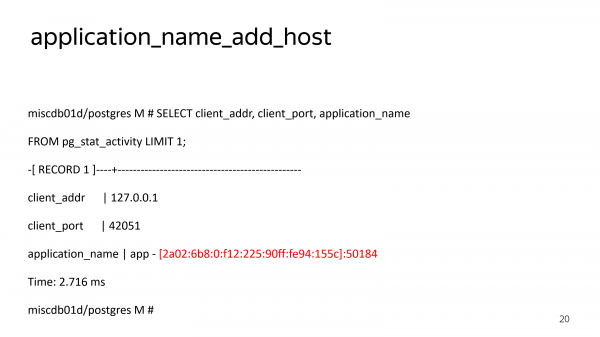
Bien sûr, vous pouvez utiliser application_name_add_host. C'est une méthode côté Bouncer pour ajouter une adresse IP à application_name. Mais application_name est établi par une connexion supplémentaire.
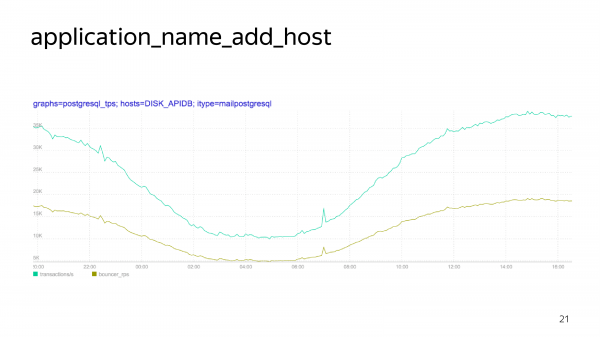
Dans ce graphique, où la ligne jaune représente les requêtes réelles, tandis que la ligne bleue montre les requêtes qui atteignent la base de données. Et cette différence représente l'établissement de application_name, qui est nécessaire uniquement pour le suivi, mais qui n'est pas gratuit du tout.
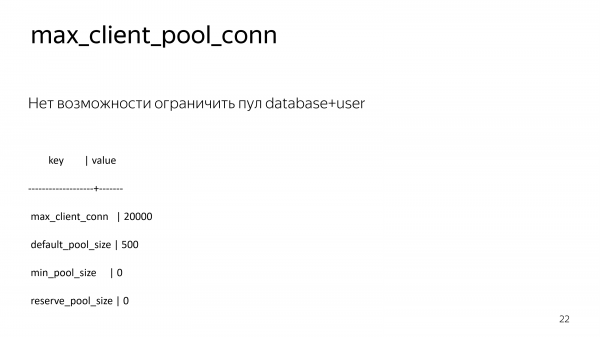
De plus, dans Bouncer, il n'est pas possible de limiter un pool, c'est-à-dire de restreindre le nombre de connexions à la base de données pour un utilisateur spécifique, pour une base de données spécifique.
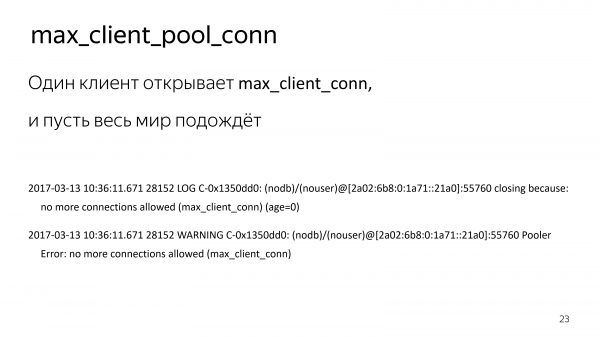
À quoi cela mène-t-il ? Vous avez un service sous forte charge, écrit en C++, et juste à côté, un petit service en Node qui ne fait rien de grave avec la base, mais son driver devient fou. Il ouvre 20 000 connexions, et le reste attendra. Votre code est même correct.
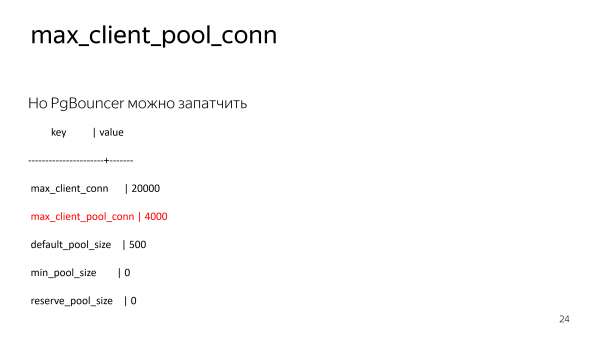
Bien sûr, nous avons écrit un petit correctif pour Bouncer qui a ajouté ce paramètre, c'est-à-dire la limitation des clients sur le pool.
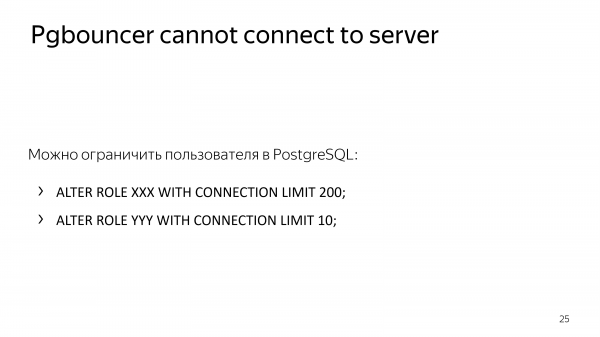
On pourrait le faire côté Postgres, c'est-à-dire limiter les rôles dans la base de données par le nombre de connexions.
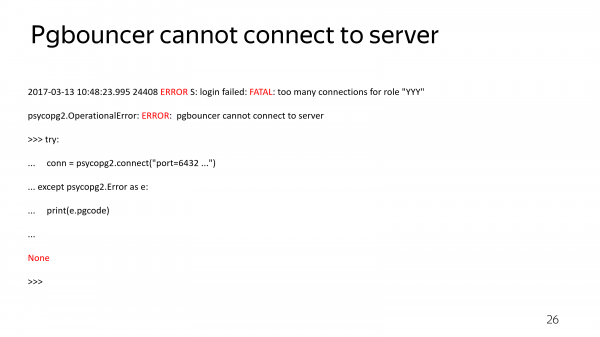
Mais alors, vous perdez la possibilité de comprendre pourquoi vous n'avez pas de connexions avec le serveur. PgBouncer ne passe pas l'erreur de connexion ; il renvoie toujours la même information. Et vous ne pouvez pas comprendre : peut-être que votre mot de passe a changé, peut-être que la base est simplement en panne, peut-être que quelque chose ne va pas. Mais il n'y a aucun diagnostic. Si la session ne peut pas être établie, vous ne saurez pas pourquoi cela ne peut pas être fait.
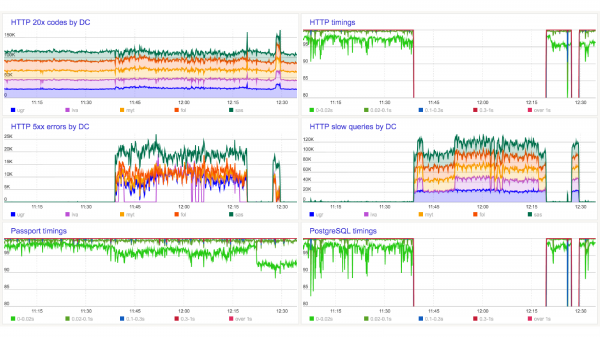
À un moment donné, vous regardez les graphiques de l'application et vous constatez que l'application ne fonctionne pas.
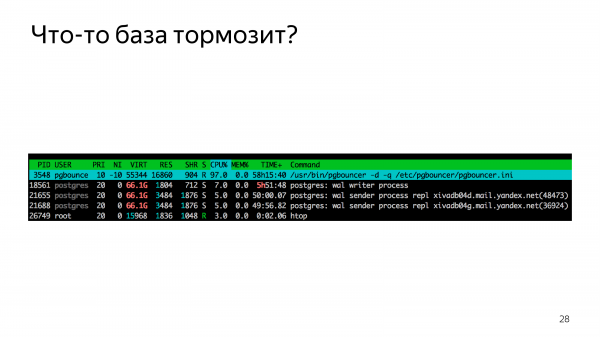
Vous regardez le top et voyez que Bouncer est monoculture. C'est un moment charnière dans la vie du service. Vous réalisez que vous vous prépariez à l'évolutivité de la base de données dans un an et demi, mais vous devez évoluer le pooler.
Nous en sommes venus à la conclusion qu'il nous fallait davantage de PgBouncer.
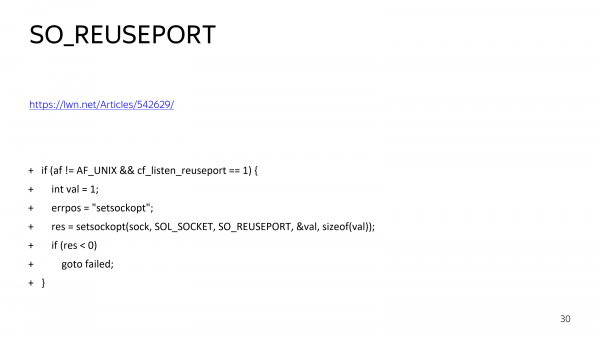
Nous avons légèrement corrigé Bouncer.
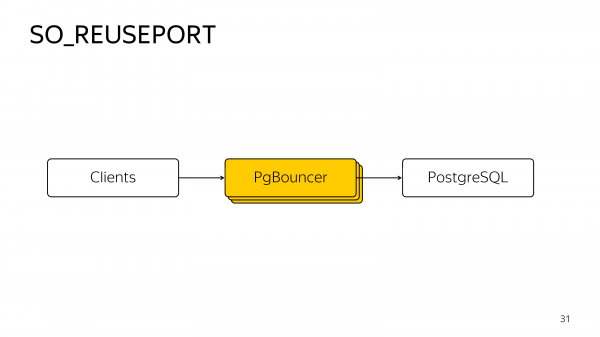
Et nous avons mis en place la possibilité de démarrer plusieurs Bouncers en réutilisant le port TCP. Et déjà, le système d'exploitation gère automatiquement les connexions TCP entrantes entre eux en round-robin.
C'est transparent pour les clients, c'est-à-dire que tout semble comme si vous aviez un seul Bouncer, mais vous avez une fragmentation des connexions idle entre les Bouncers en cours d'exécution.
Et à un certain moment, vous pouvez remarquer que ces 3 Bouncers consomment chacun leur cœur à 100 %. Vous avez besoin d'un nombre assez important de Bouncers. Pourquoi ?
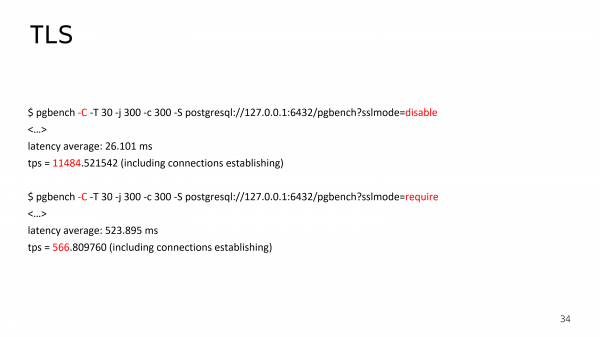
Parce que vous avez TLS. Vous avez une connexion chiffrée. Et si vous faites un benchmark de Postgres avec TLS et sans TLS, vous constaterez que le nombre de connexions établies chute de presque deux ordres de grandeur avec l'activation du chiffrement, car la poignée de main TLS consomme des ressources CPU.
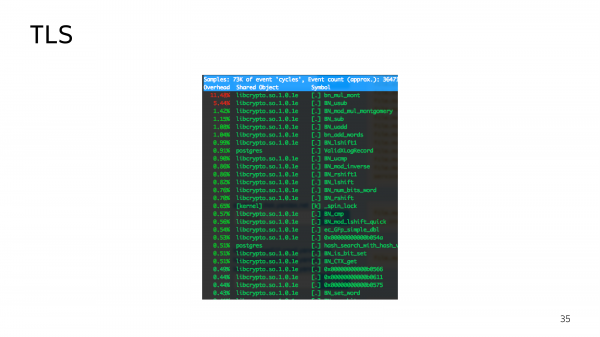
Et en haut, vous pouvez voir pas mal de fonctions cryptographiques qui s'exécutent lors d'une vague de connexions entrantes. Puisque notre primaire peut basculer entre les zones de disponibilité, une vague de connexions entrantes est une situation assez typique. C'est-à-dire que pour une raison quelconque, l'ancien primaire était inaccessible, et toute la charge a été envoyée vers un autre centre de données. Ils viendront tous en même temps saluer avec TLS.
Et un grand nombre de poignées de main TLS peut ne pas saluer le Bouncer, mais plutôt lui serrer la gorge. En raison du délai d'expiration, la vague de connexions entrantes peut devenir persistante. Si vous avez un nouveau essai dans la base sans retour exponentiel, elles n'arriveront pas encore et encore comme une vague cohérente.
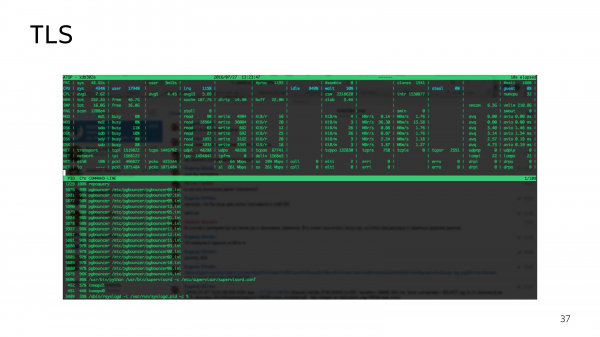
Voici un exemple de 16 PgBouncer, qui chargent 16 cœurs à 100 %.
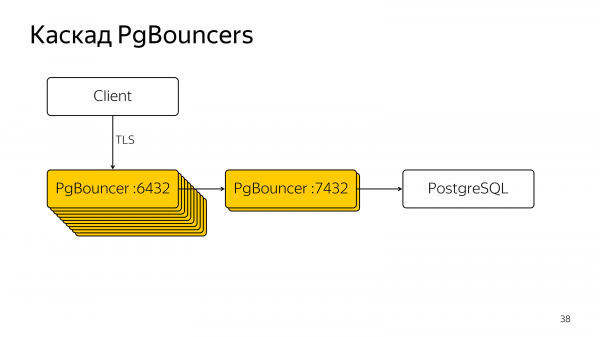
Nous avons abouti à un PgBouncer en cascade. C'est la meilleure configuration que l'on puisse atteindre avec notre charge de Bouncer. Les Bouncers externes sont là pour la poignée de main TCP, tandis que les Bouncers internes sont là pour le pooling réel, afin de ne pas trop fragmenter les connexions externes.
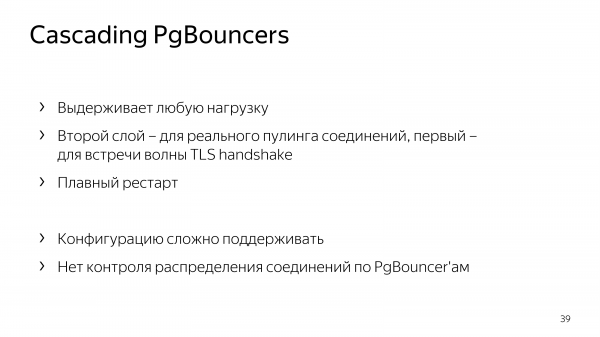
Avec cette configuration, un redémarrage en douceur est possible. Vous pouvez redémarrer ces 18 Bouncers un par un. Mais maintenir une telle configuration est assez difficile. Les administrateurs système, DevOps, et les personnes qui portent vraiment la responsabilité de ce serveur ne seront pas très heureux de ce schéma.
Il semblerait que nous pouvons promouvoir toutes nos améliorations en open source, mais le Bouncer n'est pas très bien supporté. Par exemple, la possibilité de lancer plusieurs PgBouncers sur un même port a été engagée il y a un mois. Et la demande de tirage pour cette fonctionnalité date de quelques années.
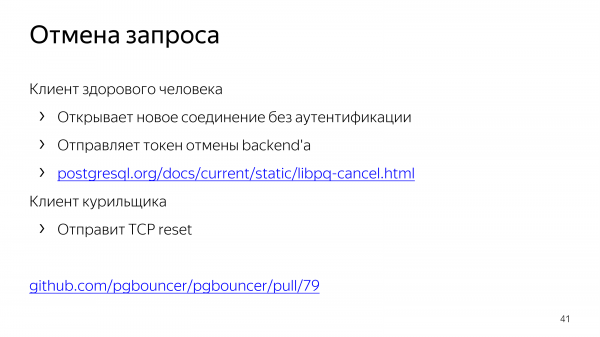
Ou un autre exemple. Dans Postgres, vous pouvez annuler une requête en cours en envoyant un secret par une autre connexion sans authentification supplémentaire. Mais certains clients envoient simplement un reset TCP, ce qui signifie qu'ils coupent la connexion réseau. Que fera alors Bouncer ? Il ne fera rien. Il continuera d'exécuter la requête. Si vous avez un grand nombre de connexions qui, avec des petites requêtes, ont mis la base à l'arrêt, il ne suffira pas de couper la connexion avec Bouncer, il faudra également terminer les requêtes en cours dans la base.
Cela a été corrigé et ce problème n'a toujours pas été fusionné dans l'upstream de Bouncer.
Ainsi, nous en sommes venus à la nécessité de disposer de notre propre pool de connexions, qui pourra évoluer, être corrigé, dans lequel nous pourrons rapidement résoudre les problèmes et qui, bien sûr, devra être multithread.
Le multithreading a été défini comme notre objectif principal. Nous devons pouvoir gérer efficacement une vague d'entrées de connexions TLS.
Pour cela, nous avons dû développer une bibliothèque distincte appelée Machinarium, qui est destinée à décrire les états machines d'une connexion réseau sous forme de code séquentiel. Si vous regardez le code source de libpq, vous verrez des appels plutôt complexes qui peuvent vous renvoyer un résultat et dire : "Appelle-moi un peu plus tard. Pour l'instant, j'ai des opérations d'E/S, mais quand les E/S seront terminées, j'aurai une charge pour le processeur." C'est un schéma multilevel. Les interactions réseau sont généralement décrites par une machine à états. Un ensemble de règles comme "Si j'ai reçu un en-tête de paquet de taille N, alors j'attends maintenant N octets", "Si j'ai envoyé un paquet SYNC, alors j'attends maintenant un paquet avec les métadonnées de résultat". Cela donne un code assez difficile et contre-intuitif, comme si un labyrinthe était transformé en un dépliant linéaire. Nous avons fait en sorte que, au lieu d'une machine à états, le programmeur décrive le chemin principal d'interaction sous la forme d'un code impératif ordinaire. Seulement dans ce code impératif, il faut insérer des endroits où la séquence d'exécution doit être interrompue en attendant des données du réseau, en passant le contexte d'exécution à une autre coroutine (green thread). Cette approche est semblable à celle où nous écrivons successivement le chemin le plus attendu dans le labyrinthe, puis ajoutons des embranchements.
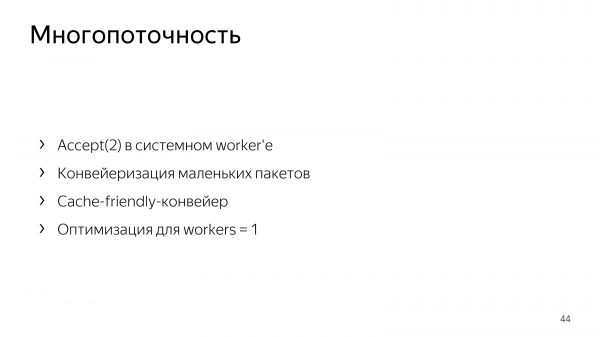
En fin de compte, nous avons un flux qui effectue un accept TCP et répartit les connexions TCP entre plusieurs workers de manière round-robin.
Chaque connexion client fonctionne toujours sur un seul processeur. Cela permet de le rendre plus adapté à la gestion du cache.
De plus, nous avons légèrement amélioré la collecte des petits paquets en un seul grand paquet afin de décharger la pile TCP système.
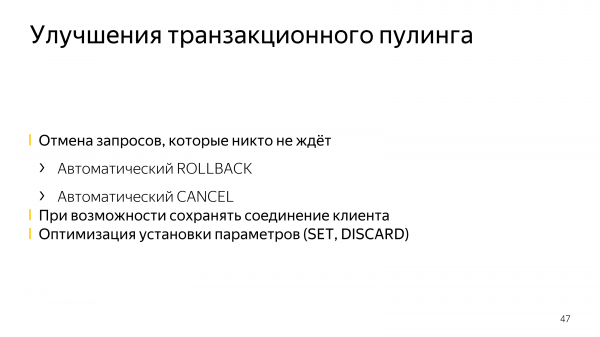
Par ailleurs, nous avons amélioré le pooling transactionnel en permettant à Odyssey, avec la configuration appropriée, d'envoyer CANCEL et ROLLBACK en cas de rupture de la connexion réseau, c'est-à-dire que si personne n'attend la requête, Odyssey demande à la base de ne pas exécuter cette requête qui pourrait consommer des ressources précieuses.
Dans la mesure du possible, nous maintenons les connexions avec le même client. Cela évite la réinitialisation de application_name_add_host. Si possible, nous n'avons pas de réinitialisation supplémentaire des paramètres nécessaires pour le diagnostic.
Nous travaillons dans l'intérêt de Yandex.Cloud. Si vous utilisez PostgreSQL géré et avez installé un pool de connexions, vous pouvez établir une réplication logique externe, c'est-à-dire vous éloigner de nous si vous le souhaitez, à l'aide de la réplication logique. Le Bouncer ne transmettra pas le flux de réplication logique vers l'extérieur.
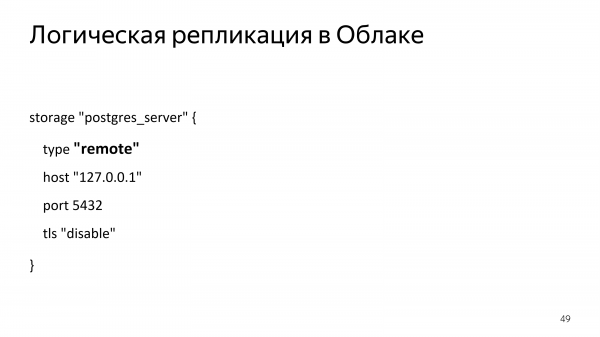
Voici un exemple de configuration de réplication logique.
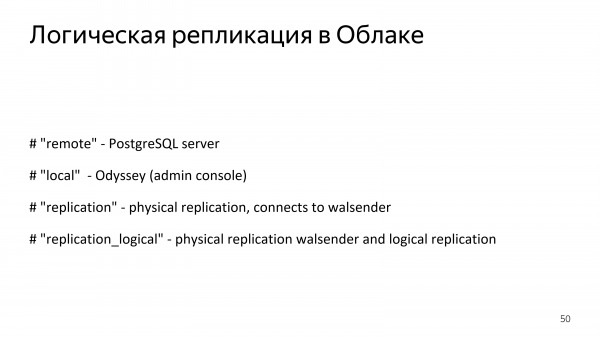
De plus, nous supportons la réplication physique vers l'extérieur. Dans le Cloud, cela est bien sûr impossible, car alors votre cluster communiquerait trop d'informations sur lui-même. Mais dans vos installations, si vous avez besoin d'une réplication physique via un pool de connexions dans Odyssey, c'est possible.
Odyssey est entièrement compatible avec la surveillance de PgBouncer. Nous avons une console qui exécute presque toutes les mêmes commandes. Si quelque chose manque, envoyez une demande de tirage ou même un problème sur GitHub, nous compléterons les commandes nécessaires. Mais la fonctionnalité principale de la console PgBouncer est déjà disponible chez nous.
Et bien sûr, nous avons le transfert d'erreurs. Nous renverrons l'erreur signalée par la base. Vous obtiendrez des informations sur les raisons pour lesquelles vous n'accédez pas à la base, et pas seulement que vous n'y accédez pas.
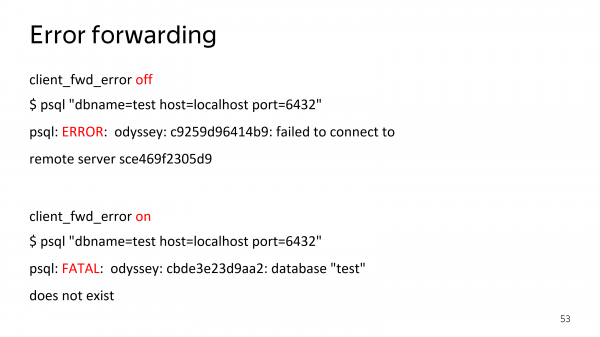
Cette fonctionnalité peut être désactivée si vous avez besoin d'une compatibilité à 100 % avec PgBouncer. Nous pouvons nous comporter de la même manière que Bouncer, juste par précaution.
Développement
Quelques mots sur le code source d'Odyssey.
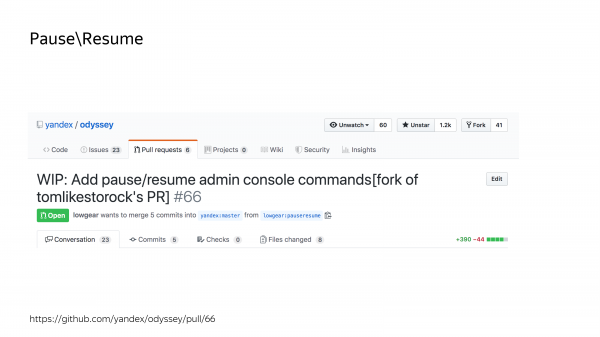
Par exemple, il existe des commandes « Pause / Reprendre ». Elles sont généralement utilisées pour mettre à jour la base de données. Si vous devez mettre à jour Postgres, vous pouvez le mettre en pause dans le pool de connexions, effectuer un pg_upgrade, puis le reprendre. Du côté client, cela ressemblera à une simple lenteur de la base de données. Cette fonctionnalité nous a été apportée par des membres de la communauté. Elle n'est pas encore fusionnée, mais cela viendra bientôt. (Déjà fusionnée)
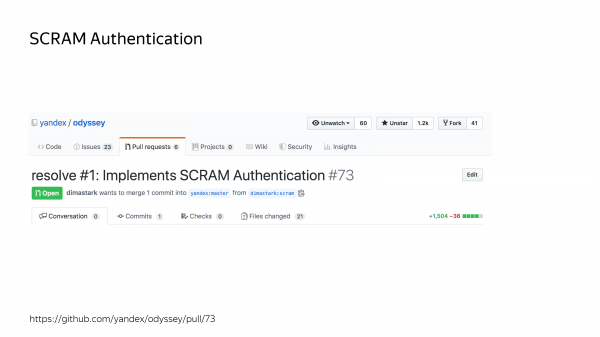
— déjà fusionnée
De plus, l'une des nouvelles fonctionnalités de PgBouncer est la prise en charge de l'authentification SCRAM, également apportée par quelqu'un qui ne travaille pas chez Yandex.Cloud. Les deux sont des fonctionnalités complexes et importantes.
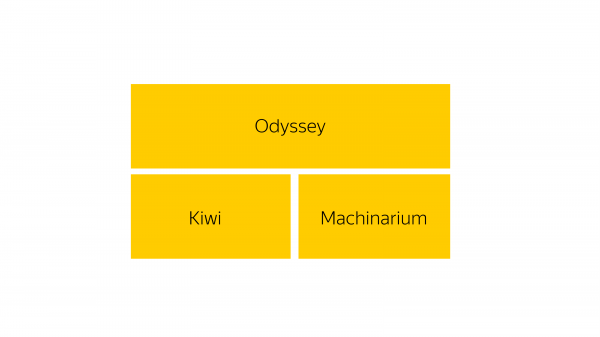
C'est pourquoi je souhaite expliquer comment Odyssey est conçu, peut-être que vous souhaitez également écrire un peu de code.
Vous avez une base Odyssey de base qui repose sur deux bibliothèques principales. La bibliothèque Kiwi est une implémentation du protocole de message de Postgres. C'est-à-dire que le proto natif 3 de Postgres représente les messages standards que les frontaux et les backends peuvent échanger. Ils sont implémentés dans la bibliothèque Kiwi.
La bibliothèque Machinarium est une bibliothèque d'implémentation de flux. Un petit fragment de ce Machinarium est écrit en assembleur. Mais, ne vous inquiétez pas, cela ne fait que 15 lignes.
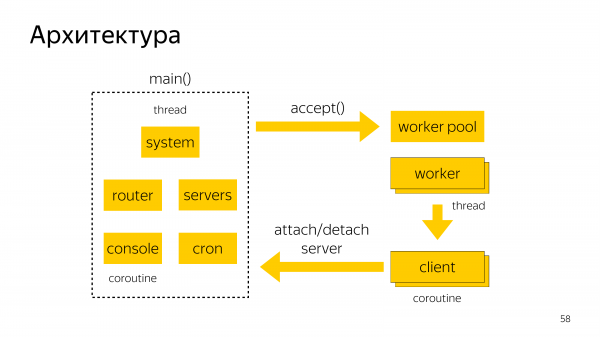
Architecture d'Odyssey. Il y a une machine principale où des coroutines sont exécutées. Dans cette machine, l'acceptation des connexions TCP entrantes et la répartition vers des workers sont réalisées.
À l'intérieur d'un worker, un gestionnaire de plusieurs clients peut fonctionner. De plus, le fil principal gère la console et le traitement des tâches cron pour supprimer les connexions qui ne sont plus nécessaires dans le pool.
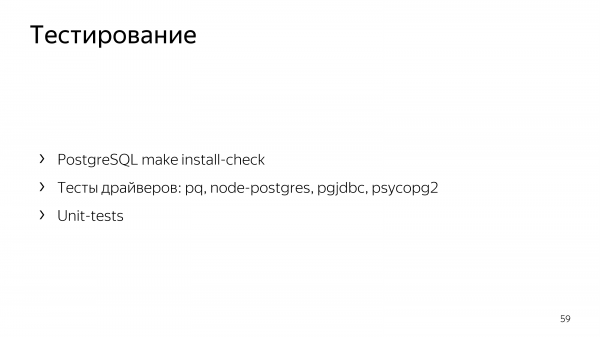
Pour tester Odyssey, nous utilisons un ensemble standard de tests de Postgres. Il suffit de lancer install-check via Bouncer et via Odyssey, nous obtenons un div nul. Certains tests liés à la formatage des dates ne passent pas de la même manière dans Bouncer et dans Odyssey.
De plus, il existe de nombreux pilotes qui ont leurs propres tests. Nous utilisons leurs tests pour tester Odyssey.
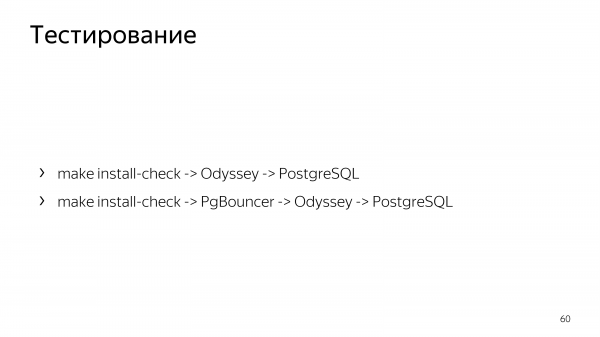
En outre, en raison de notre configuration en cascade, nous devons tester différentes combinaisons : Postgres + Odyssey, PgBouncer + Odyssey, Odyssey + Odyssey, pour nous assurer que si Odyssey se trouve à un moment donné dans une partie de la cascade, il continue de fonctionner comme prévu.
Rake
Nous utilisons Odyssey en production. Il ne serait pas juste de dire que tout fonctionne parfaitement. Non, c'est-à-dire oui, mais pas toujours. Par exemple, en production, tout fonctionnait simplement, puis nos amis de PostgreSQL Professional sont venus et ont dit que nous avions une fuite de mémoire. C'était vrai, nous l'avons corrigée. Mais c'était juste.
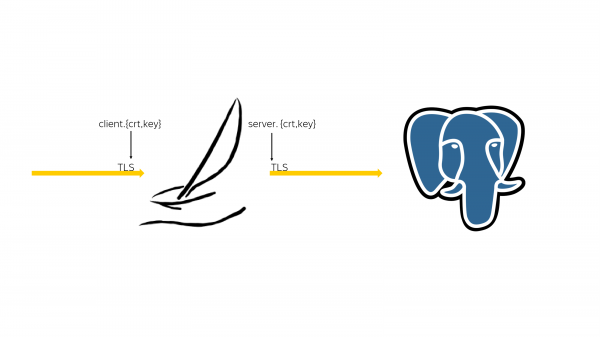
Ensuite, nous avons découvert qu'il y avait des connexions TLS entrantes et sortantes dans le pool de connexions. Et pour ces connexions, des certificats clients et des certificats serveurs sont nécessaires.
Les certificats serveurs Bouncer et Odyssey les relisent à partir de leur pcache, mais il n'est pas nécessaire de relire les certificats clients à partir de pcache, car notre Odyssey scalable se heurte finalement à la performance système de lecture de ce certificat. Cela a été une surprise pour nous, car cela ne s'est pas produit immédiatement. Au début, il évoluait de manière linéaire, mais après 20 000 connexions simultanées entrantes, ce problème s'est manifesté.
La méthode d'authentification pluggable est la possibilité de s'authentifier avec les outils intégrés à Linux. Dans PgBouncer, elle est implémentée de telle manière qu'il y a un thread séparé pour attendre la réponse de PAM, et il y a le thread principal de PgBouncer qui gère la connexion en cours et peut demander d'attendre dans le thread PAM.
Nous ne l'avons pas mise en œuvre pour une raison assez simple. Nous avons beaucoup de threads. Pourquoi en aurions-nous besoin ?
Cela peut finalement poser des problèmes, car si vous avez une authentification PAM et une authentification non-PAM, une grande vague d'authentification PAM peut considérablement retarder l'authentification non-PAM. C'est l'une des choses que nous n'avons pas corrigées. Mais si vous voulez le corriger, vous pouvez vous en occuper.
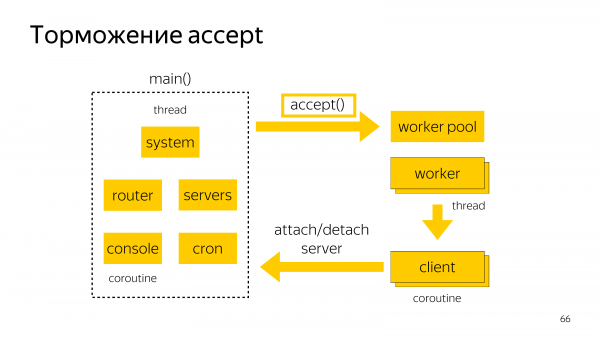
Un autre souci était que nous avons un thread qui accepte toutes les connexions entrantes. Et ensuite, il les transmet à un pool de workers, où se déroulera la poignée de main TLS.
Ainsi, si vous avez une vague cohérente de 20 000 connexions réseau, elles seront toutes acceptées. Et du côté client, libpq commencera à compter les délais d'attente. Par défaut, il semble que cela soit réglé sur 3 secondes.
S'ils ne peuvent pas tous accéder simultanément à la base de données, ils ne peuvent pas y accéder, car tout cela peut être couvert par des essais non exponentiels.
Nous en sommes arrivés à copier ici le schéma de PgBouncer en limitant le nombre de connexions TCP que nous acceptons.
Si nous constatons que nous acceptons des connexions, mais qu'elles ne parviennent finalement pas à établir le handshake, nous les plaçons dans une file d'attente afin qu'elles ne consomment pas les ressources du processeur central. Cela entraîne le fait que le handshake simultané peut ne pas être effectué pour toutes les connexions arrivées. Mais au moins, certaines seront ajoutées à la base, même si la charge est suffisamment élevée.
feuille de route
Que souhaiteriez-vous voir à l'avenir dans Odyssey ? Quelles sont nos compétences en développement et quelles attentes avons-nous vis-à-vis de la communauté ?
En août 2019.
Voici à quoi ressemblait la feuille de route d'Odyssey en août :
- Nous voulions une authentification SCRAM et PAM.
- Nous voulions transmettre les requêtes de lecture à standby.
- Nous aimerions un redémarrage en ligne.
- Et la possibilité de faire une pause sur le serveur.
La moitié de cette feuille de route est réalisée, et cela ne vient pas de nous. Et c'est bien. Maintenant, discutons de ce qui reste à faire et ajoutons encore.
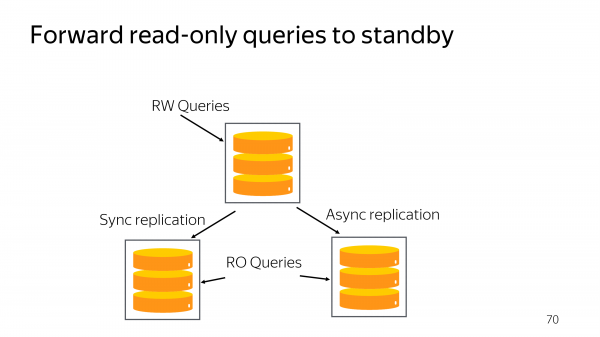
? У нас есть реплики, которые без выполнения запросов будут просто греть воздух. Они нам необходимы для обеспечения failover и switchover. В случае проблем в одном из дата-центре хотелось бы их занять какой-то полезной работой. Потому что те же самые центральные процессоры, ту же самую память мы не можем сконфигурировать по-другому, потому что иначе не будет работать репликация.
En gros, dans Postgres, à partir de la version 10, il est possible de spécifier des session_attrs lors de la connexion. Vous pouvez lister tous les hôtes de bases de données dans la connexion et indiquer pourquoi vous allez dans la base de données : pour écrire ou uniquement lire. Et le driver choisira automatiquement le premier hôte de la liste qui convient à ses exigences.
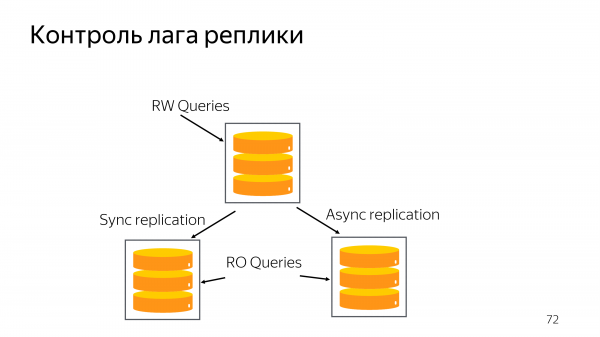
Mais le problème de cette approche est qu'elle ne contrôle pas le retard de réplication. Vous pourriez avoir une réplique qui est en retard d'un temps inacceptable pour votre service. Pour permettre l'exécution fonctionnelle des requêtes de lecture sur la réplique, nous devons essentiellement prendre en charge dans Odyssey la possibilité de ne pas fonctionner lorsque la lecture n'est pas possible.
Odyssey doit parfois interroger la base de données et demander la distance de réplication par rapport au primaire. Et si elle atteint une valeur limite, de nouvelles requêtes à la base ne doivent pas être autorisées, il faut dire au client de réinitialiser les connexions et éventuellement choisir un autre hôte pour exécuter les requêtes. Cela permettra à la base de récupérer plus rapidement le retard de réplication et de revenir pour répondre aux requêtes.
Il est difficile d'estimer les délais d'implémentation, car c'est open source. Mais j'espère que ce ne sera pas 2,5 ans comme pour mes collègues de PgBouncer. Cette fonctionnalité serait bienvenue dans Odyssey.
Vous pouvez maintenant créer une instruction préparée de deux manières. Tout d'abord, vous pouvez exécuter la commande SQL, à savoir « préparée ». Pour comprendre cette commande SQL, nous devons apprendre à comprendre SQL côté Bouncer. Ce serait excessif, car nous avons besoin d'un analyseur complet. Nous ne pouvons pas analyser chaque commande SQL.
Mais il existe une instruction préparée au niveau du protocole de messages sur proto3. Et c'est à ce moment que l'information selon laquelle une instruction préparée est créée arrive sous une forme structurée. Nous pourrions soutenir la compréhension que, lors d'une connexion serveur, le client a demandé à créer des instructions préparées. Et même si la transaction est clôturée, nous devons toujours maintenir la cohésion entre le serveur et le client.
Mais il y a un désaccord dans le dialogue, car quelqu'un dit qu'il faut comprendre quelle instruction préparée a été créée par le client et séparer la connexion serveur entre tous les clients qui ont créé cette connexion serveur, c'est-à-dire ceux qui ont créé une telle instruction préparée.
Andres Freund a dit que si un client est arrivé, qui avait déjà créé une telle instruction préparée dans une autre connexion serveur, alors créez-la pour lui. Mais, il semble que ce soit un peu incorrect d'exécuter des requêtes dans la base de données à la place du client, mais du point de vue du développeur qui écrit le protocole d'interaction avec la base, ce serait pratique si on lui fournissait simplement une connexion réseau, dans laquelle il y a cette requête préparée.
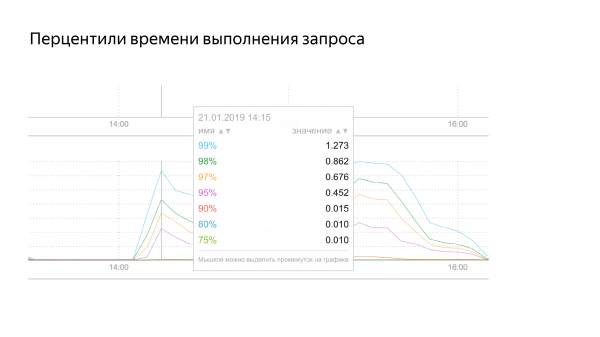
Et une autre fonctionnalité que nous devons mettre en œuvre. Nous avons actuellement un monitoring compatible avec PgBouncer. Nous pouvons retourner le temps moyen d'exécution des requêtes. Mais le temps moyen, c'est comme une température moyenne dans un hôpital : certains sont froids, certains sont tièdes - en moyenne, tous sont en bonne santé. Ce n'est pas vrai.
Nous devons implémenter le support des percentiles, qui indiqueraient qu'il y a des requêtes lentes qui consomment des ressources, et rendraient le monitoring plus acceptable.
Le plus important, c'est que nous voulons la version 1.0 (La version 1.1 est déjà sortie). La réalité est qu'actuellement Odyssey est en version 1.0rc, c'est-à-dire le candidat à la sortie. Et tous les problèmes que j'ai énumérés ont été corrigés avec cette version, à l'exception des fuites de mémoire.
Que signifie pour nous la version 1.0 ? Nous déployons Odyssey sur nos bases. Il fonctionne déjà sur nos bases, mais quand il atteindra le seuil de 1 000 000 de requêtes par seconde, nous pourrons dire que c'est une version de production, que l'on peut appeler 1.0.
Dans la communauté, plusieurs personnes ont demandé que la version 1.0 contienne également une pause et SCRAM. Mais cela signifierait que nous devrions déjà déployer la prochaine version en production, car ni SCRAM ni la pause ne sont encore fusionnés. Cependant, il est probable que ce problème sera résolu assez rapidement.
J'attends vos pull requests. J'aimerais aussi savoir quels problèmes vous rencontrez avec Bouncer. Discutons-en. Peut-être pourrons-nous réaliser certaines fonctionnalités dont vous avez besoin.
Sur cela, ma part est terminée, j'aimerais vous écouter. Merci !
Questions
Si je mets application_name, sera-t-il correctement transmis, y compris dans le pooling de transaction dans Odyssey ?
Dans Odyssey ou dans Bouncer ?
Dans Odyssey. Cela se passe dans Bouncer.
Nous allons établir un ensemble.
Et si ma connexion réelle change entre d'autres connexions, sera-t-elle transférée ?
Nous établirons un ensemble de tous les paramètres énumérés dans la liste. Je ne peux pas dire si application_name figure dans cette liste. Je crois l'avoir vu. Nous définirons tous les mêmes paramètres. Une seule requête réalisera tout ce qui a été configuré par le client au démarrage.
Merci, Andreï, pour la présentation ! Bonne présentation ! Je suis heureux qu'Odyssey se développe de plus en plus vite chaque minute. Je vous souhaite de continuer ainsi. Nous vous avons déjà contacté pour avoir une connexion multi-source de données, afin qu'Odyssey puisse se connecter simultanément à différentes bases de données, c'est-à-dire maître-esclave, et ensuite se reconnecter automatiquement au nouveau maître après un failover.
Oui, je me souviens de cette discussion. Il y a actuellement plusieurs stockages. Mais il n'y a pas de commutation entre eux. Nous devons interroger le serveur de notre côté pour savoir s'il est toujours vivant et comprendre qu'un failover s'est produit, qui appelera pg_recovery. J'ai un moyen standard de savoir que nous ne sommes pas sur le maître. Et nous devons comprendre cela par des erreurs ou comment ? C'est-à-dire que l'idée est intéressante, elle est en discussion. Écrivez plus de commentaires. Si vous avez des personnes qui savent travailler en C, c'est vraiment formidable.
La question de la mise à l'échelle par réplication nous intéresse également, car nous souhaitons rendre l'adoption des clusters répliqués aussi simple que possible pour les développeurs d'applications. Cependant, nous aimerions avoir plus de commentaires, c'est-à-dire des détails sur la façon de procéder et de le faire correctement.
La question concerne également les répliques. Il s'avère que vous avez un maître et plusieurs répliques. Il est clair que les connexions vers la réplique sont moins fréquentes que vers le maître, car elles peuvent avoir des différences. Vous avez mentionné que les différences dans les données peuvent être telles qu'elles ne satisferont pas votre entreprise et que vous n'irez pas vers elles tant qu'elles ne seront pas répliquées. En outre, si vous n'êtes pas allé là-bas depuis longtemps et commencez à y aller, alors les données dont vous avez besoin ne seront pas immédiatement disponibles. C'est-à-dire que si nous allons constamment vers le maître, le cache y sera chaud, alors que dans la réplique, le cache sera légèrement en retard.
Oui, c'est vrai. Il n'y aura pas de blocs de données dans le pcache que vous voulez, dans le cache réel, il n'y aura pas d'informations sur les tables que vous voulez, il n'y aura pas de requêtes analysées dans les plans, il n'y aura rien en fait.
Et quand vous avez un certain cluster et que vous ajoutez une nouvelle réplique, tant qu'elle démarre, tout va mal, c'est-à-dire qu'elle accumule son cache.
J'ai compris l'idée. La bonne approche serait de lancer d'abord un petit pourcentage de requêtes sur la réplique, afin de réchauffer le cache. En gros, nous avons pour condition de ne pas être en retard de plus de 10 secondes par rapport au maître. Et cette condition ne pas l'activer d'un coup, mais progressivement pour certains clients.
Oui, augmenter le poids.
C'est une bonne idée. Mais d'abord, il faut réaliser cette coupure. Il faut d'abord se déconnecter, puis penser à comment se reconnecter. C'est une excellente fonctionnalité pour se reconnecter en douceur.
Il y a une telle option dans nginx démarrer lentement dans le cluster pour le serveur. Et il augmente progressivement la charge.
Oui, excellente idée, nous essaierons lorsque nous y arriverons.
Source : habr.com
