

Cet article a été rédigé car nos employés ont eu de nombreuses conversations avec des clients sur le développement d'applications sur Kubernetes et les spécificités de ce type de développement sur OpenShift.
Nous commençons généralement par le principe que Kubernetes est simplement Kubernetes, tandis qu'OpenShift est une plateforme Kubernetes, comme Microsoft AKS ou Amazon EKS. Chacune de ces plateformes a ses avantages, orientés vers un public cible spécifique. Après cela, la discussion évolue vers la comparaison des forces et des faiblesses de ces plateformes.
En gros, nous envisagions d'écrire cet article avec une conclusion du type « Écoutez, peu importe où exécuter le code, sur OpenShift ou sur AKS, sur EKS, sur un Kubernetes personnalisé, peu importe, c'est du Kubernetes » (pour abréger, appelons-le KUK) – c'est vraiment simple, que ce soit l'un ou l'autre.
Nous avions ensuite prévu de prendre un simple « Hello World » et d'utiliser cet exemple pour montrer ce qui est commun et ce qui différencie KUK de la Red Hat OpenShift Container Platform (ci-après OCP ou simplement OpenShift).
Cependant, en rédigeant cet article, nous avons réalisé que nous étions tellement habitués à utiliser OpenShift que nous ne réalisions pas à quel point il avait grandi et s'était transformé en une plateforme impressionnante, beaucoup plus qu'un simple distribution de Kubernetes. Nous avons tendance à prendre pour acquis la maturité et la simplicité d'OpenShift, oubliant sa magnificence.
Il est donc temps de se racheter en passant à l'action, et maintenant nous allons comparer pas à pas le déploiement de notre « Hello World » sur KUK et sur OpenShift, et nous allons le faire de manière aussi objective que possible (à part peut-être des expressions parfois subjectives). Si vous êtes intéressé par une opinion purement subjective à ce sujet, vous pouvez la lire . Cet article se concentrera sur les faits et uniquement sur les faits.
Clusters
Pour notre « Hello World », nous avons besoin de clusters. D'abord, disons non à tous les clouds publics pour éviter de payer pour les serveurs, les registries, les réseaux, le transfert de données, etc. Par conséquent, nous choisissons un simple cluster à nœud unique sur (pour KUK) et (pour le cluster OpenShift). Ces deux options sont en réalité très simples à installer, mais nécessiteront pas mal de ressources sur votre ordinateur portable.
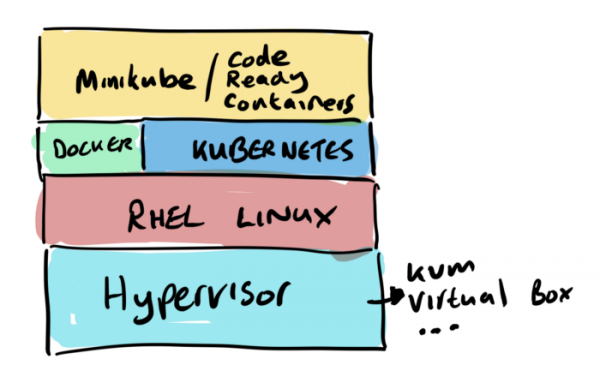
Compilation sur KUK
Alors, c'est parti.
Étape 1 – construisons notre image de conteneur
Je commencerai par déployer notre « Hello World » sur minikube. Pour cela, nous aurons besoin de :
- 1. Docker installé.
- 2. Git installé.
- 3. Maven installé (en fait, ce projet utilise le binaire mvnw, donc cela peut se faire sans lui).
- 4. Le code source lui-même, c'est-à-dire le clonage du dépôt
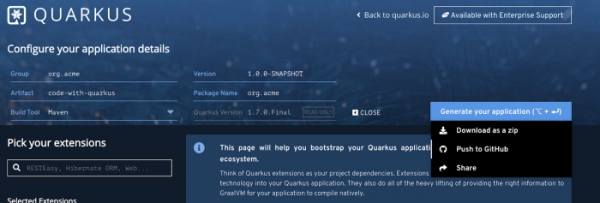
La première chose à faire est de créer un projet Quarkus. Ne vous inquiétez pas si vous n'avez jamais travaillé avec le site Quarkus.io – c'est facile. Il suffit de choisir les composants que vous souhaitez utiliser dans le projet (RestEasy, Hibernate, Amazon SQS, Camel, etc.), puis Quarkus configure déjà tout cela automatiquement sans votre intervention, en créant un archétype Maven et en le publiant sur GitHub. C'est-à-dire qu'il suffit de cliquer une seule fois – et c'est prêt. C'est pourquoi nous aimons Quarkus.
La manière la plus simple de builder notre 'Hello World' en tant qu'image de conteneur est d'utiliser les extensions quarkus-maven pour Docker, qui s'occupent de tout le travail nécessaire. Avec l'arrivée de Quarkus, cela est devenu vraiment facile : ajoutez l'extension container-image-docker et vous pouvez créer des images avec des commandes Maven.
./mvnw quarkus:add-extension -Dextensions="container-image-docker"
Et enfin, nous construisons notre image en utilisant Maven. En conséquence, notre code source se transforme en une image de conteneur prête à être exécutée dans un environnement de conteneurs.
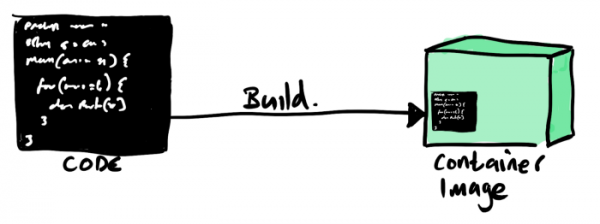
./mvnw -X clean package -Dquarkus.container-image.build=true
Voilà, c'est tout, maintenant vous pouvez exécuter le conteneur avec la commande docker run, en mappant notre service sur le port 8080 pour y accéder.
docker run -i --rm -p 8080:8080 gcolman/quarkus-hello-world
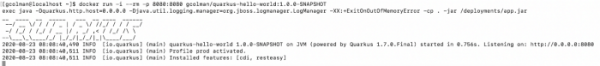
Une fois l'instance du conteneur démarrée, il suffit de vérifier avec la commande curl que notre service fonctionne :

Donc, tout fonctionne, et c'était vraiment facile.
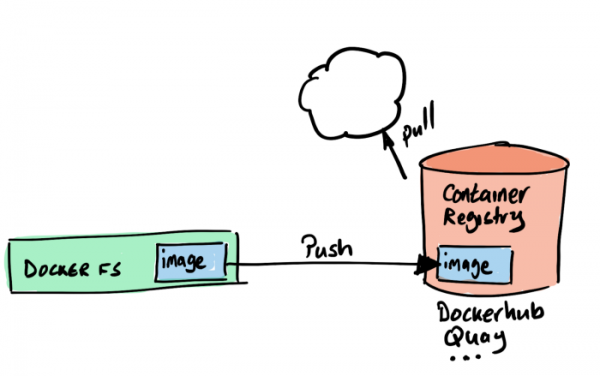
Étape 2 – envoyons notre conteneur dans le dépôt d'images de conteneur.
Pour l'instant, l'image que nous avons créée est stockée localement dans notre registre de conteneurs local. Si nous voulons utiliser cette image dans notre environnement K8S, nous devons la placer dans un autre dépôt. Kubernetes ne dispose pas de telles fonctionnalités, nous allons donc utiliser Docker Hub. Parce que, d'une part, c'est gratuit, et d'autre part, (presque) tout le monde le fait.
C'est aussi très simple, il vous faut juste un compte sur Docker Hub.
Alors, nous configurons Docker Hub et envoyons notre image là-bas.
Étape 3 – démarrons Kubernetes.
Il existe de nombreuses façons de configurer Kubernetes pour exécuter notre 'Hello World', mais nous allons utiliser la plus simple, car c'est notre nature...
Pour commencer, lançons le cluster minikube :
minikube start
Étape 4 – déployons notre image de conteneur
Nous devons maintenant transformer notre code et notre image de conteneur en configurations Kubernetes. En d'autres termes, nous avons besoin d'une définition de pod et de déploiement qui pointe vers notre image sur Docker Hub. L'un des moyens les plus simples de le faire est d'exécuter la commande create deployment en spécifiant notre image :
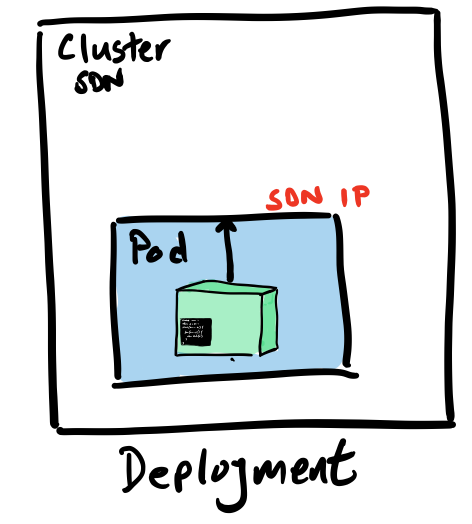
kubectl create deployment hello-quarkus --image=gcolman/quarkus-hello-world:1.0.0-SNAPSHOT
Avec cette commande, nous avons demandé à notre K8S de créer une configuration de déploiement, qui doit contenir la spécification du pod pour notre image de conteneur. Cette commande appliquera également cette configuration à notre cluster Minikube et créera un déploiement qui téléchargera notre image de conteneur et lancera le pod dans le cluster.
Étape 5 – ouvrons l'accès à notre service
Maintenant que nous avons déployé notre image de conteneur, il est temps de penser à la configuration de l'accès externe à ce service Restful, qui est en fait programmé dans notre code.
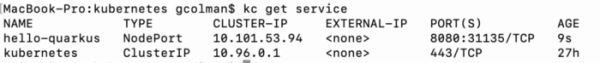
Il existe de nombreuses façons de procéder. Par exemple, nous pouvons utiliser la commande expose pour créer automatiquement les composants Kubernetes correspondants, tels que les services et les points de terminaison. C'est exactement ce que nous allons faire en exécutant la commande expose pour notre objet de déploiement :
kubectl expose deployment hello-quarkus --type=NodePort --port=8080
Prenons un moment pour examiner l'option « --type » de la commande expose.
Lorsque nous faisons l'expose et créons les composants nécessaires pour faire fonctionner notre service, nous devons, entre autres, nous assurer que l'extérieur peut se connecter au service hello-quarkus, qui se trouve dans notre réseau défini par logiciel. Et le paramètre type nous permet de créer et de connecter des éléments comme des équilibreurs de charge pour diriger le trafic vers ce réseau.
Par exemple, en spécifiant --type=LoadBalancer, nous initialisons automatiquement un équilibreur de charge dans le cloud public pour se connecter à notre cluster Kubernetes. C'est évidemment formidable, mais il faut comprendre qu'une telle configuration sera strictement liée à un cloud public particulier et qu'il sera plus difficile de la transférer entre les instances Kubernetes dans différents environnements.
Dans notre exemple --type=NodePort, c’est-à-dire que l'accès à notre service se fait via l'adresse IP du nœud et le numéro de port. Cette option permet de ne pas utiliser de clouds publics, mais nécessite quelques étapes supplémentaires. Tout d'abord, nous avons besoin de notre propre répartiteur de charge, donc nous allons déployer un répartiteur de charge NGINX dans notre cluster.
Étape 6 – Installer le répartiteur de charge
Minikube dispose de plusieurs fonctionnalités de plateforme facilitant la création des composants nécessaires pour l'accès externe, comme les contrôleurs d'ingress. Minikube est livré avec un contrôleur d'ingress Nginx, et il ne nous reste plus qu'à l'activer et le configurer.
minikube addons enable ingress
Maintenant, avec une seule commande, nous allons créer un contrôleur d'ingress Ngnix qui fonctionnera à l'intérieur de notre cluster minikube :
ingress-nginx-controller-69ccf5d9d8-j5gs9 1/1 En cours d’exécution 1 33m
Étape 7 – Configurer l'ingress
Nous devons maintenant configurer le contrôleur d'ingress Nginx afin qu'il gère les requêtes hello-quarkus.
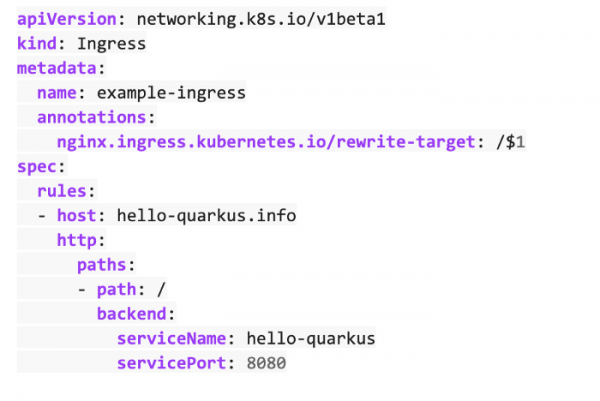
Et enfin, nous devons appliquer cette configuration.
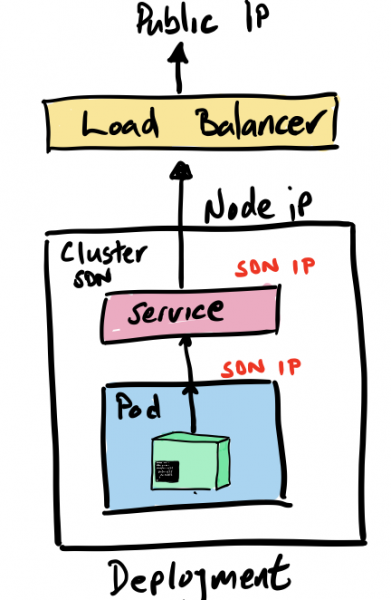
kubectl apply -f ingress.yml

Puisque nous faisons tout cela sur notre ordinateur, nous ajoutons simplement l'adresse IP de notre nœud dans le fichier /etc/hosts, afin de diriger les requêtes http vers notre minikube sur le répartiteur de charge NGINX.
192.168.99.100 hello-quarkus.info
Voilà, maintenant notre service minikube est accessible de l'extérieur via le contrôleur d'ingress Nginx.
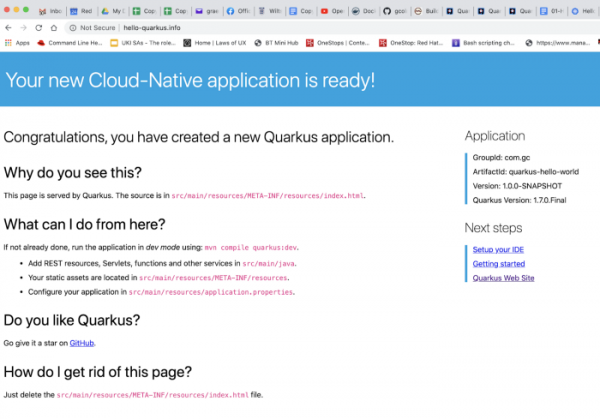
Alors, c'était facile, n'est-ce pas ? Ou pas vraiment ?
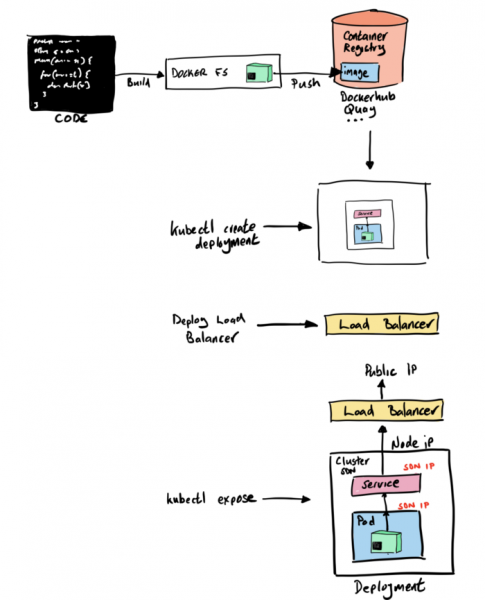
Déploiement sur OpenShift (Code Ready Containers)
Voyons maintenant comment cela se passe sur la plateforme de conteneurs Red Hat OpenShift (OCP).
Comme pour minikube, nous choisissons le schéma d'un cluster à nœud unique OpenShift sous forme de Code Ready Containers (CRC). Cela s'appelait auparavant minishift et était basé sur le projet OpenShift Origin, et maintenant c’est CRC et cela repose sur la plateforme de conteneurs OpenShift de Red Hat.
Ici, nous ne pouvons pas nous empêcher de dire : « OpenShift est formidable ! »
Au départ, nous pensions écrire que le développement sur OpenShift ne différait pas de celui sur Kubernetes. Et en fait, c’est vrai. Mais en rédigeant cet article, nous avons réalisé combien de mouvements supplémentaires étaient nécessaires quand on n’a pas OpenShift, ce qui prouve encore une fois que c'est formidable. Nous aimons quand les choses sont simples, et la facilité avec laquelle notre exemple se déploie et s'exécute sur OpenShift par rapport à minikube nous a incités à écrire cet article.
Passons en revue le processus et voyons ce que nous devrons faire.
Ainsi, dans l'exemple avec minikube, nous commencions avec Docker… Attendez, nous n'avons plus besoin que Docker soit installé sur la machine.
Et nous n'avons pas besoin de git local.
Et nous n'avons pas besoin de Maven.
Et il n'est pas nécessaire de créer manuellement une image de conteneur.
Et il n'est pas nécessaire de chercher un dépôt d'images de conteneurs.
Et il n'est pas nécessaire d'installer un contrôleur d'ingress.
Et il n'est pas non plus nécessaire de configurer l'ingress.
Vous comprenez, n'est-ce pas ? Pour déployer et exécuter notre application sur OpenShift, rien de ce qui précède n'est nécessaire. Et le processus ressemble à ceci.
Étape 1 – Démarrez votre cluster OpenShift
Nous utilisons Code Ready Containers de Red Hat, qui est en fait le même que Minikube, mais avec un cluster OpenShift à nœud unique complet.
crc start
Étape 2 – Construisez et déployez l'application dans le cluster OpenShift
C'est à cette étape que la simplicité et la commodité d'OpenShift brillent de tous leurs feux. Comme dans toutes les distributions Kubernetes, nous avons de nombreuses façons de déployer une application dans le cluster. Et, comme dans le cas de K8s, nous choisissons délibérément la méthode la plus simple.
OpenShift a toujours été conçu comme une plateforme pour créer et exécuter des applications conteneurisées. La construction de conteneurs a toujours été une partie intégrante de cette plateforme, c'est pourquoi il existe de nombreuses ressources Kubernetes supplémentaires pour les tâches correspondantes.
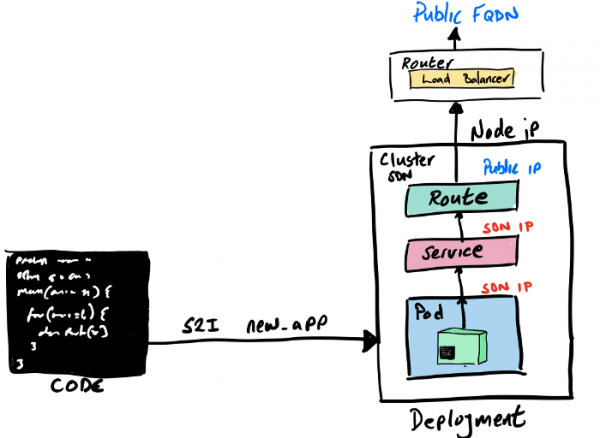
Nous allons utiliser le processus Source to Image (S2I) d'OpenShift, qui offre plusieurs manières de prendre notre source (code ou fichiers binaires) et de la transformer en une image de conteneur exécutable dans le cluster OpenShift.
Pour cela, nous aurons besoin de deux choses :
- Notre code source dans un dépôt git
- Une image de builder, à partir de laquelle la construction sera effectuée.
Il existe de nombreuses images comme celles-ci, supportées à la fois par Red Hat et par la communauté, et nous allons utiliser l'image OpenJDK, puisque je construis une application Java.
Lancer une construction S2I peut se faire à la fois via la console graphique d'OpenShift Developer et depuis la ligne de commande. Nous utiliserons la commande new-app, en lui indiquant où trouver l'image de builder et notre code source.
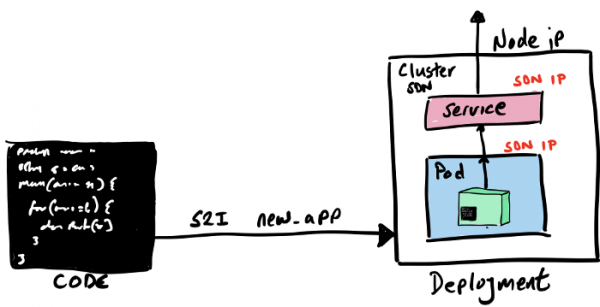
oc new-app registry.access.redhat.com/ubi8/openjdk-11:latest~https://github.com/gcolman/quarkus-hello-world.git
Voilà, notre application est créée. Pendant ce temps, le processus S2I a effectué les actions suivantes :
- Il a créé un pod de build pour toutes les tâches liées à la construction de l'application.
- Il a créé la configuration de l'OpenShift Build.
- Il a téléchargé l'image de builder dans le registre interne Docker d'OpenShift.
- Il a cloné « Hello World » dans le dépôt local.
- J'ai remarqué qu'il y avait un maven pom, donc j'ai compilé l'application avec maven.
- J'ai créé une nouvelle image de conteneur contenant l'application Java compilée et j'ai placé cette image dans le registre interne des conteneurs.
- J'ai créé un déploiement Kubernetes avec les spécifications du pod, du service, etc.
- J'ai lancé le déploiement de l'image du conteneur.
- J'ai supprimé le pod de build temporaire.
Cette liste contient beaucoup de choses, mais le principal est que toute la construction se fait exclusivement à l'intérieur d'OpenShift, le registre Docker interne se trouve à l'intérieur d'OpenShift, et le processus de construction crée tous les composants Kubernetes et les lance dans le cluster.
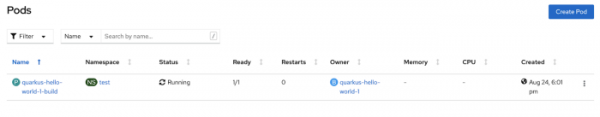
Si on suit visuellement le lancement de S2I dans la console, on peut voir comment, lors de la construction, le pod de build se lance.
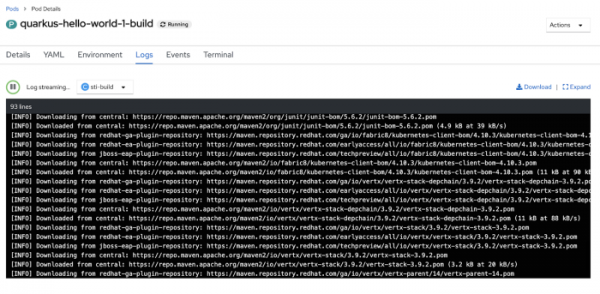
Jetons maintenant un œil aux journaux du pod builder : tout d'abord, on voit comment maven effectue son travail et télécharge les dépendances pour construire notre application java.
Après la fin de la construction maven, la construction de l'image du conteneur commence, puis cette image construite est envoyée dans le dépôt interne.
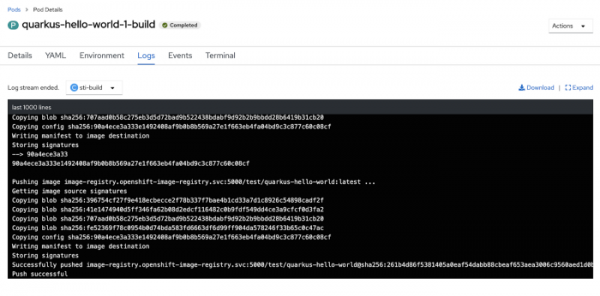
Tout est prêt, le processus de construction est terminé. Vérifions maintenant que les pods et les services de notre application ont été lancés dans le cluster.
oc get service
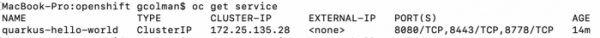
C'est tout. Et une seule commande. Il ne reste plus qu'à exposer ce service pour un accès externe.
Étape 3 - exposer le service pour un accès externe
Comme dans le cas du CHEF, notre "Hello World" a également besoin d'un routeur sur la plateforme OpenShift pour diriger le trafic externe vers le service à l'intérieur du cluster. Cela se fait très simplement dans OpenShift. Tout d'abord, un composant de routage HAProxy est installé par défaut dans le cluster (on peut le remplacer par le même NGINX). Deuxièmement, il existe des ressources spéciales et hautement configurables appelées Routes qui ressemblent aux objets Ingress du bon vieux Kubernetes (en fait, les Routes d'OpenShift ont beaucoup influencé la conception des objets Ingress, qui peuvent maintenant être utilisés dans OpenShift), mais pour notre "Hello World", et presque dans tous les autres cas, la Route standard sans configuration supplémentaire suffira.
Pour créer un FQDN routable pour "Hello World" (oui, OpenShift a son propre DNS pour le routage par nom de service), nous allons simplement exposer notre service :
oc expose service quarkus-hello-world
En regardant la Route nouvellement créée, on peut trouver le FQDN et d'autres informations de routage :
oc get route

Et enfin, accédons à notre service depuis le navigateur :
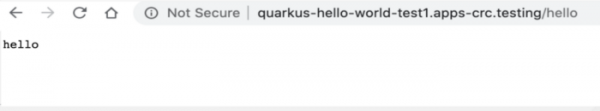
Eh bien, c'était vraiment facile !
Nous aimons Kubernetes et tout ce que cette technologie permet, ainsi que la simplicité et la légèreté. Kubernetes a été conçu pour rendre l'exploitation des conteneurs distribués et évolutifs extraordinairement simple, mais aujourd'hui, cette simplicité n'est plus suffisante pour déployer des applications. C'est là qu'intervient OpenShift, qui suit le rythme et propose un Kubernetes principalement orienté vers le développeur. De nombreux efforts ont été déployés pour adapter la plateforme OpenShift au développeur, y compris la création d'outils tels que S2I, ODI, Developer Portal, OpenShift Operator Framework, intégration avec les IDE, Developer Catalogues, intégration avec Helm, monitoring et bien d'autres.
Nous espérons que cet article vous a été intéressant et utile. Vous pouvez trouver des ressources supplémentaires, des matériaux et d'autres éléments utiles pour le développement sur la plateforme OpenShift sur le portail .
Source : habr.com
