

Les algorithmes basés sur les données, tels que les réseaux de neurones, ont pris d'assaut le monde. Leur développement est dû à plusieurs facteurs, notamment du matériel bon marché et puissant et une quantité énorme de données. Les réseaux de neurones sont actuellement à la pointe de tout ce qui concerne les tâches « cognitives », telles que la reconnaissance d'images, la compréhension du langage naturel, etc. Mais ils ne devraient pas se limiter à ces tâches. Cet article aborde la manière de compresser des images à l'aide de réseaux de neurones, en utilisant l'apprentissage résiduel. L'approche présentée dans l'article fonctionne plus rapidement et mieux que les codecs standards. Des schémas, des équations et, bien sûr, un tableau de tests sont sous le pli.
Cet article est basé sur travail. Il est supposé que vous êtes familiarisé avec les réseaux de neurones et leurs concepts convolution et fonction de perte.
Qu'est-ce que la compression d'images et quels sont ses types ?
La compression d'images est un processus qui transforme une image de telle manière qu'elle occupe moins d'espace. Un simple stockage d'images prendrait beaucoup d'espace, c'est pourquoi il existe des codecs tels que JPEG et PNG, qui visent à réduire la taille de l'image d'origine.
Comme on le sait, il existe deux types de compression d'images : sans perte et avec perte. Comme le suggèrent les noms, lors de la compression sans perte, il est possible de récupérer les données de l'image d'origine, tandis qu'avec la compression avec perte, certaines données sont perdues durant le processus. Par exemple, JPG utilise des algorithmes avec perte [note du traducteur — ne pas oublier non plus le JPEG sans perte], tandis que PNG est un algorithme sans perte.
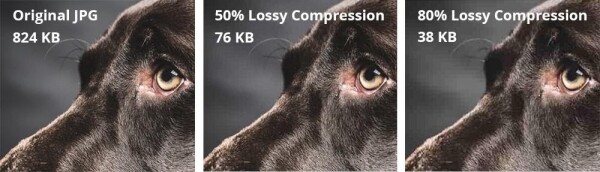
Comparaison entre la compression sans perte et avec perte
Veuillez noter qu'il y a de nombreux artefacts de bloc sur l'image à droite. Il s'agit d'informations perdues. Les pixels adjacents de couleurs similaires sont compressés en une seule zone pour économiser de l'espace, mais cela fait perdre des informations sur les pixels réels. Bien sûr, les algorithmes utilisés dans les codecs JPEG, PNG, etc., sont beaucoup plus complexes, mais c'est un bon exemple intuitif de compression avec perte. La compression sans perte est une bonne chose, mais les fichiers compressés sans perte occupent beaucoup d'espace sur le disque. Il existe des méthodes de compression d'images plus efficaces sans perdre beaucoup d'informations, mais elles sont assez lentes, et beaucoup d'entre elles appliquent des approches itératives. Cela signifie qu'elles ne peuvent pas être exécutées en parallèle sur plusieurs cœurs de processeur central ou graphique. Cette limitation les rend complètement impr pratiques pour une utilisation quotidienne.
Entrée d'un réseau de neurones convolutionnel
Si quelque chose doit être calculé et que les calculs peuvent être approximatifs, ajoutez . Les auteurs ont utilisé un réseau de neurones convolutionnel assez standard pour améliorer la compression d'images. La méthode présentée fonctionne non seulement au même niveau que les meilleures solutions (si ce n'est mieux), mais elle peut également exploiter des calculs parallèles, ce qui entraîne une augmentation rapide de la vitesse. La raison en est que les réseaux de neurones convolutionnels (CNN) sont très bons pour extraire des informations spatiales à partir d'images, qui sont ensuite représentées de manière plus compacte (par exemple, seules les « bits » importants de l'image sont conservés). Les auteurs voulaient utiliser cette capacité des CNN pour mieux représenter les images.
Architecture
Les auteurs ont proposé un double réseau. Le premier réseau prend en entrée une image et génère une représentation compacte (ComCNN). Les données de sortie de ce réseau sont ensuite traitées par un codec standard (par exemple, JPEG). Après le traitement par le codec, l'image est transmise au deuxième réseau, qui « corrige » l'image du codec dans une tentative de retourner à l'image d'origine. Les auteurs ont appelé ce réseau un CNN reconstructeur (RecCNN). Comme les GAN, les deux réseaux sont formés de manière itérative.
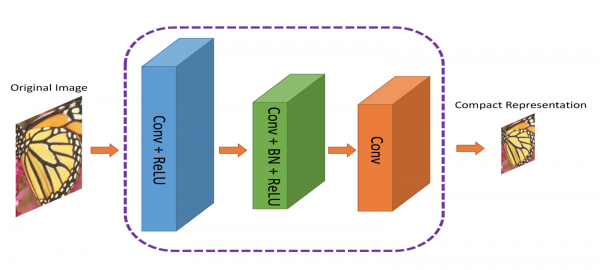
ComCNN La représentation compacte est transmise au codec standard
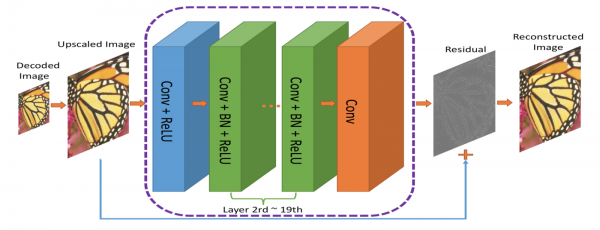
RecCNN. Les données de sortie de ComCNN sont mises à l'échelle et transmises à RecCNN, qui tentera d'apprendre le reste.
Les sorties du codec s'adaptent à l'augmentation, puis sont transmises à RecCNN. RecCNN essaiera de produire une image qui ressemble autant que possible à l'original.
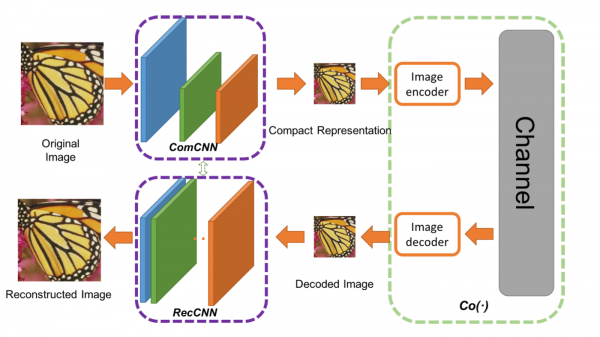
Un framework de compression d'images sans fil. Co(.) est un algorithme de compression d'images. Les auteurs ont appliqué JPEG, JPEG2000 et BPG.
Qu'est-ce que le résidu ?
Le résidu peut être considéré comme une étape de post-traitement pour "améliorer" l'image décodée par le codec. Possédant une grande quantité d'"informations" sur le monde, le réseau neuronal peut prendre des décisions cognitives sur ce qu'il faut corriger. Cette idée repose sur. , dont vous pouvez lire les détails. .
Fonctions de perte
Deux fonctions de perte sont utilisées car nous avons deux réseaux neuronaux. Le premier, ComCNN, est marqué comme L1 et est défini ainsi :
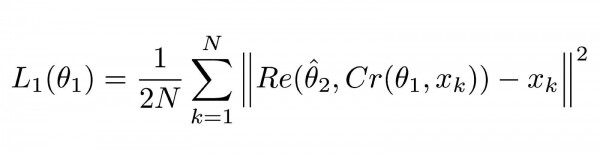
Fonction de perte pour ComCNN
L'explication
Cette équation peut sembler complexe, mais en réalité, c'est une erreur quadratique moyenne standard. MSE. ||² signifie la norme du vecteur qu'ils englobent.
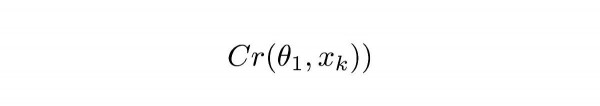
Équation 1.1
Cr représente les sorties de ComCNN. θ représente la capacité d'apprentissage des paramètres de ComCNN, XK est l'image d'entrée.
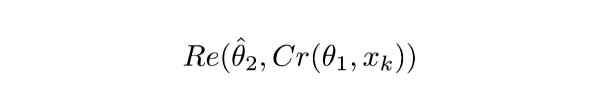
Équation 1.2
Re() représente RecCNN. Cette équation transfère simplement la valeur de l'équation 1.1 dans RecCNN. θ représente les paramètres entraînables de RecCNN (le chapeau au-dessus indique que les paramètres sont fixes).
Définition intuitive
L'équation 1.0 forcera ComCNN à ajuster ses poids de sorte qu'après avoir été reconstruit par RecCNN, l'image finale ressemble autant que possible à l'image d'entrée. La deuxième fonction de perte, RecCNN, est définie comme suit :
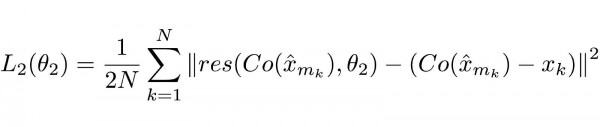
Équation 2.0
L'explication
Encore une fois, la fonction peut sembler complexe, mais c'est principalement une fonction de perte standard pour un réseau neuronal (MSE).
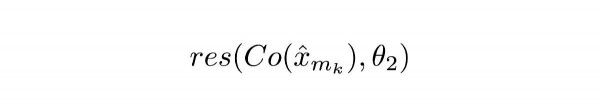
Équation 2.1
Co() représente la sortie du codec, x avec un chapeau au-dessus signifie la sortie de ComCNN. θ2 est les paramètres entraînables de RecCNN. res() représente simplement la sortie résiduelle de RecCNN. Il convient de noter que RecCNN est entraîné sur la différence entre Co() et l'image d'entrée, mais pas sur l'image d'entrée.
Définition intuitive
L'équation 2.0 forcera RecCNN à ajuster ses poids afin que les sorties ressemblent autant que possible à l'image d'entrée.
Schéma d'apprentissage
Les modèles sont formés de manière itérative, comme Les poids du premier modèle sont fixés pendant que les poids du second modèle sont mis à jour, puis les poids du second modèle sont fixés pendant que le premier modèle est entraîné.
Tests
Les auteurs ont comparé leur méthode à celles existantes, y compris les codecs simples. Leur méthode fonctionne mieux que les autres, tout en conservant une grande rapidité sur le matériel approprié. De plus, les auteurs ont tenté d'utiliser seulement l'un des deux réseaux et ont noté une baisse de performance.
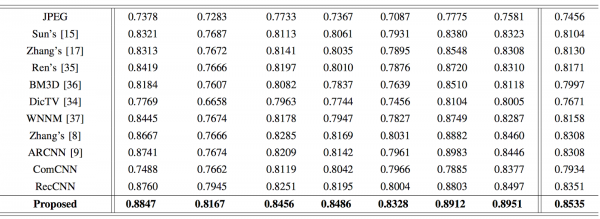
Comparaison de l'indice de similarité structurelle (SSIM). Des valeurs élevées indiquent une meilleure similarité avec l'original. Les résultats des auteurs sont mis en gras.
Conclusion
Nous avons examiné une nouvelle façon d'appliquer l'apprentissage profond à la compression d'images, discuté de la possibilité d'utiliser des réseaux de neurones pour des tâches autres que les « générales », telles que la classification d'images et le traitement du langage. Cette méthode non seulement répond aux exigences modernes, mais permet également de traiter les images beaucoup plus rapidement.
Il est devenu plus facile d'étudier les réseaux de neurones, car nous avons créé un code promotionnel spécialement pour les membres de Habr. HABR, offrant une réduction supplémentaire de 10 % sur celle indiquée sur la bannière.
Autres cours
Articles recommandés
Source : habr.com
