

Comment un développeur backend sait-il qu'une requête SQL fonctionnera bien en production ? Dans les grandes entreprises ou celles en forte croissance, tout le monde n'a pas accès à la production. De plus, même avec un accès, toutes les requêtes ne peuvent pas être vérifiées sans conséquences, et la création d'une copie de la base de données prend souvent des heures. Pour résoudre ces problèmes, nous avons créé un DBA artificiel — Joe. Il a déjà été intégré avec succès dans plusieurs entreprises et aide plus d'une dizaine de développeurs.
Vidéo :
Bonjour à tous ! Je m'appelle Anatoly Stansler. Je travaille pour l'entreprise . Nous nous concentrons sur l'accélération du processus de développement en éliminant les retards liés au travail avec Postgres, pour les développeurs, les DBA et les QA.
Nous avons des clients formidables et aujourd'hui, une partie de ma présentation sera consacrée aux cas que nous avons rencontrés en travaillant avec eux. Je vais expliquer comment nous les avons aidés à résoudre des problèmes assez sérieux.
Lorsque nous développons et effectuons des migrations complexes et chargées, nous nous posons la question : « Cette migration va-t-elle passer ? ». Nous utilisons les revues, nous nous appuyons sur les connaissances de collègues plus expérimentés, des experts DBA. Et ils peuvent dire — elle va passer ou non.
Mais peut-être qu'il serait préférable que nous puissions tester cela nous-mêmes sur des copies complètes. Et aujourd'hui, nous allons justement parler des différentes approches de test qui existent actuellement, comment les faire au mieux et avec quels outils. Nous discuterons également des avantages et des inconvénients de ces approches, et ce que nous pouvons améliorer ici.
Qui a déjà créé des index ou apporté des modifications directement en production ? Beaucoup de personnes. Et qui cela a-t-il conduit à perdre des données ou à des temps d'arrêt ? Dans ce cas, vous connaissez cette douleur. Heureusement, il y a des sauvegardes.
La première approche consiste à tester en production. Ou, lorsqu'un développeur est assis sur sa machine locale, avec des données de test, il y a un certain échantillon limité. Et nous déployons en production, et cela nous mène à une telle situation.
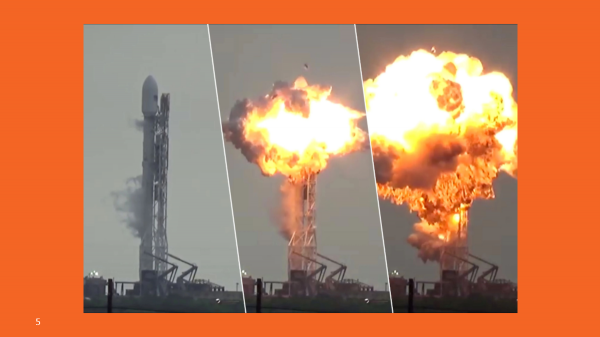
C'est douloureux, c'est coûteux. Ce n'est probablement pas la meilleure méthode.
Alors, comment le faire au mieux ?
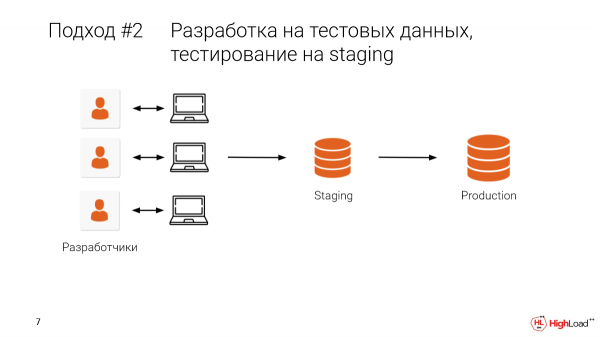
Prenons un environnement de staging et prenons une partie de la production. Ou, dans le meilleur des cas, utilisons la véritable production, toutes les données. Et après avoir développé localement, nous effectuerons des vérifications supplémentaires sur le staging.
Cela nous permettra d'éliminer une partie des erreurs, c'est-à-dire de ne pas les introduire en production.
Quelles sont les problèmes ?
- Le problème est que nous partageons ce staging avec des collègues. Et très souvent, il arrive que vous apportiez une modification, bam – et plus aucune donnée, le travail est perdu. Le staging faisait plusieurs téraoctets. Et il faut longtemps attendre qu'il redémarre. Nous décidons donc de le retravailler demain. Voilà, notre développement est bloqué.
- Et bien sûr, de nombreux collègues et équipes y travaillent. Il faut donc tout synchroniser manuellement. Ce n'est pas pratique.
Il convient de mentionner que nous n'avons qu'une seule tentative, un seul coup, si nous voulons apporter des modifications à la base de données, toucher aux données, changer la structure. Et si quelque chose ne se passe pas comme prévu, si une erreur s'est glissée dans la migration, nous ne pourrons pas revenir en arrière rapidement.
C'est mieux que l'approche précédente, mais il y a quand même un grand risque qu'une erreur passe en production.
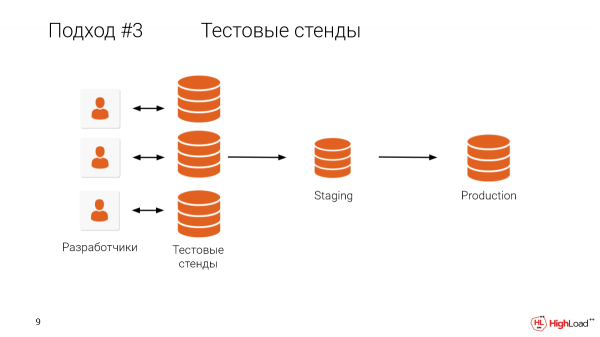
Qu'est-ce qui nous empêche de donner à chaque développeur un banc d'essai, une copie pleine grandeur ? Je pense qu'il est évident ce qui nous en empêche.
Qui a une base de données de plus d'un téraoctet ? Plus de la moitié de la salle.
Il est clair que maintenir des machines pour chaque développeur, quand la production est aussi grande, coûte très cher et prend du temps.
Nous avons des clients qui ont compris qu'il est très important de tester toutes les modifications sur des copies grandeur nature, mais leur base est inférieure à un téraoctet, et ils n'ont pas les ressources pour maintenir un banc d'essai pour chaque développeur. Ils doivent donc télécharger des dumps localement sur leur machine et tester de cette manière. Cela prend énormément de temps.
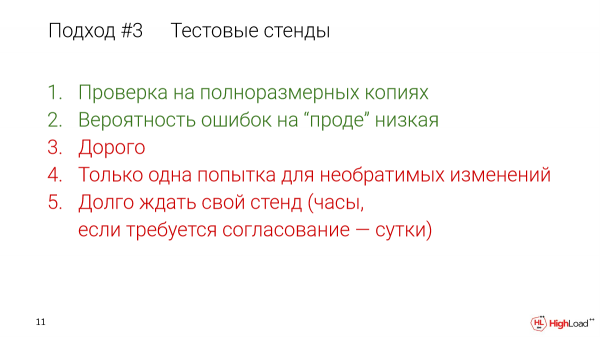
Même si vous le faites à l'intérieur de l'infrastructure, télécharger un téraoctet de données en une heure, c'est déjà très bien. Mais ils utilisent des dumps logiques, ils téléchargent localement depuis le cloud. Pour eux, la vitesse est d'environ 200 gigaoctets par heure. Et il leur faut encore du temps pour déployer à partir du dump logique, appliquer les index, etc.
Mais ils adoptent cette approche car cela permet de garder la production fiable.
Que pouvons-nous faire ici ? Rendons les bancs d'essai peu coûteux et donnons à chaque développeur son propre banc d'essai.
Et c'est possible.
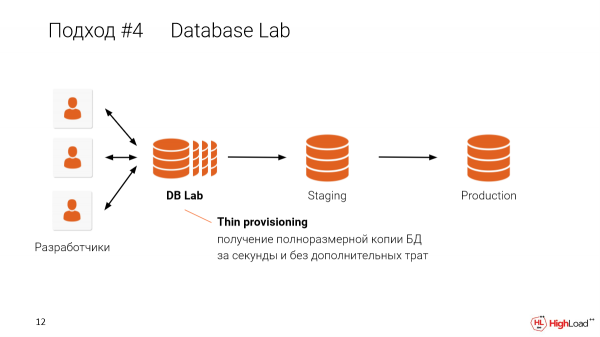
Et dans cette approche, lorsque nous faisons des clones minces pour chaque développeur, nous pouvons les partager sur une seule machine. Par exemple, si vous avez une base de 4 téraoctets et que vous souhaitez la donner à 10 développeurs, il n'est pas nécessaire d'avoir 10 bases de 4 téraoctets. Une seule machine suffit pour créer des copies isolées et minces pour chaque développeur en utilisant une seule machine. Je vous expliquerai comment cela fonctionne un peu plus tard.
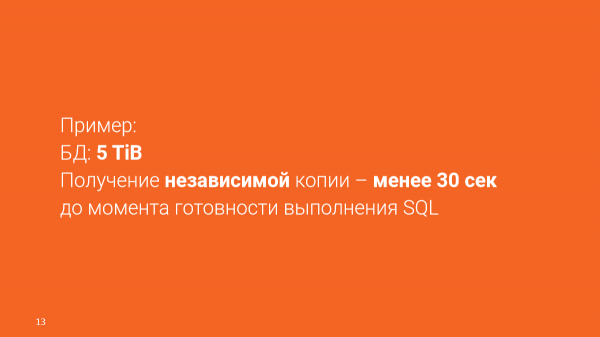
Un exemple concret :
BD – 4,5 téraoctets.
Nous pouvons obtenir des copies indépendantes en 30 secondes.
Vous n'avez pas besoin d'attendre un environnement de test ou de dépendre de sa taille. Vous pouvez l'obtenir en quelques secondes. Ce seront des environnements totalement isolés, mais qui partagent les données entre eux.
C'est génial. Ici, nous parlons de magie et de multivers.
Dans notre cas, cela fonctionne grâce au système OpenZFS.
OpenZFS est un système de fichiers copy-on-write qui prend en charge les instantanés et les clones dès la sortie de la boîte. Il est fiable et évolutif. Sa gestion est très simple. Vous pouvez le déployer littéralement en deux commandes.
Il existe d'autres options :
LVM,
Stockage (par exemple, Pure Storage).
Database Lab, dont je parle, est modulaire. Il peut être mis en œuvre en utilisant ces options. Mais jusqu'à présent, nous nous sommes concentrés sur OpenZFS, car il y avait des problèmes spécifiques avec LVM.
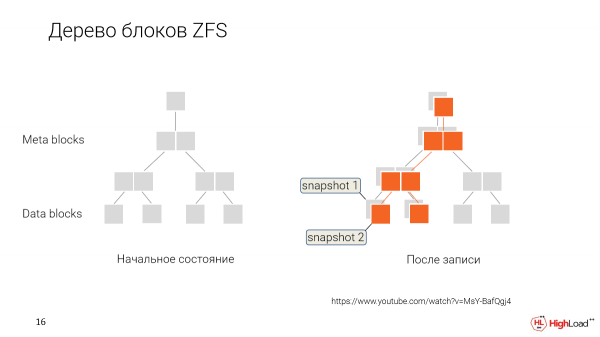
Comment ça fonctionne ? Au lieu de réécrire les données chaque fois que nous les modifions, nous les sauvegardons simplement en marquant que ces nouvelles données se réfèrent à un nouveau moment dans le temps, à un nouvel instantané.
Et plus tard, lorsque nous voulons revenir en arrière ou créer un nouveau clone à partir d'une version plus ancienne, nous disons simplement : « D'accord, donnez-nous ces blocs de données qui sont marqués comme tels ».
Et cet utilisateur travaillera avec cet ensemble de données. Il les modifiera progressivement en créant ses propres instantanés.
Et nous aurons un embranchement. Chaque développeur dans notre cas aura la possibilité d'avoir son propre clone qu'il édite, et les données communes seront partagées entre tous.
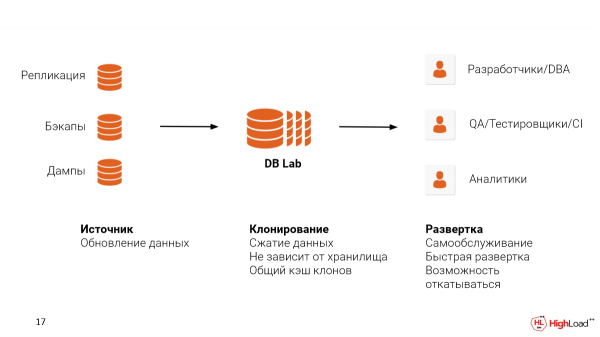
Pour déployer un tel système, il faut résoudre deux problèmes :
La première est la source de données d'où vous allez les récupérer. Vous pouvez configurer la réplication à partir de la production. Vous pouvez également utiliser les sauvegardes que vous avez configurées, je l'espère. WAL-E, WAL-G ou Barman. Et même si vous utilisez une solution Cloud, comme RDS ou Cloud SQL, vous pouvez utiliser des dumps logiques. Mais nous vous conseillons tout de même d'utiliser des sauvegardes, car avec cette approche, vous conservez également la structure physique des fichiers, ce qui vous permettra d'être encore plus proche des métriques que vous pourriez voir en production, afin de détecter les problèmes qui existent.
La deuxième est l'endroit où vous souhaitez héberger Database Lab. Cela peut être dans le Cloud ou sur site. Il est important de mentionner que ZFS prend en charge la compression des données. Et il le fait assez bien.
Imaginez qu'à partir de chaque clone, en fonction des opérations que nous effectuons sur la base, un certain dev va s'accumuler. Cet espace dev devra également être provisionné. Cependant, grâce au fait que nous avons pris une base de 4,5 téraoctets, ZFS la compressera à 3,5 téraoctets. En fonction des paramètres, cela peut varier. De plus, il nous restera de l'espace pour le dev.
Vous pouvez utiliser un tel système pour différents cas d'utilisation.
Cela concerne les développeurs et les DBA pour le contrôle des requêtes et l'optimisation.
Cela peut également être utilisé dans les tests QA pour vérifier une migration spécifique avant de la déployer en production. Nous pouvons également créer des environnements spéciaux pour QA avec de vraies données, où ils peuvent tester de nouvelles fonctionnalités. Cela prendra des secondes au lieu d'attendre des heures, voire des jours, dans d'autres cas où des copies fines ne sont pas utilisées.
Et encore un cas spécifique. Si l'entreprise n'a pas mis en place de système d'analytique, nous pouvons créer un clone fin de la base de données produit et le fournir pour des requêtes longues ou des index spéciaux qui pourraient être utilisés en analytique.
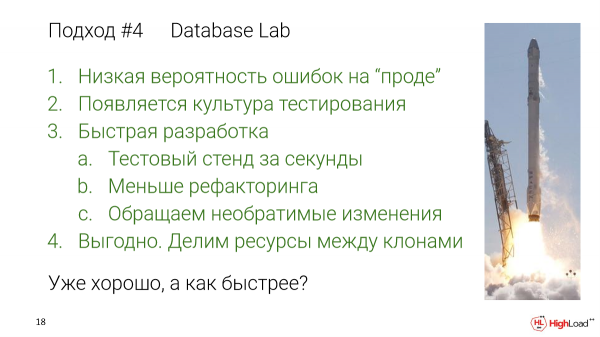
Avec cette approche :
La probabilité d'erreurs en production est faible, car nous avons testé toutes les modifications sur des données complètes.
Nous développons une culture de test, car il n'est plus nécessaire d'attendre des heures pour avoir son propre environnement.
Et il n'y a plus d'obstacles, plus d'attentes entre les tests. Vous pouvez vraiment aller vérifier. Cela sera mieux, car nous accélérerons le développement.
Il y aura moins de refactoring. Moins de bugs atteindront la production. Nous en ferons moins par la suite.
Nous pouvons effectuer des modifications irréversibles. Cela n'existe pas dans les approches standards.
- C'est avantageux, car nous partageons les ressources des environnements de test.
C'est déjà bien, mais qu'est-ce qui pourrait encore être accéléré ?
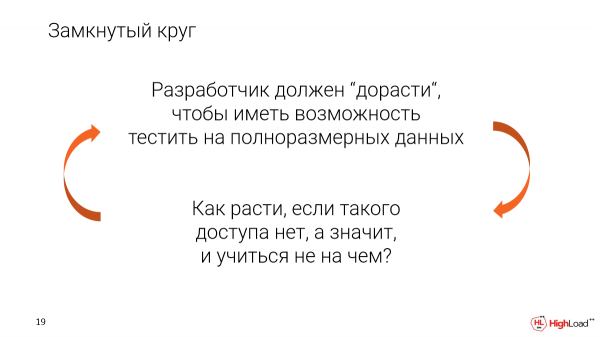
Grâce à ce système, nous pouvons considérablement réduire le seuil d'entrée à ce type de test.
Il y a actuellement un cercle vicieux où le développeur, pour accéder à des données réelles et complètes, doit devenir un expert. On doit lui faire confiance pour cet accès.
Mais comment grandir s'il n'y en a pas ? Et si tu n'as accès qu'à un très petit ensemble de données de test ? Dans ce cas, il n'est pas possible d'obtenir une expérience réelle.
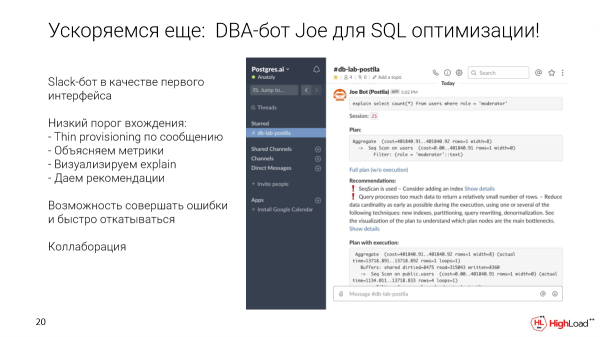
Comment sortir de ce cercle ? En tant que première interface, adaptée aux développeurs de tous niveaux, nous avons choisi un bot Slack. Mais cela peut être n'importe quelle autre interface.
Que permet-il de faire ? Nous pouvons prendre une requête spécifique et l'envoyer dans un canal spécial pour la base de données. Nous déploierons automatiquement un clone léger en quelques secondes. Nous exécuterons cette requête. Collecterons des métriques et des recommandations. Nous montrerons une visualisation. Et ensuite, ce clone restera pour que cette requête puisse être optimisée, avec des index ajoutés, etc.
Et Slack nous offre également des fonctionnalités de collaboration prêtes à l'emploi. Puisque c'est simplement un canal, on peut directement commencer à discuter cette requête dans le fil de discussion, en pingant ses collègues, DBA, présents dans l'entreprise.
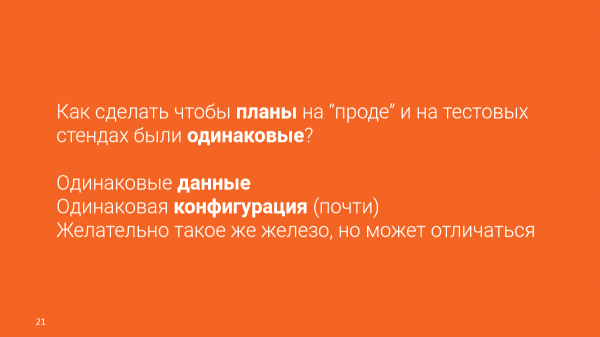
Mais il y a, bien sûr, des problèmes. Puisque c'est le monde réel, et que nous utilisons un serveur qui héberge plusieurs clones en même temps, nous devons réduire la quantité de mémoire et de puissance processeur disponibles pour les clones.
Mais pour que ces tests soient crédibles, il faut résoudre ce problème d'une manière ou d'une autre.
Il est clair qu'un point important est d'avoir des données identiques. Mais cela, nous l'avons déjà. Et nous souhaitons atteindre une configuration identique. Et nous pouvons offrir une configuration pratiquement identique.
Ce serait super d'avoir le même matériel que celui en production, mais cela peut différer.
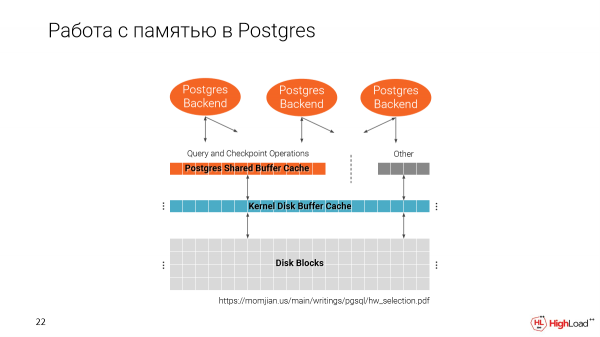
Rappelons comment Postgres gère la mémoire. Nous avons deux caches. Un provenant du système de fichiers et l'autre est le cache buffer partagé de Postgres.
Il est important de noter que le Shared Buffer Cache est alloué au démarrage de Postgres en fonction de la taille que vous définissez dans la configuration.
Le deuxième cache utilise tout l'espace disponible.
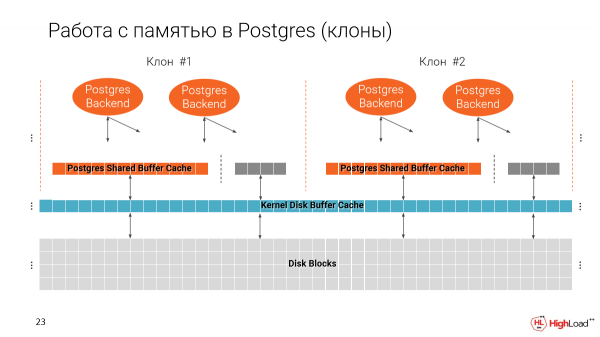
Et quand nous faisons plusieurs clones sur une même machine, il semble que nous remplissons progressivement la mémoire. En théorie, le Shared Buffer Cache devrait représenter 25 % de l'ensemble de la mémoire disponible sur la machine.
Ainsi, si nous ne modifions pas ce paramètre, nous pourrons exécuter seulement 4 instances sur une seule machine, c’est-à-dire seulement 4 clones légers. Et c'est bien sûr un inconvénient, car nous souhaitons en avoir beaucoup plus.
D'un autre côté, le Buffer Cache est utilisé pour exécuter les requêtes, pour les index, c’est-à-dire que le plan dépend de la taille de nos caches. Si nous réduisons simplement ce paramètre, nos plans peuvent changer radicalement.
Par exemple, si nous avons un gros cache sur la production, alors Postgres préférera utiliser l'index. Sinon, il usera de SeqScan. Quel serait l'intérêt si nos plans ne correspondaient pas ?
Nous arrivons donc à cette conclusion : en réalité, le plan dans Postgres ne dépend pas de la taille spécifiée dans le Shared Buffer, mais dépend de l'effective_cache_size.
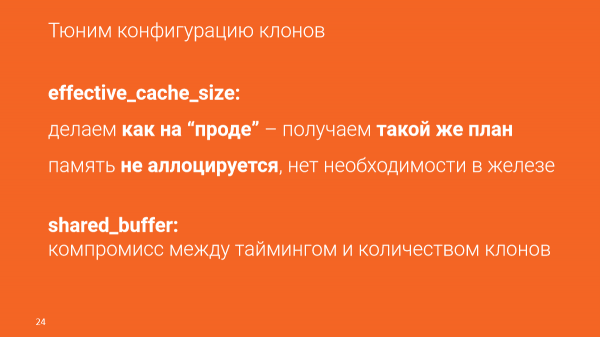
L'effective_cache_size est le volume de cache estimé qui est à notre disposition, c’est-à-dire la somme du Buffer Cache et du cache du système de fichiers. Cela est défini dans la configuration. Et cette mémoire n'est pas allouée.
Grâce à ce paramètre, nous pouvons quelque sorte duper Postgres, en lui disant qu'il nous est en fait accessible une grande quantité de données, même si nous n'avons pas ces données. Ainsi, les plans coïncideront complètement avec ceux de la production.
Mais cela peut affecter le timing. Nous optimisons les requêtes en fonction du timing, mais il est important de noter que le timing dépend de nombreux facteurs :
Il dépend de la charge actuelle sur la production.
Il dépend des caractéristiques de la machine elle-même.
C'est un paramètre indirect, mais en réalité, nous pouvons optimiser en fonction de la quantité de données que cette requête devra lire pour obtenir le résultat.
Et si vous souhaitez que le timing soit proche de ce que nous verrons en production, nous devons utiliser du matériel aussi similaire que possible, et peut-être même plus, afin que tous les clones puissent tenir. Mais c'est un compromis, c'est-à-dire que vous obtiendrez des plans similaires, vous pourrez voir combien de données une requête spécifique lira et en déduire si cette requête est bonne (ou une migration) ou mauvaise, et qu'elle doit encore être optimisée.
Voyons comment l'optimisation se passe concrètement avec Joe.
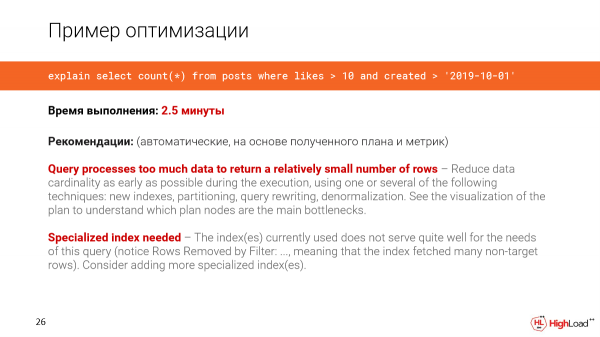
Prenons une requête d'un système réel. Dans ce cas, la base de données fait 1 To. Et nous voulons compter le nombre de nouveaux posts ayant reçu plus de 10 likes.
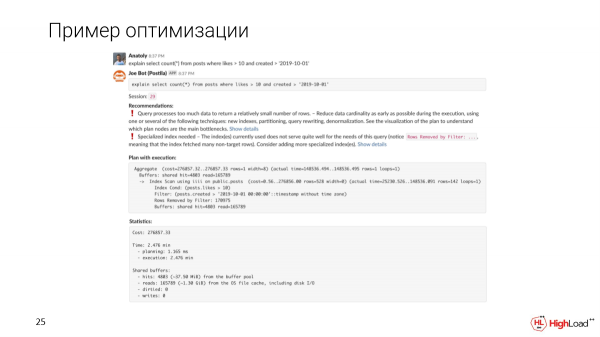
Nous écrivons un message dans le canal, un clone s'est déployé pour nous. Et nous verrons que cette requête sera exécutée en 2,5 minutes. C'est la première chose que nous allons remarquer.
B Joe affichera des recommandations automatiques basées sur le plan et les métriques.
Nous verrons que la requête traite trop de données pour obtenir un nombre relativement restreint de lignes. Et il faut un index spécialisé, car nous avons remarqué qu'il y a trop de lignes filtrées dans la requête.
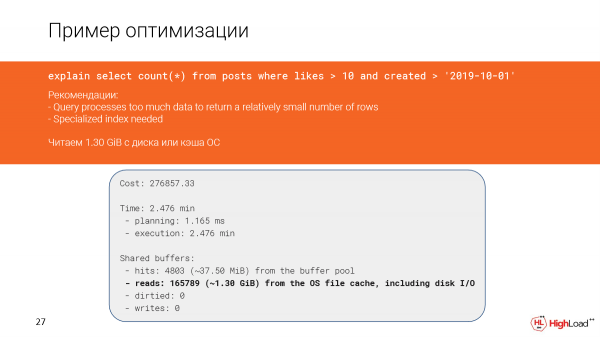
Examinons de plus près ce qui s'est passé. En effet, nous voyons que nous avons lu presque un giga et demi de données depuis le cache de fichiers ou même depuis le disque. Et ce n'est pas bon, puisque nous n'avons obtenu que 142 lignes.
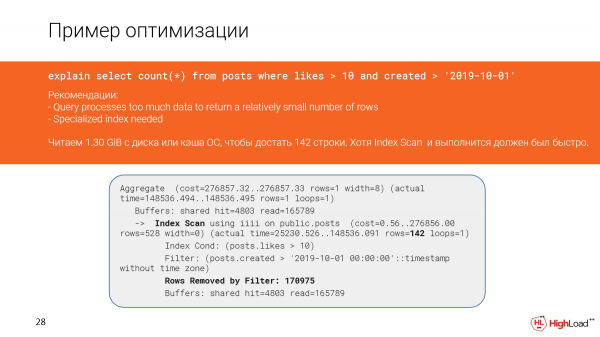
Et, apparemment, nous avons ici un index scan qui aurait dû être rapide, mais, comme nous avons filtré trop de lignes (nous avons dû les compter), la requête a été exécutée lentement.
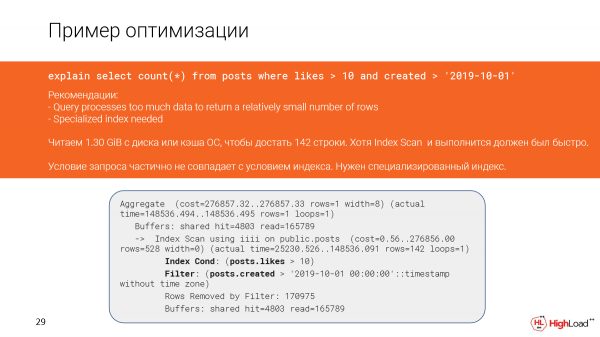
Cela est dû au fait que les conditions de la requête et celles de l'index ne correspondent pas entièrement.
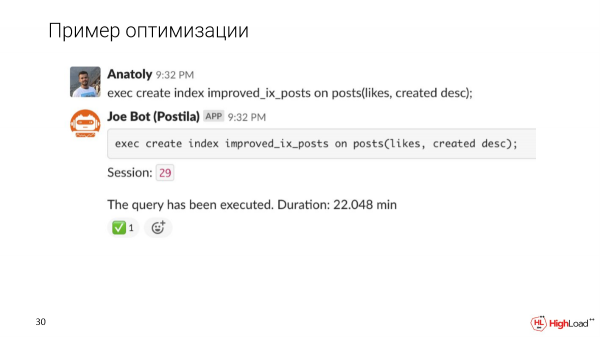
Essayons de rendre l'index plus précis et voyons comment l'exécution de la requête changera après cela.
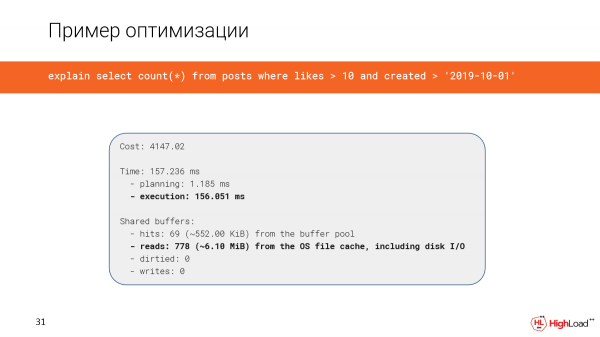
La création de l'index a pris assez de temps, mais maintenant nous vérifions la requête et voyons que le temps est passé de 2,5 minutes à seulement 156 millisecondes, ce qui est assez bon. Et nous lisons seulement 6 mégaoctets de données.
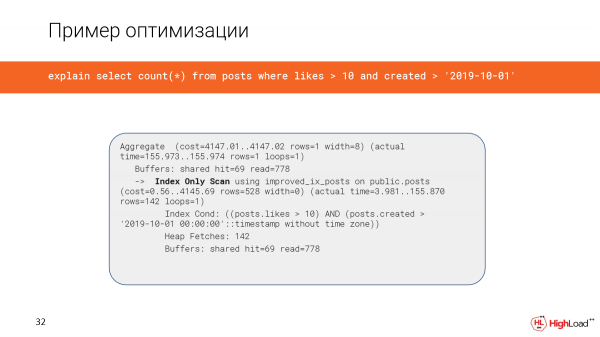
Et maintenant, nous utilisons un index only scan.
Une autre histoire importante est que nous souhaitons présenter le plan d'une manière plus compréhensible. Nous avons intégré une visualisation à l'aide des Flame Graphs.
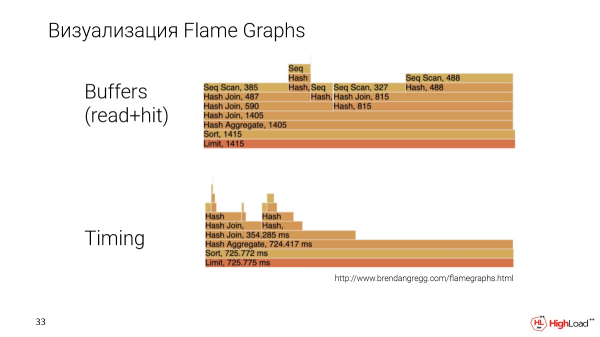
C'est une autre requête, plus riche. Et nous construisons les Flame Graphs selon deux paramètres : la quantité de données que nœud spécifique dans le plan a lue et le timing, c'est-à-dire le temps d'exécution du nœud.
Ici, nous pouvons comparer les nœuds spécifiquement entre eux. Il sera alors clair lequel d'entre eux occupe plus ou moins d'espace, ce qui est généralement difficile à faire avec d'autres méthodes de visualisation.
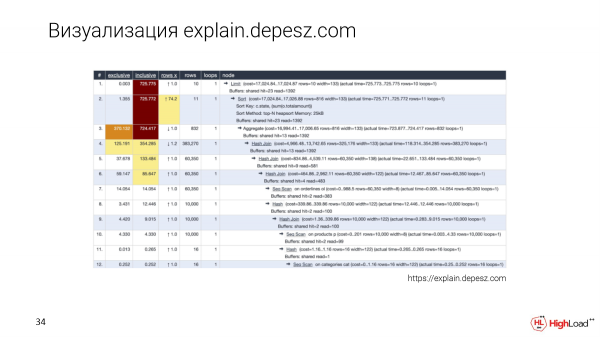
Bien sûr, tout le monde connaît explain.depesz.com. Une bonne fonctionnalité de cette visualisation est qu'elle conserve le plan textuel tout en affichant certains paramètres principaux dans un tableau, afin que l'on puisse trier.
Et les développeurs qui ne se sont pas encore plongés dans ce sujet utilisent également explain.depesz.com, car il leur est plus facile de comprendre quelles métriques sont importantes et lesquelles ne le sont pas.
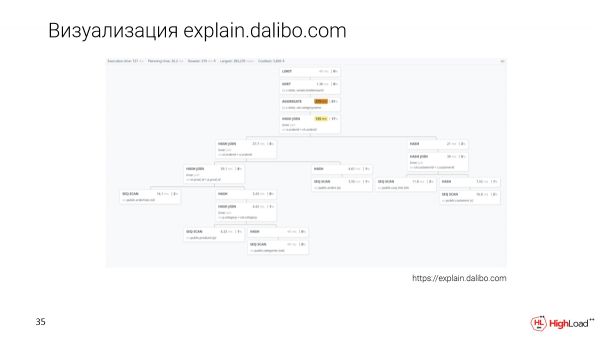
Il existe une nouvelle approche de visualisation – explain.dalibo.com. Ils réalisent une visualisation arborescente, mais ici, il est très difficile de comparer les nœuds entre eux. On peut bien comprendre la structure, cependant, si la requête est importante, il faudra faire défiler de haut en bas, mais c'est aussi une option.
Collaboration
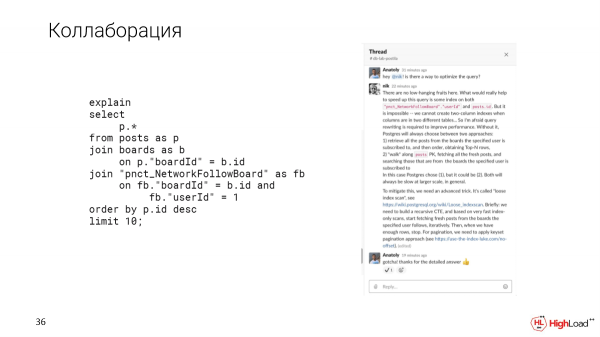
Et comme je l'ai déjà mentionné, Slack nous offre la possibilité de collaborer. Par exemple, si nous sommes confrontés à une requête complexe que nous ne savons pas comment optimiser, nous pouvons clarifier cette question avec nos collègues dans un fil de discussion sur Slack.
Nous pensons qu'il est important de tester sur des données complètes. Pour cela, nous avons créé l'outil Update Database Lab, qui est disponible en open source. Vous pouvez également utiliser le bot Joe. Vous pouvez l'utiliser dès maintenant et l'intégrer chez vous. Tous les guides sont disponibles.
Il est également important de noter que la solution en elle-même n'est pas révolutionnaire, car il existe Delphix, mais c'est une solution d'entreprise. Elle est entièrement fermée et coûte très cher. Nous nous spécialisons précisément sur Postgres. Tous nos produits sont open source. Rejoignez-nous !
Je vais m'arrêter là. Merci !
Questions
Bonjour ! Merci pour la présentation ! C'était très intéressant, surtout pour moi, car j'ai résolu un problème similaire il y a un certain temps. J'ai donc tout un tas de questions. J'espère pouvoir en poser au moins une partie.
C'est intriguant, comment calculez-vous l'espace pour cet environnement ? La technologie suppose que dans certaines circonstances, vos clones peuvent atteindre leur taille maximale. Grossièrement, si vous avez une base de dix téraoctets et 10 clones, il est facile de simuler une situation où chaque clone pèse des données uniques. Comment calculez-vous cet espace, c'est-à-dire le delta dont vous avez parlé, où ces clones vont vivre ?
Bonne question. Il est important de surveiller les clones spécifiques. Et si un clone subit un trop grand changement et commence à croître, nous pouvons d'abord avertir l'utilisateur à ce sujet, ou arrêter immédiatement ce clone afin d'éviter une situation de défaillance.
Oui, j'ai une question complémentaire. C'est-à-dire, comment assurez-vous le cycle de vie de ces modules ? Pour nous, c'est un problème et une histoire à part entière. Comment cela se passe-t-il ?
Chaque clone a un certain TTL. En principe, nous avons un TTL fixe.
Lequel, si ce n'est pas un secret ?
1 heure, c'est-à-dire inactif – 1 heure. S'il n'est pas utilisé, nous le supprimons. Mais il n'y a rien d'étonnant ici, puisque nous pouvons créer un clone en quelques secondes. Et s'il est à nouveau nécessaire, pas de problème.
Je suis également intéressé par le choix des technologies, car nous utilisons par exemple plusieurs méthodes en parallèle pour diverses raisons. Pourquoi ZFS ? Pourquoi n'avez-vous pas utilisé LVM ? Vous avez mentionné avoir eu des problèmes avec LVM. Quels problèmes y aviez-vous ? À mon avis, la solution avec SAN est la plus optimale en termes de performance.
Quel est le principal problème avec ZFS ? C'est que vous devez l'exécuter sur un seul hôte, c'est-à-dire que tous les instances vivront sous un seul système d'exploitation. Alors qu'avec un SAN, vous pouvez connecter différents équipements. Et le goulot d'étranglement n'est constitué que des blocs sur le SAN. Et la question du choix des technologies est pertinente. Pourquoi pas LVM ?
Nous pourrons discuter spécifiquement de LVM lors du meetup. Concernant le SAN – c'est simplement coûteux. Nous pouvons déployer le système ZFS n'importe où. Vous pouvez l'installer sur votre machine. Vous pouvez simplement télécharger le dépôt et le déployer. ZFS s'installe pratiquement partout, si nous parlons de Linux. C'est-à-dire que nous obtiennons une solution très flexible. Et ZFS, en soi, offre beaucoup dès la sortie de la boîte. Vous pouvez y charger autant de données que vous le souhaitez, connecter un grand nombre de disques, il y a des snapshots. Et, comme je l'ai déjà dit, il est facile à administrer. C'est-à-dire qu'il semble très agréable à utiliser. Il a été éprouvé, il existe depuis de nombreuses années. Il a une très grande communauté qui grandit. ZFS est une solution très fiable.
Nikolai Samokhvalov : Puis-je ajouter un commentaire ? Je m'appelle Nikolai, je travaille avec Anatoly. Je suis d'accord que le SAN est excellent. Et certains de nos clients ont du Pure Storage, etc.
Anatoli a raison de souligner que nous visons la modularité. À l'avenir, il sera possible de disposer d'une seule interface : prenez un snapshot, faites un clone, supprimez le clone. C'est facile. Et le stockage est super, si nous en avons un.
Mais ZFS est accessible à tous. Delphix a déjà 300 clients, et parmi eux 50 dans le fortune 100, c'est-à-dire qu'ils ciblent la NASA, etc. Il est temps que cette technologie soit accessible à tous. C'est pourquoi nous avons un Core open source. Nous avons une partie de l'interface qui n'est pas open source. C'est une plateforme que nous allons montrer. Mais nous voulons que cela soit disponible pour chacun. Nous souhaitons révolutionner le secteur pour que tous les testeurs cessent de deviner sur des ordinateurs portables. Nous devons écrire SELECT et voir immédiatement s'il est lent. Il est temps d'arrêter d'attendre que le DBA en parle. Voilà le principal objectif. Et je pense que nous y parviendrons tous. Et cette solution, nous la concevons pour qu'elle soit accessible à tous. C'est pourquoi ZFS, car il sera disponible partout. Merci à la communauté pour la résolution des problèmes et pour le respect de la licence open source, etc.
Bonjour ! Merci pour la présentation ! Je m'appelle Maxim. Nous avons rencontré des problèmes similaires. Nous les avons résolus chez nous. Comment répartissez-vous les ressources entre ces clones ? Chaque clone peut à un moment donné travailler sur sa propre charge : l'un teste une chose, un autre teste autre chose, l'un construit un index, un autre exécute une tâche lourde. Et si l'on peut encore répartir par CPU, comment faites-vous pour l'IO ? C'est la première question.
Et ma deuxième question concerne la dissimilarité des environnements. Supposons que j'ai ZFS ici et que tout fonctionne bien, mais que le client en production n’a pas ZFS, mais ext4 par exemple. Que faire dans ce cas ?
Ces questions sont très pertinentes. J'ai brièvement abordé le problème concernant la répartition des ressources. La solution est la suivante. Imaginez que vous testez en staging. Vous pouvez également rencontrer une situation où quelqu'un génère une charge et quelqu'un d'autre en génère une autre. Au final, vous voyez des métriques incompréhensibles. Même le même problème peut survenir en production. Lorsque vous voulez vérifier une certaine requête et que vous constatez qu'il y a un problème avec elle - elle s'exécute lentement, il s'agit en réalité d'une charge parallèle qui pose problème, pas de la requête elle-même.
C'est pourquoi il est important de se concentrer sur le plan, les étapes à suivre dans ce plan et combien de données nous allons mobiliser. Le fait que nos disques soient, par exemple, chargés par quelque chose affectera particulièrement le timing. Mais nous pouvons estimer la charge de cette requête en fonction de la quantité de données. Ce n'est pas si important que d'autres processus s'exécutent en même temps.
J'ai deux questions. C'est un concept très intéressant. Avez-vous déjà rencontré des cas où les données en production sont critiques, par exemple, les numéros de carte de crédit ? Existe-t-il quelque chose de prêt à l'emploi ou est-ce une tâche distincte ? Et ma deuxième question – existe-t-il quelque chose de similaire pour MySQL ?
Concernant les données. Nous allons procéder à un obfuscation, même si cela n'est pas encore fait. Mais si vous déployez spécifiquement Joe, et si vous ne donnez pas accès aux développeurs, alors il n'y a pas d'accès aux données. Pourquoi ? Parce que Joe ne montre pas les données. Il n'affiche que des métriques, des plans, et c'est tout. Cela a été conçu ainsi car c'est une des exigences de notre client. Ils voulaient avoir la possibilité d'optimiser, tout en ne donnant pas accès à tout le monde.
En ce qui concerne MySQL. Ce système peut être utilisé pour n'importe quoi qui stocke l'état sur le disque. Et comme nous travaillons avec Postgres, notre priorité actuelle est d'automatiser totalement Postgres. Nous voulons automatiser l'extraction des données des sauvegardes. Nous configurons Postgres correctement. Nous savons comment faire en sorte que les plans correspondent, etc.
Mais comme le système est extensible, il pourra également être utilisé pour MySQL. Des exemples existent déjà. Il y a un système similaire utilisé par Yandex, mais ils ne le publient nulle part. Ils l'utilisent à l'intérieur de Yandex.Metrics. Et c'est précisément une histoire liée à MySQL. Mais les technologies sont les mêmes, ZFS.
Merci pour votre présentation ! J'ai aussi quelques questions. Vous avez mentionné que le clonage peut être utilisé pour l'analytique, par exemple, pour y construire des index supplémentaires. Pourriez-vous expliquer plus en détail comment cela fonctionne ?
Et je vais poser ma deuxième question concernant l'uniformité des environnements et des plans. Le plan dépend également des statistiques collectées par Postgres. Comment résolvez-vous ce problème ?
Il n'y a pas d'analytique spécifique pour ces cas, car nous ne l'avons pas encore utilisée de cette manière, mais cette possibilité existe. Si nous parlons des index, imaginez qu'une requête est exécutée sur une table contenant des centaines de millions d'enregistrements et sur une colonne qui n'est généralement pas indexée en production. Et nous voulons procéder à certains calculs. Si cette requête est exécutée en production, il y a un risque de temps d'attente, car la requête pourrait prendre une minute à s'exécuter.
D'accord, faisons un clone léger, que l'on n'a pas peur d'arrêter pendant quelques minutes. Et pour rendre l'analyse plus confortable, nous ajouterons des index sur les colonnes qui nous intéressent.
L'index sera-t-il créé à chaque fois ?
Nous pouvons faire en sorte de manipuler les données, de créer des instantanés, puis de se restaurer à partir de cet instantané et d'exécuter de nouvelles requêtes. C'est-à-dire qu'il est possible d'élever de nouveaux clones avec des index déjà en place.
En ce qui concerne la question sur la statistique, si nous restaurons à partir d'une sauvegarde, si nous faisons de la réplication, nos statistiques resteront exactement les mêmes. Parce que nous aurons entièrement la structure physique des données, c'est-à-dire que nous ramènerons également les données telles quelles avec toutes les métriques statistiques.
C'est un autre problème. Si vous utilisez une solution cloud, seuls des dumps logiques sont disponibles, car Google et Amazon ne vous permettent pas de prendre une copie physique. Cela posera donc problème.
Merci pour la présentation. Deux bonnes questions ont été posées ici concernant MySQL et la répartition des ressources. Mais en réalité, tout se résume à une question qui n'est pas spécifique aux SGBD, mais plutôt au système de fichiers dans son ensemble. Par conséquent, les questions de répartition des ressources doivent également être résolues à ce niveau, et non à la fin, en considérant cela comme Postgres, mais plutôt dans le système de fichiers. le serveur, dans l'instance.
Ma question porte légèrement sur un autre sujet. Elle est plus axée sur la multidimensionnalité de la base de données, où plusieurs couches interviennent. Par exemple, nous avons configuré la mise à jour d'une image de dix téraoctets qui fait l'objet d'une réplication. Nous utilisons spécifiquement cette solution pour des bases de données. La réplication s'effectue, les données sont mises à jour. Parallèlement, 100 employés travaillent en continu, exécutant ces différents instantanés. Que faire ? Comment éviter les conflits, car ils peuvent exécuter une tâche, puis le système de fichiers change et ces instantanés deviennent erronés ?
Ils ne partiront pas, car c'est ainsi que fonctionne ZFS. Nous pouvons maintenir séparément dans un seul flux les modifications du système de fichiers, qui arrivent grâce à la réplication. Et conserver des clones des anciennes versions des données, que les développeurs utilisent. Et cela fonctionne pour nous, tout va bien avec ça.
Donc, la mise à jour se fera comme une couche supplémentaire, et toutes les nouvelles instantanés seront basées sur cette couche, n'est-ce pas ?
Des couches précédentes, qui étaient issues des précédentes réplications.
Les couches précédentes seront supprimées, mais elles feront référence à l'ancienne couche, et les nouvelles images seront prises de la dernière couche obtenue lors de la mise à jour ?
En général, oui.
Alors, en conséquence, nous aurons beaucoup de couches. Et avec le temps, il faudra les compresser ?
Oui, tout à fait. Il y a une certaine fenêtre. Nous conservons des snapshots hebdomadaires. Cela dépend de la capacité que vous avez. Si vous avez la possibilité de conserver beaucoup de données, vous pouvez garder des snapshots pendant longtemps. Ils ne s'effaceront pas d'eux-mêmes. Il n'y aura pas de corruption des données. Si des snapshots deviennent obsolètes, comme nous le pensons, c'est-à-dire que cela dépend de la politique de l'entreprise, nous pouvons simplement les supprimer et libérer de l'espace.
Bonjour, merci pour la présentation ! Concernant la question de Joe. Vous avez dit que le client ne voulait pas donner un accès général aux données. Stricte parlant, si quelqu'un a le résultat d'Explain Analyze, il peut voir les données.
C'est tout à fait cela. Par exemple, nous pouvons écrire : « SELECT FROM WHERE email = quelque chose ». C'est-à-dire que nous ne verrons pas les données elles-mêmes, mais nous pouvons voir certains indices indirects. Il faut comprendre cela. Mais d'un autre côté, tout cela est visible. Nous avons une audit des logs, nous avons le contrôle d'autres collègues qui voient aussi ce que font les développeurs. Et si quelqu'un essaie de faire cela, le service de sécurité viendra et s'occupera de cette question.
Bonjour ! Merci pour la présentation ! J'ai une courte question. Si Slack n'est pas utilisé dans l'entreprise, y a-t-il actuellement un lien avec cela ou les développeurs peuvent-ils déployer des instances pour connecter une application de test aux bases de données ?
Actuellement, il y a une intégration avec Slack, c'est-à-dire qu'il n'y a aucun autre messager, mais nous aimerions vraiment ajouter la prise en charge d'autres messagers également. Que pouvez-vous faire ? Vous pouvez déployer DB Lab sans Joe, utiliser l'API REST ou notre plateforme pour créer des clones et vous connecter avec PSQL. Mais cela nécessite de donner à vos développeurs un accès aux données, car il n'y aura pas d'écran ici.
Je n'ai pas besoin de cet intermédiaire, mais d'une telle possibilité.
Alors oui, cela peut être fait.
Source : habr.com
