

Bonjour à tous ! Je m'appelle Oleg Sidorenkov, je travaille chez DomClick en tant que responsable de l'équipe infrastructure. Nous exploitons « Kubik » en production depuis plus de trois ans, et durant ce temps, nous avons vécu de nombreux moments intéressants avec lui. Aujourd'hui, je vais vous expliquer comment, en adoptant la bonne approche, vous pouvez tirer encore plus de performance de votre cluster Kubernetes « vanille ». Prêts, partez !
Vous savez tous très bien que Kubernetes est un système évolutif de code ouvert pour l'orchestration des conteneurs ; enfin, ou 5 binaires qui font de la magie en gérant le cycle de vie de vos microservices dans un environnement serveur. De plus, c'est un outil assez flexible que l'on peut assembler comme un ensemble Lego pour une personnalisation maximale selon différentes tâches.
Tout semble aller pour le mieux : mettez les serveurs dans le cluster comme du bois dans un four et ne vous inquiétez pas. Mais si vous pensez à l'écologie, vous vous demanderez : « Comment puis-je entretenir le feu dans la cheminée tout en préservant la forêt ? ». Autrement dit, comment trouver des moyens d'améliorer l'infrastructure tout en réduisant les coûts.
1. Surveillez les ressources des équipes et des applications
Une des méthodes les plus banales mais efficaces est l'introduction de requests/limits. Séparez les applications par namespaces, et les namespaces par équipes de développement. Attribuez aux applications, avant déploiement, des valeurs de consommation en termes de temps CPU, mémoire, et stockage éphémère.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
Par expérience, nous avons constaté qu'il ne faut pas gonfler les requests par rapport aux limits de plus du double. Le volume du cluster est calculé en fonction des requests, et si vous attribuez aux applications une différence de ressources, par exemple, de 5 à 10 fois, imaginez ce qui arrivera à votre nœud lorsqu'il sera rempli de pods et recevra soudain une charge. Rien de bon. Au minimum, du throttling, et au maximum, vous direz adieu à votre worker et aurez une charge cyclique sur les autres nœuds après que les pods aient commencé à migraient.
De plus, à l'aide de limitranges vous pouvez définir dès le départ des valeurs de ressources pour le conteneur — minimales, maximales et par défaut :
➜  ~ kubectl describe limitranges --namespace ops
Name:       limit-range
Namespace:  ops
Type        Resource           Min   Max   Default Request  Default Limit  Max Limit/Request Ratio
----        --------           ---   ---   ---------------  -------------  -----------------------
Container   cpu                50m   10    100m             100m           2
Container   ephemeral-storage  12Mi  8Gi   128Mi            4Gi            -
Container   memory             64Mi  40Gi  128Mi            128Mi          2
N'oubliez pas de limiter les ressources du namespace pour qu'une équipe ne puisse pas prendre toutes les ressources du cluster :
➜  ~ kubectl describe resourcequotas --namespace ops
Name:                   resource-quota
Namespace:              ops
Resource                Used          Hard
--------                ----          ----
limits.cpu              77250m        80
limits.memory           124814367488  150Gi
pods                    31            45
requests.cpu            53850m        80
requests.memory         75613234944   150Gi
services                26            50
services.loadbalancers  0             0
services.nodeports      0             0
Comme on peut le voir dans la description resourcequotas, si l'équipe ops souhaite déployer des pods qui utiliseront encore 10 CPU, l'ordonnanceur ne le permettra pas et renverra une erreur :
Error creating: pods "nginx-proxy-9967d8d78-nh4fs" is forbidden: exceeded quota: resource-quota, requested: limits.cpu=5,requests.cpu=5, used: limits.cpu=77250m,requests.cpu=53850m, limited: limits.cpu=10,requests.cpu=10Pour résoudre un tel problème, on peut écrire un outil, par exemple, comme , capable de stocker et de commettre l'état des ressources des équipes.
2. Choisissez un stockage de fichiers optimal
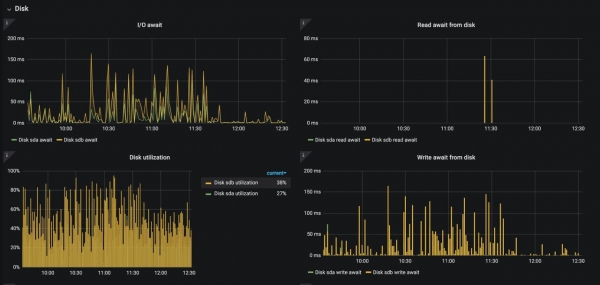
Ici, je voudrais aborder le sujet des volumes persistants et du système de stockage des nœuds de travail de Kubernetes. J'espère que personne n'utilise de « Cube » sur HDD en production, mais parfois un SSD standard devient déjà insuffisant. Nous avons été confrontés au problème où les journaux saturent le disque par les opérations d'entrée-sortie, et les options de solution ne sont pas très nombreuses :
Utiliser des SSD hautes performances ou passer à NVMe (si vous gérez vous-même votre matériel).
Réduire le niveau de journalisation.
Effectuer un équilibre « intelligent » des pods qui saturent le disque (
podAntiAffinity).
L'écran ci-dessus montre ce qui se passe avec le disque lors de l'utilisation du nginx-ingress-controller lorsque la journalisation access_logs est activée (~12 000 journaux/sec.). Cet état peut évidemment mener à une dégradation de toutes les applications sur ce nœud.
En ce qui concerne les PV, malheureusement, je n'ai pas testé tous les Volumes persistants. Utilisez la meilleure option qui vous convient. Historiquement, une petite partie des services a besoin de volumes RWX, et pour cela, on utilise depuis longtemps le stockage NFS. C'est bon marché et... suffisant. Bien sûr, nous avons rencontré de nombreux problèmes - mais nous avons appris à l'optimiser, et nous n'avons plus de soucis. Si possible, passez à un stockage d'objets S3.
3. Rassemblez des images optimisées
Il est préférable d'utiliser des images optimisées pour les conteneurs, afin que Kubernetes puisse les récupérer plus rapidement et les exécuter de manière plus efficace.
L'optimisation signifie que les images :
contiennent une seule application ou effectuent une seule fonction ;
sont de petite taille, car les grandes images sont plus mal transmises sur le réseau ;
ont des points de terminaison pour vérifier l'état de santé et la disponibilité, permettant à Kubernetes d'agir en cas de pannes ;
utilisent des systèmes d'exploitation favorables aux conteneurs (comme Alpine ou CoreOS), qui sont plus résilients aux erreurs de configuration ;
utilisent des constructions multi-étapes, afin que vous puissiez déployer uniquement des applications compilées, et non des sources connexes.
Il existe de nombreux outils et services permettant de vérifier et d'optimiser les images à la volée. Il est important de toujours les maintenir à jour et vérifiés en termes de sécurité. En fin de compte, vous obtenez :
Une réduction de la charge réseau sur l'ensemble du cluster.
Une diminution du temps de démarrage du conteneur.
Un volume réduit de tout votre registre Docker.
4. Utilisez le cache DNS
En ce qui concerne les charges élevées, il est assez difficile de vivre sans l'optimisation du système DNS du cluster. Il y a longtemps, les développeurs de Kubernetes prenaient en charge leur solution kube-dns. Celle-ci a été mise en œuvre chez nous, mais ce logiciel n'a pas été particulièrement optimisé et ne fournissait pas la performance requise, même si la tâche semblait simple. Puis est arrivé coredns, que nous avons adopté et qui nous a donné satisfaction ; il est devenu le service DNS par défaut dans K8s. À un moment donné, nous avons atteint 40 000 rps sur le système DNS, et cette solution est devenue insuffisante. Mais, par un heureux hasard, Nodelocaldns est sorti, également connu sous le nom de cache local de nœud, .
Pourquoi utilisons-nous cela ? Il y a un bug dans le noyau Linux qui, lors d'un accès multiple via conntrack NAT par UDP, conduit à une condition de course pour l'écriture dans les tables conntrack, et une partie du trafic à travers le NAT est perdue (chaque appel à travers le Service passe par le NAT). Nodelocaldns résout ce problème en éliminant le NAT et en mettant à niveau la connexion vers TCP pour les DNS en amont, ainsi qu'en mettant en cache localement les requêtes DNS vers les sources amont (y compris un court cache négatif de 5 secondes).
5. Scalez les pods horizontalement et verticalement de manière automatique
Pouvez-vous affirmer avec confiance que tous vos microservices sont prêts pour une augmentation de charge de deux à trois fois ? Comment allouer correctement les ressources à vos applications ? Avoir quelques pods en plus de la charge de travail peut sembler redondant, et en garder juste assez vous expose au risque d'un arrêt soudain en cas de pic de trafic sur le service. La voie du juste milieu est facilitée par des services tels que et .
VPA permet d'augmenter automatiquement les requests/limits de vos conteneurs dans le pod en fonction de l'utilisation réelle. En quoi cela peut-il être utile ? Si vous avez des pods qui ne peuvent pas être mis à l'échelle horizontalement pour une raison quelconque (ce qui n'est pas tout à fait fiable), vous pouvez essayer de confier l'ajustement de ses ressources au VPA. Son atout réside dans un système de recommandations basé sur des données historiques et actuelles provenant du metric-server, donc, si vous ne souhaitez pas changer automatiquement les requests/limits, vous pouvez simplement suivre les ressources recommandées pour vos conteneurs et optimiser les paramètres pour économiser du CPU et de la mémoire dans le cluster.
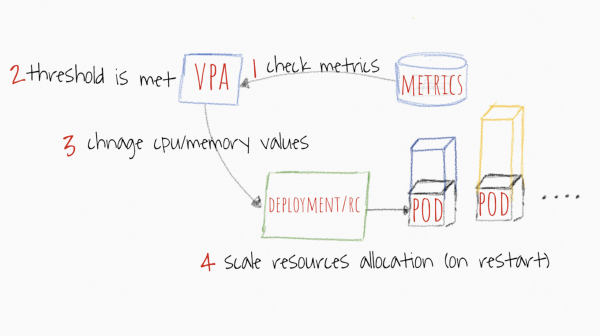 L'image est tirée de https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Le planificateur dans Kubernetes est toujours basé sur les requests. Quelle que soit la valeur que vous y attribuez, le planificateur cherchera un nœud approprié en fonction de celle-ci. Les valeurs des limits sont nécessaires au kubelet pour comprendre quand limiter ou tuer un pod. Et puisque le seul paramètre important est la valeur des requests, le VPA travaillera avec cela. Chaque fois que vous définissez le dimensionnement vertical d'une application, vous déterminez quelles doivent être les requests. Et qu'en est-il des limits ? Ce paramètre sera également redimensionné proportionnellement.
Par exemple, voici les configurations normales d'un pod :
ressources:
   demandes:
     mémoire: 250Mi
     cpu: 200m
   limites:
     mémoire: 500Mi
     cpu: 350m
Le mécanisme de recommandation détermine que votre application nécessite 300m de CPU et 500Mi pour fonctionner normalement. Vous obtiendrez ces paramètres :
ressources:
   demandes:
     mémoire: 500Mi
     cpu: 300m
   limites:
     mémoire: 1000Mi
     cpu: 525m
Comme mentionné précédemment, il s'agit d'une mise à l'échelle proportionnelle basée sur le ratio demandes/limites dans le manifeste :
CPU: 200m → 300m : ratio 1:1.75 ;
Mémoire: 250Mi → 500Mi : ratio 1:2.
Concernant HPA, ici le mécanisme est plus transparent. Des seuils de métriques sont définis, par exemple pour le CPU et la mémoire, et si la valeur moyenne de toutes les répliques dépasse le seuil, l'application est mise à l'échelle en ajoutant +1 pod jusqu'à ce que la valeur redescende en dessous du seuil ou jusqu'à atteindre le nombre maximal de répliques.
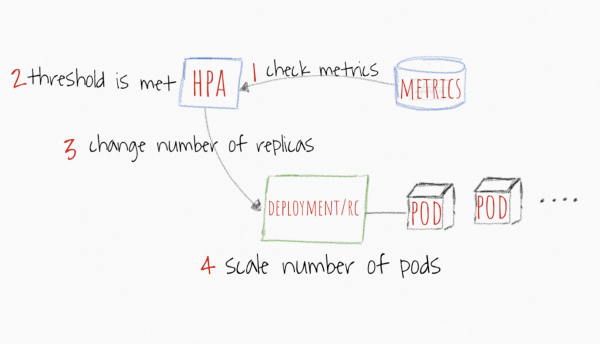 L'image est tirée de https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
En plus des métriques habituelles, comme le CPU et la mémoire, vous pouvez configurer des seuils sur vos métriques personnalisées à partir de Prometheus et travailler avec elles si vous pensez que cela définit le mieux quand il faut mettre à l'échelle votre application. Une fois l'application stabilisée sous la limite de métrique spécifiée, le HPA commencera à réduire le nombre de pods jusqu'à atteindre le minimum de répliques ou jusqu'à ce que la charge soit satisfaisante par rapport au seuil donné.
6. N'oubliez pas le Node Affinity et le Pod Affinity
Tous les nœuds ne fonctionnent pas sur le même matériel, et tous les pods n'ont pas besoin d'exécuter des applications gourmandes en calculs. Kubernetes permet de spécifier une spécialisation des nœuds et des pods à l'aide de Node Affinity et Pod Affinity.
Si vous avez des nœuds adaptés aux opérations gourmandes en calcul, il est préférable de lier les applications à ces nœuds correspondants pour une efficacité maximale. Pour cela, utilisez nodeSelector avec l'étiquette du nœud.
Supposons que vous ayez deux nœuds : un avec CPUType=HIGHFREQ et un grand nombre de cœurs rapides, l'autre avec MemoryType=HIGHMEMORY une grande quantité de mémoire et un débit plus rapide. Le plus simple est d'assigner le déploiement du pod au nœud HIGHFREQ, en ajoutant dans la section spec ce sélecteur :
…
nodeSelector:
	CPUType: HIGHFREQ
Un moyen plus coûteux et spécifique de faire cela est d'utiliser nodeAffinity dans le champ affinity de la section spec. Il existe deux options :
requiredDuringSchedulingIgnoredDuringExecution: configuration stricte (le planificateur ne déploiera des pods que sur des nœuds spécifiques (et nulle part ailleurs));preferredDuringSchedulingIgnoredDuringExecution: configuration flexible (le planificateur essaiera de déployer sur des nœuds spécifiques, et s'il n'y parvient pas, il essaiera sur le prochain nœud disponible).
Vous pouvez spécifier une syntaxe de gestion des étiquettes de nœuds, par exemple, Dans, PasDans, Existe, N'existePas, Gt ou Lt. Cependant, gardez à l'esprit que des méthodes complexes dans de longues listes d'étiquettes ralentiront la prise de décision dans des situations critiques. En d'autres termes, ne compliquez pas.
Comme mentionné précédemment, Kubernetes permet de définir la liaison des pods actuels. Cela signifie que vous pouvez faire en sorte que certains pods fonctionnent avec d'autres pods dans la même zone de disponibilité (pertinent pour les clouds) ou nœuds.
Dans podAffinity champs affinity de la section spec les mêmes champs sont disponibles que dans le cas de nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution et preferredDuringSchedulingIgnoredDuringExecution. La seule différence est que matchExpressions lier les pods à un nœud sur lequel un pod avec cette étiquette est déjà en cours d'exécution.
De plus, Kubernetes propose le champ podAntiAffinity, qui, au contraire, ne lie pas un pod à un nœud avec certains pods.
Concernant les expressions nodeAffinity on peut donner le même conseil : essayez de garder la simplicité et la logique des règles, ne tentez pas de surcharger la spécification des pods avec un ensemble complexe de règles. Il est très facile de créer une règle qui ne correspondra pas aux conditions du cluster, créant une charge supplémentaire sur le planificateur et réduisant les performances globales.
7. Taints & Tolerations
Il existe également un autre moyen de gérer le planificateur. Si vous avez un grand cluster avec des centaines de nœuds et des milliers de microservices, il est très difficile de ne pas permettre à certains pods de se déployer sur certains nœuds.
Le mécanisme des taints aide à cela — règles prohibitives. Par exemple, dans certaines situations, il peut être interdit à certains nœuds d'exécuter des pods. Pour appliquer un taint à un nœud spécifique, vous devez utiliser l'option taint dans kubectl. Spécifiez la clé et la valeur, puis un taint comme NoSchedule ou NoExecute:
$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoScheduleIl convient également de noter que le mécanisme de taint prend en charge trois effets principaux : NoSchedule, NoExecute et PreferNoSchedule.
NoSchedulesignifie que tant qu'il n'y a pas d'enregistrement correspondant dans la spécification du podtolerations, il ne pourra pas être déployé sur le nœud (dans cet exemplenode10).PreferNoSchedule— une version simplifiéeNoSchedule. Dans ce cas, le planificateur tentera de ne pas répartir les pods qui n'ont pas d'enregistrement correspondanttolerationssur le nœud, mais ce n'est pas une restriction stricte. Si le cluster ne dispose pas de ressources, les pods commenceront à se déployer sur ce nœud.NoExecute— cet effet déclenche une évacuation immédiate des pods qui n'ont pas d'enregistrement correspondanttolerations.
Il est intéressant de noter que ce comportement peut être annulé à l'aide du mécanisme des tolerations. Cela est pratique lorsqu'il existe un nœud "interdit" et que vous souhaitez y placer uniquement des services d'infrastructure. Comment faire ? Autorisez uniquement les pods pour lesquels il existe une toleration appropriée.
Voici à quoi ressemblera la spécification du pod :
spec:
   tolerations:
     - key: "node-role.kubernetes.io/ingress"
        operator: "Equal"
        value: "true"
        effect: "NoSchedule"
Cela ne signifie pas qu'au prochain redeploiement, le pod se retrouvera nécessairement sur ce nœud, ce n'est pas un mécanisme d'affinité de nœud et nodeSelector. Mais en combinant plusieurs fonctionnalités, vous pouvez obtenir une configuration très flexible de l'ordonnanceur.
8. Configurez la priorité de déploiement des pods
Le fait que vous ayez configuré la liaison des pods aux nœuds ne signifie pas que tous les pods doivent être traités avec la même priorité. Par exemple, vous pouvez vouloir déployer certains pods avant les autres.
Kubernetes propose différentes manières de configurer la priorité des pods (Pod Priority and Preemption). La configuration se compose de plusieurs parties : l'objet PriorityClass et la description du champ priorityClassName dans la spécification du pod. Examinons un exemple :
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "Cette classe de priorité ne doit être utilisée que pour des pods très importants"
Nous créons PriorityClass, lui attribuons un nom, une description et une valeur. Plus la value, plus la priorité est élevée. La valeur peut être n'importe quel entier 32 bits, inférieur ou égal à 1 000 000 000. Des valeurs plus élevées sont réservées pour des pods système critiques qui ne peuvent généralement pas être évacués. L'évacuation n'aura lieu que si un pod de haute priorité n'a pas d'endroit où se déployer, alors une partie des pods d'un nœud particulier sera évacuée. Si ce mécanisme vous semble trop strict, vous pouvez ajouter l'option preemptionPolicy: Never, et alors il n'y aura pas d'évacuation, le pod sera placé en tête de file et attendra que l'ordonnanceur trouve des ressources libres pour lui.
Ensuite, nous créons un pod dans lequel nous spécifions le nom priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
Vous pouvez créer autant de classes de priorité que vous le souhaitez, bien qu'il soit recommandé de ne pas en abuser (par exemple, se limiter aux priorités basse, moyenne et haute).
Ainsi, si nécessaire, vous pourrez améliorer l'efficacité du déploiement de services critiques, tels que nginx-ingress-controller, coredns, etc.
9. Optimisez le cluster ETCD
On peut considérer ETCD comme le cerveau de tout le cluster. Il est très important de maintenir cette base de données à un niveau élevé, car c'est de là que dépend la vitesse des opérations dans le « Cube ». Il est assez standard, et en même temps pas mal, de garder le cluster ETCD sur les nœuds maîtres afin d'avoir une latence minimale avec le kube-apiserver. Si cela n'est pas possible, placez ETCD aussi près que possible, en ayant une bonne bande passante entre les participants. Faites également attention au nombre de nœuds d'ETCD qui peuvent être perdus sans nuire au cluster.
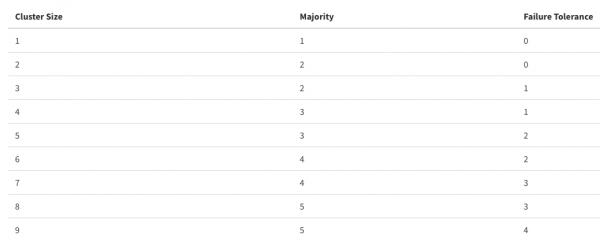
Gardez à l'esprit qu'une augmentation excessive du nombre de participants dans le cluster peut améliorer la tolérance aux pannes au détriment de la performance, tout doit être équilibré.
En ce qui concerne la configuration du service, les recommandations sont rares :
Ayez un bon matériel, en fonction des dimensions du cluster (vous pouvez lire ).
Ajustez quelques paramètres si vous avez réparti le cluster entre plusieurs centres de données ou si votre réseau et vos disques laissent à désirer (vous pouvez lire ).
Conclusion
Cet article décrit des points que notre équipe s'efforce de respecter. Ce n'est pas un guide pas à pas, mais des options qui peuvent être utiles pour optimiser les coûts de fonctionnement du cluster. Il est évident que chaque cluster est unique, et les solutions de configuration peuvent varier considérablement, c'est pourquoi il serait intéressant d'avoir votre retour : comment surveillez-vous votre cluster Kubernetes, avec quoi améliorez-vous son fonctionnement ? Partagez votre expérience dans les commentaires, nous serions ravis de la connaître.
Source : habr.com
