

Bonjour Habr ! Les ensembles de données pour le Big Data et l'apprentissage machine croissent exponentiellement et il est nécessaire de pouvoir les traiter. Notre article porte sur une autre technologie innovante dans le domaine du calcul haute performance (HPC, High Performance Computing), présentée sur le stand de Kingston à . Il s'agit de l'application de systèmes de stockage de données haut de gamme (SDS) dans des serveurs équipés de processeurs graphiques (GPU) et de la technologie de bus GPUDirect Storage. Grâce à l'échange direct de données entre les SDS et les GPU, en contournant le CPU, le chargement des données dans les accélérateurs GPU s'accélère considérablement, permettant ainsi aux applications Big Data d'atteindre des performances maximales fournies par les GPU. Par conséquent, les développeurs de systèmes HPC s'intéressent aux avancées dans le domaine des SDS offrant une vitesse d'entrée/sortie exceptionnelle — comme celles produites par Kingston.
Les performances des GPU surpassent le chargement des données
Depuis la création de CUDA en 2007 — une architecture matérielle et logicielle pour le calcul parallèle basée sur les GPU pour le développement d'applications à usage général, les capacités matérielles des GPU eux-mêmes ont incroyablement augmenté. Aujourd'hui, les GPU sont de plus en plus utilisés dans les applications HPC, telles que le Big Data, l'apprentissage machine (ML, machine learning) et l'apprentissage profond (DL, deep learning).
Notons qu'en dépit de la similarité des termes, les deux derniers représentent des tâches algorithmiquement différentes. Le ML forme l'ordinateur à partir de données structurées, tandis que le DL utilise des réponses de réseaux neuronaux. Un exemple qui aide à comprendre les différences est assez simple. Supposons que l'ordinateur doive distinguer des photos de chats et de chiens téléchargées depuis un stockage. Pour le ML, il faut fournir un ensemble d'images avec de nombreux tags, chacun définissant une caractéristique unique de l'animal. Pour le DL, il suffit de télécharger un nombre beaucoup plus élevé d'images, mais avec un seul tag « c'est un chat » ou « c'est un chien ». Le DL ressemble beaucoup à la manière dont on apprend aux jeunes enfants : on leur montre simplement des images de chiens et de chats dans des livres et dans la vie (souvent sans même expliquer la différence détaillée), et le cerveau de l'enfant commence à identifier le type d'animal après un certain nombre critique d'images à comparer (estimé à une centaine ou deux au cours de l'enfance). Les algorithmes de DL ne sont pas encore suffisamment perfectionnés : pour qu'un réseau neuronal puisse également travailler efficacement à l'identification des formes, il faut fournir et traiter des millions d'images sur le GPU.
Conclusion de l'introduction : il est possible de construire des applications HPC sur des GPU dans le domaine des Big Data, du ML et du DL, mais il existe un problème — les ensembles de données sont si vastes que le temps consacré à charger les données depuis le système de stockage vers le GPU commence à réduire la performance globale de l'application. En d'autres termes, les processeurs graphiques rapides restent sous-utilisés en raison de la lenteur des entrées/sorties de données provenant d'autres sous-systèmes. La différence de vitesse d'entrée/sortie entre le GPU et le bus vers le CPU/périphérie de stockage peut aller jusqu'à un ordre de grandeur.
Comment fonctionne la technologie GPUDirect Storage ?
Le processus d'entrée/sortie est contrôlé par le CPU, tout comme le processus de chargement des données depuis le stockage vers les processeurs graphiques pour un traitement ultérieur. Cela a donné lieu à une demande pour une technologie qui garantirait un accès direct entre les GPU et les disques NVMe pour une interaction rapide entre eux. NVIDIA a été la première à proposer une telle technologie et l'a nommée GPUDirect Storage. En fait, il s'agit d'une variante de leur technologie GPUDirect RDMA (Remote Direct Memory Address) précédemment développée.
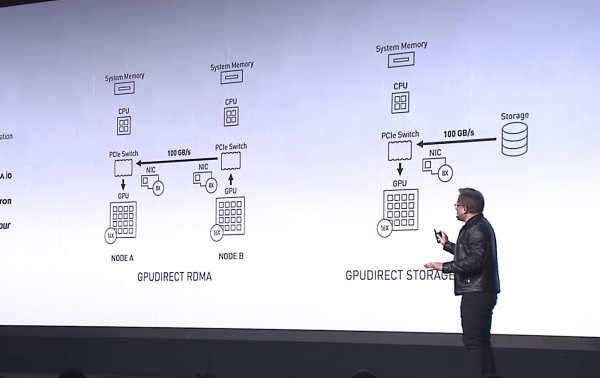
Jensen Huang, PDG de NVIDIA, présente GPUDirect Storage comme une variante de GPUDirect RDMA lors du salon SС-19. Source : NVIDIA
La différence entre GPUDirect RDMA et GPUDirect Storage réside dans les appareils entre lesquels l'adressage est effectué. La technologie GPUDirect RDMA est spécialement conçue pour transférer des données directement entre la carte d'interface réseau (NIC) et la mémoire GPU, tandis que GPUDirect Storage fournit une voie directe pour la transmission de données entre un stockage local ou distant, tel que NVMe ou NVMe over Fabric (NVMe-oF) et la mémoire GPU.
Les deux options, GPUDirect RDMA et GPUDirect Storage, évitent les transferts de données inutiles à travers le tampon de la mémoire CPU et permettent au mécanisme d'accès direct à la mémoire (DMA) de déplacer des données de la carte réseau ou du stockage directement vers la mémoire GPU ou vice versa, sans solliciter le processeur central. Pour GPUDirect Storage, l'emplacement du stockage n'a pas d'importance : cela peut être un disque NVMe à l'intérieur de l'unité avec GPU, dans un rack ou connecté via le réseau comme NVMe-oF.
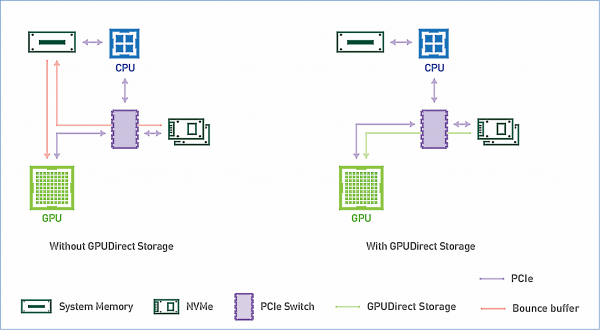
Schéma de fonctionnement de GPUDirect Storage. Source : NVIDIA
Les systèmes de stockage haut de gamme sur NVMe sont en forte demande sur le marché des applications HPC.
Conscient qu'avec l'émergence de GPUDirect Storage, l'intérêt des grands clients se portera sur des systèmes de stockage capables de fournir des vitesses d'entrée/sortie correspondant à la bande passante du GPU, lors de l'exposition SC-19, Kingston a présenté une démonstration d'un système composé d'un stockage à base de disques NVMe et d'une unité GPU, analysant des milliers d'images satellites par seconde. Nous avons déjà parlé de ce système de stockage basé sur 10 disques DC1000M U.2 NVMe. .
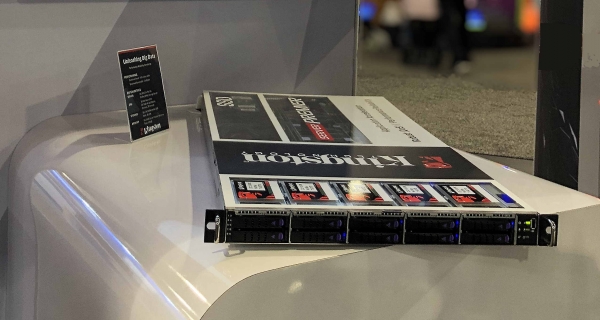
Le stockage basé sur 10 disques DC1000M U.2 NVMe complète de manière adéquate le serveur avec des accélérateurs graphiques. Source : Kingston.
Ce système de stockage se présente sous la forme d'une unité en rack 1U ou plus et peut être évolué en fonction du nombre de disques DC1000M U.2 NVMe, chacun d'une capacité de 3,84 à 7,68 To. Le DC1000M est le premier modèle de SSD NVMe au format U.2 dans la gamme de stockage Kingston pour les centres de données. Il possède une note d'endurance (DWPD, écritures de disque par jour) permettant d'écraser des données à pleine capacité une fois par jour pendant toute la durée de vie garantie du disque.
Dans le test fio v3.13 sous le système d'exploitation Ubuntu 18.04.3 LTS, avec le noyau Linux 5.0.0-31-generic, le système de stockage exposé a montré une vitesse de lecture (Lecture durable) de 5,8 millions IOPS avec une bande passante soutenue (Bande passante durable) de 23,8 Gbit/s.
Ariel Pérez, responsable commercial SSD chez Kingston, a décrit les nouvelles solutions de stockage comme suit : « Nous sommes prêts à fournir la prochaine génération de serveurs avec des solutions SSD U.2 NVMe, afin d'éliminer de nombreux goulets d'étranglement liés au transfert de données, qui ont traditionnellement été associés aux systèmes de stockage. La combinaison de disques NVMe SSD et de notre mémoire vive premium Server Premier DRAM fait de Kingston l'un des fournisseurs les plus complets dans l'industrie pour des solutions de traitement des données. »
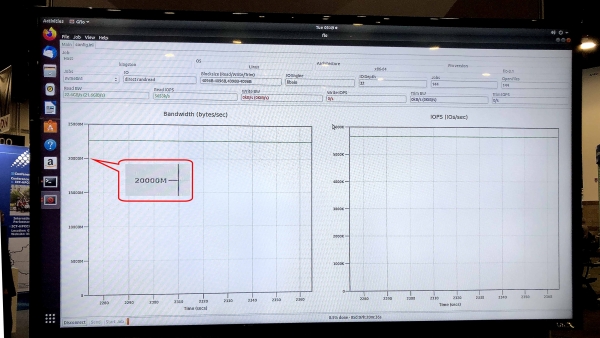
Le test gfio v3.13 a montré une bande passante de 23,8 Gbit/s pour la démonstration d'un système de stockage utilisant des disques DC1000M U.2 NVMe. Source : Kingston
À quoi ressemblerait un système typique pour des applications HPC utilisant la technologie GPUDirect Storage ou une technologie similaire ? C'est une architecture avec une séparation physique des blocs fonctionnels au sein de l'armoire : une ou deux unités pour la mémoire vive, plusieurs pour les nœuds de calcul GPU et CPU, et une ou plusieurs unités pour le système de stockage.
Avec l'annonce de GPUDirect Storage et l'éventuelle arrivée de technologies similaires chez d'autres fournisseurs de GPU, Kingston voit une demande croissante pour des systèmes de stockage conçus pour des calculs haute performance. Un indicateur clé sera la vitesse de lecture des données à partir des systèmes de stockage, comparable à la bande passante des cartes réseau de 40 ou 100 Gbit/s à l'entrée du nœud de calcul avec GPU. Ainsi, des systèmes de stockage ultra-rapides, y compris des NVMe externes via Fabric, deviendront la norme pour les applications HPC. En dehors de la science et des calculs financiers, ils trouveront leur place dans de nombreux autres domaines pratiques, comme les systèmes de sécurité de niveau métropolitain Safe City ou les centres de surveillance des transports, où la rapidité de reconnaissance et d'identification à des millions d'images HD par seconde est requise », a souligné la niche de marché pour les systèmes de stockage haut de gamme.
Pour plus d'informations sur les produits Kingston, vous pouvez consulter de l'entreprise.
Source : habr.com
