

Bonjour, Habr ! Dans cet article, je souhaite vous parler d'un outil remarquable pour le développement de processus batch de traitement de données, par exemple, dans l'infrastructure d'un DWH d'entreprise ou de votre DataLake. Nous allons parler d'Apache Airflow (ci-après Airflow). Il est injustement sous-estimé sur Habr, et dans la majeure partie de l'article, j'essaierai de vous convaincre qu'au moins Airflow mérite d'être considéré lors du choix d'un planificateur pour vos processus ETL/ELT.
Auparavant, j'avais écrit une série d'articles sur le thème du DWH, lorsque je travaillais chez Tinkoff Bank. Maintenant, je fais partie de l'équipe de Mail.Ru Group et je m'occupe du développement d'une plateforme pour l'analyse de données dans le domaine du jeu. En fait, au fur et à mesure que des nouvelles et des solutions intéressantes apparaissent, mon équipe et moi allons parler ici de notre plateforme d'analyse de données.
Prologue
Alors, commençons. Qu'est-ce qu'Airflow ? C'est une bibliothèque (ou plutôt ) pour le développement, la planification et le monitoring des workflows. La principale caractéristique d'Airflow : pour décrire (développer) les processus, on utilise du code en langage Python. D'où découle une multitude d'avantages pour l'organisation de votre projet et son développement : en fait, votre projet ETL (par exemple) n'est rien d'autre qu'un projet Python, et vous pouvez l'organiser comme bon vous semble, en tenant compte des spécificités de l'infrastructure, de la taille de l'équipe et d'autres exigences. Côté outils, c'est simple. Utilisez, par exemple, PyCharm + Git. C'est génial et très pratique !
Examinons maintenant les principales entités d'Airflow. En comprenant leur essence et leur fonction, vous optimiserez l'architecture de vos processus. Probablement, l'entité principale est le Directed Acyclic Graph (ci-après DAG).
DAG
Le DAG est une sorte d'union significative de vos tâches que vous souhaitez exécuter dans un ordre strictement défini selon un calendrier spécifique. Airflow offre une interface web conviviale pour travailler avec les DAG et d'autres entités :
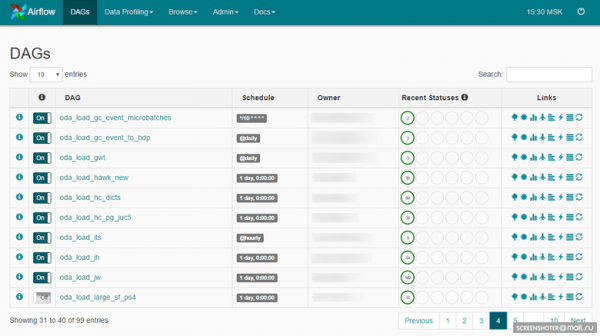
Le DAG peut ressembler à ceci :
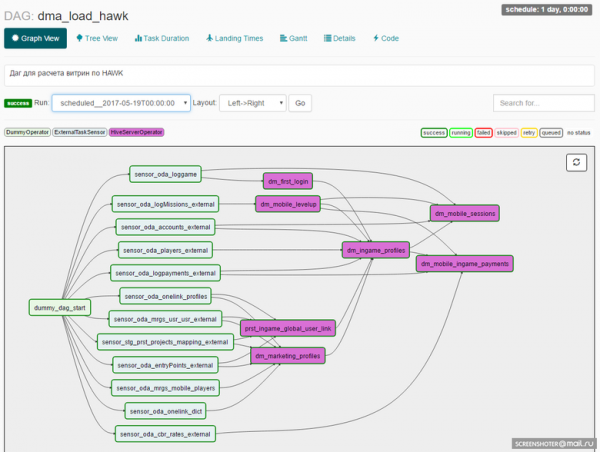
Lorsqu'un développeur conçoit un DAG, il définit un ensemble d'opérateurs sur lesquels les tâches au sein du DAG seront basées. Nous arrivons ici à une autre entité importante : l'Airflow Operator.
Les opérateurs
L'Opérateur est une entité à partir de laquelle des instances de tâches sont créées, décrivant ce qui se passera lors de l'exécution de l'instance de la tâche. contiennent déjà un ensemble d'opérateurs prêts à l'emploi. Exemples :
- BashOperator — opérateur pour exécuter une commande bash.
- PythonOperator — opérateur pour appeler du code Python.
- EmailOperator — opérateur pour envoyer un email.
- HTTPOperator — opérateur pour travailler avec des requêtes http.
- SqlOperator — opérateur pour exécuter du code SQL.
- Sensor — opérateur d'attente d'un événement (survenance d'un moment précis, apparition d'un fichier requis, ligne dans une base de données, réponse d'une API, etc.).
Il existe des opérateurs plus spécifiques : DockerOperator, HiveOperator, S3FileTransferOperator, PrestoToMysqlOperator, SlackOperator.
Vous pouvez également développer des opérateurs en fonction de vos spécificités et les utiliser dans le projet. Par exemple, nous avons créé MongoDBToHiveViaHdfsTransfer, un opérateur pour exporter des documents de MongoDB vers Hive, et plusieurs opérateurs pour travailler avec : CHLoadFromHiveOperator et CHTableLoaderOperator. En essence, dès qu'une portion de code fréquemment utilisée émerge dans un projet, basée sur des opérateurs de base, on peut envisager de la rassembler en un nouvel opérateur. Cela simplifiera le développement futur et enrichira votre bibliothèque d'opérateurs dans le projet. Ensuite, tous ces instances de tâches doivent être exécutées, et parlons maintenant du planificateur.
Le planificateur de tâches dans Airflow est basé sur
Planificateur
Celery. Chaque pool a une limite de nombre de slots. Lors de la création d'un DAG, il se voit assigner un pool :
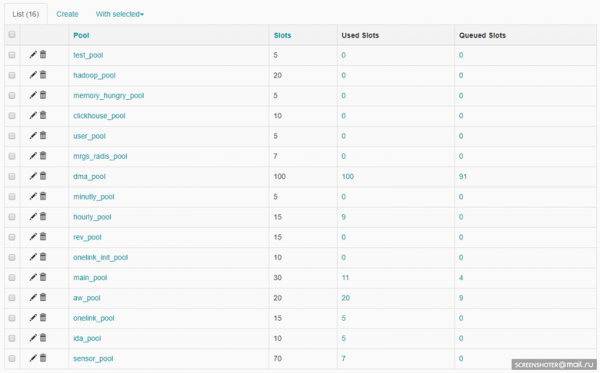
ALERT_MAILS = Variable.get("gv_mail_admin_dwh") DAG_NAME = 'dma_load' OWNER = 'Vasya Pupkin' DEPENDS_ON_PAST = True EMAIL_ON_FAILURE = True EMAIL_ON_RETRY = True RETRIES = int(Variable.get('gv_dag_retries')) POOL = 'dma_pool' PRIORITY_WEIGHT = 10start_dt = datetime.today() - timedelta(1) start_dt = datetime(start_dt.year, start_dt.month, start_dt.day)default_args = { 'owner': OWNER, 'depends_on_past': DEPENDS_ON_PAST, 'start_date': start_dt, 'email': ALERT_MAILS, 'email_on_failure': EMAIL_ON_FAILURE, 'email_on_retry': EMAIL_ON_RETRY, 'retries': RETRIES, 'pool': POOL, 'priority_weight': PRIORITY_WEIGHT } dag = DAG(DAG_NAME, default_args=default_args) dag.doc_md = __doc__
Le pool défini au niveau du DAG peut être redéfini au niveau de la tâche.La planification de toutes les tâches dans Airflow est assurée par un processus distinct — le Scheduler. En réalité, le Scheduler s'occupe de toute la mécanique de la mise en exécution des tâches. Avant d'être exécutée, une tâche passe par plusieurs étapes :
La planification de toutes les tâches dans Airflow est gérée par un processus distinct : le Scheduler. En effet, le Scheduler s'occupe de toute la mécanique de mise en œuvre des tâches. Avant qu'une tâche ne soit exécutée, elle passe par plusieurs étapes :
- Dans le DAG, les tâches précédentes ont été exécutées, une nouvelle peut être mise en file d'attente.
- La file d'attente est triée en fonction de la priorité des tâches (ces priorités peuvent également être gérées), et si un slot est libre dans le pool, la tâche peut être prise en charge.
- S'il y a un worker celery libre, la tâche lui est envoyée ; le travail que vous avez programmé dans la tâche commence, en utilisant un opérateur approprié.
C'est assez simple.
Le Scheduler fonctionne sur tous les DAG et toutes les tâches à l'intérieur des DAG.
Pour que le Scheduler commence à travailler avec un DAG, il faut lui attribuer un calendrier :
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='@hourly')Il existe un ensemble de presets prêts à l'emploi : @once, @hourly, @daily, @weekly, @monthly, @yearly.
On peut également utiliser des expressions cron :
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='*\/10 * * * *')Date d'exécution
Pour comprendre comment Airflow fonctionne, il est important de saisir ce qu'est la Date d'exécution pour un DAG. Dans Airflow, un DAG a une dimension Date d'exécution, c'est-à-dire que des instances de tâches sont créées pour chaque Date d'exécution en fonction du calendrier de travail du DAG. Et pour chaque Date d'exécution, les tâches peuvent être exécutées à nouveau — ou, par exemple, le DAG peut fonctionner simultanément sur plusieurs Dates d'exécution. Cela est clairement illustré ici :
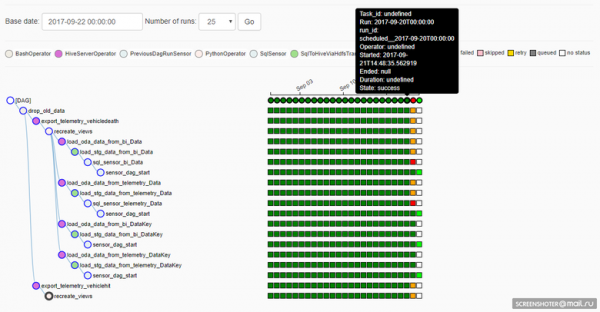
Malheureusement (ou peut-être heureusement : cela dépend de la situation), si la mise en œuvre de la tâche dans le DAG est modifiée, son exécution dans les Dates d'exécution précédentes se fera déjà en tenant compte des ajustements. C'est bien si vous avez besoin de recalculer des données pour des périodes passées avec un nouvel algorithme, mais c'est mal car cela compromet la reproductibilité du résultat (bien sûr, rien n'empêche de revenir à Git pour trouver la version souhaitée du code source et de recalculer ce qui est nécessaire, comme il le faut).
Génération de tâches
La mise en œuvre d'un DAG est du code Python, c'est pourquoi nous avons un moyen très pratique de réduire le volume de code lorsque nous travaillons, par exemple, avec des sources shardées. Supposons que vous ayez trois shards MySQL en tant que source ; vous devez vous connecter à chacun d'eux et récupérer certaines données. De manière indépendante et en parallèle. Le code Python dans le DAG peut ressembler à ceci :
connection_list = lv.get('connection_list')

export_profiles_sql = '''
SELECT
  id,
  user_id,
  nickname,
  gender,
  {{params.shard_id}} as shard_id
FROM profiles
'''

for conn_id in connection_list:
    export_profiles = SqlToHiveViaHdfsTransfer(
        task_id='export_profiles_from_' + conn_id,
        sql=export_profiles_sql,
        hive_table='stg.profiles',
        overwrite=False,
        tmpdir='\/data\/tmp',
        conn_id=conn_id,
        params={'shard_id': conn_id[-1:], },
        compress=None,
        dag=dag
    )
    export_profiles.set_upstream(exec_truncate_stg)
    export_profiles.set_downstream(load_profiles)
Le DAG est ainsi constitué :
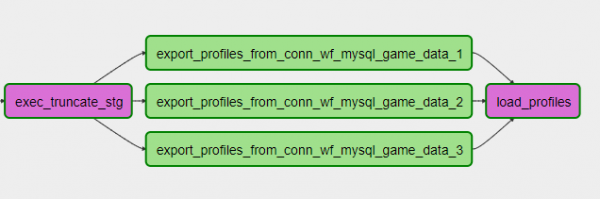
Vous pouvez ajouter ou supprimer un shard en ajustant simplement les paramètres et en mettant à jour le DAG. Pratique!
Il est possible d'utiliser une génération de code plus complexe, par exemple en travaillant avec des sources sous forme de bases de données ou en décrivant une structure tabulaire, un algorithme de traitement de tableau, et en générant un processus de chargement de N tables dans votre entrepôt en tenant compte des particularités de l'infrastructure DWH. Ou, par exemple, en travaillant avec une API qui ne prend pas en charge le traitement de paramètres sous forme de liste, vous pouvez générer N tâches dans le DAG à partir de cette liste, limiter la parallélisation des requêtes API avec un pool et extraire les données nécessaires de l'API. Flexible!
Dépôt
Airflow dispose de son propre référentiel backend, une base de données (qui peut être MySQL ou Postgres, chez nous c'est Postgres), où sont stockés l'état des tâches, les DAG, les configurations de connexions, les variables globales, etc. Il convient de mentionner que le référentiel d'Airflow est très simple (environ 20 tables) et pratique si vous souhaitez construire un processus propre. Cela me rappelle les 100 500 tables dans le référentiel Informatica, qu'il fallait longtemps étudier avant de comprendre comment formuler une requête.
Surveillance
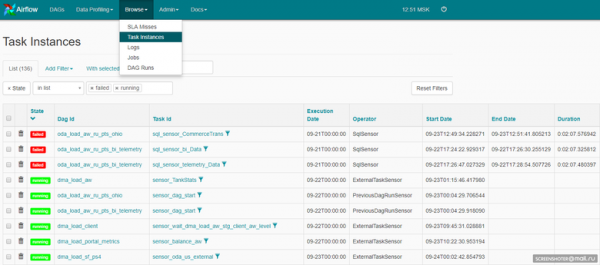
Étant donné la simplicité du référentiel, vous pouvez construire vous-même un processus de surveillance des tâches qui vous convient. Nous utilisons un carnet de notes dans Zeppelin, où nous vérifions l'état des tâches :
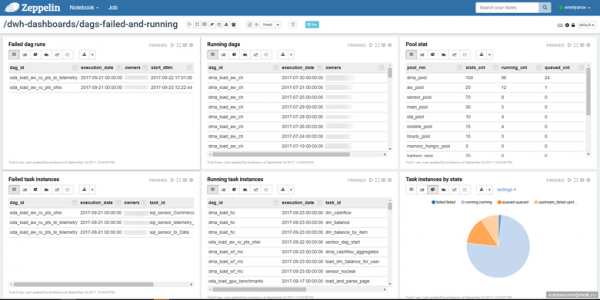
Cela peut également être l'interface web d'Airflow :
Le code d'Airflow est ouvert, donc nous avons ajouté des alertes dans Telegram. Chaque instance de tâche en cours, en cas d'erreur, envoie un message dans le groupe Telegram où se trouve toute l'équipe de développement et de support.
Nous recevons une réaction rapide via Telegram (si nécessaire), et une vue d'ensemble des tâches dans Airflow via Zeppelin.
Au total
Airflow est avant tout open source, et il ne faut pas s'attendre à des miracles. Soyez prêts à consacrer du temps et des efforts pour mettre en place une solution fonctionnelle. L'objectif est atteignable, croyez-moi, cela en vaut la peine. La rapidité de développement, la flexibilité, la simplicité d'ajout de nouveaux processus — cela vous plaira. Bien sûr, il est nécessaire de prêter beaucoup d'attention à l'organisation du projet et à la stabilité de fonctionnement d'Airflow : il n'y a pas de miracles.
Actuellement, nous avons Airflow qui exécute quotidiennement environ 6 500 tâches.. Leur nature est assez différente. Il y a des tâches de chargement de données vers l'entrepôt de données principal à partir de nombreuses sources variées et très spécifiques, des tâches de calcul de vitrines à l'intérieur de l'entrepôt de données principal, des tâches de publication de données dans un entrepôt de données rapide, et beaucoup, beaucoup d'autres tâches — et Airflow les gère jour après jour. Si l'on parle en chiffres, c'est 2,3 mille des tâches ELT de complexité variée à l'intérieur de l'entrepôt de données (Hadoop), environ 250 bases de données sources, c'est une équipe de quatre développeurs ETL, qui se répartissent entre le traitement ETL des données dans l'entrepôt de données et le traitement ELT des données à l'intérieur de l'entrepôt de données, et bien sûr encore un administrateur, qui s'occupe de l'infrastructure du service.
Plans pour l'avenir
Le nombre de processus ne peut que croître, et ce sur quoi nous allons nous concentrer en matière d'infrastructure Airflow, c'est l'échelle. Nous voulons construire un cluster Airflow, allouer quelques nœuds pour les workers Celery et créer une tête redondante avec des processus de planification de tâches et un référentiel.
Épilogue
Ce n'est bien sûr pas tout ce que j'aimerais partager sur Airflow, mais j'ai essayé de couvrir les points principaux. L'appétit vient en mangeant, essayez — et vous aimerez 🙂
Source : habr.com
