

En général, pour surveiller et analyser le fonctionnement de Nginx, on utilise des produits commerciaux ou des alternatives open-source prêtes à l'emploi, comme Prometheus + Grafana. C'est une bonne option pour la surveillance ou l'analyse en temps réel, mais pas très pratique pour l'analyse historique. Sur n'importe quelle ressource populaire, le volume de données provenant des logs Nginx augmente rapidement, et pour analyser un grand volume de données, il est logique d'utiliser quelque chose de plus spécialisé.
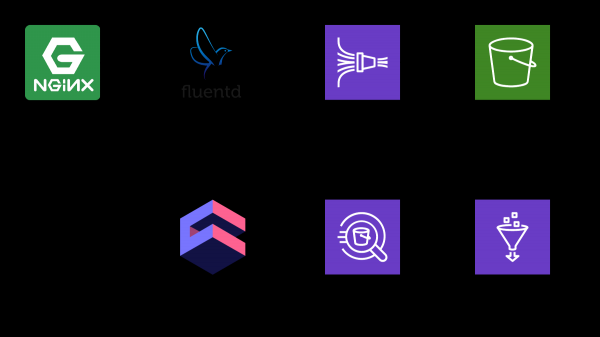
Dans cet article, je vais vous expliquer comment utiliser pour l'analyse des logs, en prenant l'exemple de Nginx, et je vais montrer comment rassembler un tableau de bord analytique à partir de ces données, en utilisant le cadre open-source cube.js. Voici l'architecture complète de la solution :
TL:DR;
.
Pour recueillir des informations, nous utilisons , pour le traitement — et , pour le stockage — . Avec cette combinaison, il est possible de stocker non seulement les logs Nginx, mais aussi d'autres événements, ainsi que les logs d'autres services. Vous pouvez remplacer certaines parties par des équivalents pour votre stack, par exemple, vous pouvez écrire les logs directement dans Kinesis depuis Nginx, en contournant Fluentd, ou utiliser Logstash à cet effet.
Collecte des logs Nginx
Par défaut, les logs Nginx ressemblent à ceci :
4/9/2019 12:58:17 PM1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-up HTTP/2.0" 200 9168 "https://example.com/sign-in" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
4/9/2019 12:58:17 PM1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-in HTTP/2.0" 200 9168 "https://example.com/sign-up" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
Ils peuvent être analysés, mais il est beaucoup plus simple de modifier la configuration de Nginx pour qu'il génère des logs au format JSON :
log_format json_combined escape=json '{ "created_at": "$msec", '
            '"remote_addr": "$remote_addr", '
            '"remote_user": "$remote_user", '
            '"request": "$request", '
            '"status": $status, '
            '"bytes_sent": $bytes_sent, '
            '"request_length": $request_length, '
            '"request_time": $request_time, '
            '"http_referrer": "$http_referer", '
            '"http_x_forwarded_for": "$http_x_forwarded_for", '
            '"http_user_agent": "$http_user_agent" }';

access_log  /var/log/nginx/access.log  json_combined;
S3 pour le stockage
Pour stocker les logs, nous allons utiliser S3. Cela permet de conserver et d'analyser les logs au même endroit, car Athena peut travailler directement avec les données dans S3. Plus loin dans cet article, je vais expliquer comment bien structurer et traiter les logs, mais pour commencer, nous avons besoin d'un bucket propre dans S3, où rien d'autre ne sera stocké. Il est judicieux de réfléchir à la région dans laquelle vous allez créer le bucket, car Athena n'est pas disponible dans toutes les régions.
Créons un schéma dans la console Athena
Nous allons créer une table dans Athena pour les journaux. Elle est nécessaire à la fois pour l'écriture et la lecture, si vous prévoyez d'utiliser Kinesis Firehose. Ouvrez la console Athena et créez la table :
SQL de création de table
CREATE EXTERNAL TABLE `kinesis_logs_nginx`(
  `created_at` double,
  `remote_addr` string,
  `remote_user` string,
  `request` string,
  `status` int,
  `bytes_sent` int,
  `request_length` int,
  `request_time` double,
  `http_referrer` string,
  `http_x_forwarded_for` string,
  `http_user_agent` string)
ROW FORMAT SERDE
  'org.apache.hadoop.hive.ql.io.orc.OrcSerde'
STORED AS INPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcInputFormat'
OUTPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcOutputFormat'
LOCATION
  's3://'
TBLPROPERTIES ('has_encrypted_data'='false');
Créons un flux Kinesis Firehose
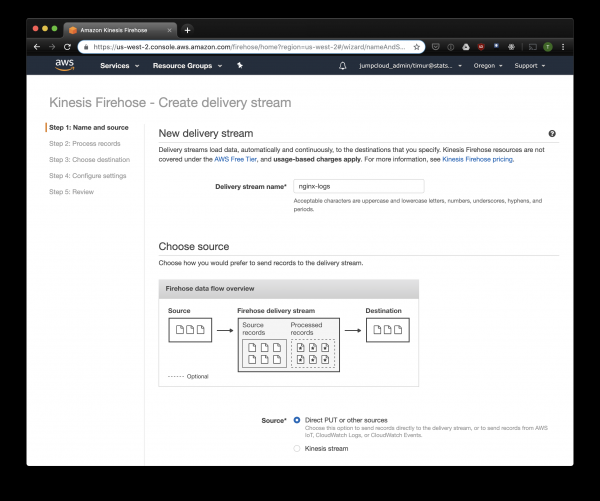
Kinesis Firehose enregistrera les données reçues d'Nginx dans S3 dans le format choisi, en les divisant par répertoires au format AAAA/MM/JJ/HH. Cela sera utile lors de la lecture des données. Il est bien sûr possible d'écrire directement dans S3 à partir de fluentd, mais dans ce cas, il faudra écrire en JSON, ce qui est inefficace en raison de la grande taille des fichiers. De plus, lors de l'utilisation de PrestoDB ou Athena, le JSON est le format de données le plus lent. Donc, ouvrons la console Kinesis Firehose, cliquons sur « Créer un flux de livraison », et choisissons « direct PUT » dans le champ « delivery » :
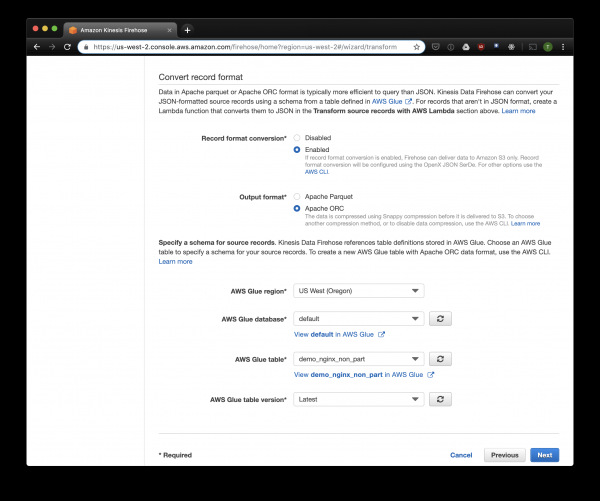
Dans l'onglet suivant, choisissons « Conversion de format d'enregistrement » — « Activé » et sélectionnons « Apache ORC » comme format d'enregistrement. Selon les recherches de certains , c'est le format optimal pour PrestoDB et Athena. Comme schéma, nous indiquerons la table que nous avons créée précédemment. Notez que l'emplacement S3 dans kinesis peut être défini comme n'importe quel emplacement, seule la structure est utilisée dans la table. Mais si vous spécifiez un autre emplacement S3, il ne sera pas possible de lire ces enregistrements à partir de cette table.
Choisissons S3 pour le stockage et le bucket que nous avons créé précédemment. Aws Glue Crawler, dont je parlerai un peu plus tard, ne peut pas travailler avec des préfixes dans le bucket S3, donc il est important de le laisser vide.
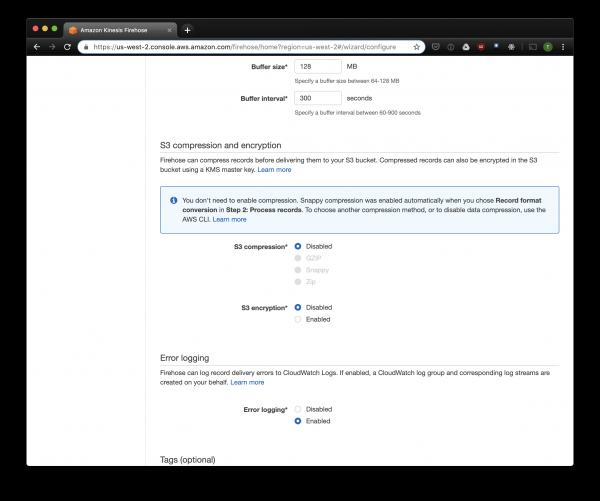
Les autres options peuvent être modifiées en fonction de votre charge, j'utilise généralement les paramètres par défaut. Notez que la compression S3 n'est pas disponible, mais ORC utilise sa propre compression par défaut.
Fluentd
Maintenant que nous avons configurer le stockage et la réception des journaux, nous devons configurer l'envoi. Nous allons utiliser , car j'aime Ruby, mais vous pouvez utiliser Logstash ou envoyer des journaux directement dans kinesis. Le serveur Fluentd peut être lancé de plusieurs manières, je vais parler de docker, car c'est simple et pratique.
Pour commencer, nous avons besoin d'un fichier de configuration fluent.conf. Créez-le et ajoutez source :
forward
port 24224
bind 0.0.0.0
Vous pouvez maintenant lancer le serveur Fluentd. Si vous avez besoin d'une configuration plus avancée, il existe un guide détaillé, y compris sur la façon de créer votre propre image.
$ docker run
  -d
  -p 24224:24224
  -p 24224:24224/udp
  -v /data:/fluentd/log
  -v : /fluentd/etc fluentd
  -c /fluentd/etc/fluent.conf
  fluent/fluentd:stable
Cette configuration utilise le chemin /fluentd/log pour la mise en cache des logs avant leur envoi. Vous pouvez vous en passer, mais alors, lors du redémarrage, vous risquez de perdre tout ce qui a été mis en cache avec peine. Vous pouvez également utiliser n'importe quel port, 24224 est le port par défaut pour Fluentd.
Maintenant que nous avons Fluentd en cours d'exécution, nous pouvons y envoyer les logs de Nginx. Nous exécutons généralement Nginx dans un conteneur Docker, et dans ce cas, Docker dispose d'un pilote de logs natif pour Fluentd :
$ docker run
--log-driver=fluentd
--log-opt fluentd-address=
--log-opt tag="{{.Name}}"
-v /some/content:/usr/share/nginx/html:ro
-d
nginx
Si vous exécutez Nginx différemment, vous pouvez utiliser les fichiers de logs, dans Fluentd, il y a .
Ajoutons à la configuration Fluent un parsing des logs, configuré ci-dessus :
@type parser
  key_name log
  emit_invalid_record_to_error false

    @type json
Et l'envoi des logs vers Kinesis, en utilisant :
@type kinesis_firehose
    region region
    delivery_stream_name
    aws_key_id
    aws_sec_key
Athena
Si vous avez tout bien configuré, après un certain temps (par défaut, Kinesis enregistre les données reçues toutes les 10 minutes), vous devriez voir les fichiers de logs dans S3. Dans le menu « monitoring » de Kinesis Firehose, vous pouvez voir combien de données ont été enregistrées dans S3, ainsi que les erreurs. N'oubliez pas de donner accès en écriture au bucket S3 pour le rôle Kinesis. Si Kinesis ne parvient pas à parser quelque chose, il enregistrera les erreurs dans le même bucket.
Vous pouvez maintenant consulter les données dans Athena. Trouvons les requêtes récentes pour lesquelles nous avons reçu des erreurs :
SELECT * FROM "db_name"."table_name" WHERE status > 499 ORDER BY created_at DESC limit 10;Le scan de tous les enregistrements pour chaque requête
Maintenant que nos logs ont été traités et stockés dans S3 en ORC, compressés et prêts à être analysés. Kinesis Firehose les a même rangés dans des répertoires par heure. Cependant, tant que la table n'est pas partitionnée, Athena va charger les données pour toute la durée à chaque requête, sauf quelques exceptions. Cela pose un grand problème pour deux raisons :
- Le volume des données augmente constamment, ralentissant les requêtes ;
- Le coût d'Athena est déterminé par le volume de données scannées, avec un minimum de 10 Mo pour chaque requête.
Pour corriger cela, nous utilisons AWS Glue Crawler, qui va scanner les données dans S3 et enregistrer les informations sur les partitions dans Glue Metastore. Cela nous permettra d'utiliser les partitions comme filtre lors des requêtes dans Athena, et elle ne scannera que les répertoires spécifiés dans la requête.
Configurer Amazon Glue Crawler
Amazon Glue Crawler scanne toutes les données dans le bucket S3 et crée des tables avec des partitions. Créez un Glue Crawler à partir de la console AWS Glue et ajoutez le bucket où vous stockez les données. Vous pouvez utiliser un seul crawler pour plusieurs buckets, auquel cas il créera des tables dans la base de données spécifiée avec des noms correspondant à ceux des buckets. Si vous prévoyez d'utiliser ces données de manière régulière, n'oubliez pas de configurer un calendrier pour le lancement du Crawler en fonction de vos besoins. Nous utilisons un seul Crawler pour toutes les tables, qui se lance toutes les heures.
Tables partitionnées
Après le premier lancement du crawler dans la base de données spécifiée dans les paramètres, des tables doivent apparaître pour chaque bucket scanné. Ouvrez la console Athena et cherchez la table avec les logs Nginx. Essayons de lire quelque chose :
SELECT * FROM "default"."part_demo_kinesis_bucket"
WHERE(
  partition_0 = '2019' AND
  partition_1 = '04' AND
  partition_2 = '08' AND
  partition_3 = '06'
  );
Cette requête va sélectionner tous les enregistrements obtenus entre 6 et 7 heures du matin le 8 avril 2019. Mais à quel point est-ce plus efficace que de simplement lire à partir d'une table non partitionnée ? Découvrons cela en sélectionnant les mêmes enregistrements, filtrés par timestamp :
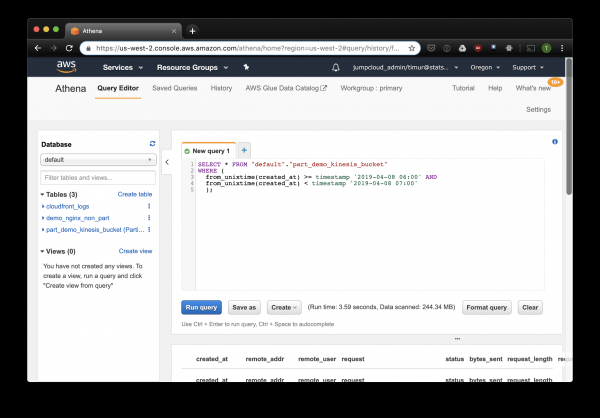
3,59 secondes et 244,34 mégaoctets de données sur un jeu de données contenant une semaine de logs. Essayons le filtre par partitions :
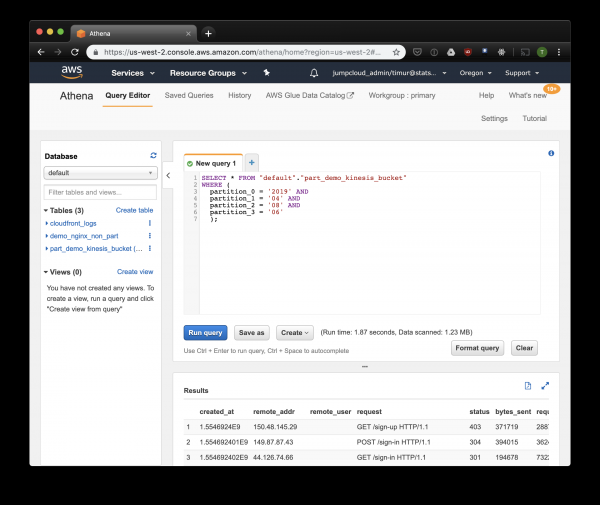
Un peu plus rapide, mais le plus important est que cela ne représente que 1,23 mégaoctets de données ! Ce serait beaucoup moins cher si ce n'était pour le minimum de 10 mégaoctets par requête dans la tarification. Mais c'est tout de même bien meilleur, et sur de grands ensembles de données, la différence serait beaucoup plus impressionnante.
Собираем дэшборд с помощью Cube.js
Pour créer un tableau de bord, nous utilisons le framework d'analyse Cube.js. Il a pas mal de fonctions, mais nous sommes intéressés par deux : la possibilité d'utiliser automatiquement des filtres par partitions et la pré-agrégation des données. Il utilise un schéma de données , écrit en Javascript, pour générer du SQL et exécuter la requête sur la base de données. Il ne nous reste plus qu'à indiquer comment utiliser le filtre par partitions dans le schéma de données.
Créons une nouvelle application Cube.js. Comme nous utilisons déjà la pile AWS, il est logique d'utiliser Lambda pour le déploiement. Vous pouvez utiliser le modèle express pour générer, si vous prévoyez d'héberger le backend Cube.js sur Heroku ou Docker. D'autres méthodes d'hébergement sont décrites dans la documentation. .
$ npm install -g cubejs-cli
$ cubejs create nginx-log-analytics -t serverless -d athena
Pour configurer l'accès à la base de données dans cube.js, des variables d'environnement sont utilisées. Le générateur créera un fichier .env, où vous pourrez spécifier vos clés pour .
Nous aurons maintenant besoin de , dans lequel nous indiquerons comment nos logs sont stockés. Vous pouvez également spécifier comment calculer les métriques pour les tableaux de bord.
Dans le répertoire schéma, créez un fichier Logs.js. Voici un exemple de modèle de données pour nginx :
Code du modèle
const partitionFilter = (from, to) => `
    date(from_iso8601_timestamp(${from})) = date_parse(partition_0 || partition_1 || partition_2, '%Y%m%d')
    `

cube(`Logs`, {
  sql: `
  select * from part_demo_kinesis_bucket
  WHERE ${FILTER_PARAMS.Logs.createdAt.filter(partitionFilter)}
  `,

  measures: {
    count: {
      type: `count`,
    },

    errorCount: {
      type: `count`,
      filters: [
        { sql: `${CUBE.isError} = 'Yes'` }
      ]
    },

    errorRate: {
      type: `number`,
      sql: `100.0 * ${errorCount} / ${count}`,
      format: `percent`
    }
  },

  dimensions: {
    status: {
      sql: `status`,
      type: `number`
    },

    isError: {
      type: `string`,
      case: {
        when: [{
          sql: `${CUBE}.status >= 400`, label: `Yes`
        }],
        else: { label: `No` }
      }
    },

    createdAt: {
      sql: `from_unixtime(created_at)`,
      type: `time`
    }
  }
});
Ici, nous utilisons la variable , pour générer une requête SQL avec un filtre sur les partitions.
Nous définissons également les métriques et les paramètres que nous souhaitons afficher sur le tableau de bord, et nous spécifions les pré-agrégations. Cube.js créera des tables supplémentaires avec des données pré-agrégées et mettra à jour automatiquement les données à mesure qu'elles arrivent. Cela permet non seulement d'accélérer les requêtes, mais aussi de réduire le coût d'utilisation d'Athena.
Ajoutons cette information dans le fichier de schéma de données :
preAggregations: {
  main: {
    type: `rollup`,
    measureReferences: [count, errorCount],
    dimensionReferences: [isError, status],
    timeDimensionReference: createdAt,
    granularity: `day`,
    partitionGranularity: `month`,
    refreshKey: {
      sql: FILTER_PARAMS.Logs.createdAt.filter((from, to) =>
        `select
           CASE WHEN from_iso8601_timestamp(${to}) + interval '3' day > now()
           THEN date_trunc('hour', now()) END`
      )
    }
  }
}
Nous indiquons dans ce modèle qu'il est nécessaire de pré-agréger les données pour toutes les métriques utilisées, et d'utiliser le partitionnement par mois. peut accélérer considérablement la collecte et la mise à jour des données.
Nous pouvons maintenant créer le tableau de bord !
Le backend de Cube.js fournit et un ensemble de bibliothèques clientes pour des frameworks frontend populaires. Nous utiliserons la version React du client pour construire le tableau de bord. Cube.js fournit uniquement des données, donc nous aurons besoin d'une bibliothèque pour les visualisations — j'aime , mais vous pouvez en utiliser n'importe quelle autre.
Le serveur Cube.js accepte les requêtes au format , dans lequel sont spécifiées les métriques nécessaires. Par exemple, pour compter le nombre d'erreurs renvoyées par Nginx par jour, il faut envoyer la requête suivante :
{
  "measures": ["Logs.errorCount"],
  "timeDimensions": [
    {
      "dimension": "Logs.createdAt",
      "dateRange": ["2019-01-01", "2019-01-07"],
      "granularity": "day"
    }
  ]
}
Installons le client Cube.js et la bibliothèque des composants React via NPM :
$ npm i --save @cubejs-client/core @cubejs-client/reactImportons les composants cubejs et QueryRenderer, afin d'extraire les données, et construisons le tableau de bord :
Le code du tableau de bord
import React from 'react';
import { LineChart, Line, XAxis, YAxis } from 'recharts';
import cubejs from '@cubejs-client/core';
import { QueryRenderer } from '@cubejs-client/react';

const cubejsApi = cubejs(
  'YOUR-CUBEJS-API-TOKEN',
  { apiUrl: 'http://localhost:4000/cubejs-api/v1' },
);

export default () => {
  return (
     {
        if (!resultSet) {
          return 'Chargement...';
        }

        return (


        );
      }}
    />
  )
}
Les sources du tableau de bord sont disponibles sur .
Source : habr.com
