

La base de données de séries chronologiques (TSDB, time series database) dans Prometheus 2 est un excellent exemple de solution d'ingénierie qui offre des améliorations significatives par rapport au stockage v2 de Prometheus 1 en termes de vitesse d'accumulation des données et d'exécution des requêtes, ainsi que d'efficacité des ressources. Nous avons intégré Prometheus 2 dans Percona Monitoring and Management (PMM), et j'ai eu l'occasion d'examiner la performance de la TSDB de Prometheus 2. Dans cet article, je vais partager les résultats de ces observations.
Charge de travail moyenne de Prometheus
Pour ceux qui ont l'habitude de travailler avec des bases de données à usages généraux, la charge de travail typique de Prometheus est plutôt curieuse. La vitesse d'accumulation des données tend vers une valeur stable : généralement, les services que vous surveillez envoient un nombre similaire de métriques, et l'infrastructure change relativement lentement.
Les requêtes d'information peuvent provenir de différentes sources. Certaines d'entre elles, comme les alertes, tendent également vers une valeur stable et prévisible. D'autres, comme les requêtes utilisateur, peuvent provoquer des pics, bien que cela ne soit pas caractéristique de la majeure partie de la charge.
Test de charge
Lors des tests, je me suis concentré sur la capacité d'accumulation des données. J'ai déployé Prometheus 2.3.2, compilé avec Go 1.10.1 (dans le cadre de PMM 1.14) sur le service Linode, en utilisant ce script : . Pour générer une charge aussi réaliste que possible, grâce à ce , j'ai lancé plusieurs nœuds MySQL avec une charge réelle (test Sysbench TPC-C), chacun émulant 10 nœuds Linux/MySQL.
Tous les tests ci-dessous ont été effectués sur un serveur Linode avec huit cœurs virtuels et 32 Go de RAM, où 20 simulations de charge surveillant deux cents instances MySQL étaient en cours d'exécution. Ou, en termes de Prometheus, 800 cibles (targets), 440 collectes (scrapes) par seconde, 380 000 enregistrements (samples) par seconde et 1,7 million de séries chronologiques actives.
Design
L'approche standard des bases de données traditionnelles, y compris celle utilisée par Prometheus 1.x, consiste en un . Si elle est insuffisante pour supporter la charge, vous rencontrerez de grandes latences, et certaines requêtes ne seront pas exécutées. L'utilisation de la mémoire dans Prometheus 2 est configurée via la clé storage.tsdb.min-block-duration, qui détermine combien de temps les enregistrements seront conservés en mémoire avant d'être écrasés sur le disque (par défaut, cela dure 2 heures). La quantité de mémoire requise dépendra du nombre de séries temporelles, d'étiquettes (labels) et de l'intensité de la collecte des données (scrapes) en plus du flux entrant brut. En ce qui concerne l'espace disque, Prometheus vise à utiliser 3 octets par enregistrement (sample). D'un autre côté, les exigences en matière de mémoire sont bien plus élevées.
Bien que la possibilité de configurer la taille de bloc existe, il n'est pas recommandé de le faire manuellement, vous vous retrouvez donc face à la nécessité de donner à Prometheus autant de mémoire qu'il en demande pour votre charge.
Si la mémoire disponible n'est pas suffisante pour maintenir le flux entrant de métriques, Prometheus rencontrera une panne due à un manque de mémoire ou sera tué par le OOM killer.
Ajouter un swap pour retarder le moment de l'échec lorsque Prometheus manque de mémoire n'aide pas vraiment, car l'utilisation de cette fonctionnalité entraîne une consommation de mémoire explosive. Je pense que cela est dû à Go, à son ramasse-miettes et à la façon dont il fonctionne avec le swap.
Une autre approche intéressante consiste à configurer le vidage du head block sur le disque à des moments précis, plutôt que de le chronométrer à partir du démarrage du processus.
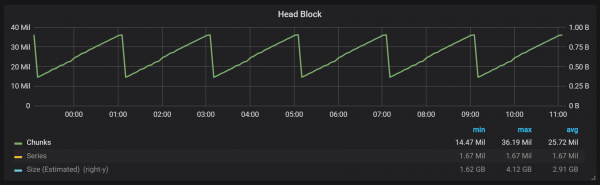
Comme vous pouvez le voir sur le graphique, les vidages sur le disque se produisent toutes les deux heures. Si vous modifiez le paramètre min-block-duration à une heure, ces vidages se produiront chaque heure, à commencer d'ici trente minutes.
Si vous souhaitez utiliser ce graphique et d'autres dans votre installation de Prometheus, vous pouvez utiliser ce . Il a été conçu pour PMM, mais avec quelques modifications, il convient à toute installation de Prometheus.
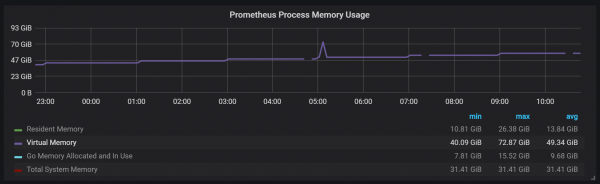
Nous avons un bloc actif, appelé head block, qui est conservé en mémoire ; les blocs contenant des données plus anciennes sont accessibles via mmap(). Cela élimine le besoin de configurer le cache séparément, mais cela signifie également que vous devez laisser suffisamment d'espace pour le cache du système d'exploitation si vous souhaitez interroger des données plus anciennes que celles contenues dans le head block.
Et cela signifie aussi que la consommation de mémoire virtuelle de Prometheus semblera assez élevée, mais il n'y a pas lieu de s'en inquiéter.
Un autre aspect intéressant du design est l'utilisation de WAL (write ahead log). Comme indiqué dans la documentation du stockage, Prometheus utilise WAL pour éviter des pertes en cas de plantages. Malheureusement, les mécanismes spécifiques garantissant la durabilité des données ne sont pas suffisamment documentés. La version 2.3.2 de Prometheus écrit le WAL sur le disque toutes les 10 secondes, et ce paramètre n'est pas configurable par l'utilisateur.
Compactions
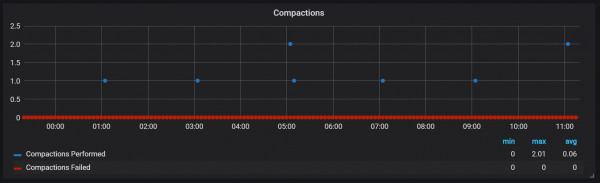
La TSDB de Prometheus est conçue à l'image d'un stockage LSM (Log Structured Merge - arbre structuré en journaux avec fusion) : le bloc principal est périodiquement écrit sur le disque, tandis que le mécanisme de compaction fusionne plusieurs blocs pour éviter de scanner trop de blocs lors des requêtes. Voici le nombre de blocs que j'ai observé sur le système de test après 24 heures de charge.
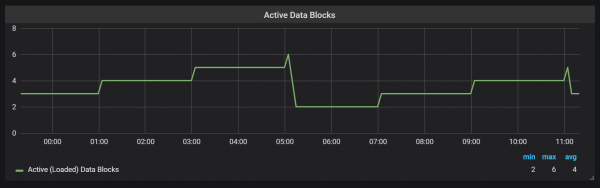
Si vous souhaitez en savoir plus sur le stockage, vous pouvez examiner le fichier meta.json, qui contient des informations sur les blocs existants et sur leur provenance.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
Les compactions dans Prometheus sont liées au temps d'écriture du bloc principal sur le disque. À ce moment-là, plusieurs de ces opérations peuvent être effectuées.
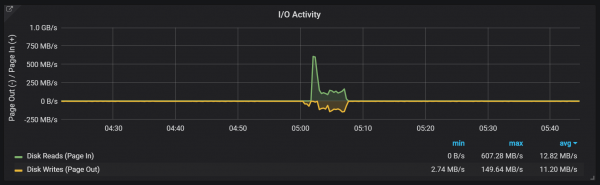
Apparemment, le compactage n'est pas du tout limité et peut entraîner de grandes fluctuations de l'I/O disque pendant l'exécution.
Fluctuations de charge CPU
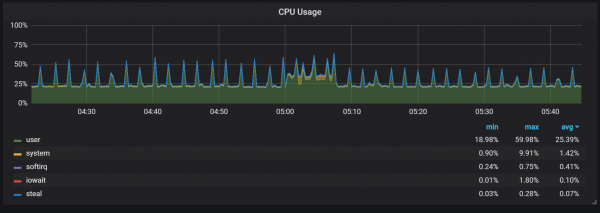
Cela a bien sûr un impact assez négatif sur la vitesse du système et représente un défi sérieux pour les stockages LSM : comment effectuer des compactages pour maintenir une vitesse de requête élevée sans générer trop de surcharge ?
L'utilisation de la mémoire pendant les compactages semble également assez intéressante.
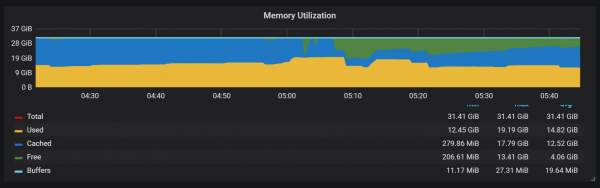
Nous pouvons voir qu'après le compactage, la plupart de la mémoire passe de l'état Cached à Free : cela signifie que des informations potentiellement précieuses ont été retirées de là. Il est intéressant de savoir si cela utilise fadvice() ou une autre technique de minimisation, ou si cela est dû au fait que le cache a été libéré des blocs détruits lors du compactage ?
Récupération après sinistre
La récupération après sinistre prend du temps, et cela se justifie. Pour un flux entrant d'un million d'enregistrements par seconde, j'ai dû attendre environ 25 minutes pour que la récupération soit effectuée, même avec un disque SSD.
niveau=info ts=2018-09-13T13:38:14.09650965Z appelant=main.go:222 msg="Démarrage de Prometheus" version="(version=2.3.2, branche=v2.3.2, révision=71af5e29e815795e9dd14742ee7725682fa14b7b)"
niveau=info ts=2018-09-13T13:38:14.096599879Z appelant=main.go:223 build_context="(go=go1.10.1, utilisateur=Jenkins, date=20180725-08:58:13OURCE)"
niveau=info ts=2018-09-13T13:38:14.096624109Z appelant=main.go:224 host_details="(Linux 4.15.0-32-generic #35-Ubuntu SMP Ven Aoû 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (aucun))"
niveau=info ts=2018-09-13T13:38:14.096641396Z appelant=main.go:225 fd_limits="(soft=1048576, hard=1048576)"
niveau=info ts=2018-09-13T13:38:14.097715256Z appelant=web.go:415 composant=web msg="Début de l'écoute des connexions" adresse=:9090
niveau=info ts=2018-09-13T13:38:14.097400393Z appelant=main.go:533 msg="Démarrage de TSDB ..."
niveau=info ts=2018-09-13T13:38:14.098718401Z appelant=repair.go:39 composant=tsdb msg="bloc sain trouvé" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R
niveau=info ts=2018-09-13T13:38:14.100315658Z appelant=web.go:467 composant=web msg="préfixe du routeur" préfixe=\/prometheus
niveau=info ts=2018-09-13T13:38:14.101793727Z appelant=repair.go:39 composant=tsdb msg="bloc sain trouvé" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM
niveau=info ts=2018-09-13T13:38:14.102267346Z appelant=repair.go:39 composant=tsdb msg="bloc sain trouvé" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0
niveau=info ts=2018-09-13T13:38:14.102660295Z appelant=repair.go:39 composant=tsdb msg="bloc sain trouvé" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q
niveau=info ts=2018-09-13T13:38:14.103075885Z appelant=repair.go:39 composant=tsdb msg="bloc sain trouvé" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB
niveau=erreur ts=2018-09-13T14:05:18.208469169Z appelant=wal.go:275 composant=tsdb msg="Corruption de WAL détectée ; troncature" err="checksum CRC32 inattendu d0465484, voulu 0" fichier=\/opt\/prometheus\/data\/ .prom2-data\/wal\/007357 pos=15504363
niveau=info ts=2018-09-13T14:05:19.471459777Z appelant=main.go:543 msg="TSDB démarré"
niveau=info ts=2018-09-13T14:05:19.471604598Z appelant=main.go:603 msg="Chargement du fichier de configuration" filename=\/etc\/prometheus.yml
niveau=info ts=2018-09-13T14:05:19.499156711Z appelant=main.go:629 msg="Chargement complet du fichier de configuration" filename=\/etc\/prometheus.yml
niveau=info ts=2018-09-13T14:05:19.499228186Z appelant=main.go:502 msg="Le serveur est prêt à recevoir des requêtes web."
Le principal problème du processus de récupération est la forte consommation de mémoire. Bien que dans une situation normale, le serveur puisse fonctionner de manière stable avec la même quantité de mémoire, lors d'un crash, il peut ne pas redémarrer en raison de l'OOM. La seule solution que j'ai trouvée est de désactiver la collecte de données, de relancer le serveur, de lui permettre de se rétablir et de le redémarrer avec la collecte activée.
Chauffage
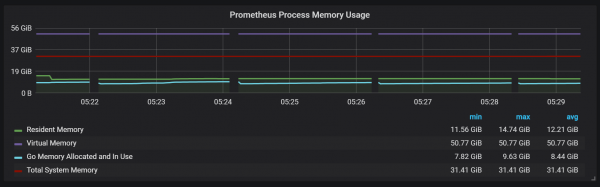
Un autre comportement à garder à l'esprit pendant le chauffage est le rapport entre une faible performance et une forte consommation de ressources juste après le démarrage. Lors de certains démarrages, mais pas tous, j'ai observé une charge CPU et mémoire significative.
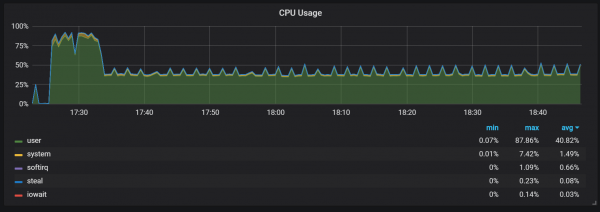
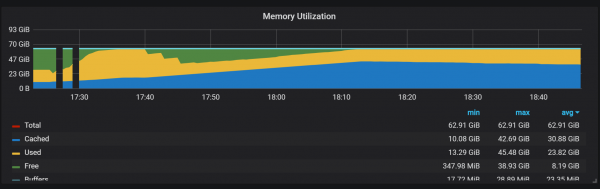
Des chutes dans l'utilisation de la mémoire indiquent que Prometheus ne peut pas configurer toutes les collectes dès le départ et certaines informations sont perdues.
Je n'ai pas déterminé les raisons exactes de la charge élevée sur le processeur et la mémoire. Je soupçonne que cela soit lié à la création de nouvelles séries temporelles dans le bloc principal à une fréquence élevée.
Sauts de charge sur le CPU
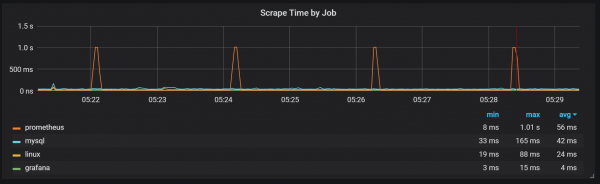
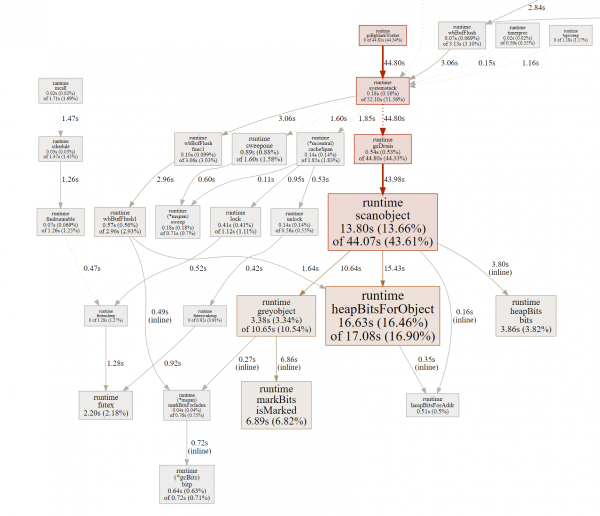
En plus des compressions qui génèrent une charge I/O relativement élevée, j'ai remarqué des pics de charge sur le processeur toutes les deux minutes. Les pics durent plus longtemps avec un flux entrant élevé et il semble qu'ils soient causés par le ramasse-miettes Go, au moins certains cœurs sont complètement chargés.
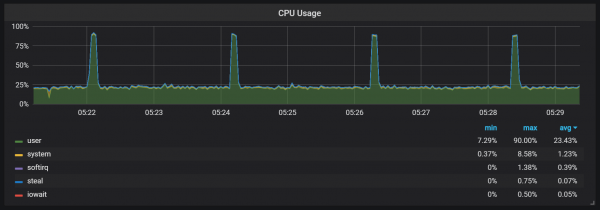
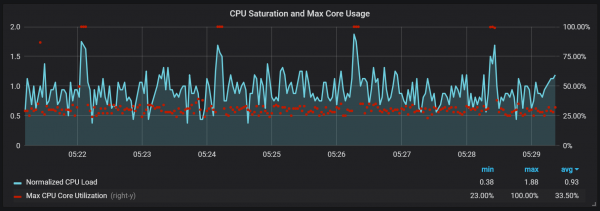
Ces sauts ne sont pas si insignifiants. Il semble que lorsqu'ils surviennent, le point d'entrée interne et les métriques Prometheus deviennent indisponibles, ce qui entraîne des pertes de données durant ces mêmes intervalles.
On peut également noter que l'exportateur Prometheus se fige pendant une seconde.
Nous pouvons observer des corrélations avec le ramassage de déchets (GC).
Conclusion
La TSDB dans Prometheus 2 fonctionne rapidement, capable de gérer des millions de séries temporelles tout en traitant des milliers d'écritures par seconde, le tout avec un matériel assez modeste. L'utilisation du CPU et de l'I/O disque est également impressionnante. Mon exemple a montré jusqu'à 200 000 métriques par seconde sur un seul cœur utilisé.
Pour planifier une extension, il faut garder à l'esprit des volumes de mémoire suffisants, et cela doit être de la mémoire réelle. Le volume de mémoire utilisée que j'ai observé était d'environ 5 Go pour 100 000 écritures par seconde de flux entrant, ce qui totalisait environ 8 Go de mémoire occupée avec le cache du système d'exploitation.
Évidemment, un travail conséquent reste à faire pour maîtriser les pics de CPU et d'I/O disque, et cela n'est pas surprenant, étant donné à quel point la TSDB Prometheus 2 est encore jeune par rapport à InnoDB, TokuDB, RocksDB, WiredTiger, mais ils ont tous rencontré des problèmes similaires au début de leur cycle de vie.
Source : habr.com
