

Bonjour, je suis Dmitri Logvinenko, Data Engineer au sein du département d'analyse du groupe «Vezet».
Je vais vous parler d'un outil remarquable pour le développement de processus ETL : Apache Airflow. Mais Airflow est si polyvalent et riche en fonctionnalités qu'il vaut la peine de s'y intéresser même si vous ne travaillez pas avec des flux de données, mais avez besoin de lancer périodiquement certains processus et de suivre leur exécution.
Et oui, je vais non seulement vous expliquer, mais aussi vous montrer : le programme contient beaucoup de code, de captures d'écran et de recommandations.
Que voit-on habituellement lorsque l'on recherche le mot Airflow / Wikimedia Commons
Table des matières
Introduction
Apache Airflow — c'est un peu comme Django :
- écrit en Python,
- il offre une excellente interface admin,
- il est extensible à l'infini,
— juste mieux, et conçu pour des objectifs complètement différents, à savoir (comme écrit jusqu'ici) :
- l'exécution et la surveillance de tâches sur un nombre illimité de machines (autant que Celery/Kubernetes et votre conscience le permettent)
- avec une génération dynamique de workflow à partir d'un code Python très simple à écrire et à comprendre
- et la possibilité de relier n'importe quelles bases de données et API, à l'aide à la fois de composants prêts à l'emploi et de plugins faits maison (ce qui est extrêmement simple à réaliser).
Nous utilisons Apache Airflow de la manière suivante :
- nous collectons des données provenant de différentes sources (de nombreux instances SQL Server et PostgreSQL, diverses API avec les métriques des applications, même 1C) dans DWH et ODS (nous utilisons Vertica et Clickhouse).
- comme un système avancé
cron, qui lance des processus de consolidation des données dans ODS, tout en surveillant leur maintenance.
Jusqu'à récemment, nos besoins étaient couverts par un petit serveur de 32 cœurs et 50 Go de RAM. Dans Airflow, il fonctionne avec :
- plus de 200 DAGs (en fait des workflows dans lesquels nous avons inclus des tâches),
- avec en moyenne 70 tâches,
- ceci s'exécutant (également en moyenne) une fois par heure.
Et je vais parler de notre expansion ci-dessous, mais pour l'instant, définissons la tâche über que nous allons résoudre :
Il existe trois SQL Servers d'origine, chacun avec 50 bases de données — des instances d'un même projet, donc leur structure est presque identique (partout, muahaha), ce qui signifie qu'il y a une table Orders dans chacune (heureusement, une table avec ce nom peut être intégrée dans n'importe quel secteur d'activité). Nous récupérons les données en ajoutant des champs de métadonnées (serveur source, base source, identifiant de la tâche ETL) et naïvement, nous allons les jeter dans, disons, Vertica.
Allons-y !
Partie principale, pratique (et un peu théorique)
Pourquoi est-ce intéressant pour nous (et pour vous)
Quand les arbres étaient grands et que j'étais simple SQL-moulins dans un grand détaillant russe, nous pilotions les processus ETL aka les flux de données à l'aide de deux outils que nous avions à disposition :
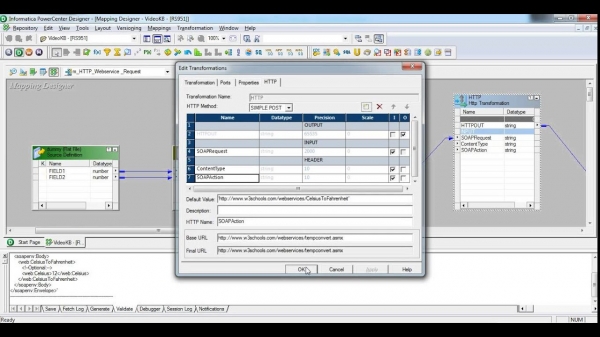
- Informatica Power Center — un système extrêmement complexe et très performant, avec son propre matériel et son propre système de versioning. Je n'ai utilisé même pas 1% de ses capacités. Pourquoi ? Eh bien, d'une part, cette interface vient d'un autre temps et nous pesait psychologiquement. D'autre part, cette machine est conçue pour des processus extrêmement sophistiqués, une réutilisation féroce des composants et d'autres fonctionnalités très importantes pour les entreprises. En ce qui concerne son coût, comparable à celui d'une aile d'Airbus A380 par an, nous allons rester silencieux.
Attention, une capture d'écran peut blesser un peu les personnes de moins de 30 ans

- SQL Server Integration Server — nous avons utilisé ce camarade dans nos flux internes de projet. En réalité : nous utilisons déjà SQL Server, et il serait un peu irrationnel de ne pas utiliser ses outils ETL. Tout dans celui-ci est agréable : l'interface est belle, et les rapports d'exécution... Mais ce n'est pas pour cela que nous aimons les produits logiciels, oh non. Nous pouvons versionner ses
dtsx(qui est un XML avec des nœuds mélangés lors de la sauvegarde), mais à quoi bon ? Et créer un paquet de tâches qui transférera une centaine de tables d'un serveur à un autre ? Pff, qu'une centaine, après une vingtaine de clics, votre index va flancher sur le bouton de la souris. Mais il a, sans aucun doute, un look plus à la mode :
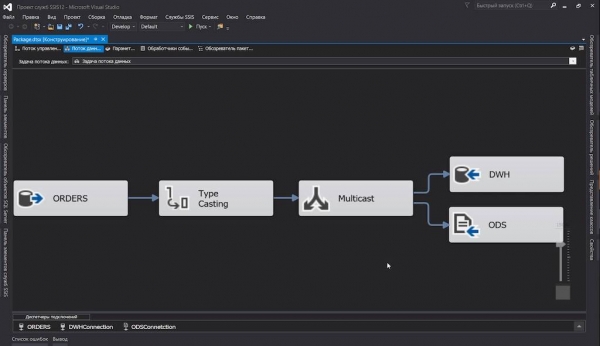
Nous cherchions sans cesse des solutions. Le fait est que presque nous en sommes arrivés à un générateur de paquets SSIS fait maison...
... puis un nouvel emploi m'a trouvé. Et dans ce nouvel emploi, Apache Airflow m'a rattrapé.
Quand j'ai appris que la description des processus ETL était simplement du code Python, je ne pouvais presque pas contenir ma joie. Ainsi, les flux de données ont été soumis à la version et à la différenciation, et rassembler des tables avec une structure unique à partir de centaines de bases de données en une seule cible est devenu une question de quelques lignes de code Python sur un écran de 13 pouces.
Assembler un cluster
Évitons de faire un véritable jardin d'enfants et parlons ici de choses totalement évidentes, comme l'installation d'Airflow, la base de données que vous avez choisie, Celery et d'autres aspects décrits dans la documentation.
Afin que nous puissions commencer immédiatement les expérimentations, j'ai esquissé docker-compose.yml where:
- Levant notre propre Airflow: Scheduler, Webserver. Flower sera également utilisé pour surveiller les tâches Celery (car il a déjà été intégré dans
apache/airflow:1.10.10-python3.7, et nous n'y voyons pas d'inconvénient); - PostgreSQL, où Airflow écrira ses informations de service (données du planificateur, statistiques d'exécution, etc.), et Celery - marquera les tâches terminées;
- Redis, qui agira comme un courtier de tâches pour Celery;
- Celery worker, qui s'occupera de l'exécution des tâches.
- Dans le dossier
. /dagsnous allons placer nos fichiers décrivant les dags. Ils seront récupérés à la volée, donc il n'est pas nécessaire de redémarrer toute la pile après chaque petit changement.
Dans certains endroits, le code dans les exemples n'est pas complètement présenté (pour ne pas alourdir le texte), et ailleurs, il est modifié en cours de route. Des exemples de code complets et fonctionnels peuvent être consultés dans le dépôt. .
docker-compose.yml
version: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: /dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2://airflow:airflow@airflow-db:5432/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis://broker:6379/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql://airflow:airflow@airflow-db/airflow

x-airflow-base: &airflow-base
  image: apache/airflow:1.10.10-python3.7
  entrypoint: /bin/bash
  restart: always
  volumes:
    - ./dags:/dags
    - ./requirements.txt:/requirements.txt

services:
  # Redis comme broker Celery
  broker:
    image: redis:6.0.5-alpine

  # Base de données pour les métadonnées Airflow
  airflow-db:
    image: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - ./db:/var/lib/postgresql/data

  # Conteneur principal avec Airflow Webserver, Scheduler, Celery Flower
  airflow:
    <<: *airflow-base

    environment:
      <<: *airflow-config

      AIRFLOW__SCHEDULER__DAG_DIR_LIST_INTERVAL: 30
      AIRFLOW__SCHEDULER__CATCHUP_BY_DEFAULT: 'False'
      AIRFLOW__SCHEDULER__MAX_THREADS: 8

      AIRFLOW__WEBSERVER__LOG_FETCH_TIMEOUT_SEC: 10

    depends_on:
      - airflow-db
      - broker

    command: >
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint initdb &&
          (/entrypoint webserver &) &&
          (/entrypoint flower &) &&
           /entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Airflow Webserver
      - 8080:8080

  # Celery worker, sera redimensionné en utilisant `--scale=n`
  worker:
    <<: *airflow-base

    environment:
      <<: *airflow-config

    command: >
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Remarques :
- Dans la construction du compose, je me suis largement basé sur l'image bien connue – à ne pas manquer. Peut-être que vous n'aurez besoin de rien d'autre dans votre vie.
- Tous les paramètres d'Airflow sont accessibles non seulement par
airflow.cfg, mais aussi par des variables d'environnement (merci aux développeurs), ce dont j'ai profité avec malice. - Bien sûr, ce n'est pas prêt pour la production : je n'ai pas déployé de heartbeats sur les conteneurs et je n'ai pas pris en compte la sécurité. Mais j'ai créé un minimum adapté pour nos expérimentations.
- Notez que :
- Le dossier contenant les DAG doit être accessible à la fois par le planificateur et par les travailleurs.
- Il en va de même pour toutes les bibliothèques tierces — elles doivent toutes être installées sur les machines avec le planificateur et les travailleurs.
Eh bien, maintenant c'est simple :
$ docker-compose up --scale worker=3Après que tout s'est mis en route, vous pouvez consulter les interfaces web :
- Airflow :
- Flower :
Concepts de base
Si vous n'avez rien compris à tous ces « DAGs », voici un petit glossaire :
- Scheduler — le gros bonhomme d'Airflow, qui veille à ce que ce soient des robots qui bossent, pas des humains : il surveille le planning, met à jour les DAGs, lance les tâches.
En fait, dans les anciennes versions, il avait des problèmes de mémoire (non, pas d'amnésie, mais des fuites) et il restait même un paramètre legacy dans les configs
run_duration— l'intervalle de son redémarrage. Mais maintenant, tout va bien. - DAG (également appelé « dag ») — « graphe acyclique orienté », mais cette définition ne dira pas grand-chose à la plupart des gens, en réalité c'est un conteneur pour des tâches qui interagissent entre elles (voir ci-dessous) ou l'analogue de Package dans SSIS et Workflow dans Informatica.
En plus des DAGs, il peut y avoir des sous-DAGs, mais nous n'y arriverons probablement pas.
- DAG Run — un DAG initialisé auquel est attribuée sa propre
execution_date. Les DAG runs d'un même DAG peuvent parfaitement fonctionner en parallèle (si bien sûr vous avez rendu vos tâches idempotentes). - Operator — ce sont des morceaux de code responsables de l'exécution d'une action spécifique. Il existe trois types d'opérateurs :
- action, comme notre cher
PythonOperator, qui peut exécuter n'importe quel code Python (valide) ; - transfert, qui déplacent des données d'un endroit à un autre, par exemple,
MsSqlToHiveTransfer; - sensor permettra de réagir ou de ralentir l'exécution du DAG jusqu'à ce qu'un événement se produise.
HttpSensorpeut interroger un endpoint spécifié, et lorsque la bonne réponse est reçue, lancer le transfertGoogleCloudStorageToS3Operator. Un esprit curieux pourrait demander : « pourquoi ? Après tout, on pourrait faire des répétitions directement dans l'opérateur ! » Et bien, pour ne pas saturer le pool de tâches avec des opérateurs suspendus. Le capteur se déclenche, vérifie et s'arrête jusqu'à la prochaine tentative.
- action, comme notre cher
- Task — les opérateurs déclarés, quel que soit leur type, attachés au DAG sont élevés au rang de tâche.
- Task instance — quand le planificateur général a décidé qu'il était temps d'envoyer les tâches au combat pour les exécuteurs-travailleurs (directement sur place, si nous utilisons
LocalExecutorou sur un nœud distant dans le cas deCeleryExecutor), il leur attribue un contexte (c'est-à-dire un ensemble de variables — paramètres d'exécution), déploie les modèles de commandes ou de requêtes et les regroupe dans un pool.
Générer des tâches
Commençons par définir le schéma général de notre DAG, puis nous plongerons progressivement dans les détails, car nous appliquons certaines solutions non triviales.
Ainsi, dans sa forme la plus simple, un tel DAG ressemblera à ceci :
from datetime import timedelta, datetime

from airflow import DAG
from airflow.operators.python_operator import PythonOperator

from commons.datasources import sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

for conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Commençons par comprendre :
- Tout d'abord, importons les bibliothèques nécessaires et quelques autres éléments;
sql_server_ds— ce sont desList[namedtuple[str, str]]avec les noms de connexions provenant des connexions Airflow et les bases de données d'où nous allons récupérer notre tableau ;dag— la déclaration de notre dag, qui doit absolument se trouver dansglobals(), sinon Airflow ne le trouvera pas. Il faut également dire au dag :- quel est son nom
orders— ce nom apparaîtra ensuite dans l'interface web, - qu'il commencera à fonctionner à partir de minuit le 8 juillet,
- et qu'il doit se déclencher environ toutes les 6 heures (pour les durs ici, à la place de
timedelta()on peut utiliser unecron-chaîne0 0 0/6 ? * * *, pour les moins durs — une expression comme@daily);
- quel est son nom
workflow()fera le travail principal, mais pas maintenant. Pour l'instant, nous allons simplement afficher notre contexte dans le journal.- Et maintenant, la simple magie de création des tâches :
- nous parcourons nos sources ;
- nous initialisons
PythonOperator, qui exécutera notre tâche videworkflow(). N'oubliez pas d'indiquer un nom unique (dans le cadre du dag) pour la tâche et d'attacher le dag lui-même. Le flagprovide_contextinjectera à son tour des arguments supplémentaires dans la fonction, que nous rassemblerons avec soin grâce à**context.
Pour l'instant, c'est tout. Que nous avons obtenu :
- un nouveau dag dans l'interface web,
- une centaine de tâches qui seront exécutées en parallèle (si les paramètres d'Airflow, Celery et la puissance des serveurs le permettent).
Eh bien, presque obtenu.
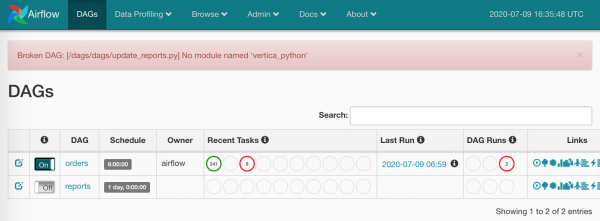
Qui va établir les dépendances ?
Pour simplifier tout cela, j'ai intégré dans docker-compose.yml le traitement requirements.txt sur tous les nœuds.
Maintenant, ça y est :
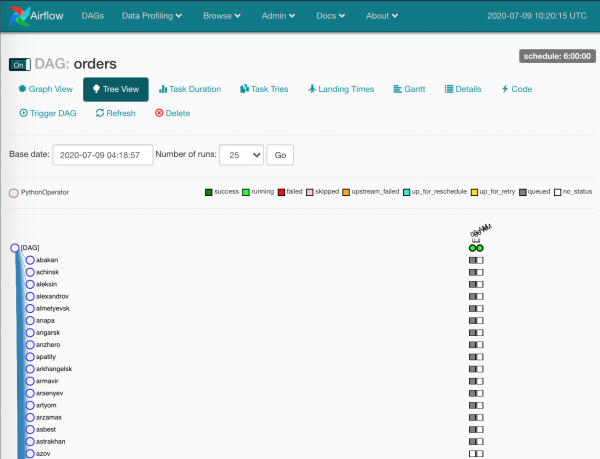
Les carrés gris — instances de tâches, traitées par le planificateur.
Nous attendons un peu, les tâches sont prises par les workers :
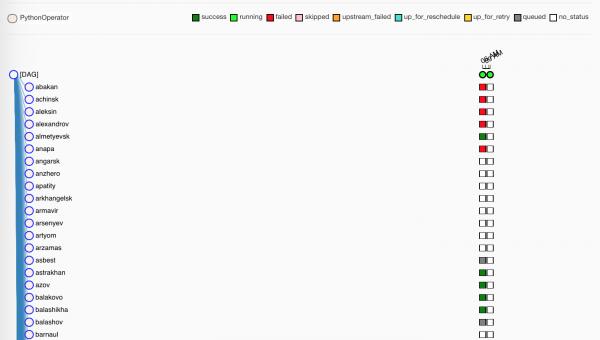
Les vertes, c'est évident, — celles qui ont été exécutées avec succès. Les rouges — pas très réussies.
D'ailleurs, sur notre prod, il n'y a aucun dossier
. /dags, synchronisé entre les machines — tous les dags se trouvent dansgitnotre Gitlab, et Gitlab CI déploie les mises à jour sur les machines lors d'un merge dansmaster.
Un mot sur Flower
Pendant que les workers traitent nos tâches vides, rappelons-nous d'un autre outil, qui peut nous montrer certaines choses — Flower.
La première page avec un résumé des informations sur les nœuds-workers :
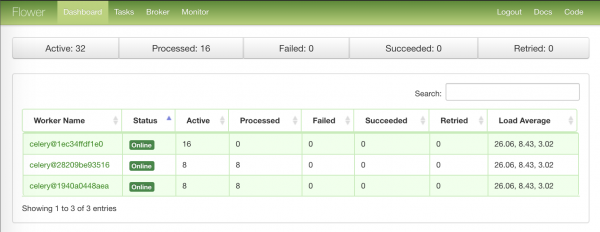
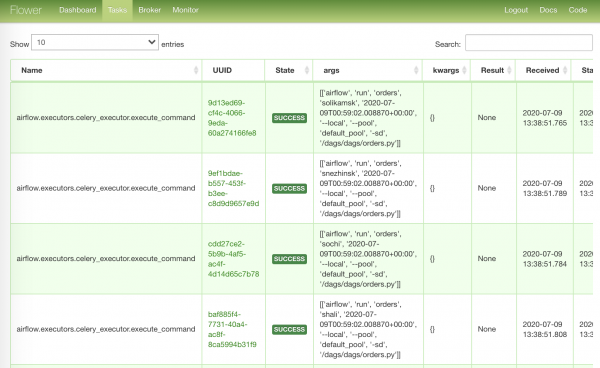
La page la plus chargée avec les tâches envoyées au travail :
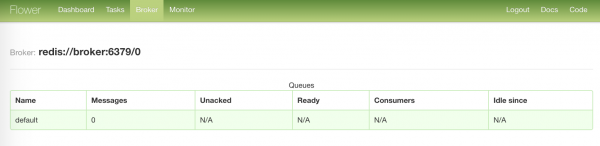
La page la plus ennuyeuse sur l'état de notre courtier :
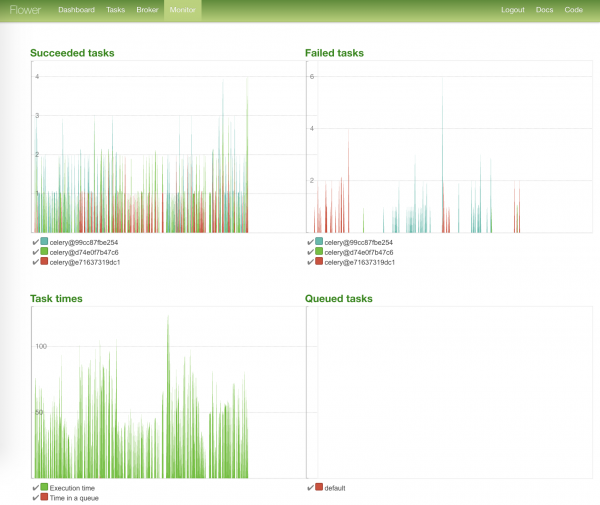
La page la plus dynamique — avec des graphiques de l'état des tâches et leurs temps d'exécution :
Charger ce qui n'est pas encore chargé
Ainsi, toutes les tâches ont été effectuées, nous pouvons évacuer les blessés.
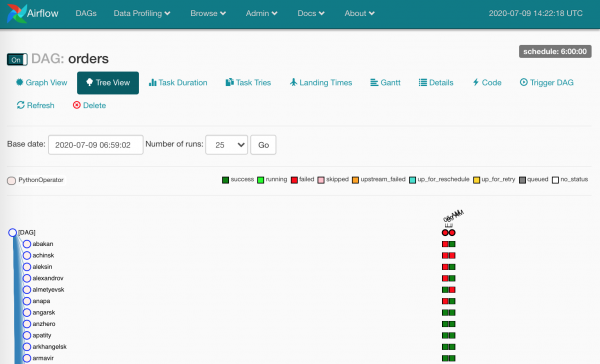
Et il y avait pas mal de blessés — pour diverses raisons. En cas d'utilisation correcte d'Airflow, ces carrés montrent que les données n'ont clairement pas été livrées.
Il faut consulter le journal et redémarrer les instances de tâche échouées.
En cliquant sur n'importe quel carré, nous verrons les actions qui nous sont disponibles :
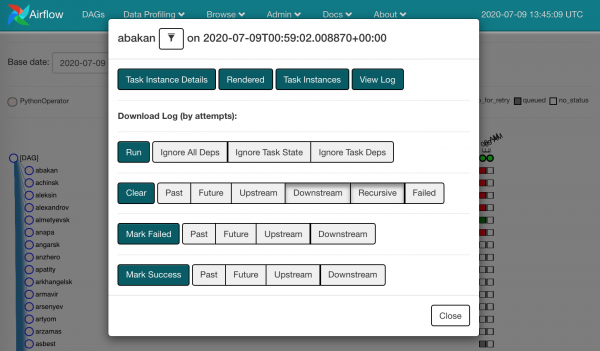
On peut choisir de faire Clear sur celui qui a échoué. Autrement dit, nous oublions que quelque chose s'est enrayé, et la même instance de tâche partira vers le planificateur.
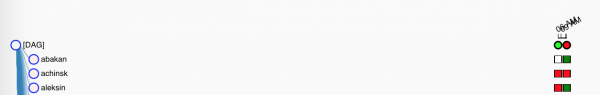
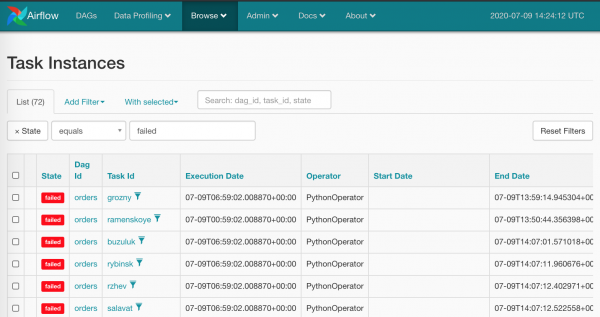
Évidemment, procéder ainsi avec toutes les cases rouges n'est pas très humain — ce n'est pas ce que nous attendons d'Airflow. Naturellement, nous avons une arme de destruction massive : Browse/Task Instances
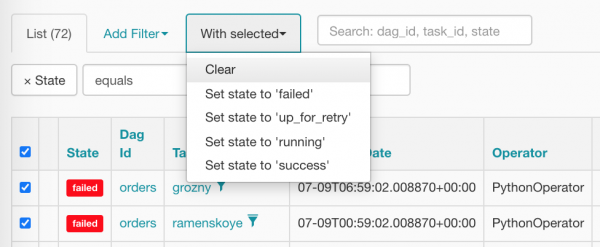
Sélectionnons tout d'un coup et appliquons la bonne option :
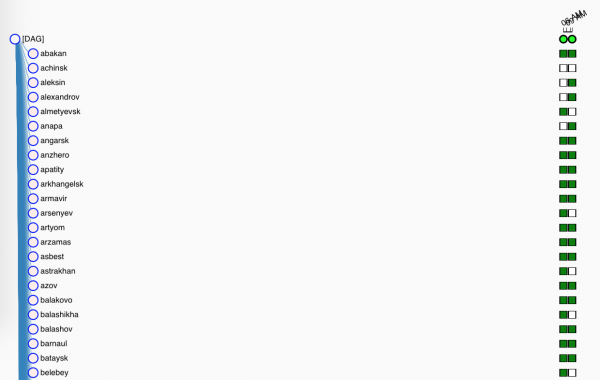
Après nettoyage, nos tâches ressemblent à ceci (elles attendent déjà avec impatience que le planificateur les programme) :
Connexions, hooks et autres variables
Il est temps de jeter un œil au prochain DAG, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Mesdames et messieurs, les rapports ont été mis à jour"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Natasha, réveille-toi, nous avons fait tomber {{ dag.dag_id }}
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

    report_update >> [email, tg]
Tout le monde a-t-il déjà fait un mise à jour de rapports ? C'est encore elle : il y a une liste de sources à partir desquelles récupérer les données ; il y a une liste d'endroits pour les placer ; n'oublions pas de signaler lorsque tout s'est passé ou s'est cassé (bon, ça ne nous concerne pas, non).
Reprenons le fichier et examinons les nouveaux éléments curieux :
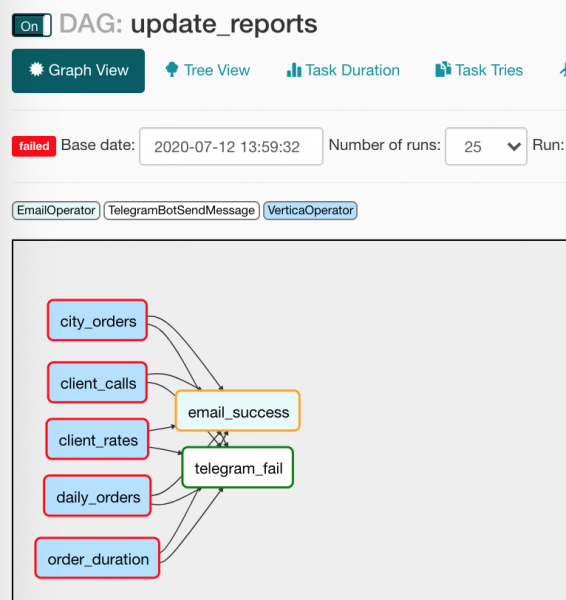
from commons.operators import TelegramBotSendMessage— rien ne nous empêche de créer nos propres opérateurs, ce que nous avons fait en réalisant un petit wrapper pour envoyer des messages dans Unblocked. (Nous parlerons plus en détail de cet opérateur ci-dessous);default_args={}— le DAG peut distribuer les mêmes arguments à tous ses opérateurs;to='{{ var.value.all_the_kings_men }}'— champtonous ne le coderons pas en dur, mais nous le générerons dynamiquement à l'aide de Jinja et d'une variable contenant une liste d'adresses email, que j'ai soigneusement placée dansAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— condition de déclenchement de l'opérateur. Dans notre cas, l'email sera envoyé aux chefs seulement si toutes les dépendances se sont exécutées avec succès;tg_bot_conn_id='tg_main'— argumentsconn_idreçoivent les identifiants de connexions que nous créons dansAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— les messages dans Telegram seront envoyés uniquement en cas d'échec de tâches;task_concurrency=1— nous interdisons le lancement simultané de plusieurs instances de tâches du même task. Sinon, nous obtiendrons le lancement simultané de plusieursVerticaOperator(regardant la même table);report_update >> [email, tg]— toutVerticaOperatorse rejoindra pour l'envoi de l'email et du message, comme ceci :

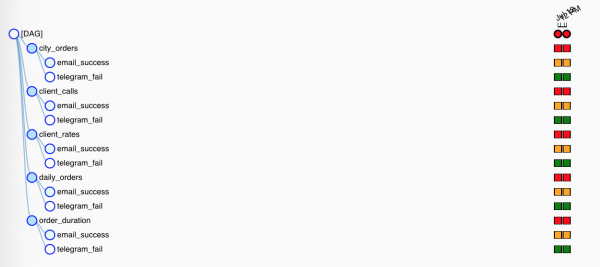
Mais comme les opérateurs de notification ont des conditions de déclenchement différentes, seul un d'entre eux fonctionnera. Dans l'arborescence, tout semble un peu moins clair :

Je vais dire quelques mots sur les macros et leurs amis — des variables.
Les macros sont des placeholders Jinja qui peuvent insérer diverses informations utiles dans les arguments des opérateurs. Par exemple, comme ceci :
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
{{ ds }} se développera en le contenu de la variable de contexte execution_date au format YYYY-MM-DD: 2020-07-14. Ce qui est agréable, c'est que les variables de contexte sont attachées à une instance de tâche donnée (la case dans l'arborescence), et lors du redémarrage, les placeholders seront développés dans les mêmes valeurs.
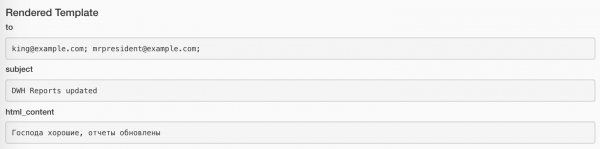
Les valeurs assignées peuvent être consultées à l'aide du bouton Rendered sur chaque instance de tâche. Voici comment cela se présente pour la tâche d'envoi d'email :
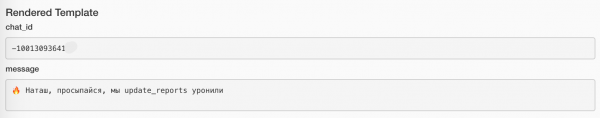
Et voici pour la tâche d'envoi de message :
Une liste complète des macros intégrées pour la dernière version disponible est disponible ici :
De plus, grâce aux plugins, nous pouvons déclarer nos propres macros, mais c'est une toute autre histoire.
En plus des éléments prédéfinis, nous pouvons injecter des valeurs de nos variables (j'ai déjà utilisé cela plus haut dans le code). Créons dans Admin/Variables quelques éléments :
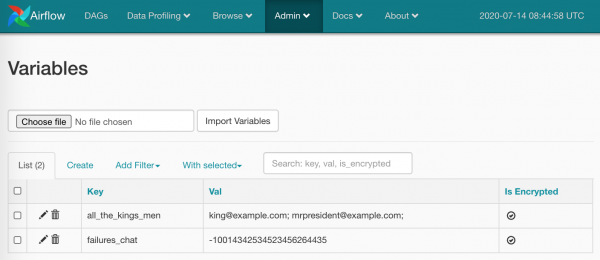
Voilà, il est prêt à l'emploi :
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')Dans la valeur, il peut y avoir un scalaire, ou même un JSON. Dans le cas d'un JSON :
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
il suffit d'utiliser le chemin vers la clé souhaitée : {{ var.json.bot_config.bot.token }}.
Je vais dire un seul mot et montrer une capture d'écran sur les connexions. Ici, tout est élémentaire : sur la page Admin/Connections nous créons une connexion, en y ajoutant nos identifiants/mots de passe et des paramètres plus spécifiques. Voici comment :
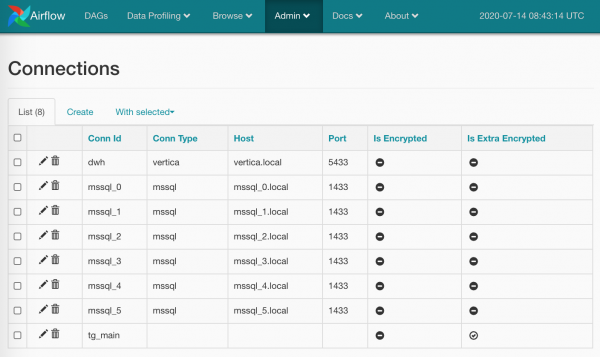
Les mots de passe peuvent être chiffrés (plus soigneusement que dans l'option par défaut), ou le type de connexion peut ne pas être spécifié (comme je l'ai fait pour tg_main) — le fait est que la liste des types est intégrée dans les modèles Airflow et ne peut être étendue sans toucher aux sources (si jamais je n'ai pas trouvé l'information, merci de me corriger), mais rien ne nous empêche d'obtenir les informations d'identification simplement par nom.
De plus, il est possible de créer plusieurs connexions avec le même nom : dans ce cas, la méthode BaseHook.get_connection(), qui récupère les connexions par nom, renverra un aléatoire parmi plusieurs homonymes (il serait plus logique de faire un Round Robin, mais laissons cela à la discrétion des développeurs d'Airflow).
Les Variables et les Connexions sont bien sûr des outils pratiques, mais il est important de ne pas perdre l'équilibre : quelles parties de vos flux vous conservez effectivement dans le code, et quelles parties vous confiez à Airflow. D'un côté, changer rapidement une valeur, par exemple une boîte de réception, peut être pratique via l'UI. D'un autre côté, cela revient à utiliser la souris, ce dont nous (je) voulions nous débarrasser.
Travailler avec les connexions est l'une des tâches hooks. En fait, les hooks Airflow sont des points de connexion à des services et bibliothèques externes. Par exemple, JiraHook nous ouvrira un client pour interagir avec Jira (nous pouvons déplacer des tâches d'un côté à l'autre), et avec SambaHook nous pouvons pousser un fichier local vers un point smb.Nous sommes donc très proches de voir comment fonctionne
Analyser un opérateur personnalisé
TelegramBotSendMessage commons/operators.py
Code avec l'opérateur proprement dit : avec son propre opérateur :
de typing import Union

from airflow.operators import BaseOperator

from commons.hooks import TelegramBotHook, TelegramBot

class TelegramBotSendMessage(BaseOperator):
    """Envoyer un message au chat_id en utilisant TelegramBotHook

    Exemple:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     message='{{ dag.dag_id }} a échoué :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    def __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    def execute(self, context):
        print(f'Envoyer "{self.message}" au chat {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Ici, comme le reste dans Airflow, c'est très simple :
- Nous avons hérité de
BaseOperator, qui implémente beaucoup de choses spécifiques à Airflow (jetez-y un œil lorsque vous en avez le temps) - Nous avons déclaré les champs
template_fields, dans lesquels Jinja va chercher des macros pour le traitement. - Nous avons organisé les bons arguments pour
__init__(), en plaçant des valeurs par défaut là où cela était nécessaire. - Nous n'avons pas oublié d'initialiser le parent non plus.
- Nous avons ouvert le hook correspondant
TelegramBotHook, et obtenu l'objet client à partir de celui-ci. - Nous avons redéfini la méthode
BaseOperator.execute(), que Airflow appellera lorsque le moment sera venu d'exécuter l'opérateur — c'est là que nous réalisons l'action principale, sans oublier de faire des journaux. (Nous loggons, d'ailleurs, directement dansstdoutetstderr— Airflow va tout intercepter, bien l'enrober, le classer là où il faut.)
Voyons ce que nous avons dans commons/hooks.py. La première partie du fichier, avec le hook lui-même :
from typing import Union

from airflow.hooks.base_hook import BaseHook
from requests_toolbelt.sessions import BaseUrlSession

class TelegramBotHook(BaseHook):
    """Hook API de Telegram Bot

    Remarque : ajoutez une connexion avec un type de Conn vide et n'oubliez pas
    de remplir Extra :

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Je ne sais même pas quoi expliquer ici, juste quelques points importants :
- Nous héritons, pensons aux arguments — dans la plupart des cas, il n'y en aura qu'un :
conn_id; - Nous redéfinissons les méthodes standard : je me suis limité à
get_conn(), dans laquelle je récupère les paramètres de connexion par nom et j'extrais simplement la sectionextra(ce champ est pour JSON), dans lequel j'ai (selon mes propres instructions !) mis le token du bot Telegram :{"bot_token": "YOuRAwEsomeBOtToKen"}. - Je crée une instance de notre
TelegramBot, lui donnant déjà un token spécifique.
Voilà, c'est tout. On peut obtenir le client du hook grâce à TelegramBotHook().client ou TelegramBotHook().get_conn().
Et la deuxième partie du fichier, dans laquelle j'ai fait un micro-emballage pour l'API REST de Telegram, afin de ne pas avoir à utiliser le même pour une seule méthode sendMessage.
class TelegramBot:
    """Wrapper de l'API Telegram Bot

    Exemples:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Salut, chéri')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Salut, chéri', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
Le bon chemin consiste à rassembler tout cela :
commons/operators.py,TelegramBotHook,TelegramBot— dans un plugin, le mettre dans un dépôt public, et le rendre Open Source.
Pendant que nous étudions tout cela, nos mises à jour de rapports ont eu le temps de crouler sous le poids et de m'envoyer un message d'erreur dans le canal. Je vais vérifier ce qui ne va pas encore ...
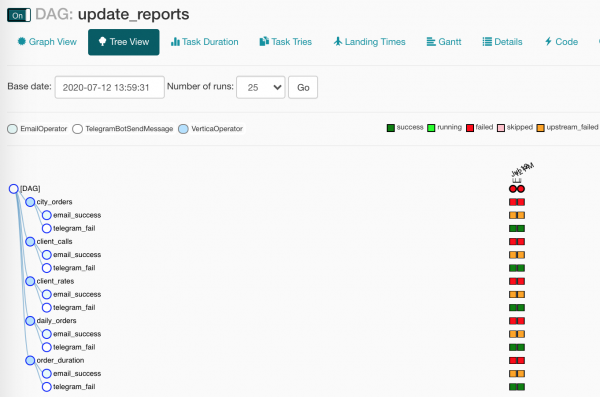
Quelque chose s'est cassé dans notre DAG ! N'est-ce pas ce que nous attendions ? En effet !
Vas-tu remplir ça ?
Vous sentez que j'ai raté quelque chose ? Il semblait que je devais transférer des données de SQL Server vers Vertica, et voilà que je m'éloigne du sujet, quel drôle !
Cet acte était intentionnel, je devais simplement vous expliquer une certaine terminologie. Maintenant, nous pouvons avancer.
Notre plan était le suivant :
- Faire le DAG
- Générer les tâches
- Regarder comme tout est beau
- Attribuer des numéros de session aux chargements
- Récupérer des données de SQL Server
- Mettre des données dans Vertica
- Rassembler des statistiques
Donc, pour démarrer tout cela, j'ai fait un petit ajout à notre docker-compose.yml:
docker-compose.db.yml
version: '3.4'

x-mssql-base: &mssql-base
  image: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  restart: always
  environment:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

services:
  dwh:
    image: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    image: mio101/py3-sql-db-client-base
    command: python3 .\/mssql_init.py
    depends_on:
      - mssql_0
      - mssql_1
      - mssql_2
    environment:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volumes:
      - .\/mssql_init.py:\/mssql_init.py
      - .\/dags\/commons\/datasources.py:\/commons\/datasources.py
Ici, nous déployons :
- Vertica en tant qu'hôte
dwhavec les paramètres par défaut les plus simples, - trois instances de SQL Server,
- nous alimentons les bases avec quelques données récentes (surtout, ne regardez pas dans le
mssql_init.py!)
Nous lançons tout cela avec une commande un peu plus complexe qu'auparavant :
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Ce que notre générateur aléatoire a produit peut être consulté en utilisant la section Profilage des données / Requête Ad Hoc:
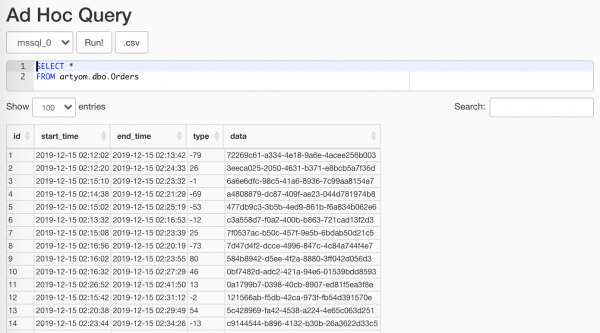
Surtout, ne le montrez pas aux analystes
Je ne vais pas m'attarder sur les sessions ETL c'est assez simple : nous créons une base de données, une table dans celle-ci, nous enveloppons le tout dans un gestionnaire de contexte, et maintenant faisons comme ceci :
with Session(task_name) as session:
    print('Chargement', session.id, 'commencé')

    # Charger le workflow
    ...

    session.successful = True
    session.loaded_rows = 15
session.py
from sys import stderr

class Session:
    """Session de flux de travail ETL

    Exemple:
        with Session(task_name) as session:
            print(session.id)
            session.successful = True
            session.loaded_rows = 15
            session.comment = 'Bien joué'
    """

    def __init__(self, connection, task_name):
        self.connection = connection
        self.connection.autocommit = True

        self._task_name = task_name
        self._id = None

        self.loaded_rows = None
        self.successful = None
        self.comment = None

    def __enter__(self):
        return self.open()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.successful = False
            self.comment = f'{exc_type}: {exc_val}n{exc_tb}'
            print(exc_type, exc_val, exc_tb, file=stderr)
        self.close()

    def __repr__(self):
        return (f'')

    @property
    def task_name(self):
        return self._task_name

    @property
    def id(self):
        return self._id

    def _execute(self, query, *args):
        with self.connection.cursor() as cursor:
            cursor.execute(query, args)
            return cursor.fetchone()[0]

    def _create(self):
        query = """
            CREATE TABLE IF NOT EXISTS sessions (
                id          SERIAL       NOT NULL PRIMARY KEY,
                task_name   VARCHAR(200) NOT NULL,

                started     TIMESTAMPTZ  NOT NULL DEFAULT current_timestamp,
                finished    TIMESTAMPTZ           DEFAULT current_timestamp,
                successful  BOOL,

                loaded_rows INT,
                comment     VARCHAR(500)
            );
            """
        self._execute(query)

    def open(self):
        query = """
            INSERT INTO sessions (task_name, finished)
            VALUES (%s, NULL)
            RETURNING id;
            """
        self._id = self._execute(query, self.task_name)
        print(self, 'ouvert')
        return self

    def close(self):
        if not self._id:
            raise SessionClosedError('La session n'est pas ouverte')
        query = """
            UPDATE sessions
            SET
                finished    = DEFAULT,
                successful  = %s,
                loaded_rows = %s,
                comment     = %s
            WHERE
                id = %s
            RETURNING id;
            """
        self._execute(query, self.successful, self.loaded_rows,
                      self.comment, self.id)
        print(self, 'fermé',
              ', réussi: ', self.successful,
              ', Chargé: ', self.loaded_rows,
              ', commentaire:', self.comment)

class SessionError(Exception):
    pass

class SessionClosedError(SessionError):
    pass
Il est temps de récupérer nos données de nos quelque cent cinquante tables. Faisons-le avec quelques lignes très simples :
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

query = f"""
    SELECT
        id, start_time, end_time, type, data
    FROM dbo.Orders
    WHERE
        CONVERT(DATE, start_time) = '{dt}'
    """

df = pd.read_sql_query(query, source_conn)- Nous allons obtenir de Airflow
pymssql-connexion - Nous allons inclure une limite de date dans la requête - le templateur l'ajoutera.
- Nous alimentons notre requête
pandas, qui nous extrairaDataFrame— elle nous sera utile par la suite.
J'utilise le substitut
{dt}au lieu du paramètre de la requête%snon pas parce que je suis un méchant Pinocchio, mais parce quepandasne peut pas gérerpymssqlet en propose au dernierparams: Liste, bien qu'il le veuille vraimenttuple.
Veuillez également noter que le développeurpymssqla décidé de ne plus le supporter, et il est temps de passer àpyodbc.
Voyons ce qu'Airflow a introduit comme arguments à nos fonctions :
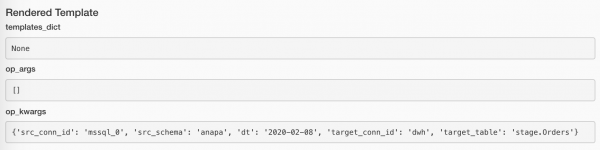
S'il n'y a pas de données, il n'y a pas de raison de continuer. Mais il est également étrange de considérer que le chargement a réussi. Mais ce n'est pas une erreur. Que faire ? Voici la réponse :
if df.empty:
    raise AirflowSkipException('Aucune ligne à charger')
AirflowSkipException Airflow dira qu'il n'y a pas vraiment d'erreur, et que nous passons la tâche. Dans l'interface, il n'y aura pas de carré vert ou rouge, mais de couleur rose.
Ajoutons à nos données quelques colonnes:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
À savoir :
- BD d'où nous avons récupéré les commandes,
- L'identifiant de notre session de chargement (elle sera différente pour chaque tâche),
- Le hachage de la source et de l'identifiant de la commande — pour que dans la base finale (où tout sera fusionné dans une seule table) nous ayons un identifiant unique de commande.
Il reste une avant-dernière étape : charger tout dans Vertica. Étonnamment, l'un des moyens les plus efficaces de le faire est via CSV !
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Nous faisons un récepteur spécial
StringIO. pandasva aimablement y stocker notreDataFramesous formeCSV-lignes.- Ouvrons une connexion à notre chère Vertica avec un hook.
- Et maintenant, à l'aide de
copy()envoyons nos données directement dans Vertica !
Nous récupérerons depuis le driver combien de lignes ont été chargées, et dirons au manager de session que tout va bien :
session.loaded_rows = cursor.rowcount
session.successful = True
Et voilà.
En production, nous créons manuellement la table cible. Ici, je me suis permis un petit automatisme :
create_schema_query = f'CREATE SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    CREATE TABLE IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
À l'aide de
VerticaOperator()je crée le schéma de BD et la table (s'ils n'existent pas encore, bien sûr). L'essentiel est de bien établir les dépendances :
for conn_id, schema in sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Bilan
— Eh bien, dit la petite souris, n'est-ce pas, maintenant
Es-tu sûr que dans la forêt, je suis la bête la plus terrifiante ?
Julia Donaldson, «Le Gruffalo»
Je pense que si mes collègues et moi organisions un concours : qui peut créer et lancer un processus ETL à partir de zéro le plus rapidement possible : eux avec leurs SSIS et leur souris et moi avec Airflow… Et ensuite, nous comparerions la facilité de maintenance… Ouf, je pense que vous conviendrez que je les surpasserai sur tous les fronts !
Cependant, pour parler un peu plus sérieusement, Apache Airflow — grâce à la description des processus sous forme de code — a rendu mon travail beaucoup plus pratique et agréable.
Sa capacité d'extension illimitée : tant en termes de plugins que de scalabilité — vous permet de l'appliquer pratiquement dans n'importe quel domaine : que ce soit dans le cycle complet de collecte, de préparation et de traitement des données, ou dans le lancement de fusées (vers Mars, bien sûr).
Partie finale, informative et référentielle
Les écueils que nous avons évités pour vous
start_date. Oui, c'est déjà un mème local. À travers l'argument principal du DAGstart_datetous passent. En résumé, si vous spécifiez dansstart_datela date actuelle, et dansschedule_interval— un jour, alors le DAG ne se lancera pas avant demain.start_date = datetime(2020, 7, 7, 0, 1, 2)Et plus aucun problème.
C'est également lié à une autre erreur d'exécution :
Task is missing the start_date parameter, qui indique le plus souvent que vous avez oublié de lier au DAG un opérateur.- Tout sur une seule machine. Oui, et les bases (d'Airflow lui-même et de notre couvercle), ainsi que le serveur web, le planificateur et les workers. Et ça fonctionnait même. Mais avec le temps, le nombre de tâches sur les services a augmenté, et quand PostgreSQL a commencé à répondre avec un index en 20 ms au lieu de 5 ms, nous l'avons pris et déplacé.
- LocalExecutor. Oui, nous y sommes toujours, et nous avons déjà atteint le bord du gouffre. Le LocalExecutor nous suffisait jusqu'à présent, mais maintenant il est temps de s'étendre d'au moins un worker, et il va falloir se bouger pour passer au CeleryExecutor. Et étant donné qu'on peut travailler avec lui même sur une seule machine, rien n'empêche l'utilisation de Celery même sur un serveur qui « naturellement, n'ira jamais en production, c'est promis ! »
- Ne pas utiliser les outils intégrés:
- Connections pour stocker les identifiants des services,
- SLA Misses pour réagir aux tâches qui n'ont pas été exécutées à temps,
- XCom pour échanger des métadonnées (j'ai dit métadonnées !) entre les tâches du DAG.
- Abus de la messagerie. Que dire à ce sujet ? Des alertes ont été configurées pour tous les doublons des tâches échouées. Maintenant, dans ma boîte Gmail de travail, j'ai plus de 90k emails d'Airflow, et l'interface web de la messagerie refuse de charger et de supprimer plus de 100 à la fois.
Plus de pièges cachés :
Outils pour encore plus d'automatisation
Pour nous permettre de travailler davantage avec notre tête plutôt qu'avec nos mains, Airflow a prévu pour nous ceci :
- — il a toujours le statut Experimental, ce qui ne l'empêche pas de fonctionner. Avec lui, il est possible non seulement d'obtenir des informations sur les DAGs et les tâches, mais aussi d'arrêter/démarrer un DAG, de créer un DAG Run ou un pool.
- — de nombreux outils sont disponibles en ligne de commande, qui ne sont pas seulement difficiles à utiliser via l'interface Web, mais qui sont même totalement absents. Par exemple :
backfillnécessaire pour relancer des instances de tâches.
Par exemple, des analystes arrivent et disent : « Eh bien, cher ami, il y a des anomalies dans les données du 1er au 13 janvier ! Réparez, réparez, réparez ! ». Et vous, vous répondez :airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Maintenance de la base :
initdb,resetdb,upgradedb,checkdb. run, qui permet de lancer une seule instance de tâche, sans tenir compte de toutes les dépendances. De plus, il est possible de le lancer viaLocalExecutor, même si vous avez un cluster Celery.- En gros, c'est à peu près ce que fait
test, sauf qu'il n'écrit rien dans la base. connectionspermet de créer massivement des connexions depuis le shell.
- — un moyen assez hardcore d'interagir, qui est destiné aux plugins, et non pas à manipuler manuellement. Mais qui nous empêche d'aller dans
/home/airflow/dags, de lanceripythonet de commencer à faire des folies ? On peut, par exemple, exporter toutes les connexions avec ce code :from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Connexion à la base de données des métadonnées d'Airflow. Je ne recommande pas d'y écrire, mais il est possible d'extraire les états des tâches pour différentes métriques spécifiques beaucoup plus rapidement et facilement que via n'importe quel des API.
Disons que tous nos travaux ne sont pas idempotents et peuvent parfois échouer, et c'est normal. Mais plusieurs échecs, c'est déjà suspect, et il faudrait vérifier.
Attention, SQL !
AVEZ dernières_exécutions COMME (
SELECT
    task_id,
    dag_id,
    execution_date,
    state,
        row_number()
        OVER (
            PARTITION PAR task_id, dag_id
            ORDER BY execution_date DESC) AS rn
FROM public.task_instance
WHERE
    execution_date > now() - INTERVAL '2' JOURS
),
échoué COMME (
    SELECT
        task_id,
        dag_id,
        execution_date,
        state,
        CASE WHEN rn = row_number() OVER (
            PARTITION PAR task_id, dag_id
            ORDER BY execution_date DESC)
                 THEN TRUE END AS last_fail_seq
    FROM dernières_exécutions
    WHERE
        state IN ('failed', 'up_for_retry')
)
SELECT
    task_id,
    dag_id,
    count(last_fail_seq)                       AS unsuccessful,
    count(CASE WHEN last_fail_seq
        AND state = 'failed' THEN 1 END)       AS failed,
    count(CASE WHEN last_fail_seq
        AND state = 'up_for_retry' THEN 1 END) AS up_for_retry
FROM échoué
GROUPE PAR
    task_id,
    dag_id
AYANT
    count(last_fail_seq) > 0
Liens
Et bien sûr, les dix premiers liens dans les résultats de Google contiennent le contenu du dossier Airflow de mes favoris.
- — bien sûr, il faut commencer par la documentation officielle, mais qui lit les instructions ?
- — au moins lisez les recommandations des créateurs.
- — les bases : l'interface utilisateur en images
- — les bases sont bien expliquées, au cas où (par hasard !) vous n'auriez pas compris chez moi.
- — un guide rapide pour configurer un cluster Airflow.
- — un article presque aussi intéressant, juste un peu plus de formalisme et moins d'exemples.
- — sur le travail conjoint avec Celery.
- — sur l'idempotence des tâches, le chargement par ID au lieu de la date, les transformations, la structure des fichiers et d'autres choses intéressantes.
- — dépendances des tâches et Trigger Rule, que j'ai mentionnées brièvement.
- — comment surmonter certains « fonctionne comme prévu » du planificateur, charger les données manquantes et prioriser les tâches.
- — requêtes SQL utiles pour les métadonnées Airflow.
- — il y a une section utile sur la création de capteurs personnalisés.
- — une note courte et intéressante sur la construction de l'infrastructure sur AWS pour Data Science.
- — erreurs fréquentes (lorsque quelqu'un ne lit toujours pas les instructions).
- — souriez, comment les gens bricolent le stockage des mots de passe, alors qu'il suffit d'utiliser les Connections.
- — passage implicite du DAG, passage de contexte dans une fonction, encore sur les dépendances, et aussi sur le saut des exécutions de tâches.
- — sur l'utilisation de
arguments par défautetparamsdans les modèles, ainsi que sur les variables et les connexions. - — un récit sur la préparation du planificateur pour Airflow 2.0.
- — un article un peu obsolète sur le déploiement de notre cluster dans
docker-compose. - — des tâches dynamiques à l'aide de modèles et de passage de contexte.
- — notifications standard et personnalisées par e-mail et Slack.
- — embranchements de tâches, macros et XCom.
Et les liens mentionnés dans l'article :
- — placeholders disponibles pour utilisation dans les modèles.
- — erreurs fréquentes lors de la création de DAG.
- —
docker-composepour les expériences, le débogage et plus encore. - — Wrapper Python pour l'API REST de Telegram.
Source : habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish