

Bonjour, Habr ! Aujourd'hui, nous allons construire un système qui traitera des flux de messages Apache Kafka avec Spark Streaming et enregistrera le résultat dans une base de données AWS RDS.
Imaginons qu'une institution de crédit nous demande de traiter des transactions entrantes « en temps réel » dans toutes ses agences. Cela peut être fait dans le but de calculer rapidement une position en devise ouverte pour la trésorerie, des limites ou des résultats financiers sur des transactions, etc.
Comment réaliser ce cas sans utiliser de magie et de sorts — lisez sous la coupe ! C'est parti !
Introduction
Bien sûr, le traitement de grands ensembles de données en temps réel offre de nombreuses possibilités d'utilisation dans les systèmes modernes. L'une des combinaisons les plus populaires pour cela est le tandem Apache Kafka et Spark Streaming, où Kafka crée un flux de paquets de messages entrants, tandis que Spark Streaming traite ces paquets à intervalles réguliers.
Pour améliorer la résilience de l'application, nous allons utiliser des points de contrôle — checkpoints. Grâce à ce mécanisme, lorsque le module Spark Streaming aura besoin de récupérer des données perdues, il devra seulement revenir au dernier point de contrôle et reprendre les calculs à partir de celui-ci.
Architecture du système en cours de développement
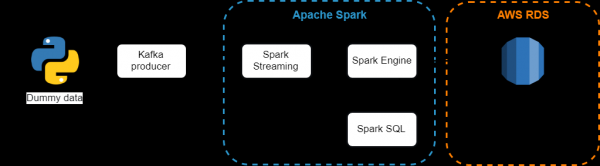
Composants utilisés :
- — est un système distribué d'échange de messages avec publication et abonnement. Il convient à la consommation de messages en mode autonome ou en ligne. Pour éviter la perte de données, les messages Kafka sont enregistrés sur disque et répliqués à l'intérieur du cluster. Le système Kafka est construit au-dessus du service de synchronisation ZooKeeper ;
- — le composant Spark pour le traitement des flux de données. Le module Spark Streaming est construit sur une architecture de « micro-lots » (micro-batch architecture), où un flux de données est interprété comme une séquence continue de petits paquets de données. Spark Streaming reçoit des données de différentes sources et les regroupe en petits paquets. De nouveaux paquets sont créés à intervalles de temps réguliers. Au début de chaque intervalle de temps, un nouveau paquet est créé, et toutes les données reçues pendant cet intervalle sont incluses dans le paquet. À la fin de l'intervalle, l'augmentation du paquet s'arrête. La taille de l'intervalle est définie par un paramètre appelé intervalle de lot (batch interval);
- — combine le traitement relationnel avec la programmation fonctionnelle de Spark. Les données structurées désignent des données ayant un schéma, c'est-à-dire un ensemble unique de champs pour tous les enregistrements. Spark SQL prend en charge l'entrée de plusieurs sources de données structurées et, grâce à la présence d'informations sur le schéma, il peut efficacement extraire uniquement les champs nécessaires des enregistrements et fournit également des API DataFrame;
- — c'est une base de données relationnelle cloud relativement peu coûteuse, un service web qui simplifie la configuration, l'exploitation et l'évolutivité, administré directement par Amazon.
Installation et lancement du serveur Kafka
Avant d'utiliser Kafka, vous devez vous assurer que Java est présent, car il utilise la JVM pour fonctionner :
sudo apt-get update
sudo apt-get install default-jre
java -version
Créons un nouvel utilisateur pour travailler avec Kafka :
sudo useradd kafka -m
sudo passwd kafka
sudo adduser kafka sudo
Ensuite, téléchargez la distribution depuis le site officiel d'Apache Kafka :
wget -P /YOUR_PATH "http://apache-mirror.rbc.ru/pub/apache/kafka/2.2.0/kafka_2.12-2.2.0.tgz"Décompressons l'archive téléchargée :
tar -xvzf /YOUR_PATH/kafka_2.12-2.2.0.tgz
ln -s /YOUR_PATH/kafka_2.12-2.2.0 kafka
L'étape suivante est facultative. En effet, les paramètres par défaut ne permettent pas d'exploiter pleinement toutes les capacités d'Apache Kafka. Par exemple, pour supprimer des thèmes, des catégories, ou des groupes sur lesquels des messages peuvent être publiés. Pour modifier cela, nous allons éditer le fichier de configuration :
vim ~/kafka/config/server.propertiesAjoutez ce qui suit à la fin du fichier :
delete.topic.enable = trueAvant de lancer le serveur Kafka, il est nécessaire de démarrer le serveur ZooKeeper. Nous allons utiliser un script d'assistance qui est fourni avec la distribution de Kafka :
Cd ~/kafka
bin/zookeeper-server-start.sh config/zookeeper.properties
Une fois que ZooKeeper a démarré avec succès, nous lançons le serveur Kafka dans un terminal séparé :
bin/kafka-server-start.sh config/server.propertiesCréons un nouveau sujet intitulé Transaction :
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic transactionVérifions que le sujet avec le nombre de partitions et la réplication requis a été créé :
bin/kafka-topics.sh --describe --zookeeper localhost:2181 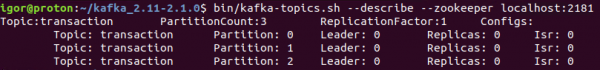
Nous ne couvrirons pas les moments de test du producteur et du consommateur pour le nouveau sujet. Vous trouverez plus d'informations sur la façon de tester l'envoi et la réception de messages dans la documentation officielle — . Nous passons maintenant à l'écriture d'un producteur en Python en utilisant l'API KafkaProducer.
Écriture du producteur
Le producteur générera des données aléatoires — 100 messages chaque seconde. Par données aléatoires, nous entendons un dictionnaire composé de trois champs :
- Filiale — le nom du point de vente de l'organisme de crédit ;
- Currency — la devise de la transaction ;
- Amount — le montant de la transaction. Le montant sera un nombre positif si c'est un achat de devise par la Banque et négatif si c'est une vente.
Le code pour le producteur est le suivant :
from numpy.random import choice, randint

def get_random_value():
    new_dict = {}

    branch_list = ['Kazan', 'SPB', 'Novosibirsk', 'Surgut']
    currency_list = ['RUB', 'USD', 'EUR', 'GBP']

    new_dict['branch'] = choice(branch_list)
    new_dict['currency'] = choice(currency_list)
    new_dict['amount'] = randint(-100, 100)

    return new_dict
Ensuite, en utilisant la méthode send, nous envoyons le message au serveur, dans le sujet désiré, au format JSON :
from kafka import KafkaProducer

producer = KafkaProducer(bootstrap_servers=['localhost:9092'],
                             value_serializer=lambda x:dumps(x).encode('utf-8'),
                             compression_type='gzip')
my_topic = 'transaction'
data = get_random_value()

try:
    future = producer.send(topic = my_topic, value = data)
    record_metadata = future.get(timeout=10)

    print('--> Le message a été envoyé à un sujet :
            {}, partition : {}, offset : {}'
            .format(record_metadata.topic,
                record_metadata.partition,
                record_metadata.offset ))

except Exception as e:
    print('--> Il semble qu'une erreur se soit produite : {}'.format(e))

finally:
    producer.flush()
Lors de l'exécution du script, nous obtenons les messages suivants dans le terminal :
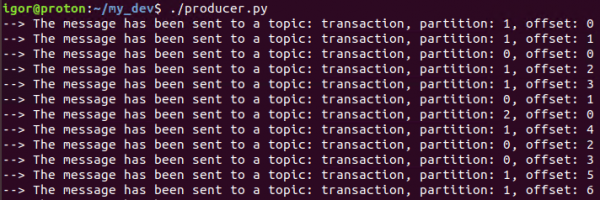
Cela signifie que tout fonctionne comme prévu — le producteur génère et envoie des messages dans le sujet désiré.
La prochaine étape sera l'installation de Spark et le traitement de ce flux de messages.
Installation d'Apache Spark
Apache Spark — est une plateforme de calcul distribué universelle et haute performance.
En termes de performance, Spark surpasse les implémentations populaires du modèle MapReduce, tout en offrant un support pour une gamme plus large de types de calculs, y compris les requêtes interactives et le traitement en continu. La vitesse joue un rôle crucial dans le traitement de grandes quantités de données, car c'est cette vitesse qui permet de travailler de manière interactive sans perdre des minutes ou des heures à attendre. L'un des principaux atouts de Spark qui garantit une telle rapidité est sa capacité à effectuer des calculs en mémoire.
Ce framework est écrit en Scala, donc il est nécessaire de l'installer en premier lieu :
sudo apt-get install scalaTéléchargeons la distribution de Spark depuis le site officiel :
wget "http://mirror.linux-ia64.org/apache/spark/spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz"Décompressons l'archive :
sudo tar xvf spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz -C /usr/local/sparkAjoutons le chemin de Spark dans le fichier bash :
vim ~/bashrcAjoutons les lignes suivantes via l'éditeur :
SPARK_HOME=/usr/local/spark
export PATH=$SPARK_HOME/bin:$PATH
Exécutons la commande ci-dessous après avoir apporté les modifications au bashrc :
source ~/bashrcDéploiement AWS PostgreSQL
Il reste à déployer la base de données, où nous allons charger les informations traitées des flux. Pour cela, nous allons utiliser le service AWS RDS.
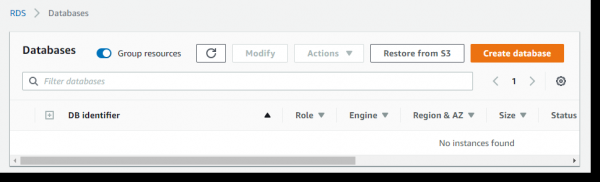
Connectons-nous à la console AWS -> AWS RDS -> Bases de données -> Créer une base de données :
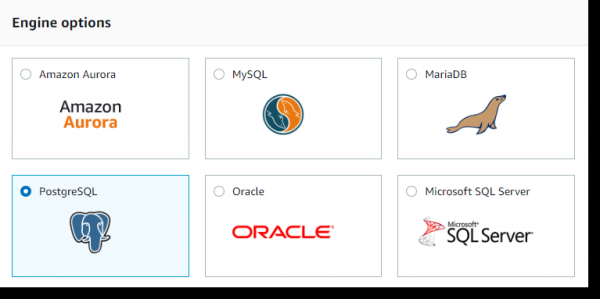
Sélectionnons PostgreSQL et cliquons sur le bouton Suivant :
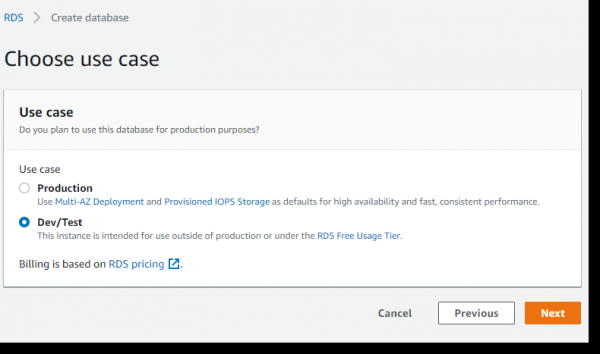
Comme cet exemple est exclusivement étudié à des fins éducatives, nous allons utiliser un serveur gratuit « minimaliste » (Free Tier) :
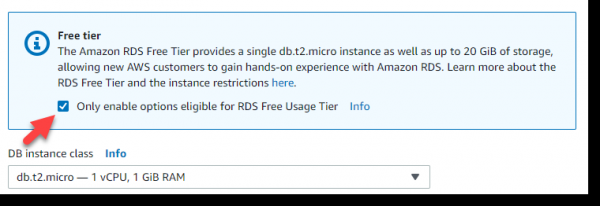
Ensuite, cochons la case dans le bloc Free Tier, et après ça, un instance de classe t2.micro nous sera automatiquement proposée — bien que faible, elle est gratuite et conviendra parfaitement à notre tâche :
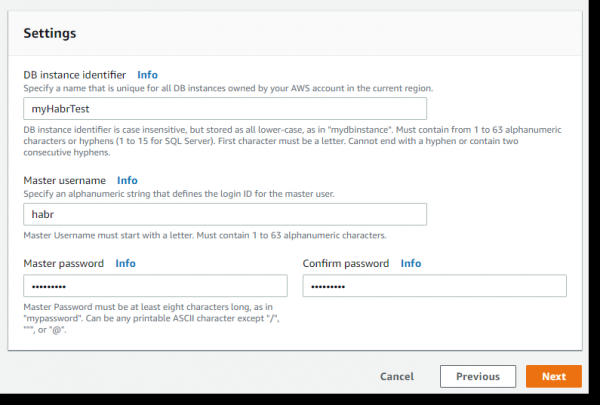
Les éléments suivants sont très importants : le nom de l'instance de la base de données, le nom de l'utilisateur principal et son mot de passe. Appelons l'instance : myHabrTest, utilisateur principal : habr, mot de passe : habr12345 et cliquons sur le bouton Suivant :
Sur la page suivante se trouvent les paramètres concernant l'accessibilité de notre serveur de base de données depuis l'extérieur (Accessibilité publique) et la disponibilité des ports :
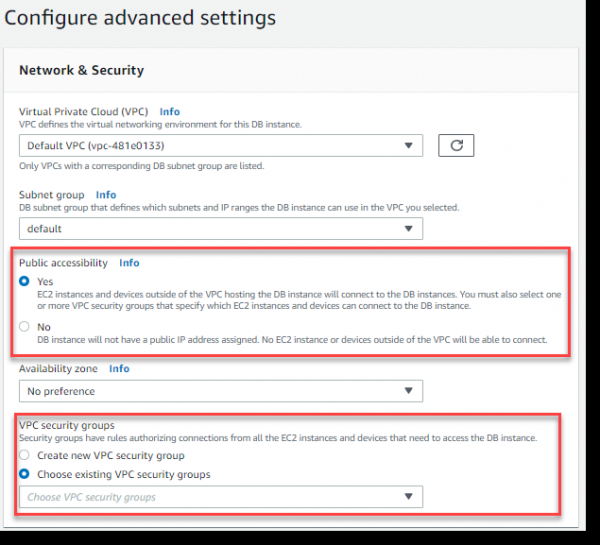
Créons une nouvelle configuration pour le groupe de sécurité VPC, qui permettra d'accéder à notre serveur de base de données depuis l'extérieur via le port 5432 (PostgreSQL).
Passons dans une nouvelle fenêtre de navigateur à la console AWS dans la section Tableau de bord VPC -> Groupes de sécurité -> Créer un groupe de sécurité :
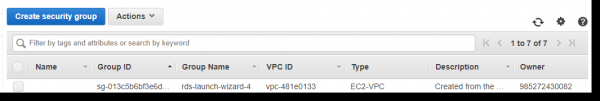
Définissons un nom pour le groupe de sécurité — PostgreSQL, ajoutons une description, spécifions à quel VPC ce groupe doit être associé et cliquons sur le bouton Créer :

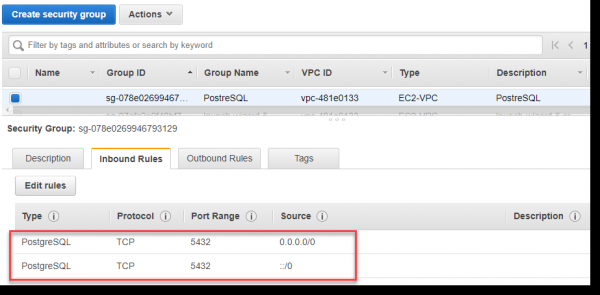
Remplissons pour le nouveau groupe les règles entrantes pour le port 5432, comme indiqué sur l'image ci-dessous. Il n'est pas nécessaire d'indiquer manuellement le port, il suffit de choisir PostgreSQL dans le menu déroulant Type.
Strictement parlant, la valeur ::/0 signifie que le trafic entrant est accessible pour le serveur depuis le monde entier, ce qui n'est pas tout à fait juste canoniquement, mais pour l'analyse de l'exemple, nous nous permettons d'utiliser cette approche :
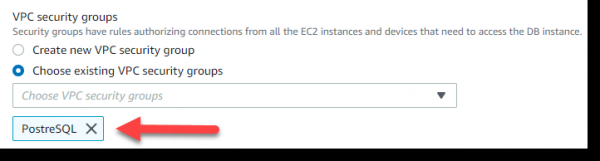
Revenons à la page du navigateur où nous avons ouvert « Configurer les paramètres avancés » et sélectionnons dans la section Groupes de sécurité VPC —> Choisir des groupes de sécurité VPC existants —> PostgreSQL :
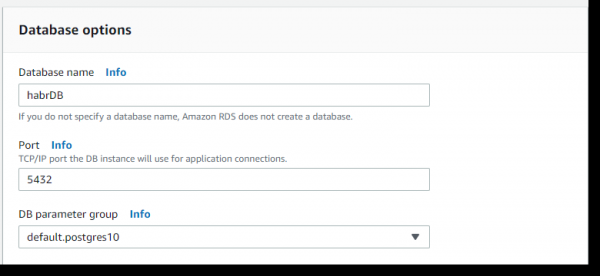
Ensuite, dans la section Options de base de données —> Nom de la base de données —> définissons le nom — habrDB.
Les autres paramètres, à l'exception peut-être de la désactivation de la sauvegarde (durée de conservation des sauvegardes — 0 jours), de la surveillance et des Performance Insights, peuvent être laissés par défaut. Cliquons sur le bouton Créer une base de données:
Gestionnaire de flux
La dernière étape consistera à développer un job Spark qui traitera de nouvelles données toutes les deux secondes, provenant de Kafka et stockera le résultat dans la base de données.
Comme mentionné ci-dessus, les points de contrôle (checkpoints) sont le principal mécanisme dans Spark Streaming, qui doit être configuré pour assurer la tolérance aux pannes. Nous allons utiliser des points de contrôle et, en cas d'échec de la procédure, le module Spark Streaming pour récupérer les données perdues devra simplement revenir au dernier point de contrôle et reprendre les calculs à partir de là.
Le point de contrôle peut être activé en configurant un répertoire dans un système de fichiers tolérant aux pannes et fiable (par exemple, HDFS, S3, etc.) où les informations du point de contrôle seront sauvegardées. Cela se fait par exemple avec :
streamingContext.checkpoint(checkpointDirectory)Dans notre exemple, nous utiliserons l'approche suivante, à savoir que si checkpointDirectory existe, alors le contexte sera recréé à partir des données du point de contrôle. Si le répertoire n'existe pas (c'est-à-dire qu'il s'exécute pour la première fois), la fonction functionToCreateContext est appelée pour créer un nouveau contexte et configurer les DStreams :
from pyspark.streaming import StreamingContext

context = StreamingContext.getOrCreate(checkpointDirectory, functionToCreateContext)
Créons un objet DirectStream dans le but de se connecter au topic « transaction » à l'aide de la méthode createDirectStream de la bibliothèque KafkaUtils :
from pyspark.streaming.kafka import KafkaUtils

sc = SparkContext(conf=conf)
ssc = StreamingContext(sc, 2)

broker_list = 'localhost:9092'
topic = 'transaction'

directKafkaStream = KafkaUtils.createDirectStream(ssc,
                                [topic],
                                {"metadata.broker.list": broker_list})
Analysons les données entrantes au format JSON :
rowRdd = rdd.map(lambda w: Row(branch=w['branch'],
                                       currency=w['currency'],
                                       amount=w['amount']))

testDataFrame = spark.createDataFrame(rowRdd)
testDataFrame.createOrReplaceTempView("treasury_stream")
En utilisant Spark SQL, faisons un simple regroupement et affichons le résultat dans la console :
select
    from_unixtime(unix_timestamp()) as curr_time,
    t.branch                        as branch_name,
    t.currency                      as currency_code,
    sum(amount)                     as batch_value
from treasury_stream t
group by
    t.branch,
    t.currency
Obtention du texte de la requête et exécution via Spark SQL :
sql_query = get_sql_query()
testResultDataFrame = spark.sql(sql_query)
testResultDataFrame.show(n=5)
Nous sauvegardons ensuite les données agrégées dans une table sur AWS RDS. Pour enregistrer les résultats de l'agrégation dans une table de base de données, nous utiliserons la méthode write de l'objet DataFrame :
testResultDataFrame.write
    .format("jdbc")
    .mode("append")
    .option("driver", 'org.postgresql.Driver')
    .option("url","jdbc:postgresql://myhabrtest.ciny8bykwxeg.us-east-1.rds.amazonaws.com:5432/habrDB")
    .option("dbtable", "transaction_flow")
    .option("user", "habr")
    .option("password", "habr12345")
    .save()
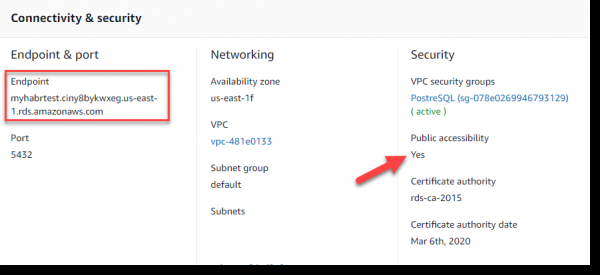
Quelques mots sur la configuration de la connexion à AWS RDS. Nous avons créé l'utilisateur et le mot de passe lors de l'étape « Déploiement AWS PostgreSQL ». Comme URL du serveur de base de données, nous devons utiliser l'Endpoint affiché dans la section Connectivité et sécurité :
Pour une liaison correcte entre Spark et Kafka, il est nécessaire de lancer le job via spark-submit en utilisant l'artefact spark-streaming-kafka-0-8_2.11. Nous utiliserons également un artefact pour l'interaction avec la base de données PostgreSQL, que nous transmettrons via —packages.
Pour la flexibilité du script, nous extrairons également comme paramètres d'entrée le nom du serveur de messages et le sujet à partir duquel nous voulons recevoir des données.
Il est donc temps de lancer et de vérifier le bon fonctionnement du système :
spark-submit
--packages org.apache.spark:spark-streaming-kafka-0-8_2.11:2.0.2,
org.postgresql:postgresql:9.4.1207
spark_job.py localhost:9092 transaction
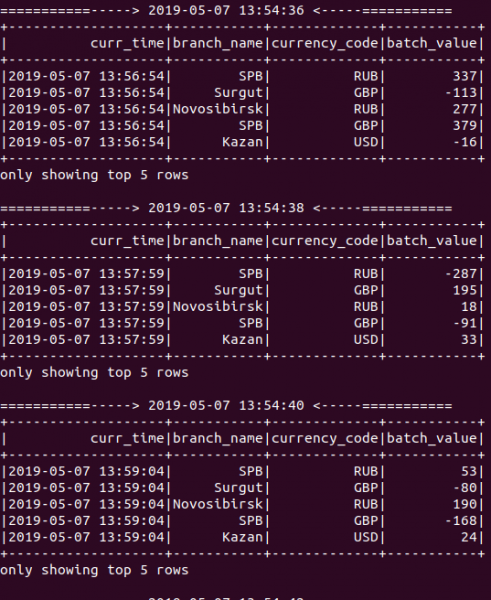
Tout a fonctionné ! Comme le montre l'image ci-dessous, pendant le fonctionnement de l'application, de nouveaux résultats d'agrégation sont affichés toutes les 2 secondes, car nous avons défini l'intervalle de mise en paquets à 2 secondes lors de la création de l'objet StreamingContext :
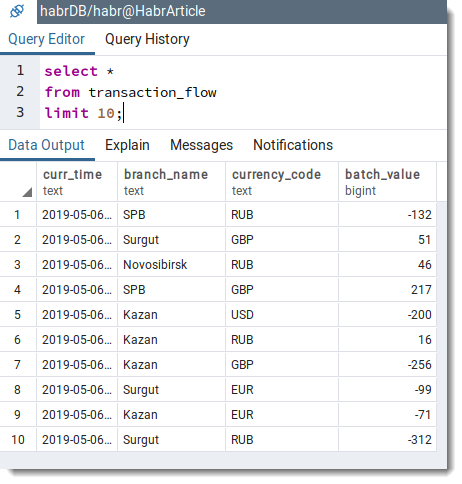
Ensuite, faisons une simple requête à la base de données pour vérifier la présence d'enregistrements dans la table transaction_flow:
Conclusion
Cet article présente un exemple de traitement de flux d'informations en utilisant Spark Streaming en combinaison avec Apache Kafka et PostgreSQL. Avec l'augmentation des volumes de données provenant de diverses sources, la valeur pratique de Spark Streaming pour la création d'applications de flux et d'applications fonctionnant à l'échelle du temps réel est difficile à surestimer.
Le code source complet est disponible dans mon dépôt sur .
Je suis heureux de discuter de cet article, j'attends vos commentaires et j'espère également des critiques constructives de tous les lecteurs intéressés.
Je vous souhaite du succès !
Ps. Au départ, il était prévu d'utiliser une base de données PostgreSQL locale, mais compte tenu de mon amour pour AWS, j'ai décidé d'externaliser la base de données dans le cloud. Dans le prochain article sur ce sujet, je montrerai comment réaliser l'ensemble du système décrit ci-dessus dans AWS en utilisant AWS Kinesis et AWS EMR. Restez à l'écoute !
Source : habr.com
