

En 2017, nous avons remporté un appel d'offres pour le développement du noyau transactionnel de l'activité d'investissement de Alfa-Bank et avons commencé notre travail (à HighLoad++ 2018, avec une présentation sur le noyau d'investissement). Vladimir Dryinkin, responsable du noyau transactionnel de l'activité d'investissement de Alfa-Bank). Ce système devait agréger des données sur les transactions provenant de différentes sources dans divers formats, unifier ces données, les stocker et en assurer l'accès.
Au cours du développement, le système a évolué et s'est enrichi de fonctionnalités, et à un moment donné, nous avons compris que nous cristalisation quelque chose de beaucoup plus grand qu'un simple logiciel applicatif conçu pour résoudre un ensemble précis de tâches : nous avons créé un système pour construire des applications distribuées avec un stockage persistant.. L'expérience que nous en avons tirée a servi de base à un nouveau produit — (TDG).
Je veux vous parler de l'architecture de TDG et des solutions que nous avons trouvées au cours du développement, vous familiariser avec les fonctionnalités principales et vous montrer comment notre produit peut servir de base pour la création de solutions complètes.
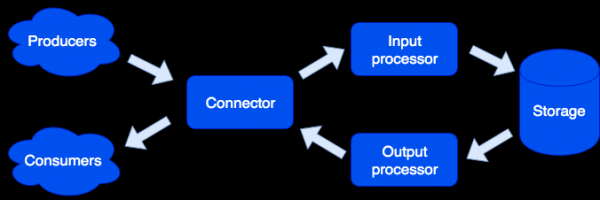
Architecturalement, nous avons divisé le système en modules distincts, rôles, chacun d'eux étant responsable du traitement d'une certaine catégorie de tâches. Une instance d'application exécutée peut réaliser un ou plusieurs types de rôles. Il peut y avoir plusieurs rôles du même type dans un cluster :
Connecteur
Le connecteur est responsable de la connexion avec le monde extérieur ; sa tâche consiste à recevoir une requête, à l'analyser et, si cela réussit, à envoyer les données à l'input processor pour traitement. Nous supportons les formats HTTP, SOAP, Kafka et FIX. L'architecture permet d'ajouter facilement le support de nouveaux formats, le support d'IBM MQ arrivera bientôt. Si l'analyse de la requête échoue, le connecteur renverra une erreur ; en revanche, s'il réussit, il indiquera que la requête a été traitée avec succès, même s'il y a eu une erreur lors de son traitement ultérieur. Cela a été fait spécialement pour travailler avec des systèmes qui ne peuvent pas renvoyer des requêtes – ou, au contraire, qui le font de manière trop insistante. Pour éviter de perdre des données, une file d'attente de réparation est utilisée : l'objet y entre d'abord et ne sera supprimé qu'après un traitement réussi. L'administrateur peut recevoir des notifications sur les objets restant dans la file d'attente de réparation, et après avoir corrigé un bogue logiciel ou un problème matériel, il peut réessayer.
Input processor
L'input processor classifie les données reçues en fonction de caractéristiques distinctives et appelle les gestionnaires appropriés. Les gestionnaires sont des codes en langage Lua, exécutés dans un bac à sable, ce qui signifie qu'ils ne peuvent pas affecter le fonctionnement du système. À ce stade, les données peuvent être mises au format requis et, si nécessaire, un nombre arbitraire de tâches peut être lancé pour mettre en œuvre la logique nécessaire. Par exemple, dans le produit MDM (Master Data Management), construit sur le Tarantool Data Grid, lors de l'ajout d'un nouvel utilisateur, nous lançons la création d'un enregistrement principal dans une tâche distincte pour ne pas ralentir le traitement de la requête. Le bac à sable prend en charge les requêtes de lecture, de modification et d'ajout de données, et permet d'exécuter une fonction sur tous les rôles de type stockage et d'agréger le résultat (map/reduce).
Les gestionnaires peuvent être décrits dans des fichiers :
sum.lua

local x, y = unpack(...)
return x + y
Et ensuite, déclarés dans la configuration :
functions:
  sum: { __file: sum.lua }
Pourquoi Lua ? Lua est un langage très simple. D'après notre expérience, quelques heures après avoir découvert ce langage, les gens commencent à écrire du code pour résoudre leur problème. Et ce ne sont pas seulement des développeurs professionnels, mais aussi des analystes par exemple. De plus, grâce au compilateur JIT, Lua fonctionne très rapidement.
Stockage
Le stockage conserve des données persistantes. Avant de les sauvegarder, les données sont validées par rapport au schéma de données. Pour décrire le schéma, nous utilisons un format étendu. . Exemple :
{
    "name": "User",
    "type": "record",
    "logicalType": "Aggregate",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "first_name", "type": "string"},
        {"name": "last_name", "type": "string"}
    ],
    "indexes": ["id"]
}
À partir de cette description, une DDL (Data Definition Language) est générée automatiquement pour la base de données Tarantool et un schéma pour l'accès aux données.
La réplication asynchrone des données est prise en charge (des plans pour une réplication synchrone sont en cours).
Output processor
Parfois, il est nécessaire d'informer des consommateurs externes de l'arrivée de nouvelles données, c'est pourquoi il existe un rôle d'Output processor. Après la sauvegarde des données, celles-ci peuvent être transmises à leur gestionnaire respectif (par exemple, pour les formater comme l'exige le consommateur) — puis transmises au connector pour l'envoi. Ici aussi, une file d'attente de réparation est utilisée : si personne n'a accepté l'objet, l'administrateur peut réessayer plus tard.
Mise à l’échelle
Les rôles de connector, input processor et output processor sont sans état, ce qui nous permet de mettre à l'échelle le système horizontalement, en ajoutant simplement de nouvelles instances de l'application avec le rôle du type désiré. Pour la mise à l'échelle horizontale, le stockage utilise d'organisation du cluster utilisant des seaux virtuels. Après l'ajout d'un nouveau serveur, une partie des seaux des anciens serveurs est transférée en arrière-plan vers le nouveau serveur ; cela se fait de manière transparente pour les utilisateurs et n'affecte pas le bon fonctionnement du système dans son ensemble.
Propriétés des données
Les objets peuvent être très volumineux et contenir d'autres objets. Nous garantissons l'atomicité de l'ajout et de la mise à jour des données, en sauvegardant un objet avec toutes ses dépendances dans un seul seau virtuel. Cela élimine le "problème de dispersion" de l'objet sur plusieurs serveurs physiques.
La versionnage est pris en charge : chaque mise à jour d'un objet crée une nouvelle version, et nous pouvons toujours prendre une capture temporaire pour voir à quoi ressemblait le monde à l'époque. Pour les données qui n'ont pas besoin d'une longue histoire, nous pouvons limiter le nombre de versions ou même ne conserver qu'une seule — la dernière — ce qui désactive en fait le versionnage pour un certain type. Il est également possible de limiter l'historique dans le temps : par exemple, supprimer tous les objets d'un certain type datant de plus de 1 an. L'archivage est également pris en charge : nous pouvons exporter des objets dépassant un certain temps, libérant ainsi de l'espace dans le cluster.
Objectifs
Parmi les fonctionnalités intéressantes, on peut noter la possibilité de lancer des tâches selon un calendrier, à la demande de l'utilisateur ou programmé depuis le bac à sable :
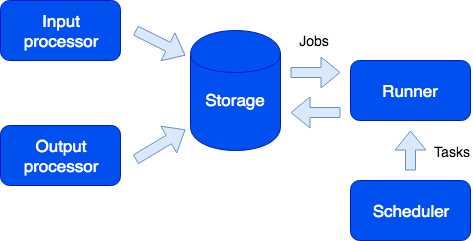
Ici, nous voyons un autre rôle — runner. Ce rôle est sans état, et si besoin, des instances supplémentaires de l'application avec ce rôle peuvent être ajoutées au cluster. La responsabilité du runner est d'exécuter des tâches. Comme mentionné, depuis le bac à sable, il est possible de créer de nouvelles tâches ; elles sont enregistrées dans la file d'attente sur le stockage et ensuite exécutées sur le runner. Ce type de tâche est appelé Job. Nous avons aussi un type de tâches, appelé Task — ce sont des tâches définies par l'utilisateur et lancées selon un calendrier (la syntaxe cron est utilisée) ou à la demande. Pour démarrer et suivre ces tâches, nous avons un gestionnaire de tâches pratique. Pour que cette fonctionnalité soit accessible, il est nécessaire d'activer le rôle scheduler ; ce rôle a un état, donc il n'est pas évolutif, ce qui n'est cependant pas nécessaire ; il peut, comme tous les autres rôles, avoir une réplique qui commence à fonctionner si le maître échoue soudainement.
Logger
Un autre rôle s'appelle logger. Il collecte les journaux de tous les membres du cluster et fournit une interface pour les exporter et les visualiser via une interface web.
Services
Il convient de mentionner que le système permet de créer facilement des services. Dans le fichier de configuration, on peut indiquer quelles requêtes diriger vers le gestionnaire développé par l'utilisateur, exécuté dans le bac à sable. Dans ce gestionnaire, par exemple, il est possible d'effectuer une requête analytique et de renvoyer le résultat.
Le service est décrit dans le fichier de configuration :
services:
   sum:
      doc: "ajoute deux nombres"
      function: sum
      return_type: int
      args:
         x: int
         y: int
L'API GraphQL est généré automatiquement et le service devient accessible pour l'appel :
query {
   sum(x: 1, y: 2)
}
Cela entraînera l'appel du gestionnaire sum, qui renverra le résultat :
3
Profilage des requêtes et métriques
Pour comprendre le fonctionnement du système et profiler les requêtes, nous avons implémenté le support du protocole OpenTracing. Le système peut, à la demande, envoyer des informations aux outils qui prennent en charge ce protocole, comme Zipkin, permettant de comprendre comment la requête a été exécutée :
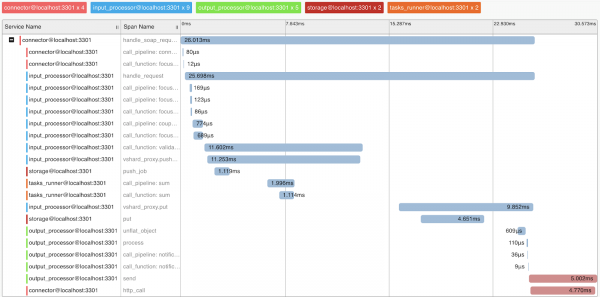
Naturellement, le système fournit des métriques internes qui peuvent être collectées avec Prometheus et visualisées avec Grafana.
Déployer
Tarantool Data Grid peut être déployé à partir de paquets RPM ou d'une archive, en utilisant l'outil fourni ou Ansible, avec également un support pour Kubernetes ().
L'application implémentant la logique métier (configuration, gestionnaires) est chargée dans le cluster Tarantool Data Grid déployé sous forme d'archive via l'interface utilisateur ou à l'aide d'un script, via l'API que nous fournissons.
Exemples d'applications
Quelles applications peuvent être créées avec Tarantool Data Grid ? En réalité, la plupart des tâches commerciales sont liées au traitement de flux de données, au stockage et à l'accès à celles-ci. Ainsi, si vous avez de grands flux de données qui doivent être stockés de manière fiable et rendus accessibles, notre produit peut vous faire gagner beaucoup de temps en développement et vous permettre de vous concentrer sur votre logique métier.
Par exemple, nous souhaitons collecter des informations sur le marché immobilier, afin d'avoir ultérieurement des informations sur les offres les plus avantageuses. Dans ce cas, nous définirons les tâches suivantes :
- Les robots collectant des informations à partir de sources ouvertes seront nos sources de données. Vous pouvez résoudre cette tâche en utilisant des solutions prêtes à l'emploi ou en écrivant du code dans n'importe quel langage.
- Ensuite, Tarantool Data Grid acceptera et stockera les données. Si le format des données provenant de différentes sources diffère, vous pouvez écrire du code en Lua qui effectuera la conversion au format uniforme. À l'étape de prétraitement, vous pourrez également, par exemple, filtrer les offres en double ou mettre à jour les informations sur les agents opérant sur le marché dans la base de données.
- Vous disposez désormais d'une solution évolutive dans un cluster, que vous pouvez alimenter en données et interroger. Par la suite, vous pouvez mettre en œuvre de nouvelles fonctionnalités, par exemple, écrire un service qui interroge les données et fournit l'offre la plus avantageuse sur une période de 24 heures — cela nécessitera quelques lignes dans le fichier de configuration et un peu de code en Lua.
Et après ?
Nous accordons la priorité à améliorer la commodité du développement grâce à . Par exemple, il s'agit d'une IDE avec support du profilage et du débogage des gestionnaires fonctionnant dans un environnement sandbox.
Nous attachons également une grande importance aux questions de sécurité. En ce moment, nous sommes en train de passer la certification du FSTEC de Russie pour confirmer un niveau de sécurité élevé et répondre aux exigences en matière de certification des produits logiciels utilisés dans les systèmes d'information des données personnelles et dans les systèmes d'information gouvernementaux.
Source : habr.com
