

Le CDSM est terminé, mais le désir incontrôlé d'écrire reste.
Pendant de nombreuses années, notre frère a souffert de l'exécution de tâches routinières, croisant les doigts avant chaque commit et manquant de sommeil à cause des rollbacks nocturnes.
Mais les temps sombres touchent à leur fin.
Avec cet article, je commencerai une série sur comment moi l'automatisation est envisagée.
Nous allons explorer les étapes de l'automatisation, le stockage des variables, la formalisation du design, avec RestAPI, NETCONF, YANG, YDK et nous allons beaucoup programmer.
Pour moi, cela signifie que a) ce n'est pas une vérité objective, b) ce n'est pas nécessairement la meilleure approche, et c) mon point de vue même au fil de la progression de l'article peut changer — honnêtement, depuis la phase de brouillon jusqu'à la publication, j'ai réécrit tout deux fois.
Contenu
- Objectifs
- Le réseau — comme un organisme unique.
- Test de configuration.
- Versioning.
- Surveillance et auto-récupération des services.
- Outils
- Système d'inventaire.
- Système de gestion de l'espace IP.
- Système de description des services réseau.
- Mécanisme d'initialisation des dispositifs.
- Modèle de configuration indépendant du fournisseur.
- Interface spécifique au fournisseur driver.
- Mécanisme de livraison de la configuration au dispositif.
- CI/CD
- Mécanisme de sauvegarde et de recherche des écarts.
- Système de surveillance.
- Conclusion
Je vais essayer de mener l'ADSM dans un format légèrement différent du CDSM. De longs articles détaillés continueront à apparaître, et entre eux, je publierai de courtes notes de mon expérience quotidienne. J'essaierai ici de lutter contre le perfectionnisme et de ne pas peaufiner chacune d'elles.
C'est amusant que, pour la seconde fois, je doive suivre le même chemin.
Au début, j'ai dû écrire moi-même des articles sur les réseaux car il n'y en avait pas dans le Runet.
Maintenant, je n'arrive pas à trouver un document complet qui systématise les approches d'automatisation et examine les technologies mentionnées précédemment avec des exemples pratiques simples.
Peut-être que je me trompe, alors n'hésitez pas à m'envoyer des liens vers des ressources utiles. Cependant, cela ne changera pas ma volonté d'écrire, car l'objectif principal est d'apprendre quelque chose par moi-même, et faciliter la vie des autres est un agréable bonus qui stimule la diffusion de l'expérience.
Nous allons essayer de prendre un centre de données LAN DC de taille moyenne et de travailler sur l'ensemble du schéma d'automatisation.
Je vais faire certaines choses pratiquement pour la première fois avec vous.
Dans les idées et outils décrits ici, je ne vais pas être original. Dmitry Figol a une excellente .
Les articles vont se chevaucher sur de nombreux aspects.
Dans le LAN DC, il y a 4 DC, environ 250 switches, une demi-douzaine de routeurs et quelques pare-feu.
Ce n'est pas Facebook, mais c'est suffisant pour réfléchir profondément à l'automatisation.
Il est dit, cependant, que si vous avez plus d'un appareil, l'automatisation est déjà nécessaire.
Il est en fait difficile d'imaginer que quelqu'un puisse vivre actuellement sans au moins une série de scripts de base.
Bien que j'aie entendu dire qu'il existe des entreprises où la gestion des adresses IP est faite dans Excel, et chaque appareil réseau parmi des milliers est configuré manuellement avec sa propre configuration unique. Cela peut évidemment être présenté comme un art contemporain, mais les sentiments d'un ingénieur en seront certainement blessés.
Objectifs
Nous allons maintenant établir des objectifs aussi abstraits que possible :
- Le réseau — comme un organisme unique.
- Test de configuration.
- Versioning de l'état du réseau
- Surveillance et auto-récupération des services.
Plus tard dans cet article, nous analyserons les outils que nous allons utiliser, et dans les prochains articles, nous aborderons en détail les objectifs et les outils.
Le réseau — comme un organisme unique.
Une phrase clé du cycle, bien qu'elle puisse sembler insignifiante au premier abord : nous allons configurer le réseau, et non des appareils individuels.
Ces dernières années, nous avons observé un changement d'accent vers la gestion du réseau en tant qu'entité unique, d'où l'émergence de Réseautage Défini par Logiciel, Intent Driven Networks et Autonomous Networks.
Après tout, ce dont les applications ont besoin de manière globale du réseau : connectivité entre les points A et B (et parfois +B-Y) et isolation des autres applications et utilisateurs.
Ainsi, notre tâche dans cette série est de construire un système, soutenant la configuration actuelle de tout le réseau, qui se décompose déjà en configuration active sur chaque appareil selon son rôle et son emplacement.
Le système La gestion du réseau implique que pour effectuer des changements, nous nous y adressons, et elle, à son tour, calcule l'état requis pour chaque appareil et le configure.
Ainsi, nous minimisons presque à zéro l'utilisation manuelle du CLI — tout changement dans les configurations ou la conception du réseau doit être formalisé et documenté — et ce n'est qu'ensuite qu'il peut être déployé sur les éléments nécessaires du réseau.
Par exemple, si nous avons décidé qu'à partir de maintenant, les commutateurs de châssis à Kazan doivent annoncer deux réseaux au lieu d'un, nous
- Nous documentons d'abord les modifications dans les systèmes
- Nous générons la configuration cible de tous les dispositifs du réseau
- Nous lançons le programme de mise à jour de la configuration du réseau, qui calcule ce qu'il faut supprimer sur chaque nœud, ce qu'il faut ajouter, et amène les nœuds à l'état souhaité.
En procédez manuellement, nous apportons des modifications uniquement à la première étape.
Test de configuration.
, que 80 % des problèmes surviennent lors des changements de configuration - le fait que pendant les vacances de fin d'année, tout est généralement calme est une preuve indirecte.
J'ai personnellement été témoin de dizaines de pannes globales dues à une erreur humaine : une mauvaise commande, une exécution dans le mauvais branche de configuration, un oubli de la communauté, un effacement global de l'MPLS sur le routeur, cinq appareils configurés, et une erreur non remarquée sur le sixième, des anciennes modifications commises par une autre personne. Les scénarios sont innombrables.
L'automatisation nous permettra de commettre moins d'erreurs, mais à une échelle plus grande. Ainsi, on peut brique un seul appareil, mais toute le réseau d'un coup.
Depuis des temps immémoriaux, nos ancêtres vérifiaient l'exactitude des modifications apportées avec un œil acéré, des parties métalliques et la fonctionnalité du réseau après leur déploiement.
Ces ancêtres, dont le travail entraînait des temps d'arrêt et des pertes catastrophiques, laissaient moins de descendants et devaient disparaître avec le temps, mais l'évolution est un processus lent, c'est pourquoi jusqu'à présent, tous ne vérifient pas les modifications au préalable dans un laboratoire.
Cependant, à la pointe du progrès se trouvent ceux qui ont automatisé le processus de test des configurations et leur application ultérieure sur le réseau. En d'autres termes, ils ont emprunté la procédure CI/CD () chez les développeurs.
Dans l'une des parties, nous examinerons comment cela peut être réalisé à l'aide d'un système de contrôle de version, probablement GitHub.
Dès que vous vous habituez à l'idée de CI/CD réseau, la méthode de vérification de la configuration par son application sur un réseau de travail vous semblera tout à coup comme une ignorance du haut Moyen Âge. Un peu comme frapper un missile nucléaire avec un marteau.
L'évolution organique des idées sur système la gestion du réseau et CI/CD devient un véritable versionnage de la configuration.
Versioning.
Nous considérerons qu'à chaque changement, même les plus infimes, même sur un appareil inconnu, l'ensemble du réseau passe d'un état à un autre.
Et nous n'exécutons jamais la commande sur l'appareil, nous changeons l'état du réseau.
Appelons ces états des versions.
Supposons que la version actuelle soit 1.0.0.
L'adresse IP de l'interface Loopback a changé sur l'un des ToR ? C'est une version mineure — elle obtiendra le numéro 1.0.1.
Les politiques d'importation de routes dans BGP ont été révisées — un peu plus sérieux — déjà 1.1.0.
Nous avons décidé de nous débarrasser de l'IGP et de passer seulement au BGP — c'est déjà un changement de conception radical — 2.0.0.
Cependant, différents DC peuvent avoir des versions différentes — le réseau évolue, de nouveaux équipements sont installés, de nouveaux niveaux de spine sont ajoutés par endroits, et pas ailleurs, etc.
À propos de nous en parlerons dans un article séparé.
Je répète — tout changement (sauf les commandes de débogage) constitue une mise à jour de version. Les administrateurs doivent être informés de tout écart par rapport à la version actuelle.
Il en va de même pour le retour en arrière des changements — ce n'est pas l'annulation des dernières commandes, ce n'est pas un rollback par les moyens du système d'exploitation de l'appareil — c'est ramener tout le réseau à une nouvelle (ancienne) version.
Surveillance et auto-récupération des services.
C'est une tâche évidente qui atteint un nouveau niveau dans les réseaux modernes.
Souvent, chez les grands fournisseurs de services, il est courant que lorsque le service tombe, il faille le recréer rapidement et en déployer un nouveau, plutôt que de s'attarder sur ce qui s'est passé.
« Rapidement » signifie qu'il faut se couvrir abondamment de supervisons, qui découvriront en quelques secondes les moindres écarts par rapport à la normale.
Et ici, les métriques habituelles, telles que l'utilisation de l'interface ou la disponibilité d'un nœud, ne suffisent pas. Le suivi manuel d'un surveillant ne suffit pas non plus.
Pour de nombreuses choses, il doit y avoir un — les systèmes de monitoring s'allument en rouge et vont automatiquement appliquer des solutions là où ça fait mal.
Et ici, nous surveillons également non seulement des appareils individuels, mais aussi la santé globale du réseau, tant en white-box, ce qui est relativement clair, qu'en black-box, ce qui est déjà plus complexe.
De quoi avons-nous besoin pour mettre en œuvre de tels plans ambitieux ?
- Avoir une liste de tous les appareils dans le réseau, leur emplacement, leurs rôles, modèles, versions logicielles.
kazan-leaf-1.lmu.net, Kazan, leaf, Juniper QFX 5120, R18.3. - Avoir un système de description des services réseau.
IGP, BGP, L2/3VPN, Policy, ACL, NTP, SSH. - Savoir initialiser un appareil.
Nom d'hôte, IP de gestion, Route de gestion, Utilisateurs, Clés RSA, LLDP, NETCONF - Configurer l'appareil et ramener la configuration à la version souhaitée (y compris une ancienne version).
- Tester la configuration
- Vérifier régulièrement l'état de tous les appareils pour détecter toute déviation par rapport à l'actuel et informer les personnes concernées.
La nuit, quelqu'un a discrètement ajouté une règle dans l'ACL.. - Surveiller le bon fonctionnement.
Outils
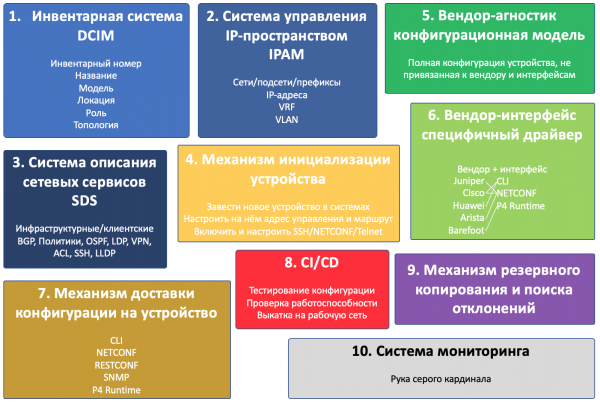
Cela semble assez complexe pour commencer à décomposer le projet en composants.
Et il y en aura dix :
- Système d'inventaire.
- Système de gestion de l'espace IP.
- Système de description des services réseau.
- Mécanisme d'initialisation des dispositifs.
- Modèle de configuration indépendant du fournisseur.
- Interface spécifique au fournisseur driver.
- Mécanisme de livraison de la configuration au dispositif.
- CI/CD
- Mécanisme de sauvegarde et de recherche des écarts.
- Système de surveillance.
Ceci est d'ailleurs un exemple de la façon dont la vision des objectifs du cycle a évolué - dans le brouillon des composants, il y avait 4.
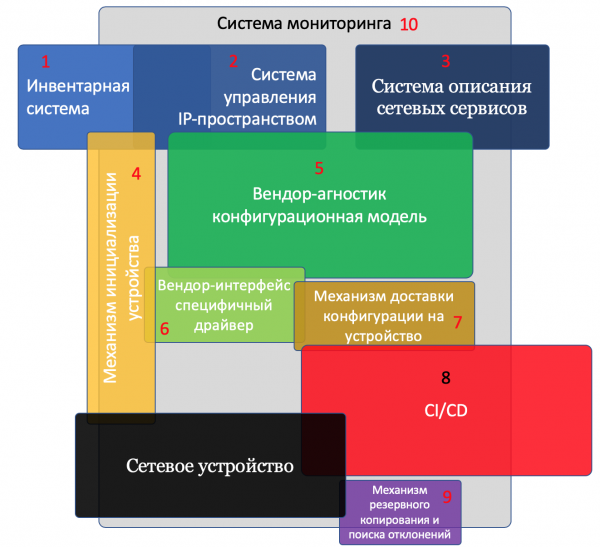
Sur l'illustration, j'ai représenté tous les composants et l'appareil lui-même.
Les composants chevauchants interagissent les uns avec les autres.
Plus le bloc est important, plus il faut prêter attention à ce composant.
Composant 1. Système d'inventaire
Évidemment, nous voulons savoir quel équipement se trouve où, et à quoi il est connecté.
Le système d'inventaire est une partie intégrante de toute entreprise.
Le plus souvent, pour les appareils réseau, l'entreprise a un système d'inventaire distinct qui répond à des besoins plus spécifiques.
Dans le cadre de cette série d'articles, nous l'appellerons DCIM - Gestion de l'infrastructure des centres de données. Bien que le terme DCIM, à proprement parler, englobe bien plus.
Pour nos besoins, nous y stockerons les informations suivantes sur l'appareil :
- Numéro d'inventaire
- Nom/description
- Modèle (Huawei CE12800, Juniper QFX5120, etc.)
- Paramètres caractéristiques (cartes, interfaces, etc.)
- Rôle (Leaf, Spine, Routeur de frontière, etc.)
- Localisation (région, ville, centre de données, rack, unité)
- Interconnexions entre appareils
- Topologie réseau
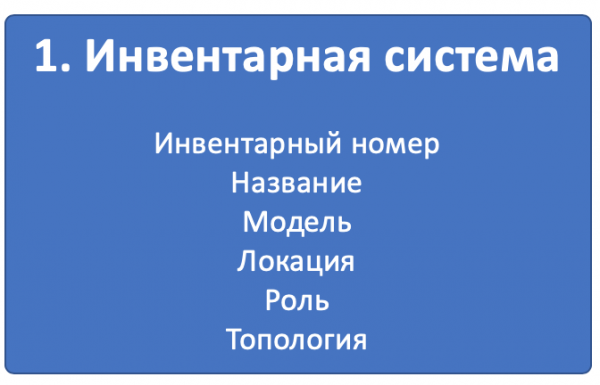
Il est parfaitement clair que nous voulons nous-même connaître tout cela.
Mais cela aidera-t-il dans un but d'automatisation ?
Absolument.
Par exemple, nous savons que dans ce centre de données sur les commutateurs Leaf, s'il s'agit de Huawei, les ACL pour filtrer un certain trafic doivent être appliquées sur VLAN, et si c'est Juniper, alors sur l'unité 0 de l'interface physique.
Ou devons-nous déployer un nouveau serveur Syslog sur toutes les frontières de la région.
Nous y stockerons également des appareils réseau virtuels, comme des routeurs virtuels ou des routeurs-reflecteurs. Nous pouvons ajouter des serveurs DNS, NTP, Syslog et en général tout ce qui concerne le réseau.
Composant 2. Système de gestion de l'espace IP
Oui, même aujourd'hui, il existe des groupes de personnes qui enregistrent les préfixes et les adresses IP dans un fichier Excel. Mais l'approche moderne consiste plutôt en une base de données, avec un front-end sur nginx/apache, une API et des fonctionnalités étendues pour la gestion des adresses IP et des réseaux avec une séparation par VRF.
IPAM — Gestion des adresses IP.
Pour nos besoins, nous allons stocker les informations suivantes :
- VLAN
- VRF
- Réseaux/Sous-réseaux
- adresses IP
- Association des adresses aux dispositifs, des réseaux aux emplacements et aux numéros VLAN
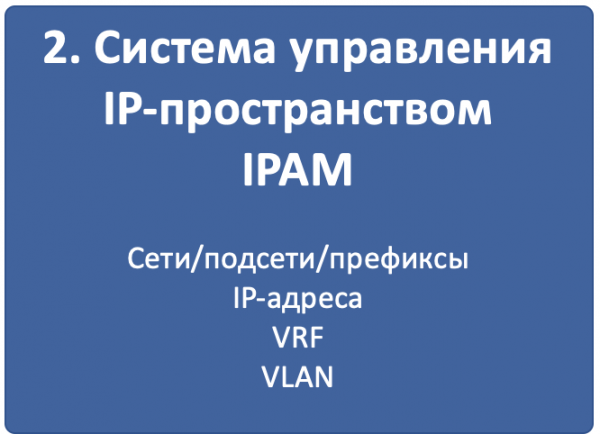
Il est évident que nous voulons nous assurer qu'en attribuant une nouvelle adresse IP pour le loopback du ToR, nous ne trébucherons pas sur le fait qu'elle ait déjà été assignée à quelqu'un. Ou que le même préfixe ait été utilisé deux fois à des extrémités différentes du réseau.
Mais comment cela aidera-t-il à l'automatisation ?
Facile.
Nous demandons dans le système le préfixe avec le rôle de Loopbacks, dans lequel il y a des adresses IP disponibles pour attribution — si trouvé, nous attribuons l'adresse, sinon, nous demandons la création d'un nouveau préfixe.
Ou lors de la création de la configuration d'un appareil, nous pouvons apprendre depuis ce même système dans quel VRF doit se trouver l'interface.
Et lors du démarrage d'un nouveau serveur, un script interroge le système, découvre dans quel switch de serveur, dans quel port et quel sous-réseau est attribué à l'interface — c'est de là que l'adresse du serveur sera attribuée.
Nous souhaitons réunir DCIM et IPAM en un seul système pour éviter de dupliquer des fonctions et de gérer deux entités similaires.
C'est ce que nous allons faire.
Composant 3. Système de description des services réseau
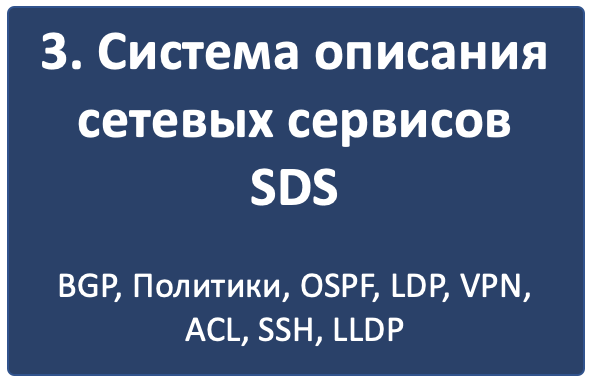
Alors que les deux premiers systèmes stockent des variables qui doivent encore être utilisées d'une certaine manière, le troisième décrit pour chaque rôle d'appareil comment il doit être configuré.
Il convient de distinguer deux types différents de services réseau :
- Infrastructure
- Client.
Les premiers visent à assurer la connectivité de base et la gestion de l'appareil. Cela inclut VTY, SNMP, NTP, Syslog, AAA, protocoles de routage, CoPP, etc.
Les seconds organisent des services pour le client : MPLS L2/L3VPN, GRE, VXLAN, VLAN, L2TP, etc.
Bien sûr, il y a aussi des cas limites — où classer MPLS LDP, BGP ? Et les protocoles de routage peuvent également être utilisés par les clients. Mais ce n'est pas essentiel.
Les deux types de services sont décomposés en primitives de configuration :
- interfaces physiques et logiques (tag/untag, mtu)
- adresses IP et VRF (IP, IPv6, VRF)
- ACL et politiques de traitement du trafic
- Protocoles (IGP, BGP, MPLS)
- Politiques de routage (listes de préfixes, communautés, filtres ASN).
- Services auxiliaires (SSH, NTP, LLDP, Syslog…)
- Etc.
Comment nous allons procéder, je n'en ai pas encore la moindre idée. Nous en discuterons dans un article séparé.
Pour être un peu plus concret, nous pourrions décrire que
Un commutateur Leaf doit avoir des sessions BGP avec tous les commutateurs Spine connectés, importer dans le processus les réseaux connectés et accepter uniquement les réseaux d'un certain préfixe des commutateurs Spine. Limiter CoPP IPv6 ND à 10 pps, etc.
En revanche, les Spine maintiennent des sessions avec tous les Leaf connectés, agissant comme des routeurs réfléchissants, et n'acceptent d'eux que des routes d'une certaine longueur et avec une certaine communauté.
Composant 4. Mécanisme d'initialisation de l'appareil
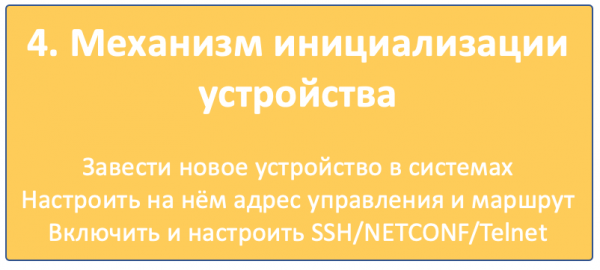
Sous ce titre, je regroupe de nombreuses actions qui doivent avoir lieu pour que l'appareil apparaisse sur les radars et puisse être accédé à distance.
- Enregistrer l'appareil dans le système d'inventaire.
- Attribuer une adresse IP de gestion.
- Configurer l'accès de base à celui-ci :
Nom d'hôte, adresse IP de gestion, route vers le réseau de gestion, utilisateurs, clés SSH, protocoles — telnet/SSH/NETCONF
Il existe trois approches :
- Tout faire manuellement. L'appareil est amené sur le stand, où une personne ordinaire l'enregistrera dans les systèmes, se connectera par console et le configurera. Cela peut fonctionner sur de petits réseaux statiques.
- ZTP — Zero Touch Provisioning. Le matériel est arrivé, s'est installé, a obtenu une adresse via DHCP, est allé sur un serveur spécial et s'est configuré tout seul.
- Infrastructure de serveurs de console, où la configuration initiale se fait automatiquement via le port console.
Nous parlerons de ces trois approches dans un article séparé.
Composant 5. Modèle de configuration agnostique vis-à-vis du fournisseur
Jusqu'à présent, tous les systèmes étaient des morceaux épars, donnant une description variable et déclarative de ce que nous aimerions voir dans le réseau. Mais tôt ou tard, il faudra faire face à la réalité.
À ce stade, pour chaque appareil spécifique, les primitives, services et variables sont combinés en un modèle de configuration, décrivant en fait la configuration complète d'un appareil spécifique, mais de manière indépendante du fournisseur.
Quel est l'avantage de cette étape ? Pourquoi ne pas simplement générer la configuration de l'appareil que l'on pourrait télécharger immédiatement ?
En fait, cela permet de résoudre trois problèmes :
- Ne pas s'adapter à une interface d'interaction spécifique avec le dispositif. Que ce soit CLI, NETCONF, RESTCONF, SNMP, le modèle sera le même.
- Ne pas maintenir le nombre de templates/scripts égal au nombre de fournisseurs dans le réseau, et en cas de changement de design, modifier la même chose à plusieurs endroits.
- Charger la configuration depuis le dispositif (sauvegarde), la décomposer dans un modèle identique et comparer directement la configuration cible et celle existante pour calculer la différence et préparer un patch de configuration qui modifiera uniquement les parties nécessaires ou pour détecter des écarts.
À l'issue de cette étape, nous obtenons une configuration indépendante du fournisseur.
Composant 6. Pilote d'interface spécifique au fournisseur
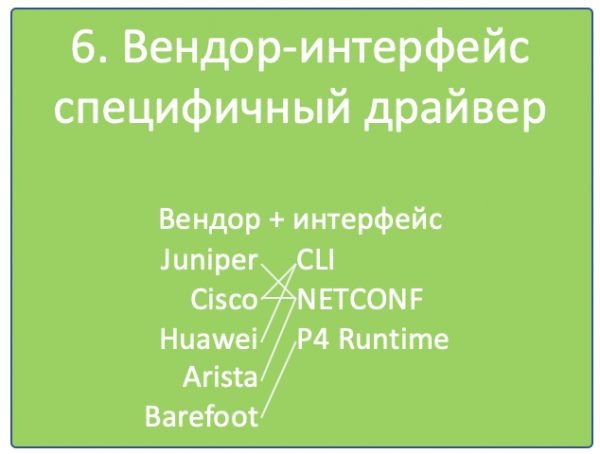
Il ne faut pas se laisser illusionner par l'idée qu'il sera un jour possible de configurer un Cisco de la même manière qu'un Juniper, simplement en leur envoyant des appels exactement identiques. Malgré la montée en popularité des whiteboxes et l'apparition du soutien NETCONF, RESTCONF, OpenConfig, le contenu concret fourni par ces protocoles diffère d'un fournisseur à l'autre, et c'est l'une de leurs distinctions concurrentielles, qu'ils ne céderont pas facilement.
C'est à peu près comme OpenContrail et OpenStack, qui ayant REST API comme leur interface NorthBound, attendent des appels complètement différents.
Ainsi, à la cinquième étape, le modèle indépendant du fournisseur doit prendre la forme dans laquelle il sera envoyé sur le matériel.
Et ici, tous les moyens sont bons (non) : CLI, NETCONF, RESTCONF, SNMP…
Nous aurons donc besoin d'un pilote qui traduira le résultat de l'étape précédente au format requis par le fournisseur spécifique : ensemble de commandes CLI, structure XML.
Composant 7. Mécanisme de livraison de la configuration sur le dispositif
Nous avons généré la configuration, mais il faut encore la livrer aux dispositifs — et, évidemment, pas manuellement.
Tout d'abord, la question se pose alors, quel transport allons-nous utiliser ? Et aujourd'hui, le choix n'est déjà pas négligeable :
- CLI (telnet, ssh)
- SNMP
- NETCONF
- RESTCONF
- API REST
- OpenFlow (bien qu'il soit déplacé de la liste puisqu'il s'agit d'un moyen de livrer le FIB, et non des configurations)
Mettons ici les choses au clair. CLI — c'est du legacy. SNMP... euh.
RESTCONF — encore un animal mystérieux, l'API REST n'est presque pas supportée. C'est pourquoi nous allons nous concentrer en boucle sur NETCONF.
En réalité, comme le lecteur l'a déjà compris, nous avons déjà défini l'interface à ce stade — le résultat de l'étape précédente est déjà présenté au format de l'interface choisie.
Deuxièmement, mais quels outils allons-nous utiliser pour cela ?
Ici, le choix est également vaste :
- Un script fait maison ou une plateforme. Armons-nous de ncclient et d'asyncIO et faisons-le nous-mêmes. Qu'est-ce qui nous empêche de construire un système de déploiement à partir de zéro ?
- Ansible avec sa riche bibliothèque de modules réseau.
- Salt avec son travail limité sur les réseaux et son intégration avec Napalm.
- Napalm lui-même, qui connaît quelques fournisseurs et c'est tout, au revoir.
- Nornir — un autre petit outil que nous disséquerons plus tard.
Ici, le favori n'est pas encore choisi — nous allons expérimenter.
Qu'est-ce qui est important ici ? Les conséquences de l'application de la configuration.
Avec succès ou non. L'accès au matériel est-il maintenu ou non ?
Il semble qu'un commit avec confirmation et validation de ce qui a été chargé sur l'appareil pourrait aider.
Ceci, combiné à une mise en œuvre correcte de NETCONF, réduit considérablement le nombre d'appareils compatibles — les commits normaux ne sont pas supportés par beaucoup de fabricants. Mais c'est juste une des conditions requises dans . Après tout, personne ne s'inquiète du fait qu'aucun fournisseur russe ne répondra aux exigences de l'interface 32*100GE. Ou s'inquiète-t-il ?
Composant 8. CI/CD
À ce stade, nous avons déjà une configuration prête pour tous les appareils du réseau.
J'écris « pour tous », car nous parlons de la version de l'état du réseau. Et même si nous devons changer les paramètres d'un seul commutateur, les modifications sont calculées pour l'ensemble du réseau. Évidemment, elles peuvent être nulles pour la majorité des nœuds.
Mais, comme déjà mentionné ci-dessus, nous ne sommes pas des barbares pour tout pousser directement en production.
La configuration générée doit d'abord passer par un Pipeline CI/CD.
CI/CD signifie Intégration Continue, Déploiement Continu. C'est une approche où l'équipe ne publie pas une nouvelle version majeure tous les six mois, remplaçant complètement l'ancienne, mais intègre régulièrement (Déploiement) de nouvelles fonctionnalités en petites portions, chacune étant complètement testée pour la compatibilité, la sécurité et la fonctionnalité (Intégration).
Pour cela, nous disposons d'un système de contrôle de version qui suit les modifications de la configuration, d'un laboratoire dans lequel nous vérifions que le service client ne tombe pas en panne, d'un système de surveillance qui vérifie ce fait, et la dernière étape consiste à déployer les modifications dans le réseau de production.
À l'exception des commandes de débogage, tous les changements sur le réseau doivent passer par le pipeline CI/CD — c'est notre garantie d'une vie tranquille et d'une carrière longue et heureuse.
Composant 9. Système de sauvegarde et de détection des anomalies
Il n'est pas nécessaire de parler trop des sauvegardes.
Nous allons simplement les enregistrer soit par cron, soit à la suite d'un changement de configuration dans git.
La deuxième partie est plus intéressante — quelqu'un doit surveiller ces sauvegardes. Dans certains cas, cette personne doit revenir en arrière et tout remettre comme c'était, tandis que dans d'autres, il faut alerter quelqu'un qu'il y a un problème.
Par exemple, si un nouvel utilisateur apparaît qui n'est pas inscrit dans les variables, il faut le supprimer au plus vite du hack. Et si une nouvelle règle de pare-feu est apparue, mieux vaut ne pas y toucher, quelqu'un a peut-être simplement activé le débogage, ou peut-être qu'un nouveau service, maladroit, a été mal configuré, alors que des utilisateurs l'utilisent déjà.
Nous ne pourrons de toute façon pas nous échapper d'un certain écart dans l'ensemble du réseau, malgré tous les systèmes d'automatisation et la main de fer de la direction. Pour déboguer des problèmes, personne ne modifiera la configuration dans les systèmes. D'autant plus que le modèle de configuration peut même ne pas le prévoir.
Par exemple, une règle de pare-feu pour compter le nombre de paquets à une certaine IP, pour localiser le problème — c'est une configuration temporaire tout à fait standard.
Composant 10. Système de surveillance
Au début, je ne prévoyais pas d'aborder le sujet de la surveillance — c'est un sujet complexe, volumineux et controversé. Mais au fil du récit, il est devenu évident que c'est une partie intégrante de l'automatisation. Et on ne peut tout simplement pas l'ignorer, même sans pratique.
En développant cette idée — c'est une partie organique du processus CI/CD. Après le déploiement de la configuration sur le réseau, nous devons être en mesure de déterminer si tout est en ordre.
Et il ne s'agit pas seulement de graphiques d'utilisation des interfaces ou de disponibilité des nœuds, mais aussi de choses plus subtiles — la présence des routes nécessaires, leurs attributs, le nombre de sessions BGP, de voisins OSPF, et la fonctionnalité de bout en bout des services qui en dépendent.
Les logs système ne cessent-ils pas d'être enregistrés sur le serveur externe, le SFlow agent ne s'est-il pas rompu, les pertes dans les files d'attente n'ont-elles pas commencé à augmenter, et la connectivité entre certaines paires de préfixes n'est-elle pas altérée ?
Dans un article séparé, nous réfléchirons également à cela.
Conclusion
J'ai choisi comme base l'un des designs modernes de réseau de data centers — L3 Clos Fabric avec BGP comme protocole de routage.
Nous construirons le réseau cette fois-ci sur Juniper, car l'interface JunOs est maintenant conviviale.
Nous compliquerons notre vie en utilisant uniquement des outils Open Source et un réseau multi-vendeurs — donc en plus de Juniper, je choisirai un autre heureux élu au fur et à mesure.
Le plan des prochaines publications est à peu près le suivant :
D'abord, je parlerai des réseaux virtuels. Premièrement, parce que cela m'intéresse, et deuxièmement, parce que sans cela, le design du réseau d'infrastructure ne sera pas très clair.
Ensuite, sur le design du réseau : topologie, routage, politiques.
Nous construirons un banc d'essai de laboratoire.
Nous réfléchirons et peut-être pratiquerons l'initialisation d'un appareil dans le réseau.
Et ensuite, chaque composant en détails intimes.
Et oui, je ne promets pas de finir ce cycle avec une solution élégante. 🙂
Liens utiles
- Avant de plonger dans la série, il vaut la peine de lire le livre de Natasha Samoylenko . Et peut-être même de suivre .
- Il sera également utile de lire sur le design des data centers de Facebook écrit par Petr Lapukhov.
- La documentation sur l'architecture vous donnera une idée de la façon dont fonctionne le SDN de type Overlay (anciennement Open Contrail).
Merci
Roman Gorge. Pour les commentaires et corrections.
Artyom Chernobai. Pour le KDPV.
Source : habr.com
