

Dans j'ai décrit le cadre d'automatisation réseau. D'après les retours, pour certaines personnes, cette première approche du problème a déjà clarifié certaines questions. Et cela me réjouit beaucoup, car notre objectif dans ce cycle n'est pas d'enrober Ansible de scripts Python, mais de construire un système.
Ce même cadre établit l'ordre dans lequel nous allons aborder la question.
Et la virtualisation réseau, à laquelle cet épisode est consacré, ne s'intègre pas vraiment dans la thématique de l'ADSM, où nous traitons l'automatisation.
Mais examinons cela sous un autre angle.
Depuis longtemps, de nombreux services utilisent un même réseau. Dans le cas d'un opérateur de télécommunications, cela comprend 2G, 3G, LTE, ADSL et B2B, par exemple. Dans le cas d'un centre de données : connectivité pour différents clients, Internet, stockage en bloc, stockage d'objets.
Et tous les services nécessitent une isolation mutuelle. C'est ainsi que sont apparus les réseaux overlay.
Et aucun service ne veut attendre qu'une personne les configure manuellement. C'est ainsi que sont nés les orchestrateurs et le SDN.
La première approche de l'automatisation systématique du réseau, ou plutôt d'une partie de celui-ci, a été entreprise depuis longtemps et a été mise en œuvre dans de nombreux endroits : VMWare, OpenStack, Google Compute Cloud, AWS, Facebook.
C'est ce que nous allons explorer aujourd'hui.
Contenu
- Raisons
- Terminologie
- Underlay — réseau physique
- Overlay — réseau virtuel
- Overlay depuis ToR
- Overlay depuis l'hôte
- À l'exemple de Tungsten Fabric
- Communication au sein d'une seule machine physique
- Communication entre des VM situées sur différentes machines physiques
- Sortie vers le monde extérieur
- FAQ
- Conclusion
- Liens utiles
Raisons
Et puisque nous en parlons, il convient de mentionner les prérequis à la virtualisation réseau. En réalité, ce processus a commencé depuis longtemps.
Vous avez probablement entendu dire que le réseau a toujours été la partie la plus inerte de tout système. Et c'est vrai à tous égards. Le réseau est la base sur laquelle tout repose, et apporter des modifications à celui-ci est relativement complexe : les services ne supportent pas que le réseau soit hors service. Souvent, la mise hors service d'un seul nœud peut affecter une grande partie des applications et toucher de nombreux clients. En partie pour cette raison, l'équipe réseau peut s'opposer à tout changement — car actuellement, cela fonctionne d'une certaine manière (nous ne savons peut-être même pas comment), et il faut maintenant configurer quelque chose de nouveau, sans savoir comment cela affectera le réseau.
Pour ne pas attendre que les techniciens réseau étendent le VLAN et pour éviter de configurer chaque service sur chaque nœud du réseau, les gens ont inventé l'utilisation de superpositions — réseaux superposés — qui se déclinent en une grande variété : GRE, IPinIP, MPLS, MPLS L2/L3VPN, VXLAN, GENEVE, MPLSoverUDP, MPLSoverGRE, etc.
Leur attrait réside dans deux choses simples :
- Seuls les nœuds finaux sont configurés — il n'est pas nécessaire de toucher aux nœuds de transit. Cela accélère considérablement le processus et permet parfois d'exclure complètement le département des infrastructures réseau lors de l'introduction de nouveaux services.
- La charge est dissimulée au sein des en-têtes — les nœuds de transit n'ont pas besoin d'en connaître la nature, l'adressage sur les hôtes, les routes du réseau superposé. Cela signifie qu'il est nécessaire de stocker moins d'informations dans les tables, ce qui permet d'utiliser un équipement plus simple et moins coûteux.
Dans ce numéro pas tout à fait complet, je ne prévois pas d'explorer toutes les technologies possibles, mais plutôt de décrire le cadre de fonctionnement des réseaux superposés dans un datacenter.
Toute la série décrira un datacenter composé de rangées de racks identiques, dans lesquels sont installés des équipements serveur identiques.
Sur cet équipement, des machines virtuelles/conteneurs/serveurs sans serveur fonctionnent, réalisant les services.
Terminologie
Dans ce cycle, serveur je désignerai le programme qui met en œuvre la partie serveur de la communication client-serveur.
Les machines physiques dans les racks seront appelées serveurs ne comme nous le ferons.
La machine physique est un ordinateur x86 installé dans un rack. Le terme le plus couramment utilisé est hôte. Nous l'appellerons «machine» ou hôte.
Hyperviseur une application fonctionnant sur une machine physique, émulant les ressources physiques sur lesquelles fonctionnent les Machines Virtuelles. Parfois, dans la littérature et sur Internet, le mot « hyperviseur » est utilisé comme synonyme de « hôte ».
Machine virtuelle est un système d'exploitation fonctionnant sur une machine physique au-dessus de l'hyperviseur. Pour nous, dans le cadre de ce cycle, il n'est pas si important de savoir s'il s'agit réellement d'une machine virtuelle ou simplement d'un conteneur. Nous allons appeler cela «VM«
Tenant est un terme large que je définirai dans cet article comme un service distinct ou un client distinct.
La multi-location ou multi-tenant est l'utilisation de la même application par différents clients/services. L'isolement des clients les uns des autres est réalisé grâce à l'architecture de l'application, et non à des instances séparément exécutées.
ToR — commutateur au sommet du rack — un commutateur installé dans un rack auquel toutes les machines physiques sont connectées.
Outre la topologie ToR, différents fournisseurs pratiquent le modèle End of Row (EoR) ou Middle of Row (bien que ce dernier soit rarement utilisé et que je n'ai jamais rencontré l'abréviation MoR).
Réseau sous-jacent ou réseau sous-jacent — infrastructure réseau physique : commutateurs, routeurs, câbles.
Réseau superposé ou réseau superposé — réseau virtuel de tunnels fonctionnant au-dessus du physique.
Fabric L3 ou Fabric IP — une invention incroyable qui permet d'éviter de répéter STP lors des discussions et d'apprendre TRILL. Un concept où l'ensemble du réseau jusqu'au niveau d'accès est exclusivement L3, sans VLAN et, par conséquent, d'énormes domaines de diffusion étendus. Nous expliquerons d'où vient le mot « fabric » dans la prochaine section.
SDN — Réseau défini par logiciel. Cela ne nécessite guère de présentation. Une approche de gestion réseau où les modifications du réseau sont effectuées non par un humain, mais par un programme. Cela signifie généralement déplacer le Control Plane hors des appareils réseau finaux vers un contrôleur.
NFV — Virtualisation des fonctions réseau — une virtualisation des dispositifs réseau, suggérant que certaines fonctions réseau peuvent être exécutées sous forme de machines virtuelles ou de conteneurs pour accélérer le déploiement de nouveaux services, organiser le Service Chaining et simplifier la mise à l'échelle horizontale.
VNF — Fonction réseau virtuelle. Un dispositif virtuel spécifique : routeur, commutateur, pare-feu, NAT, IPS/IDS, etc.
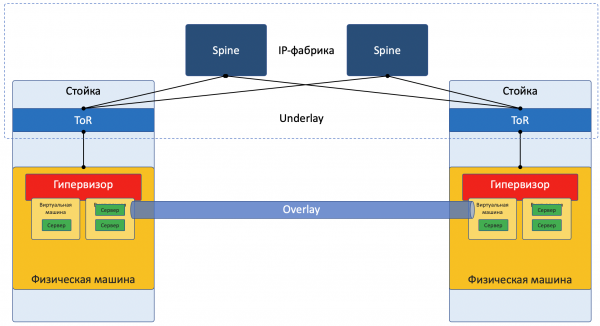
Je simplifie actuellement la description à une réalisation concrète pour ne pas trop embrouiller le lecteur. Pour une lecture plus approfondie, je le renvoie à la section . De plus, Roma Gorge, qui critique cet article pour des inexactitudes, promet d'écrire une édition séparée sur les technologies de virtualisation des serveurs et des réseaux, plus approfondie et attentive aux détails.
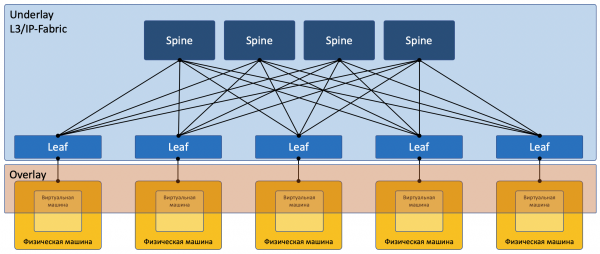
La plupart des réseaux aujourd'hui peuvent être clairement divisés en deux parties :
Sous-jacent — un réseau physique avec une configuration stable.
Superposé — une abstraction au-dessus de l'Underlay pour isoler les locataires.
C'est vrai, tant pour le cas des centres de données (que nous examinerons dans cet article) que pour les FAI (que nous ne traiterons pas, car cela a déjà été traité dans ). Avec les réseaux d'entreprise, bien sûr, la situation est quelque peu différente.
Une image mettant l'accent sur le réseau :
Sous-jacent
L'Underlay est un réseau physique : des commutateurs matériels et des câbles. Les dispositifs dans l'underlay savent comment accéder aux machines physiques.
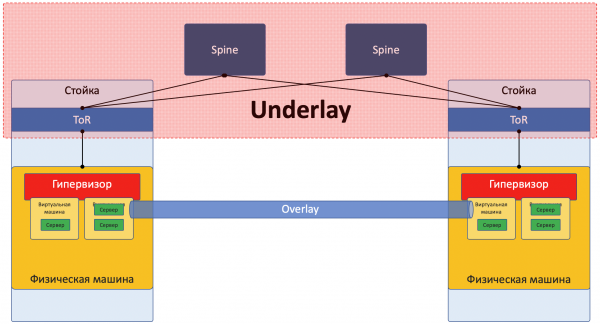
Il repose sur des protocoles et des technologies standards. Pas en dernier lieu parce que les appareils matériels fonctionnent toujours sur des logiciels propriétaires qui n'autorisent ni la programmation de la puce ni la mise en œuvre de leurs propres protocoles, d'où la nécessité de compatibilité avec d'autres fournisseurs et de normalisation.
Mais une entreprise comme Google peut se permettre de développer ses propres commutateurs et de renoncer aux protocoles conventionnels. Cependant, LAN_DC n'est pas Google.
L'underlay change relativement rarement, car sa tâche est d'assurer la connectivité IP de base entre les machines physiques. L'underlay ne sait rien des services, clients ou locataires fonctionnant au-dessus de lui — il doit simplement livrer un paquet d'une machine à une autre.
Un exemple d'underlay peut être le suivant :
- IPv4+OSPF
- IPv6+ISIS+BGP+L3VPN
- L2+TRILL
- L2+STP
Le réseau underlay est configuré de manière classique : CLI/GUI/NETCONF.
Manuellement, avec des scripts, des utilitaires propriétaires.
L'underlay sera abordé en détail dans l'article suivant de la série.
Superposé
L'Overlay est un réseau virtuel de tunnels, tendu au-dessus de l'underlay, permettant aux VM d'un client de communiquer entre elles, tout en assurant l'isolation des autres clients.
Les données du client sont encapsulées dans des en-têtes de tunneling pour être transmises à travers le réseau partagé.
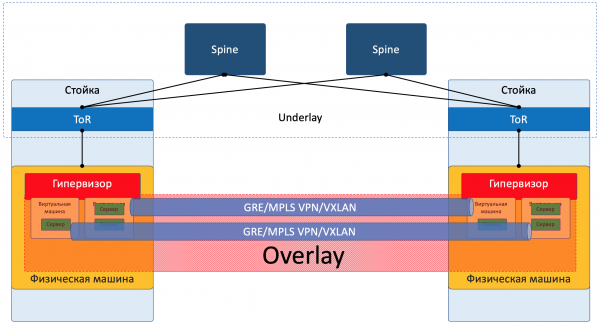
Ainsi, les VM d'un client (d'un service) peuvent communiquer entre elles via l'Overlay, sans même savoir quel chemin emprunte réellement le paquet.
Un exemple d'Overlay peut être le suivant, comme je l'ai déjà mentionné :
- Tunnel GRE
- VXLAN
- EVPN
- L3VPN
- GENEVE
Le réseau overlay est généralement configuré et maintenu via un contrôleur central. De là, la configuration, le Control Plane et le Data Plane sont transmis aux appareils qui s'occupent du routage et de l'encapsulation du trafic client. Un peu découvrons cela à travers des exemples.
Oui, c'est le SDN dans sa forme pure.
Il existe deux approches fondamentalement différentes pour organiser un réseau overlay :
- Overlay depuis ToR
- Overlay depuis l'hôte
Overlay depuis ToR
L'Overlay peut commencer sur un commutateur d'accès (ToR) installé dans un rack, comme cela se produit, par exemple, dans le cas d'une usine VXLAN.
C'est un mécanisme éprouvé dans les réseaux ISP et tous les fournisseurs de matériel réseau le soutiennent.
Cependant, dans ce cas, le commutateur ToR doit être capable de séparer les différents services, et l'administrateur réseau doit collaborer dans une certaine mesure avec les administrateurs des machines virtuelles et apporter des modifications (même automatiquement) à la configuration des dispositifs.
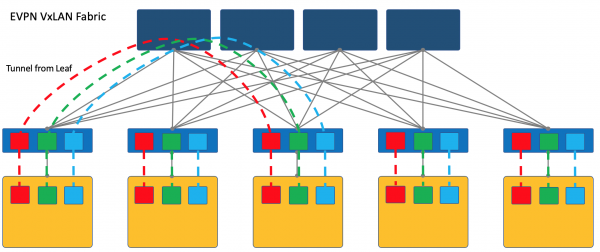
Je renverrai ici le lecteur à l'article sur notre ancien ami .
Dans cet article, qui décrit en détail les approches de la construction d'un réseau de centre de données avec une usine EVPN VXLAN.
Et pour une immersion plus complète dans la réalité, on peut lire le livre de Cisco .
Je souligne que VXLAN est juste une méthode d'encapsulation et que la terminaison des tunnels peut se faire non pas sur le ToR, mais sur l'hôte, comme c'est le cas avec OpenStack, par exemple.
Cependant, une usine VXLAN où le superposition commence sur le ToR est l'un des designs bien établis des réseaux en superposition.
Overlay depuis l'hôte
Une autre approche consiste à commencer et à terminer les tunnels sur les hôtes finaux.
Dans ce cas, le réseau (Underlay) reste aussi simple et statique que possible.
Et l'hôte effectue toutes les encapsulations nécessaires.
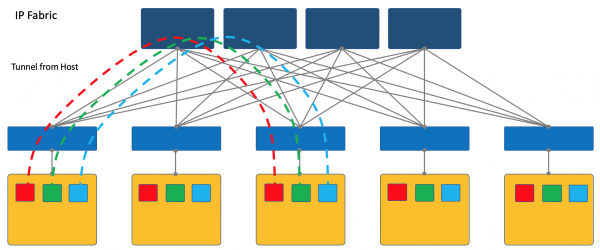
Pour cela, il faudra, sans aucun doute, exécuter une application spéciale sur les hôtes, mais cela en vaut la peine.
Tout d'abord, exécuter le client sur une machine Linux est plus simple ou, disons, est même possible - alors que sur un commutateur, il faudra probablement encore se tourner vers des solutions SDN propriétaires, ce qui détruit l'idée de multi-fournisseur.
Deuxièmement, dans ce cas, le commutateur ToR peut rester aussi simple que possible, tant du point de vue du plan de contrôle que du plan de données. En effet, avec un contrôleur SDN, il n'a pas besoin de communiquer, et il n'est pas nécessaire de stocker les réseaux / ARP de tous les clients connectés - il suffit de connaître l'adresse IP de la machine physique, ce qui simplifie beaucoup les tables de commutation / routage.
Dans la série ADSM, je choisis l'approche de la superposition à partir de l'hôte - nous ne parlerons plus que de cela et nous ne retournerons pas à l'usine VXLAN.
Il est le plus facile d'examiner cela par des exemples. Et comme cobaye, nous allons prendre la plateforme SDN OpenSource OpenContrail, maintenant connue sous le nom de .
À la fin de l'article, je fournirai quelques réflexions sur l'analogie avec OpenFlow et OpenvSwitch.
À l'exemple de Tungsten Fabric
Sur chaque machine physique, il y a vRouter — un routeur virtuel qui connaît les réseaux connectés et à quels clients ils appartiennent — en substance — un routeur PE. Pour chaque client, il maintient une table de routage isolée (lisez VRF). Et le vRouter réalise le tunneling en mode Overlay.
Un peu plus sur le vRouter — à la fin de l'article.
Chaque VM située sur l'hyperviseur se connecte au vRouter de cette machine via .
TAP — Terminal Access Point — une interface virtuelle dans le noyau Linux, qui permet d'assurer des interactions réseau.
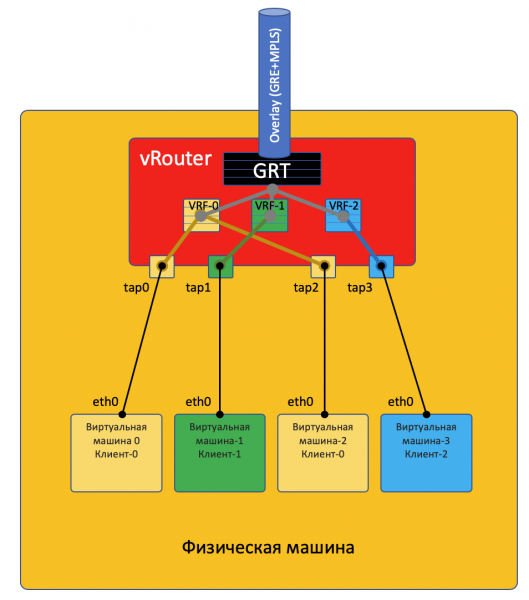
S'il y a plusieurs réseaux derrière le vRouter, une interface virtuelle est créée pour chacun d'eux, à laquelle une adresse IP est assignée — elle servira d'adresse de passerelle par défaut.
Tous les réseaux d'un même client sont placés dans une VRF (une table), ceux d'autres clients dans des tables différentes.
Je ferai ici une réserve, car ce n'est pas si simple, et je renverrai le lecteur curieux à la fin de l'article..
Pour que les vRouter puissent communiquer entre eux, et donc que les VM qui se trouvent derrière, elles aussi, échangent des informations de routage via le contrôleur SDN..
Pour sortir dans le monde extérieur, il existe un point de sortie de la matrice — la passerelle du réseau virtuel. VNGW — Virtual Network Gateway (terme que j'utilise)).
Regardons maintenant des exemples de communications — cela éclaircira les choses.
Communication au sein d'une seule machine physique
VM0 veut envoyer un paquet à VM2. Supposons pour l'instant que ce sont des VM d'un même client.
le Data Plane
- VM-0 a une route par défaut vers son interface eth0. Le paquet y est envoyé.
Cette interface eth0 est en réalité connectée virtuellement au routeur virtuel vRouter via l'interface TAP tap0. - Le vRouter analyse sur quelle interface le paquet est arrivé, c'est-à-dire à quel client (VRF) il appartient, puis compare l'adresse du destinataire avec la table de routage de ce client.
- Constatant que le destinataire est sur cette même machine par un autre port, le vRouter envoie simplement le paquet vers lui sans en-têtes supplémentaires — pour ce cas, il y a déjà une entrée ARP sur le vRouter.
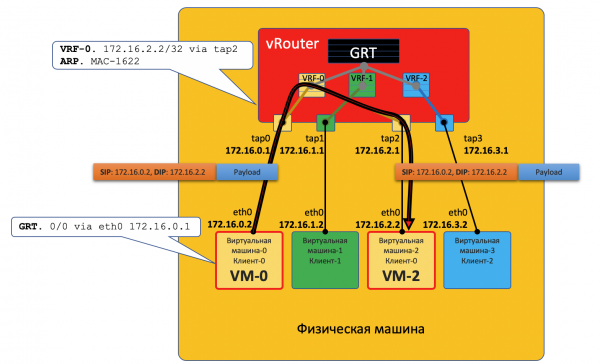
Le paquet, dans ce cas, ne passe pas par le réseau physique — il est routé à l'intérieur du vRouter.
Control Plane
L'hyperviseur, lors du démarrage de la machine virtuelle, lui signale :
- Son propre IP.
- La route par défaut — via l'adresse IP du vRouter dans ce réseau.
Le vRouter est informé par un API spécial de l'hyperviseur :
- Qu'il faut créer une interface virtuelle.
- Quelle Virtual Network il doit créer (pour la VM).
- À quel VRF son (VN) doit être lié.
- L'enregistrement ARP statique pour cette VM — quelle interface a son adresse IP et à quel adresse MAC elle est liée.
Encore une fois, la procédure réelle d'interaction est simplifiée pour faciliter la compréhension du concept.
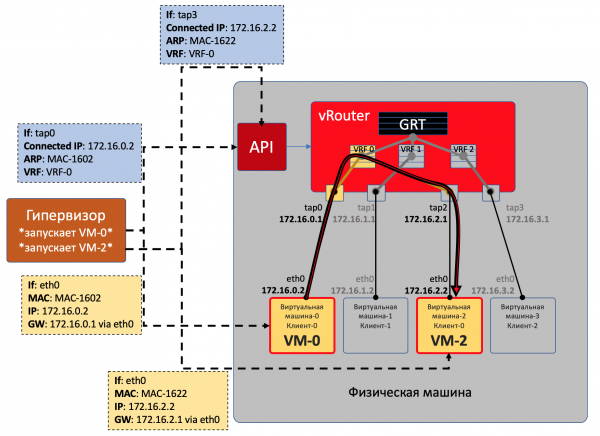
Ainsi, toutes les VM d'un client sur cette machine vRouter sont vues comme des réseaux directement connectés et peuvent elles-mêmes router entre eux.
Cependant, VM0 et VM1 appartiennent à des clients différents et se trouvent donc dans des tables vRouter différentes.
Leur capacité à communiquer directement dépend des paramètres du vRouter et de la conception du réseau.
Par exemple, si les VM des deux clients utilisent des adresses publiques, ou si le NAT se produit sur le vRouter lui-même, une routage direct via le vRouter est possible.
Dans le cas contraire, il peut y avoir un chevauchement des espaces d'adressage — il est nécessaire de passer par un serveur NAT pour obtenir une adresse publique — ce qui ressemble à un accès à des réseaux externes, comme mentionné ci-dessous.
Communication entre des VM situées sur différentes machines physiques
le Data Plane
- Le début est exactement le même : VM-0 envoie un paquet à l'adresse VM-7 (172.17.3.2) par défaut.
- Le vRouter le reçoit et cette fois-ci voit que le destinataire se trouve sur une autre machine et est accessible via le tunnel Tunnel0.
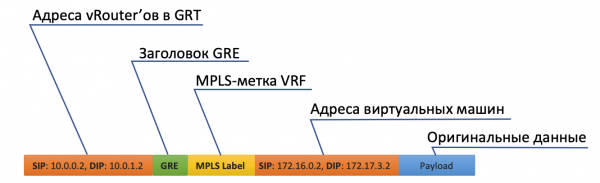
- D'abord, il ajoute une étiquette MPLS, identifiant l'interface distante, afin que de l'autre côté le vRouter puisse déterminer où placer ce paquet sans boucles supplémentaires.
- Pour Tunnel0, l'origine est 10.0.0.2, et le destinataire : 10.0.1.2.
Le vRouter ajoute des en-têtes GRE (ou UDP) et une nouvelle IP au paquet d'origine. - Dans la table de routage, le vRouter a une route par défaut via l'adresse ToR1 10.0.0.1. C'est là qu'il envoie le paquet.

- ToR1, en tant que membre du réseau Underlay, sait (par exemple, via OSPF) comment atteindre 10.0.1.2 et envoie le paquet par la route. Notez que l'ECMP est ici impliqué. Sur l'illustration, il y a deux next-hops, et différents flux seront répartis entre eux en fonction du hachage. Dans une vraie fabrique, il y aurait plutôt 4 next-hops.
Il n'a pas besoin de savoir ce qui se trouve sous l'en-tête IP externe. En fait, sous IP, il peut y avoir un empilement de IPv6 over MPLS over Ethernet over MPLS over GRE over over over GRE.
- Ainsi, du côté récepteur, le vRouter retire le GRE et, grâce à l'étiquette MPLS, sait à quel interface ce paquet doit être transmis, le restituant à son état initial pour l'envoyer au destinataire.
Control Plane
Lors du démarrage de la machine, tout se passe comme décrit ci-dessus.
Et en plus, ce qui suit :
- Pour chaque client, le vRouter attribue une étiquette MPLS. Il s'agit d'une étiquette de service L3VPN, selon laquelle les clients seront séparés au sein d'une seule machine physique.
En réalité, l'étiquette MPLS est systématiquement attribuée par le vRouter — car on ne sait pas à l'avance que la machine interagira uniquement avec d'autres machines derrière le même vRouter, et c'est probablement même rarement le cas.
- Le vRouter établit une connexion avec le contrôleur SDN via le protocole BGP (ou un protocole similaire — dans le cas de TF, c'est XMPP 0_o).
- Au cours de cette session, le vRouter informe le contrôleur SDN des itinéraires vers les réseaux connectés :
- Adresse du réseau
- Méthode d'encapsulation (MPLSoGRE, MPLSoUDP, VXLAN)
- L'étiquette MPLS du client
- Son adresse IP comme nexthop
- Le contrôleur SDN reçoit ces itinéraires de tous les vRouters connectés et les reflète à d'autres. C'est-à-dire qu'il agit en tant que Route Reflector.
La même chose se produit dans l'autre sens.
L'Overlay peut changer chaque minute. C'est ainsi que cela se passe dans les nuages publics, où les clients démarrent et arrêtent régulièrement leurs machines virtuelles.
Le contrôleur central prend en charge toutes les complexités liées au maintien de la configuration et au contrôle des tables de commutation/routage sur le vRouter.
Grossièrement parlant, le contrôleur se connecte à tous les vRouters via BGP (ou un protocole similaire) et se contente de transmettre des informations de routage. BGP, par exemple, possède déjà un Address-Family pour transmettre la méthode d'encapsulation. ou .
Cela ne modifie en rien la configuration du réseau Underlay, qui, soit dit en passant, est beaucoup plus difficile à automatiser, et il est plus facile de détruire cette configuration par un mouvement maladroit.
Sortie vers le monde extérieur
À un moment donné, la simulation doit prendre fin, et il est nécessaire de sortir du monde virtuel pour entrer dans le réel. Et il faut un passerelle de téléphonie.
Deux approches sont pratiquées :
- Un routeur matériel est installé.
- Une appliance qui réalise les fonctions d'un routeur est lancée (oui, oui, après le SDN, nous avons également rencontré le VNF). Appelons cela une passerelle virtuelle.
L'avantage de la seconde approche réside dans la possibilité d'une évolutivité horizontale à bas coût — si la puissance est insuffisante, une autre machine virtuelle avec passerelle est lancée. Sur n'importe quelle machine physique, sans besoin de chercher des racks libres, des unités d'alimentation, d'acheter le matériel, de le transporter, de l'installer, de le câbler, de le configurer, puis de devoir remplacer des composants défectueux.
Les désavantages d'une passerelle virtuelle résident dans le fait qu'une unité physique de routeur est de loin plus puissante qu'une machine virtuelle multicœur, et que son logiciel, adapté à sa propre base matérielle, fonctionne de manière beaucoup plus stable (non). Il est difficile de nier le fait que le complexe logiciel-matériel fonctionne simplement, nécessitant seulement une configuration, tandis que le lancement et l'entretien d'une passerelle virtuelle nécessitent des ingénieurs compétents.
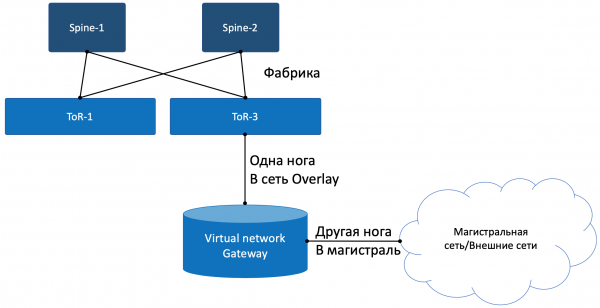
D'une de ses pattes, la passerelle se connecte à un réseau virtuel Overlay, tout comme une machine virtuelle ordinaire, et peut interagir avec toutes les autres VM. Elle peut ainsi terminer tous les réseaux des clients et donc effectuer le routage entre eux.
De l'autre côté, la passerelle se connecte au réseau backbone et sait comment accéder à Internet.
le Data Plane
Le processus se déroule donc ainsi :
- La VM-0, ayant pour défaut tous les paramètres vers le vRouter, envoie un paquet à l'adresse d'un destinataire dans le monde extérieur (185.147.83.177) via l'interface eth0.
- Le vRouter reçoit ce paquet et effectue une recherche de l'adresse de destination dans la table de routage — il trouve la route par défaut via la passerelle VNGW1 à travers le Tunnel 1.
Il voit également que c'est un tunnel GRE avec SIP 10.0.0.2 et DIP 10.0.255.2, et il faut d'abord ajouter l'étiquette MPLS de ce client que VNGW1 attend. - Le vRouter encapsule le paquet initial dans les en-têtes MPLS, GRE et nouvel IP, puis l'envoie à l'adresse ToR1 10.0.0.1 par défaut.
- Le réseau souterrain livre le paquet à la passerelle VNGW1.
- La passerelle VNGW1 retire les en-têtes de tunnel GRE et MPLS, voit l'adresse de destination, consulte sa table de routage et comprend que l'adresse est destinée à Internet — donc via Full View ou Default. Elle effectue la traduction NAT si nécessaire.
- Entre VNGW et la bordure, il peut y avoir un réseau IP standard, ce qui semble peu probable.
Cela peut être un réseau MPLS classique (IGP+LDP/Rsvp TE) ou une usine inverse avec BGP LU ou un tunnel GRE de VNGW à la bordure via un réseau IP.
Quoi qu'il en soit, VNGW1 effectue les encapsulations nécessaires et envoie le paquet initial vers la bordure.
Le trafic dans le sens inverse suit les mêmes étapes dans l'ordre inverse.
- La bordure envoie le paquet à VNGW1.
- Cette dernière le décapsule, regarde l'adresse du destinataire et voit qu'elle est accessible via le tunnel Tunnel1 (MPLSoGRE ou MPLSoUDP).
- En conséquence, elle ajoute l'étiquette MPLS, l'en-tête GRE/UDP et un nouvel IP, puis l'envoie à son ToR3 10.0.255.1.
L'adresse de destination du tunnel est l'adresse IP du vRouter derrière lequel se trouve la VM cible — 10.0.0.2. - Le réseau de canalisation livre le paquet au vRouter ciblé.
- Le vRouter cible extrait le GRE/UDP, détermine l'interface en fonction du label MPLS, et envoie le paquet IP brut vers son interface TAP associée à eth0 de la VM.
Control Plane
VNGW1 établit un voisinage BGP avec le contrôleur SDN, à partir duquel il reçoit toutes les informations de routage sur les clients : quel client est derrière quelle adresse IP (vRouter) et avec quel label MPLS il est identifié.
De la même manière, il informe le contrôleur SDN de la route par défaut avec le label de ce client, se désignant comme nexthop. Cette route par défaut arrive ensuite aux vRouters.
Sur VNGW, il y a généralement agrégation des routes ou traduction NAT.
Et dans l'autre sens, lors de la session avec les frontières ou les Route Reflectors, il remet exactement cette route agrégée. Et de ces derniers, il reçoit la route par défaut, ou un Full-View, ou autre chose.
Du point de vue de l'encapsulation et de l'échange de trafic, VNGW ne diffère en rien du vRouter.
Si l'on élargit un peu le champ, on peut ajouter d'autres dispositifs réseau, tels que des pare-feux, des fermes de nettoyage ou d'enrichissement de trafic, des IPS, etc., aux VNGW et vRouters.
Et grâce à la création séquentielle de VRF et à l'annonce correcte des routes, il est possible de faire circuler le trafic comme vous le souhaitez, ce qu'on appelle le Service Chaining.
Ici, le contrôleur SDN joue également le rôle de Route Reflector entre VNGW, vRouters et d'autres dispositifs réseau.
Mais en réalité, le contrôleur transmet également des informations sur l'ACL et le PBR (Policy Based Routing), obligeant certains flux de trafic à emprunter des chemins différents de ceux dictés par la route.
FAQ
Pourquoi fais-tu toujours la remarque sur GRE/UDP ?
Eh bien, en fait, on peut dire que c'est spécifique à Tungsten Fabric — on peut tout à fait ne pas en tenir compte.
Mais si l'on prend cela en compte, TF, alors qu'il était encore OpenContrail, supportait les deux encapsulations : MPLS dans GRE et MPLS dans UDP.
L'UDP est avantageux car il est très facile d'encoder une fonction de hachage dérivée des IP+Proto+Port d'origine dans le champ Source Port de son en-tête, ce qui permet d'assurer un équilibrage.
Dans le cas de GRE, hélas, il n'y a que les en-têtes IP et GRE externes, qui sont identiques pour tout le trafic encapsulé, et il n'est donc pas question d'équilibrage — peu de personnes peuvent regarder si profondément à l'intérieur du paquet.
Jusqu'à récemment, les routeurs savaient gérer les tunnels dynamiques uniquement avec MPLSoGRE, et ce n'est que tout récemment qu'ils ont appris à gérer MPLSoUDP. Il est donc toujours nécessaire de noter la possibilité de deux encapsulations différentes.
Pour être juste, il convient de mentionner que TF prend également en charge la connectivité L2 via VXLAN.
Tu as promis de faire des parallèles avec OpenFlow.
Ils se présentent effectivement. Le vSwitch dans OpenStack fait des choses très similaires en utilisant VXLAN, qui, soit dit en passant, a également un en-tête UDP.
Dans le Data Plane, ils fonctionnent à peu près de la même manière, mais le Control Plane varie considérablement. Tungsten Fabric utilise XMPP pour la livraison des informations de routage sur le vRouter, tandis qu'OpenStack utilise OpenFlow.
Peut-on en savoir un peu plus sur le vRouter?
Il se divise en deux parties: vRouter Agent et vRouter Forwarder.
Le premier s'exécute dans l'espace utilisateur du système d'exploitation hôte et communique avec le contrôleur SDN, échangeant des informations sur les routes, les VRF et les ACL.
Le second implémente le Data Plane — généralement dans le Kernel Space, mais peut également s'exécuter sur des SmartNIC, des cartes réseau avec CPU et un chip de commutation programmable séparé, ce qui permet de réduire la charge sur le CPU de la machine hôte, rendant le réseau plus rapide et plus prévisible.
Il est également possible que le vRouter soit une application DPDK dans l'espace utilisateur.
Le vRouter Agent déploie les configurations sur le vRouter Forwarder.
Qu'est-ce que le Réseau Virtuel?
J'ai mentionné au début de l'article le VRF, soulignant que chaque locataire est lié à son propre VRF. Et si cela suffisait pour une compréhension superficielle du fonctionnement du réseau overlay, des clarifications doivent être apportées lors de la prochaine itération.
Généralement, dans les mécanismes de virtualisation, l'entité Réseau Virtuel (que l'on peut considérer comme un nom propre) est introduite séparément des clients/locataires/machines virtuelles — une chose tout à fait autonome. Ce Réseau Virtuel peut ensuite être connecté à un locataire, à un autre, à deux, ou même à plus. Ainsi, par exemple, le Service Chaining est réalisé lorsque le trafic doit passer par certains nœuds dans un ordre spécifique, créant et liant simplement des Réseaux Virtuels dans le bon ordre.
Il n'existe donc pas de correspondance directe entre le Réseau Virtuel et le locataire.
Conclusion
Ceci est une description plutôt superficielle du fonctionnement d'un réseau virtuel avec overlay sur un hôte et un contrôleur SDN. Peu importe la plateforme de virtualisation que vous choisissez aujourd'hui, elle fonctionnera de manière similaire, que ce soit VMWare, ACI, OpenStack, CloudStack, Tungsten Fabric ou Juniper Contrail. Ils différeront par les types d'encapsulations et d'en-têtes, ainsi que par les protocoles de livraison d'informations aux dispositifs réseaux finaux, mais le principe d'un réseau overlay programmable, fonctionnant sur un réseau underlay relativement simple et statique, restera le même.
On peut dire qu'aujourd'hui, dans le domaine de la création de cloud privé, le SDN basé sur le réseau overlay a triomphé. Cependant, cela ne signifie pas qu'Openflow n'a plus sa place dans le monde moderne — il est utilisé dans OpenStack et dans VMware NSX, et, autant que je sache, Google l'utilise pour configurer le réseau underlay.
Un peu plus bas, j'ai fourni des liens vers des documents plus détaillés, si vous souhaitez approfondir la question.
Et qu'en est-il de notre Underlay ?
Eh bien, en fait, rien. Il n'a pas changé depuis le début. Tout ce qu'il doit faire en cas d'overlay sur un hôte, c'est mettre à jour les routes et les ARP au fur et à mesure que vRouter/VNGW apparaissent et disparaissent et faire passer les paquets entre eux.
Formulons la liste des exigences pour le réseau Underlay.
- Être capable de comprendre un certain protocole de routage, dans notre cas — BGP.
- Avoir une large bande, de préférence sans sursouscription, afin d'éviter la perte de paquets due à une surcharge.
- Supporter l'ECMP — une partie essentielle de l'usine.
- Être capable d'assurer la QoS, y compris des choses subtiles, comme l'ECN.
- Supporter NETCONF — un investissement pour l'avenir.
J'ai consacré très peu de temps au fonctionnement même du réseau Underlay ici. C'est parce qu'ensuite dans la série, je me concentrerai précisément sur elle, tandis que l'Overlay ne sera abordé qu'en passant.
Il est évident que je me limite énormément en utilisant comme exemple un réseau de centre de données construit sur une usine Closa avec un routage IP pur et un overlay sur un hôte.
Cependant, je suis convaincu que tout réseau ayant un design peut être décrit en termes formels et automatisé. Mon objectif ici est de comprendre les approches d'automatisation, sans compliquer les choses en essayant de résoudre le problème de manière générale.
Dans le cadre de l'ADSM, Roman Gorge et moi prévoyons de publier un numéro séparé sur la virtualisation des ressources de calcul et son interaction avec la virtualisation du réseau. Restez connectés.
Liens utiles
- .
- . 6 heures sur Yandex.Cloud, où l'on aborde notamment le réseau virtuel sur TF.
- .
- . Cela concerne l'ensemble du réseau du centre de données, y compris l'Underlay, l'Overlay, les approches multi-homing et la gestion.
Merci
- — ancien animateur du podcast linkmeup, et désormais expert en plateformes cloud. Merci pour les commentaires et les corrections. Nous attendons également dans un futur proche son article plus approfondi sur la virtualisation.
- — mon collègue et expert en développement de réseaux virtuels. Merci pour les commentaires et les corrections.
- — mon collègue et expert en Tungsten Fabric. Merci pour les commentaires et les corrections.
- — illustrateur linkmeup. Merci pour la KDPV.
- Alexandre Limonov. Merci pour le mème « automato ».
Source : habr.com
