

Dans les deux premiers articles, j'ai soulevé la question de l'automatisation et esquissé son cadre, dans le second, j'ai fait une digression sur la virtualisation des réseaux, comme première approche à l'automatisation de la configuration des services.
Il est maintenant temps de dessiner le schéma du réseau physique.
Si vous n'êtes pas familier avec les équipements des réseaux de centres de données, je vous recommande vivement de commencer par .
Tous les numéros :
Les pratiques décrites dans cette série devraient pouvoir s'appliquer à tout type de réseau, quelle que soit sa taille et sa diversité de fournisseurs (non). Cependant, il n'est pas possible de décrire un exemple universel de l'application de ces approches. Je vais donc me concentrer sur l'architecture moderne des réseaux de centres de données : .
La DCI se fera sur MPLS L3VPN.
Au-dessus du réseau physique, il y a un réseau Overlay depuis l’hôte (cela peut être une VXLAN d'OpenStack ou Tungsten Fabric ou quelque chose d'autre qui nécessite simplement une connectivité IP de base).
Dans ce cas, ce sera un scénario relativement simple pour l'automatisation, car nous avons beaucoup d'équipements configurés de la même manière.
Nous allons choisir un centre de données sphérique dans le vide :
- Une version de design partout.
- Deux fournisseurs créant deux plans de réseau.
- Un centre de données ressemble à un autre comme deux gouttes d'eau.
Contenu
- Topologie physique
- Routage
- Plan IP
- Lab
- Conclusion
- Liens utiles
Que notre Fournisseur de Services LAN_DC héberge, par exemple, des vidéos de formation sur la survie dans des ascenseurs bloqués.
Dans les grandes villes, cela rencontre un grand succès, donc il faut beaucoup de machines physiques.
D'abord, je vais décrire le réseau tel que je voudrais qu'il soit. Ensuite, j'éclaircirai cela pour le lab.
Topologie physique
Emplacements
LAN_DC aura 6 centres de données :
- Russie (RU):
- Moscou (msk)
- Kazan (kzn)
- Espagne (SP):
- Barcelone (bcn)
- Malaga (mlg)
- Chine (CN):
- Shanghai (sha)
- Xi'an (sia)

À l'intérieur du DC (Intra-DC)
Dans tous les DC, il y a des réseaux de connectivité interne identiques, basés sur la topologie Clos.
Quelles sont les réseaux Clos et pourquoi eux — dans un article séparé. .
Dans chaque DC, il y a 10 racks avec des machines, ils seront numérotés comme A, B, C Et ainsi de suite.
Dans chaque rack, il y a 30 machines. Elles ne nous intéresseront pas.
Il y a aussi un commutateur dans chaque rack, auquel toutes les machines sont connectées — c'est un Top of the Rack switch — ToR ou sinon, en termes de fabrication Clos, nous l'appellerons Leaf.

Schéma général de la fabrique.
Nous les nommerons XXX-leafY, où XXX — une abréviation en trois lettres pour le DC, et Y — un numéro d'ordre. Par exemple, kzn-leaf11.
Dans mes articles, je me permettrais d'utiliser les termes Leaf et ToR de manière assez libre, comme des synonymes. Cependant, il faut se rappeler que ce n'est pas exactement le cas.
ToR — c'est un commutateur monté en rack auquel les machines sont connectées.
Leaf — c'est le rôle d'un appareil dans un réseau physique ou un commutateur de premier niveau selon la topologie Clos.
Donc Leaf != ToR.
Ainsi, un commutateur EndofRaw peut être un Leaf, par exemple.
Cependant, dans le cadre de cet article, nous les considérerons tout de même comme des synonymes.
Chaque commutateur ToR est à son tour connecté à quatre commutateurs agrégateurs supérieurs — Spine. Un rack est dédié aux Spine dans le DC. Nous allons les nommer de la manière suivante : XXX-spineY.
Dans ce même rack se trouvera l'équipement réseau pour la connectivité entre les centres de données — 2 routeurs avec MPLS à bord. Mais en réalité, ce sont les mêmes ToR. En d'autres termes, du point de vue des commutateurs Spine, il n'y a aucune différence entre un ToR ordinaire avec des machines connectées ou un routeur pour DCI — cela revient au même en termes de transfert.
Ces ToR spéciaux sont appelés Edge-leaf. Nous allons les nommer XXX-edgeY.
Cela ressemblera à ceci.
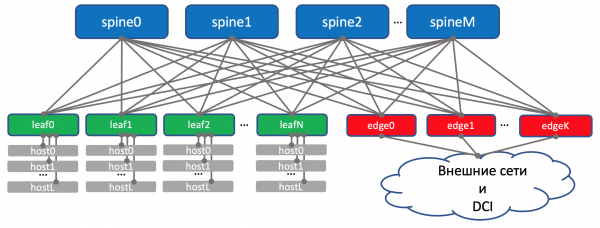
Dans le schéma ci-dessus, j'ai effectivement placé edge et leaf au même niveau. nous ont habitués à considérer l'uplink (d'où le terme) comme des liens vers le haut. Ici, l'uplink DCI va en fait vers le bas, ce qui déroute un peu la logique habituelle. Dans le cas de grands réseaux, lorsque les centres de données sont divisés en unités encore plus petites — PODdes POD (Point Of Delivery), des Edge-PODsont séparés pour le DCI et la sortie vers les réseaux externes.
Pour plus de clarté, je vais tout de même dessiner Edge au-dessus de Spine, tout en gardant à l'esprit qu'il n'y a aucune intelligence sur Spine et aucune différence à travailler avec des Leaf ordinaires et des Edge-leaf (bien qu'il puisse y avoir des nuances, mais en gros, c'est comme ça).
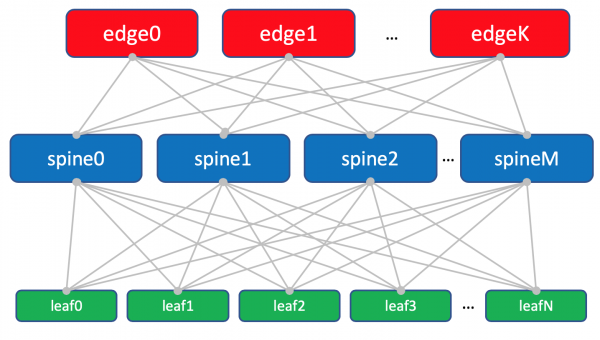
Schéma de la fabrique avec Edge-leaf.
Le trio Leaf, Spine et Edge forme un réseau Underlay ou une fabrique.
La tâche de la fabrique réseau (c'est-à-dire l'Underlay), comme nous l'avons déjà défini dans , est très simple — assurer la connectivité IP entre les machines tant à l'intérieur d'un même DC que entre.
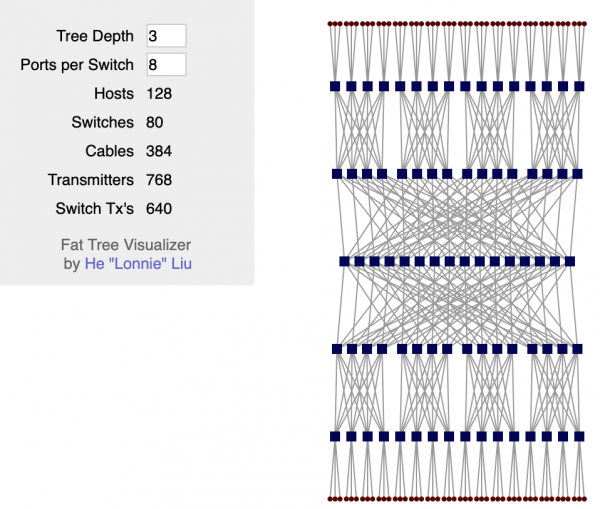
C'est pourquoi le réseau est appelé fabrique, tout comme une fabrique de commutation à l'intérieur des boîtiers réseau modulaires, dont vous pouvez en lire davantage dans .
En fait, ce type de topologie s'appelle une fabrique, car le mot "fabric" se traduit par "tissu". Il est difficile de ne pas être d'accord :
La fabrique est entièrement L3. Pas de VLAN, pas de Broadcast — voilà ce que nos merveilleux programmeurs à LAN_DC savent faire, écrire des applications qui fonctionnent selon le paradigme L3, et les machines virtuelles n'ont pas besoin de Live Migration tout en conservant l'adresse IP.
Et une fois de plus : la réponse à la question de pourquoi une fabrique et pourquoi L3 se trouve dans un autre .
DCI — Interconnexion de Centres de Données (Inter-DC)
Le DCI sera organisé à l'aide de Edge-Leaf, c'est-à-dire qu'ils sont notre point de sortie vers le backbone.
Pour simplifier, supposons que les DC sont connectés par des liaisons directes.
Excluons la connectivité externe.
Je suis conscient que chaque fois que je retire un composant, je simplifie considérablement le réseau. Et lors de l'automatisation de notre réseau abstrait, tout ira bien, mais dans le réel, des solutions de contournement apparaîtront.
C'est vrai. Et pourtant, l'objectif de cette série est de réfléchir et de travailler sur les approches, plutôt que de résoudre héroïquement des problèmes imaginaires.
Sur les Edge-Leaf, l'underlay est placé dans un VPN et transmis via le backbone MPLS (cette fameuse liaison directe).
Voici donc un schéma de haut niveau.

Routage
Pour le routage à l'intérieur du DC, nous utiliserons BGP.
Sur le backbone MPLS, OSPF+LDP.
Pour le DCI, c'est-à-dire l'organisation de la connectivité dans l'underlay — BGP L3VPN sur MPLS.
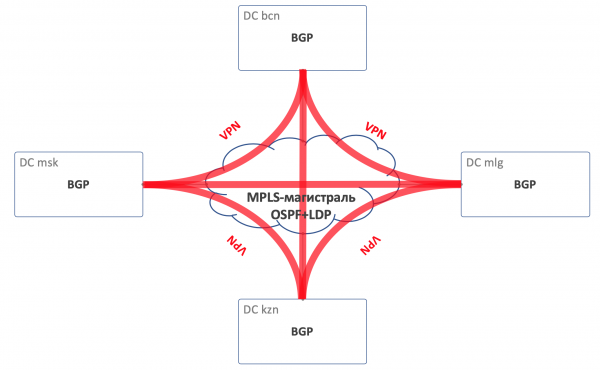
Schéma général de routage
Dans la fabrique, il n'y a pas d'OSPF ni d'ISIS (protocole de routage interdit en Fédération de Russie).
Cela signifie qu'il n'y aura pas d'Auto-discovery et de calcul des chemins les plus courts — uniquement une configuration manuelle (en réalité automatique — nous parlons ici d'automatisation) des protocoles, des voisins et des politiques.
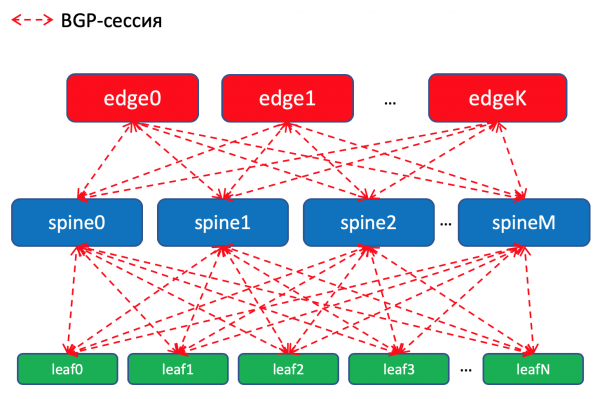
Schéma de routage BGP à l'intérieur du DC
Pourquoi BGP ?
Il existe à ce sujet de Facebook et Arista, qui explique comment construire des réseaux de centres de données très vastes en utilisant BGP. Cela se lit presque comme un roman, je le recommande vivement pour une soirée tranquille. Il y a aussi une section entière dans mon article à ce sujet. Je vous
renvoie donc .
De plus, l'utilisation de BGP partout permettra de ne pas se disperser dans le soutien de plusieurs protocoles différents et leur synchronisation.
De plus, l'utilisation de BGP partout permettra de ne pas se disperser en supportant plusieurs protocoles différents et en synchronisant entre eux.
À dire vrai, dans notre usine, qui ne connaîtra probablement pas de croissance rapide, le protocole OSPF suffirait amplement. Ce sont réellement des problèmes des méga-scaler et des titans du cloud. Mais imaginons simplement pour quelques éditions que nous en aurions besoin, et utilisons le BGP, comme l'a prescrit Piotr Lapoukhov.
Politiques de routage
Sur les commutateurs Leaf, nous importons dans BGP des préfixes depuis des interfaces Underlay avec des réseaux.
Nous aurons une session BGP entre chaque paire Leaf-Spine, où ces préfixes Underlay seront annoncés sur le réseau.
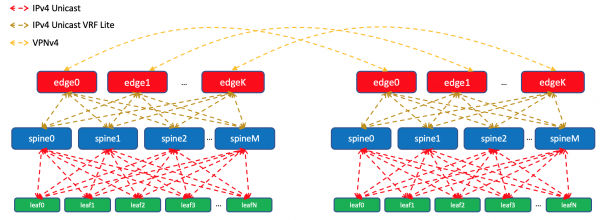
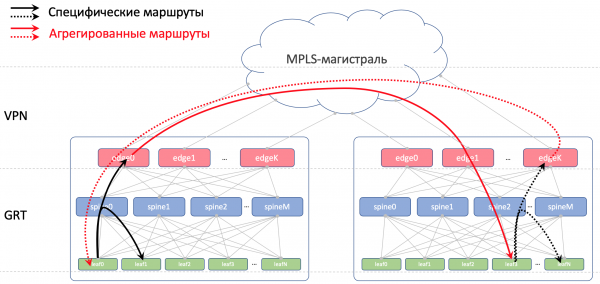
À l'intérieur d'un même centre de données, nous diffuserons les spécificités que nous avons importées sur les ToR. Sur les Edge-Leaf, nous allons les agréger et les annoncer dans des centres de données distants et les faire descendre jusqu'aux ToR. Cela signifie que chaque ToR saura exactement comment atteindre un autre ToR dans ce même centre de données et où se trouve le point d'entrée pour rejoindre le ToR dans un autre centre de données.
Dans le DCI, les routes seront transmises comme VPNv4. Pour cela, l'interface Edge-Leaf vers l'usine sera placée dans un VRF, que nous appellerons UNDERLAY, et le voisinage avec le Spine sur l'Edge-Leaf sera établi à l'intérieur du VRF, ainsi qu'entre les Edge-Leaf dans la famille VPNv4.
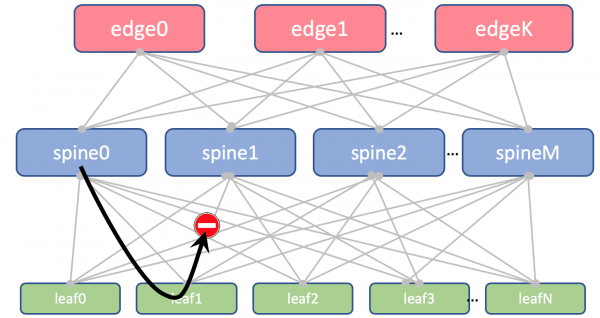
Et nous allons également interdire de réannonce des routes reçues des spines, en retour vers eux.
Sur Leaf et Spine, nous n'importerons pas les Loopback. Nous n'en aurons besoin que pour définir l'ID du routeur.
Cependant, sur les Edge-Leaf, nous l'importons dans le BGP global. Entre les adresses Loopback, les Edge-Leaf établiront une session BGP dans la famille VPN IPv4 les uns avec les autres.
Entre les dispositifs EDGE, nous aurons une liaison étendue sur OSPF+LDP. Tout dans une seule zone. Configuration extrêmement simple.
Voici à quoi ressemble le routage.
BGP ASN
Edge-Leaf ASN
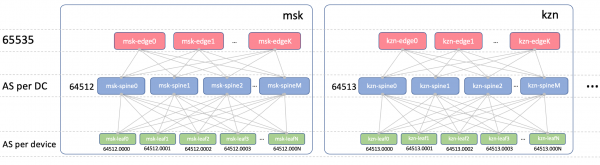
Sur les Edge-Leaf, il y aura un ASN unique dans tous les centres de données. C'est important afin qu'il y ait un iBGP parmi les Edge-Leaf, et nous ne soyons pas piégés par les nuances de l'eBGP. Prenons-le comme 65535. En réalité, cela pourrait être un numéro d'AS public.
Spine ASN
Sur le Spine, nous aurons un ASN par centre de données. Nous commencerons ici avec le tout premier numéro de la plage des AS privés — 64512, 64513, et ainsi de suite.
Pourquoi un ASN par centre de données ?
Décomposons cette question en deux :
- Pourquoi des ASN identiques sur tous les spines d'un même centre de données ?
- Pourquoi différents dans différents centres de données ?
Pourquoi des ASN identiques sur tous les spines d'un même centre de données ?
Voici à quoi ressemblera le chemin AS de la route Underlay sur les Edge-Leaf :
[leafX_ASN, spine_ASN, edge_ASN]
En essayant de l'annoncer à nouveau sur le Spine, celui-ci le rejettera parce que son AS (Spine_AS) est déjà dans la liste.
Cependant, au sein du DC, nous sommes tout à fait d'accord sur le fait que les routes Underlay, qui se sont élevées jusqu'à Edge, ne pourront pas redescendre. Toute la communication entre les hôtes à l'intérieur du DC doit se faire au niveau des spines.
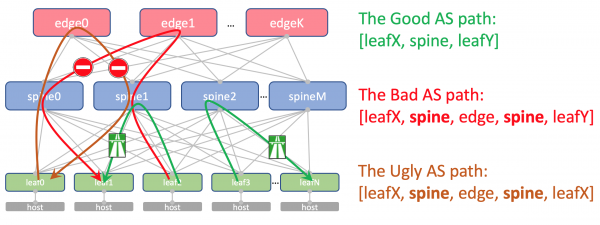
Ainsi, les routes agrégées d'autres DC parviendront sans obstacle aux ToR - leur AS-Path comportera uniquement l'ASN 65535 - le numéro AS des Edge-Leaves, car c'est exactement sur eux qu'elles ont été créées.
Pourquoi différentes dans différents DC
Théoriquement, il peut nous être nécessaire de faire passer des Loopbacks d'éventuelles machines virtuelles de service entre les DC.
Par exemple, sur l'hôte, un Route Reflector ou (Virtual Network Gateway), qui, via BGP, se connectera au ToR et annoncera son loopback, qui doit être accessible depuis tous les DC.
Voici à quoi ressemblera son AS-Path :
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
Et ici, il ne devrait pas y avoir d'ASNs répétés.
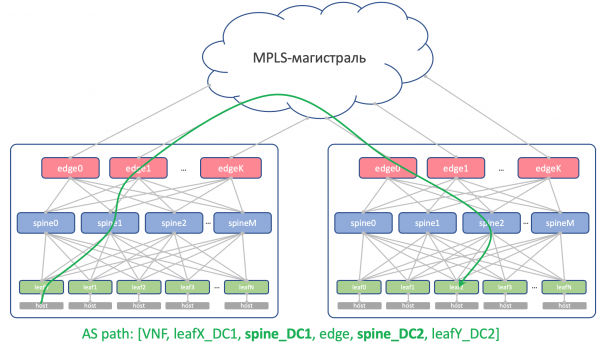
C'est-à-dire que Spine_DC1 et Spine_DC2 doivent être différents, tout comme leafX_DC1 et leafY_DC2, ce à quoi nous arrivons justement.
Comme vous le savez probablement, il existe des hacks permettant d'accepter des routes avec des ASNs répétées malgré le mécanisme de prévention des boucles (allowas-in sur Cisco). Et cela a même des applications parfaitement légitimes. Mais c'est une brèche potentielle dans la stabilité du réseau. Et personnellement, j'y suis tombé quelques fois.
Et si nous avons la possibilité de ne pas utiliser des choses dangereuses, nous en profiterons.
ASN des Leaves
Nous aurons un ASN individuel sur chaque switch Leaf dans l'ensemble du réseau.
Nous procédons ainsi pour les raisons évoquées ci-dessus : un AS-Path sans boucles, une configuration BGP sans pièges.
Pour que les routes entre les Leaves passent sans obstruction, l'AS-Path doit être comme suit :
[leafX_ASN, spine_ASN, leafY_ASN]
où leafX_ASN et leafY_ASN seraient mieux s'ils différaient.
Cela est également nécessaire pour le cas de l'annonce du loopback VNF entre les DC :
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
Nous allons utiliser un ASN à 4 octets et le générer sur la base de l'ASN des Spine et du numéro du switch Leaf, à savoir, comme suit : Spine_ASN.0000X.
Voici à quoi ressemble la situation avec l'ASN.
Plan IP
Fondamentalement, nous devons attribuer des adresses pour les connexions suivantes :
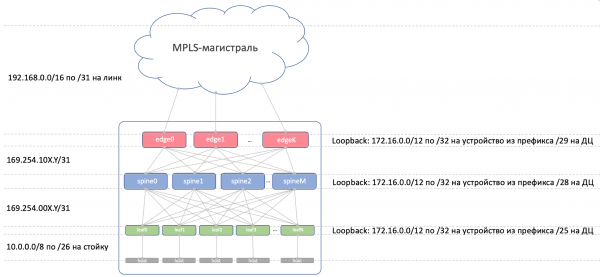
- Les adresses du réseau Underlay entre le ToR et la machine. Elles doivent être uniques dans l'ensemble du réseau, afin que n'importe quelle machine puisse communiquer avec n'importe quelle autre. Cela convient parfaitement 10/8. Pour chaque rack, par /26 avec une réserve. Nous allons allouer un /19 au DC et un /17 à la région.
- Les adresses de liaison entre le Leaf/Tor et le Spine.
Ils pourraient être assignés de manière algorithmique, c'est-à-dire calculés à partir des noms des appareils à connecter.
Faisons que ce soit… 169.254.0.0/16.
À savoir 169.254.00X.Y/31, où X — numéro de Spine, Y — réseau P2P /31.
Cela permettra de déployer jusqu'à 128 racks et jusqu'à 10 Spine dans le DC. Les adresses de liaison peuvent (et seront) répétées d'un DC à l'autre. - Les liaisons Spine - Edge-Leaf seront organisées sur des sous-réseaux 169.254.10X.Y/31, où il en va de même X — numéro de Spine, Y — réseau P2P /31.
- Les adresses de liaison de Edge-Leaf vers le tronc MPLS. Ici, la situation est quelque peu différente — le point de connexion de tous les morceaux en un seul tout, donc il ne sera pas possible de réutiliser les mêmes adresses — il faudra choisir le prochain sous-réseau libre. Prenons donc 192.168.0.0/16 et allons extraire les libres.
- Adresses Loopback. Nous y consacrerons toute la plage 172.16.0.0/12.
- Leaf — par /25 dans le DC — les mêmes 128 racks. Nous allouerons /23 pour la région.
- Spine — par /28 dans le DC — jusqu'à 16 Spine. Nous allouerons /26 pour la région.
- Edge-Leaf — par /29 dans le DC — jusqu'à 8 appareils. Nous allouerons /27 pour la région.
Si nous ne disposons pas de plages allouées suffisantes dans le DC (et ce sera le cas — nous aspirons à l'hyperscalabilité), nous attribuons simplement le prochain bloc.
Voilà à quoi ressemble la situation de l'adressage IP.
Loopbacks :
Préfixe
Rôle de l'appareil
Région
DC
172.16.0.0/23
edge
172.16.0.0/27
fr
172.16.0.0/29
msk
172.16.0.8/29
kzn
172.16.0.32/27
sp
172.16.0.32/29
bcn
172.16.0.40/29
mlg
172.16.0.64/27
cn
172.16.0.64/29
sha
172.16.0.72/29
sia
172.16.2.0/23
spine
172.16.2.0/26
fr
172.16.2.0/28
msk
172.16.2.16/28
kzn
172.16.2.64/26
sp
172.16.2.64/28
bcn
172.16.2.80/28
mlg
172.16.2.128/26
cn
172.16.2.128/28
sha
172.16.2.144/28
sia
172.16.8.0/21
leaf
172.16.8.0/23
fr
172.16.8.0/25
msk
172.16.8.128/25
kzn
172.16.10.0/23
sp
172.16.10.0/25
bcn
172.16.10.128/25
mlg
172.16.12.0/23
cn
172.16.12.0/25
sha
172.16.12.128/25
sia
Underlay :
Préfixe
Région
DC
10.0.0.0/17
fr
10.0.0.0/19
msk
10.0.32.0/19
kzn
10.0.128.0/17
sp
10.0.128.0/19
bcn
10.0.160.0/19
mlg
10.1.0.0/17
cn
10.1.0.0/19
sha
10.1.32.0/19
sia
Lab
Deux vendeurs. Un réseau. ADSM.
Juniper + Arista. Ubuntu. La vieille Eva.
Le nombre de ressources sur notre virtuel dans Miran est néanmoins limité, c'est pourquoi pour la pratique nous allons utiliser un réseau simplifié au maximum.
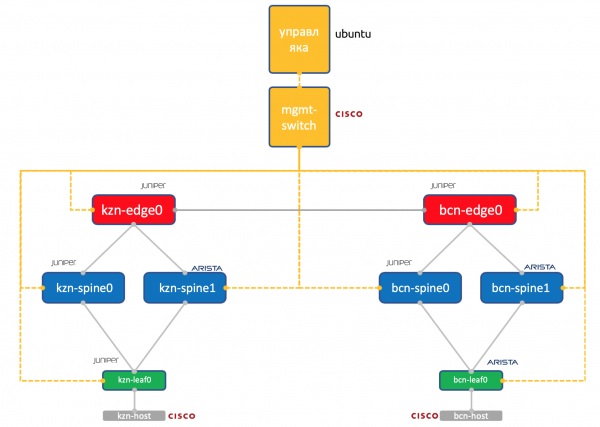
Deux centres de données : Kazan et Barcelone.
- Deux spines dans chacun : Juniper et Arista.
- Un tor (Leaf) dans chacun — Juniper et Arista, avec un hôte connecté (nous prendrons un léger Cisco IOL pour cela).
- Une node Edge-Leaf (uniquement Juniper pour l'instant).
- Un switch Cisco pour les gouverner tous.
- En plus des boîtiers réseau, une machine virtuelle de gestion est lancée. Sous Ubuntu.
Elle a accès à tous les appareils, y fonctionne les systèmes IPAM/DCIM, une série de scripts Python, Ansible et tout ce dont nous pourrions avoir besoin.
de tous les dispositifs réseau que nous allons tenter de reproduire à l'aide de l'automatisation.
Conclusion
Est-ce également d'usage ? Faire un court résumé sous chaque article ?
Nous avons donc choisi Kloza à l'intérieur du DC, car nous prévoyons beaucoup de trafic Est-Ouest et voulons de l'ECMP.
Nous avons divisé le réseau en physique (underlay) et virtuel (overlay). L'overlay commence avec l'hôte — simplifiant ainsi les exigences de l'underlay.
Nous avons choisi BGP comme protocole de routage pour les réseaux de superposition en raison de sa scalabilité et de la flexibilité des politiques.
Nous aurons des nœuds séparés pour l'organisation du DCI — Edge-leaf.
La dorsale utilisera OSPF+LDP.
Le DCI sera mis en œuvre sur la base de MPLS L3VPN.
Pour les liens P2P, nous calculerons les adresses IP de manière algorithmique sur la base des noms des dispositifs.
Nous attribuerons les boucles de retour selon le rôle des dispositifs et leur emplacement de manière séquentielle.
Les préfixes de superposition seront attribués uniquement aux commutateurs Leaf de manière séquentielle en fonction de leur emplacement.
Supposons qu'à l'heure actuelle, nous n'ayons pas encore installé l'équipement.
Donc, nos prochaines étapes seront d'intégrer ces équipements dans les systèmes (IPAM, inventaire), d'organiser l'accès, de générer la configuration et de la déployer.
Dans le prochain article, nous examinerons Netbox — le système d'inventaire et de gestion de l'espace IP dans le DC.
Merci
- À Andreï Glazkov aka @glazgoo pour la relecture et les corrections
- À Alexandr Klimenko aka @v00lk pour la relecture et les corrections
- À Artem Tchernobai pour KDPV
Source : habr.com
