

Cet article vous aidera à comprendre comment fonctionne l'équilibrage de charge dans Kubernetes, ce qui se passe lors du scaling des connexions persistantes et pourquoi il est important de considérer l'équilibrage côté client lorsque vous utilisez HTTP/2, gRPC, RSockets, AMQP ou d'autres protocoles à connexions longues.
Un peu sur la façon dont le trafic est redistribué dans Kubernetes
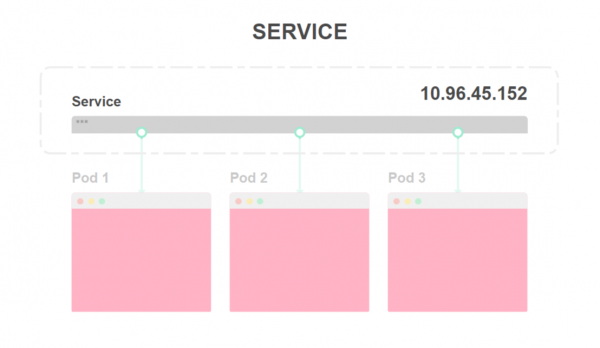
Kubernetes propose deux abstractions pratiques pour le déploiement d'applications : les services (Services) et les déploiements (Deployments).
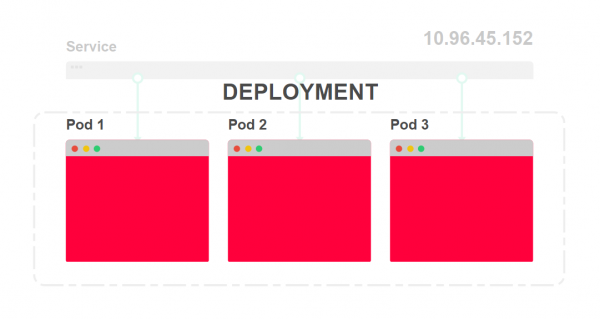
Les déploiements décrivent comment et combien de copies de votre application doivent être exécutées à tout moment. Chaque application est déployée en tant que pod (Pod) et se voit attribuer une adresse IP.
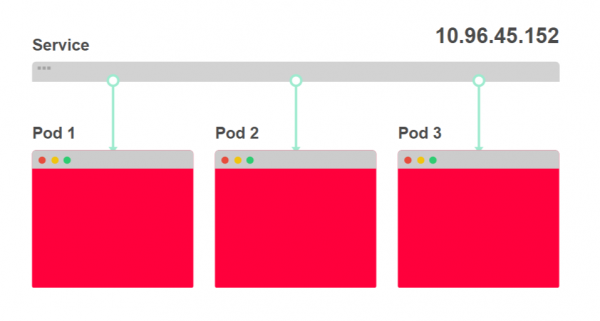
Les services fonctionnent de manière similaire à un équilibreur de charge. Ils sont conçus pour distribuer le trafic entre plusieurs pods.
Voyons à quoi cela ressemble.
- Dans le diagramme ci-dessous, vous voyez trois instances d'une application et un équilibreur de charge :

- L'équilibreur de charge est appelé service (Service), il lui est attribué une adresse IP. Toute requête entrante est redirigée vers l'un des pods :

- Le scénario de déploiement définit le nombre d'instances d'application. Vous n'aurez presque jamais à déployer directement un pod :

- Chaque pod se voit attribuer sa propre adresse IP :

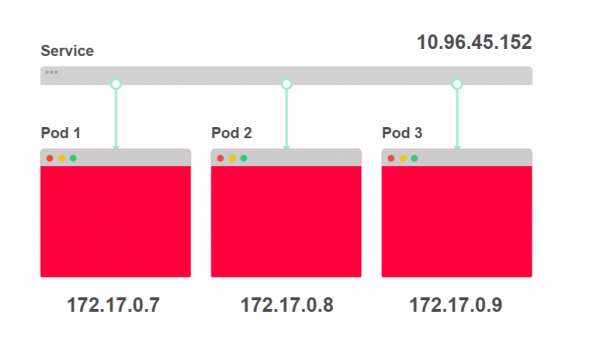
Il est utile de considérer les services comme un ensemble d'adresses IP. Chaque fois que vous accédez à un service, l'une des adresses IP est choisie dans la liste et utilisée comme adresse de destination.
Cela ressemble à ceci.
- Une requête curl à 10.96.45.152 est envoyée au service :

- Le service choisit l'une des trois adresses des pods comme point de destination :

- Le trafic est redirigé vers un pod spécifique :


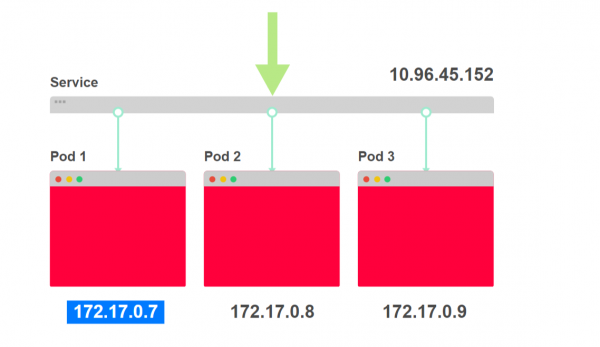
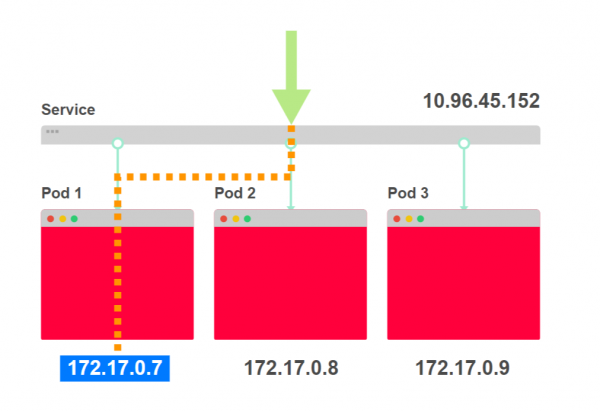
Si votre application se compose d'un front-end et d'un back-end, vous aurez un service et un déploiement pour chacun.
Lorsque le front-end effectue une requête au back-end, il n'a pas besoin de savoir combien de pods sont gérés par le back-end : cela peut être un, dix ou cent.
De plus, le front-end ne connaît pas les adresses des pods gérant le back-end.
Lorsque le front-end effectue une requête au back-end, il utilise l'adresse IP du service du back-end, qui ne change pas.
Voici à quoi cela ressemble.
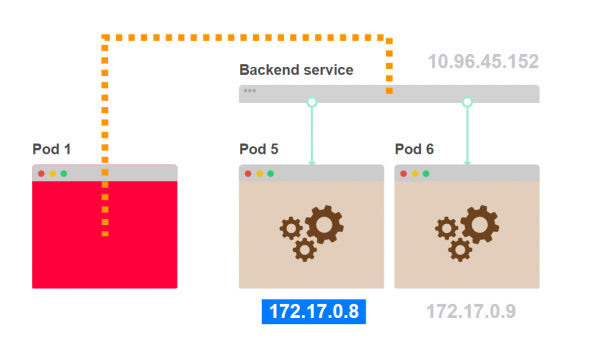
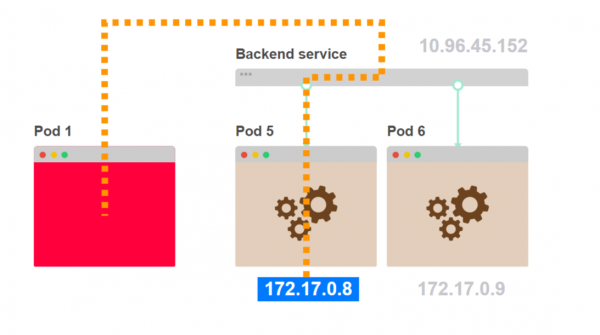
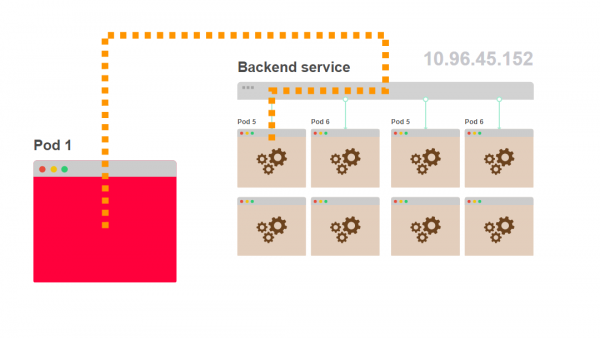
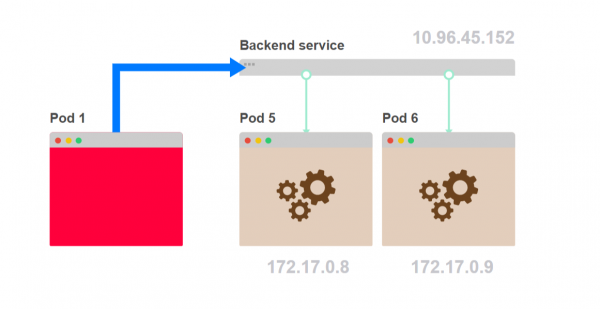
- Le pod 1 demande un composant interne du back-end. Au lieu de choisir un pod spécifique du back-end, il effectue une requête au service :

- Le service choisit un des pods backend comme destination :

- Le trafic passe du pod 1 au pod 5, sélectionné par le service :

- Le pod 1 ne sait pas combien de pods comme le pod 5 sont cachés derrière le service :

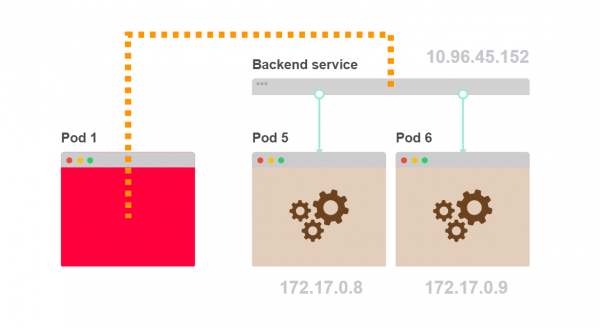
Mais comment le service répartit-il les requêtes ? Apparemment, un équilibrage de charge round-robin est utilisé ? Voyons cela de plus près.
Équilibrage de charge dans les services Kubernetes
Les services Kubernetes n'existent pas. Il n'y a pas de processus auquel une adresse IP et un port sont attribués pour un service.
Vous pouvez le vérifier en accédant à n'importe quel nœud du cluster et en exécutant la commande netstat -ntlp.
Vous ne pourrez même pas trouver l'adresse IP attribuée au service.
L'adresse IP du service se trouve dans la couche de gestion, dans le contrôleur, et est enregistrée dans la base de données — etcd. Cette même adresse est utilisée par un autre composant — kube-proxy.
Kube-proxy reçoit la liste des adresses IP pour tous les services et forme un ensemble de règles iptables sur chaque nœud du cluster.
Ces règles indiquent : « Si nous voyons l'adresse IP du service, il faut modifier l'adresse de destination de la requête et l'envoyer à l'un des pods. »
L'adresse IP du service est utilisée uniquement comme point d'entrée et n'est pas gérée par un quelconque processus écoutant cette adresse IP et ce port.
Examinons cela.
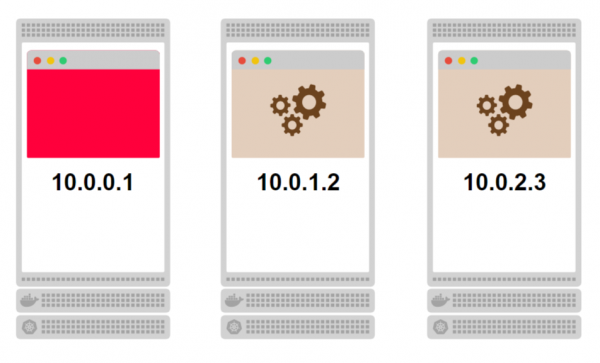
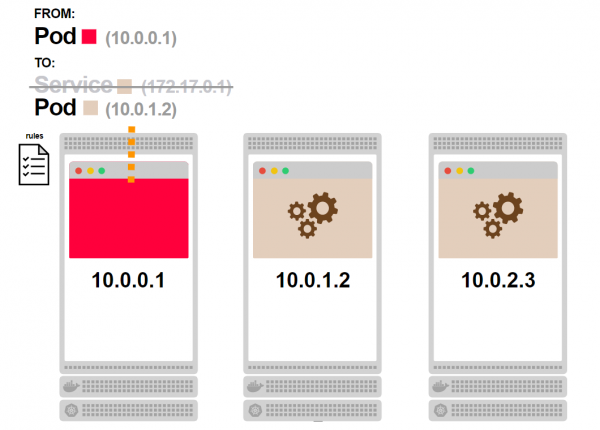
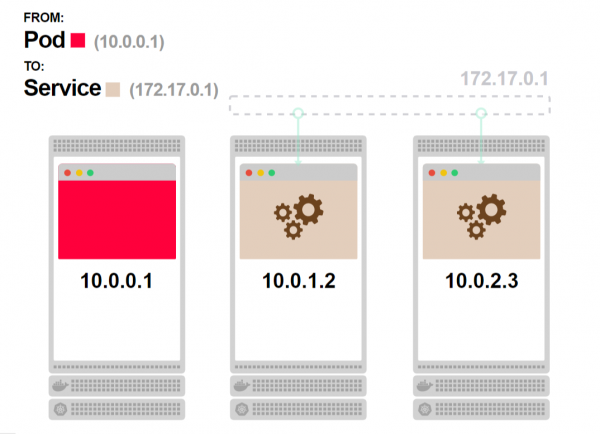
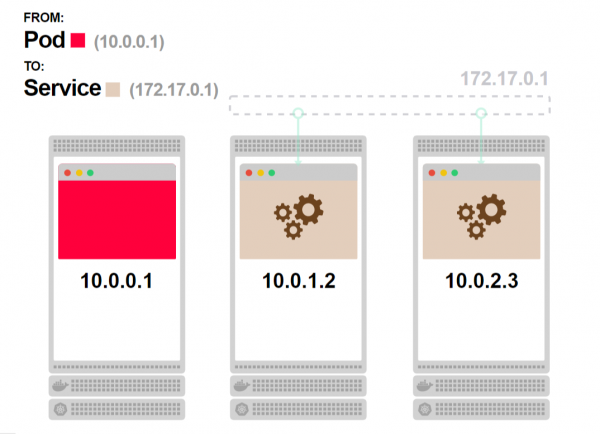
- Considérons un cluster composé de trois nœuds. Sur chaque nœud se trouvent des pods :

- Les pods associés, colorés en beige, font partie du service. Étant donné que le service n'existe pas en tant que processus, il est représenté en gris :

- Le premier pod demande le service et doit se connecter à l'un des pods associés :

- Mais le service n'existe pas, il n'y a pas de processus. Comment cela fonctionne-t-il ?

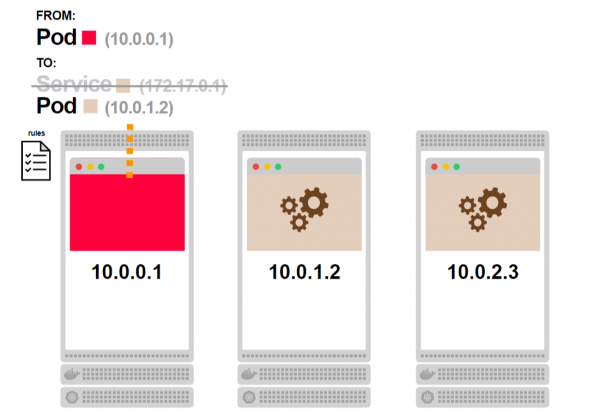
- Avant que la requête ne quitte le nœud, elle passe par les règles iptables :

- Les règles iptables savent qu'il n'y a pas de service et remplacent son adresse IP par l'une des adresses IP des pods associés à ce service :

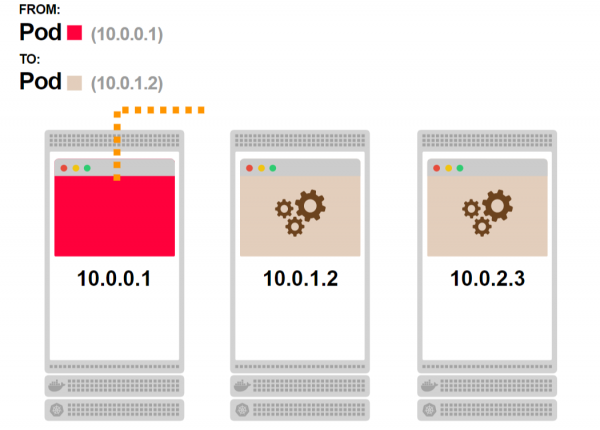
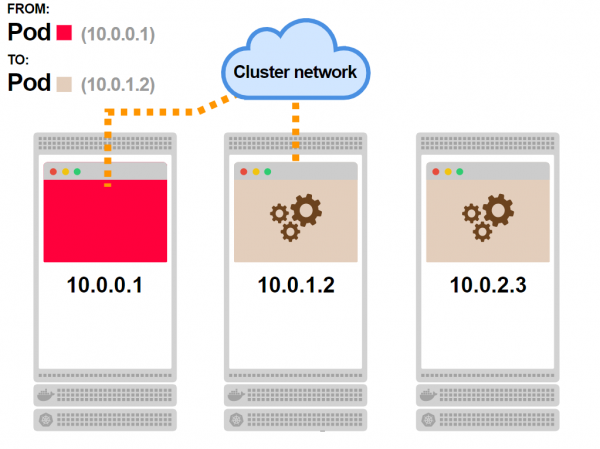
- La requête reçoit une adresse IP valide en tant qu'adresse de destination et est traitée normalement :
- Selon la topologie réseau, la requête atteint finalement le pod :

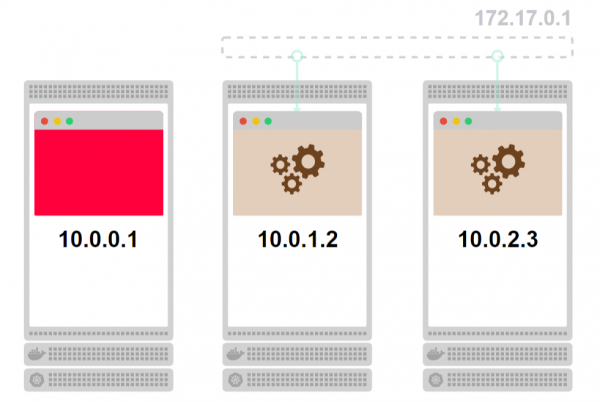
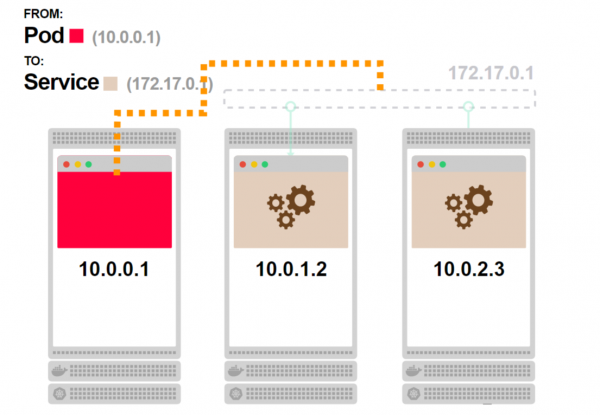
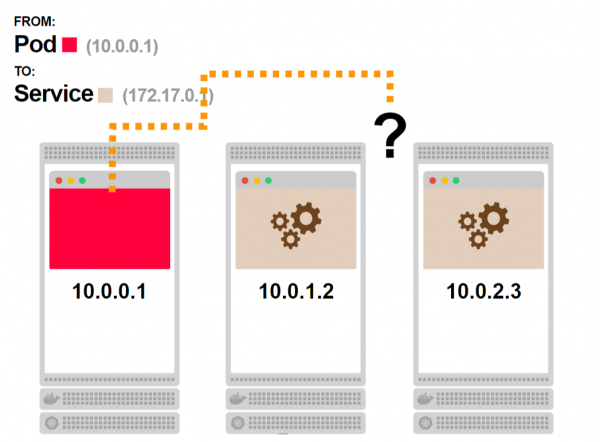
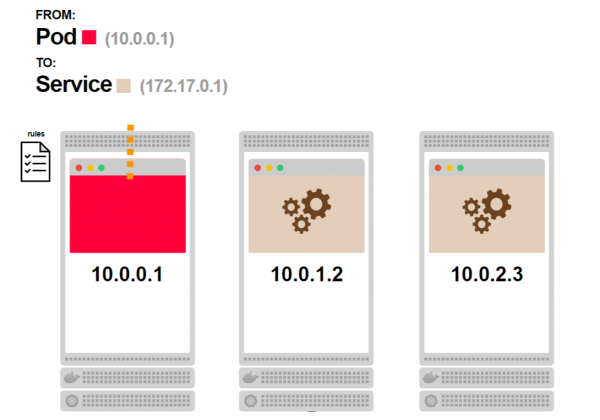
Les iptables savent-ils équilibrer la charge ?
Non, les iptables sont utilisés pour le filtrage et n'ont pas été conçus pour l'équilibrage.
Cependant, il est possible d'écrire un ensemble de règles qui agissent comme .
C'est précisément ce qui est mis en œuvre dans Kubernetes.
Si vous avez trois pods, kube-proxy écrira les règles suivantes :
- Sélectionnez le premier pod avec une probabilité de 33 %, sinon passez à la règle suivante.
- Choisir le deuxième pod avec une probabilité de 50 %, sinon passer à la règle suivante.
- Choisir le troisième pod.
Un tel système entraîne que chaque pod est sélectionné avec une probabilité de 33 %.
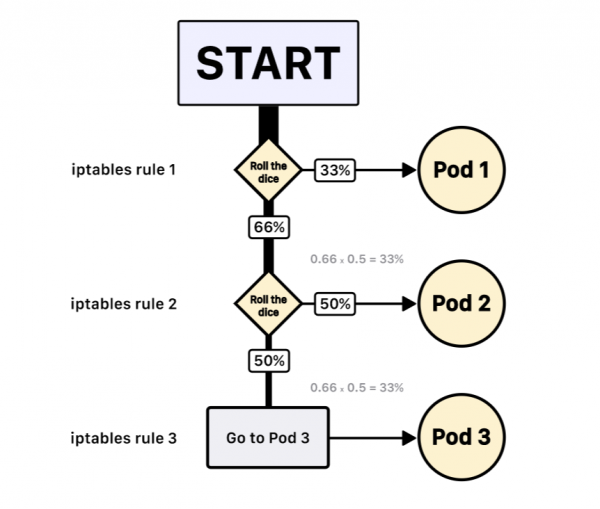
Et il n'y a aucune garantie que le pod 2 sera sélectionné après le pod 1.
Remarque: iptables utilise un module statistique avec une distribution aléatoire. Ainsi, l'algorithme d'équilibrage est basé sur un choix aléatoire.
Maintenant que vous comprenez comment fonctionnent les services, examinons des scénarios de fonctionnement plus intéressants.
Les connexions longues dans Kubernetes ne sont pas évolutives par défaut.
Chaque requête HTTP du frontend vers le backend est traitée par une connexion TCP distincte, qui est ouverte et fermée.
Si le frontend envoie 100 requêtes par seconde au backend, 100 connexions TCP différentes sont ouvertes et fermées.
Il est possible de réduire le temps de traitement des requêtes et de diminuer la charge en ouvrant une seule connexion TCP et en l'utilisant pour toutes les requêtes HTTP suivantes.
Le protocole HTTP inclut une fonctionnalité appelée keep-alive HTTP, ou réutilisation de la connexion. Dans ce cas, une seule connexion TCP est utilisée pour envoyer et recevoir de nombreuses requêtes et réponses HTTP :
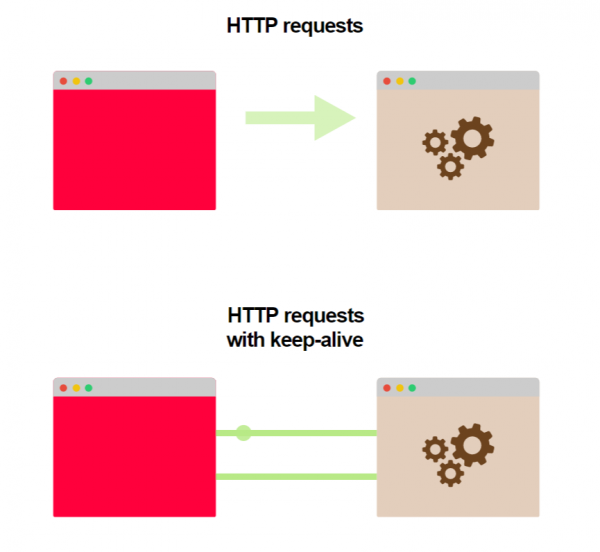
Cette fonctionnalité n'est pas activée par défaut : le serveur et le client doivent être configurés en conséquence.
La configuration elle-même est simple et accessible pour la plupart des langages de programmation et des environnements.
Voici quelques liens vers des exemples dans différents langages :
Que se passera-t-il si nous utilisons keep-alive dans le service Kubernetes ?
Supposons que le frontend et le backend prennent en charge keep-alive.
Nous avons une copie du frontend et trois instances du backend. Le frontend fait la première requête et ouvre une connexion TCP vers le backend. La requête atteint le service, un des pods du backend est sélectionné comme adresse de destination. Le pod du backend envoie une réponse et le frontend la reçoit.
Contrairement à la situation habituelle où la connexion TCP se ferme après la réception de la réponse, celle-ci est maintenant maintenue ouverte pour les requêtes HTTP suivantes.
Que se passera-t-il si le frontend envoie d'autres requêtes au backend ?
Pour transmettre ces requêtes, la connexion TCP ouverte sera utilisée, toutes les requêtes iront vers le même pod du backend, où la première requête a été envoyée.
Le système iptables ne doit-il pas rediriger le trafic ?
Pas dans ce cas.
Lorsqu'une connexion TCP est établie, elle passe par les règles d'iptables qui choisissent le pod backend spécifique auquel le trafic sera dirigé.
Étant donné que toutes les demandes suivantes transitent par une connexion TCP déjà ouverte, les règles d'iptables ne sont plus appelées.
Voyons à quoi cela ressemble.
- Le premier pod envoie une demande au service :

- Vous savez déjà ce qui va suivre. Le service n'existe pas, mais des règles iptables traiteront la demande :
- Un des pods backend sera choisi comme adresse de destination :

- La demande atteint le pod. À ce moment-là, une connexion TCP persistante entre les deux pods sera établie :

- Toute demande suivante du premier pod passera par la connexion déjà établie :

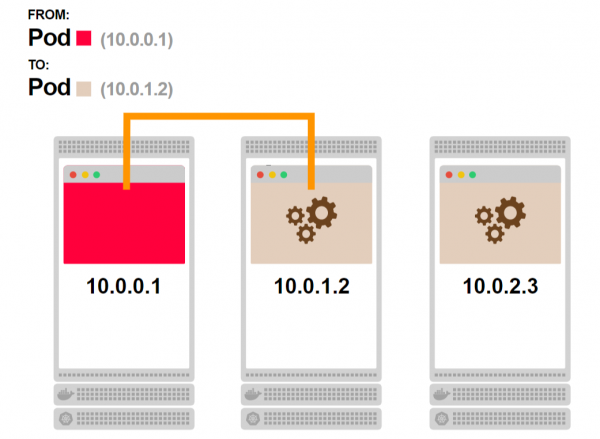
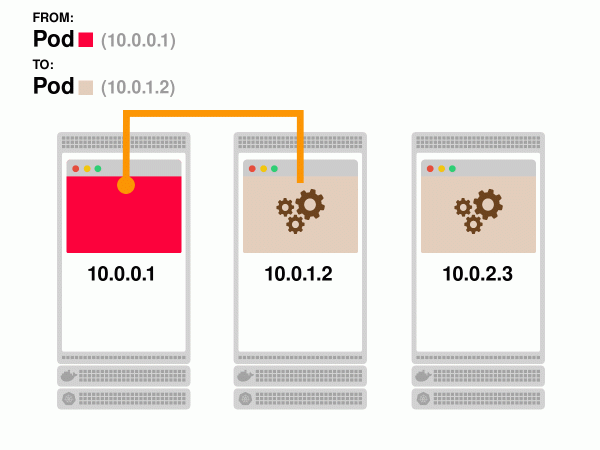
En conséquence, vous obtenez un temps de réponse plus rapide et une plus grande bande passante, mais vous perdez la capacité de scalabilité du backend.
Même si vous avez deux pods en backend, avec une connexion persistante, le trafic sera toujours dirigé vers l'un d'eux.
Peut-on corriger cela ?
Étant donné que Kubernetes ne sait pas comment équilibrer les connexions persistantes, cette tâche vous incombe.
Les services sont un ensemble d'adresses IP et de ports que l'on appelle des points de terminaison.
Votre application peut obtenir la liste des points de terminaison du service et décider comment distribuer les demandes entre eux. Il est possible d'ouvrir une connexion persistante avec chaque pod et d'équilibrer les demandes entre ces connexions par round-robin.
Ou d'appliquer des .
Le code côté client responsable de l'équilibrage doit suivre cette logique :
- Obtenez la liste des points de terminaison du service.
- Pour chaque point de terminaison, ouvrez une connexion persistante.
- Lorsqu'une demande doit être effectuée, utilisez l'une des connexions ouvertes.
- Mettez régulièrement à jour la liste des points de terminaison, créez de nouvelles connexions persistantes ou fermez celles qui sont anciennes en cas de modification de la liste.
Voici à quoi cela ressemblera.
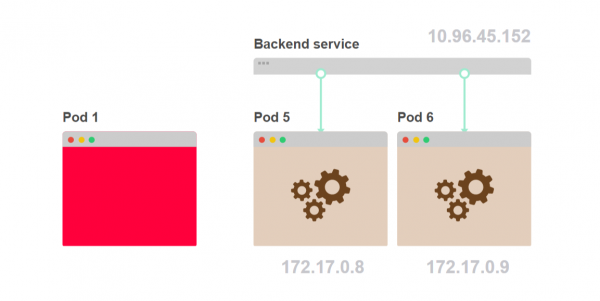
- Au lieu que le premier pod envoie une demande au service, vous pouvez équilibrer les demandes côté client :

- Vous devez écrire du code qui interroge quels pods font partie du service :

- Une fois que vous avez la liste, enregistrez-la côté client et utilisez-la pour vous connecter aux pods :

- Vous êtes responsable de l'algorithme d'équilibrage de charge :
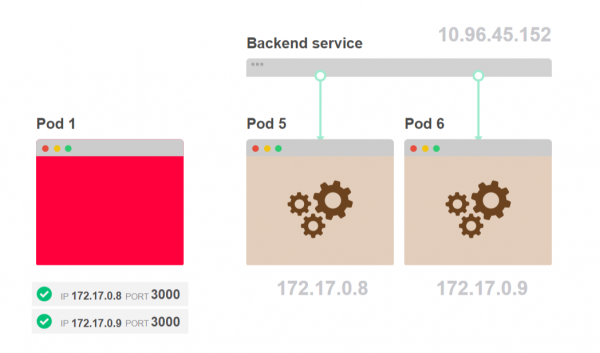
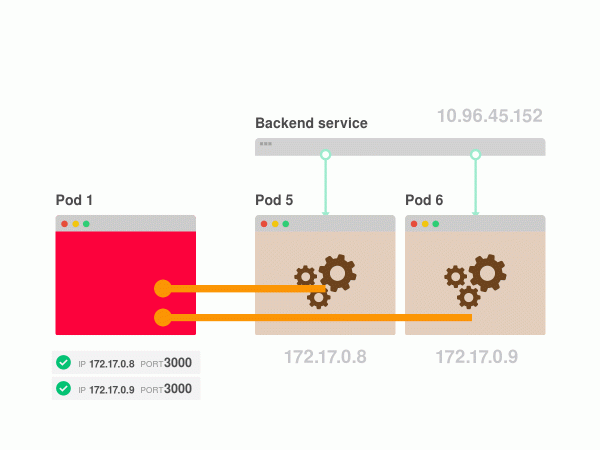
La question se pose maintenant : ce problème ne concerne-t-il que le HTTP keep-alive ?
Équilibrage de charge côté client
HTTP n'est pas le seul protocole à pouvoir utiliser des connexions TCP persistantes.
Si votre application utilise une base de données, la connexion TCP n'est pas ouverte chaque fois que vous devez exécuter une requête ou récupérer un document de la base de données.
Au lieu de cela, une connexion TCP persistante à la base de données est ouverte et utilisée.
Si votre base de données est déployée dans Kubernetes et que l'accès est fourni sous forme de service, vous rencontrerez les mêmes problèmes que ceux décrits dans la section précédente.
Une réplique de base de données sera plus chargée que les autres. Kube-proxy et Kubernetes n'aideront pas à équilibrer les connexions. Vous devez vous occuper de l'équilibrage des requêtes vers votre base de données.
Selon la bibliothèque que vous utilisez pour vous connecter à la base de données, vous pouvez avoir différentes options pour résoudre ce problème.
Voici un exemple d'accès à un cluster de bases de données MySQL depuis Node.js :
var mysql = require('mysql');
var poolCluster = mysql.createPoolCluster();

var endpoints = /* récupérer les endpoints du Service */

for (var [index, endpoint] of endpoints) {
  poolCluster.add(`mysql-replica-${index}`, endpoint);
}

// Effectuer des requêtes à la base de données MySQL clusterisée
Il existe de nombreux autres protocoles utilisant des connexions TCP persistantes :
- WebSockets et WebSockets sécurisés
- HTTP/2
- gRPC
- RSockets
- AMQP
Vous devez déjà être familier avec la plupart de ces protocoles.
Mais si ces protocoles sont si populaires, pourquoi n'y a-t-il pas de solution standardisée pour l'équilibrage ? Pourquoi un changement de logique côté client est-il nécessaire ? Existe-t-il une solution native dans Kubernetes ?
Kube-proxy et iptables sont conçus pour couvrir la plupart des scénarios d'utilisation standard lors d'un déploiement dans Kubernetes. Cela est fait pour la commodité.
Si vous utilisez un service web qui fournit une API REST, vous avez de la chance — dans ce cas, les connexions TCP persistantes ne sont pas utilisées, vous pouvez utiliser n'importe quel service Kubernetes.
Mais dès que vous commencez à utiliser des connexions TCP persistantes, vous devrez comprendre comment répartir équitablement la charge sur les backends. Kubernetes ne contient pas de solutions toutes prêtes à cet effet.
Cependant, il existe certainement des options qui peuvent aider.
Équilibrage des connexions de longue durée dans Kubernetes
Dans Kubernetes, il existe quatre types de services :
- ClusterIP
- NodePort
- LoadBalancer
- Headless
Les trois premiers services fonctionnent sur la base d'une adresse IP virtuelle utilisée par kube-proxy pour établir des règles iptables. Mais la base fondamentale de tous les services est le service de type headless.
Aucun IP n'est associé au service headless ; il fournit seulement un mécanisme pour obtenir une liste d'adresses IP et de ports liés aux pods associés (points d'accès).
Tous les services reposent sur le service headless.
Le service ClusterIP est un service headless avec quelques ajouts :
- La couche de gestion lui attribue une adresse IP.
- Kube-proxy forme les règles iptables nécessaires.
Ainsi, vous pouvez ignorer kube-proxy et utiliser directement la liste des points d'accès obtenue du service headless pour l'équilibrage de charge de votre application.
Mais comment ajouter cette logique à toutes les applications déployées dans le cluster ?
Si votre application est déjà déployée, cette tâche peut sembler impossible. Cependant, il existe une alternative.
Service Mesh peut vous aider.
Vous avez probablement déjà remarqué que la stratégie d'équilibrage de charge côté client est assez standard.
Lorsque l'application démarre, elle :
- Obtient une liste d'adresses IP à partir du service.
- Ouvre et maintient un pool de connexions.
- Met à jour périodiquement le pool en ajoutant ou en retirant des points d'accès.
Une fois que l'application souhaite faire une requête, elle :
- Sélectionne une connexion disponible en utilisant une logique quelconque (par exemple, round-robin).
- Exécute la requête.
Ces étapes fonctionnent pour les connexions WebSockets, gRPC et AMQP.
Vous pouvez extrader cette logique dans une bibliothèque distincte et l'utiliser dans vos applications.
Cependant, vous pouvez aussi utiliser des maillages de services, comme Istio ou Linkerd.
Le Service Mesh complète votre application par un processus qui :
- Recherche automatiquement les adresses IP des services.
- Vérifie les connexions telles que WebSockets et gRPC.
- Équilibre les requêtes en utilisant le bon protocole.
Le Service Mesh aide à gérer le trafic à l'intérieur du cluster, mais il est assez gourmand en ressources. D'autres options incluent l'utilisation de bibliothèques tierces, comme Netflix Ribbon, ou des proxys programmables, comme Envoy.
Que se passe-t-il si l'on ignore les problèmes d'équilibrage ?
Vous pouvez ne pas utiliser l'équilibrage de charge et ne remarquer aucun changement. Examinons quelques scénarios de fonctionnement.
Si vous avez plus de clients que de serveurs, ce n'est pas un si gros problème.
Supposons qu'il y ait cinq clients connectés à deux serveurs. Même sans équilibrage, les deux serveurs seront utilisés :
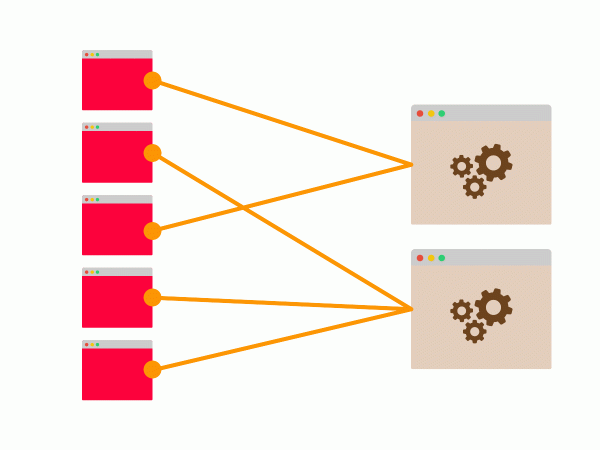
Les connexions peuvent être réparties de manière inégale : il est possible que quatre clients se soient connectés au même serveur, mais il y a de bonnes chances que les deux serveurs soient utilisés.
Ce qui est plus problématique, c'est le scénario inverse.
Si vous avez moins de clients et plus de serveurs, vos ressources peuvent ne pas être suffisamment utilisées, ce qui peut créer un goulot d'étranglement potentiel.
Supposons qu'il y ait deux clients et cinq serveurs. Au mieux, il y aura deux connexions permanentes à deux des cinq serveurs.
Les autres serveurs seront à l'arrêt :
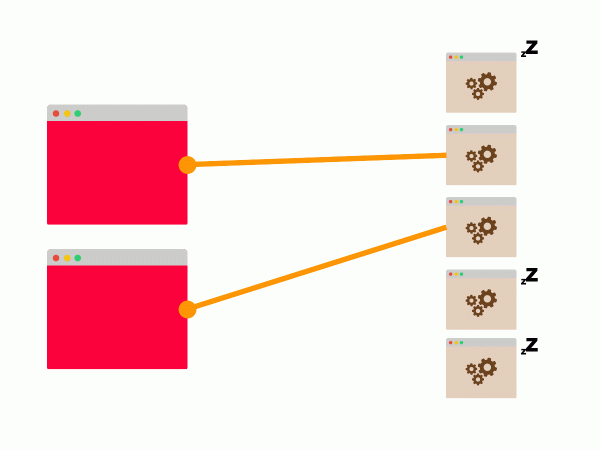
Si ces deux serveurs ne peuvent pas gérer le traitement des requêtes des clients, le scaling horizontal ne sera d'aucune aide.
Conclusion
Les services Kubernetes sont conçus pour fonctionner dans la plupart des scénarios standard d'applications web.
Cependant, dès que vous commencez à travailler avec des protocoles d'applications qui utilisent des connexions TCP permanentes, comme les bases de données, gRPC ou WebSockets, les services ne conviennent plus. Kubernetes ne fournit pas de mécanismes internes pour l'équilibrage de connexions TCP permanentes.
Cela signifie que vous devez écrire des applications en tenant compte de la possibilité d'un équilibrage côté client.
La traduction a été préparée par l'équipe .
Suggestions de lecture supplémentaires:
- .
- .
- .
Source : habr.com
