

Dans les grandes systèmes cloud, la question de l'équilibrage automatique ou de la répartition de la charge sur les ressources de calcul est particulièrement critique. Ce problème a également été pris en compte par Tionix (développeur et opérateur de services cloud, membre du groupe Rostelecom).
Et, comme notre principale plateforme de développement est OpenStack, et que, comme tout le monde, nous sommes paresseux, il a été décidé de trouver un module prêt à l'emploi qui soit déjà inclus dans la plateforme. Nous avons choisi Watcher, que nous avons décidé d'utiliser pour nos besoins.
Pour commencer, examinons les termes et définitions.
Termes et définitions
L'objectif — c'est un résultat final, lisible par l'homme, observable et mesurable, qui doit être atteint. Pour chaque objectif, il existe une ou plusieurs stratégies. Une stratégie est la mise en œuvre d'un algorithme capable de trouver une solution à cet objectif.
Action (Action) — il s'agit d'une tâche élémentaire qui modifie l'état actuel de la ressource gérée cible dans le cluster OpenStack, comme : la migration d'une machine virtuelle (migration), le changement de l'état d'alimentation d'un nœud (change_node_power_state), le changement de l'état du service Nova (change_nova_service_state), le changement de la taille (resize), l'enregistrement d'un message NOP (nop), l'absence d'actions pendant une certaine durée — une pause (sleep), le transfert d'un disque (volume_migrate).
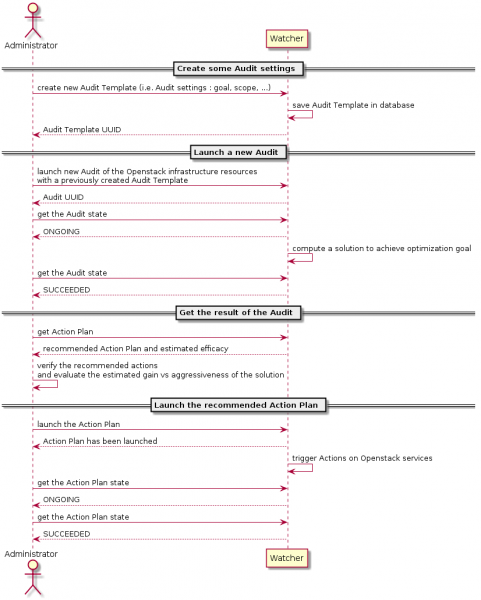
Plan d'action (Action Plan) — un flux d'actions spécifique, réalisé dans un certain ordre pour atteindre un objectif concret. Le plan d'action comprend également une efficacité globale évaluée avec un ensemble d'indicateurs de performance. Le plan d'action est généré par Watcher lors d'un audit réussi, à la suite duquel la stratégie utilisée trouve une solution pour atteindre l'objectif. Le plan d'action se compose d'une liste d'actions séquentielles.
Audit (Audit) — c'est une demande d'optimisation du cluster. L'optimisation est effectuée pour atteindre un objectif dans ce cluster. Pour chaque audit réussi, Watcher génère un plan d'action.
Domaine d'audit (Audit Scope) — est un ensemble de ressources dans le cadre duquel un audit est effectué (zone(s) de disponibilité, agrégateurs de nœuds, nœuds de calcul individuels ou nœuds de stockage, etc.). La portée de l'audit est définie dans chaque modèle. Si la portée de l'audit n'est pas précisée, l'audit est réalisé sur l'ensemble du cluster.
Modèle d'audit (Audit Template) — un ensemble enregistré de paramètres pour effectuer un audit. Les modèles sont nécessaires pour exécuter plusieurs fois des audits avec les mêmes paramètres. Le modèle doit obligatoirement contenir l'objectif de l'audit ; si les stratégies ne sont pas précisées, les stratégies les plus appropriées parmi les stratégies existantes sont choisies.
Cluster (Cluster) — c'est un ensemble de machines physiques qui fournissent des ressources de calcul, des ressources de stockage et des ressources réseau, gérées par un même nœud de contrôle OpenStack.
Modèle de données de cluster (Cluster Data Model, CDM) — c'est une représentation logique de l'état actuel et de la topologie des ressources gérées par le cluster.
Indicateur de performance (Efficacy Indicator) — un indicateur qui indique comment la solution créée par cette stratégie est exécutée. Les indicateurs de performance sont spécifiques à un objectif donné et sont souvent utilisés pour calculer l'efficacité globale du plan d'action final.
Spécification de performance (Efficacy Specification) — un ensemble de caractéristiques spécifiques lié à chaque objectif, qui définit divers indicateurs de performance que la stratégie, assurant l'atteinte de l'objectif correspondant, doit respecter dans sa solution. En effet, chaque solution proposée par la stratégie sera vérifiée par rapport à la spécification avant de calculer son efficacité globale.
Moteur de calcul (Scoring Engine) — c'est un fichier exécutable qui a des entrées clairement définies, des sorties clairement définies et exécute une tâche purement mathématique. Ainsi, le calcul ne dépend pas de l'environnement dans lequel il s'exécute — il donnera le même résultat partout.
Planificateur Watcher (Watcher Planner) — partie du mécanisme de prise de décision de Watcher. Ce module prend un ensemble d'actions générées par la stratégie et crée un plan de flux de travail qui détermine comment planifier dans le temps ces différentes actions et, pour chaque action, quelles sont les conditions préalables.
Objectifs et stratégies de Watcher
L'objectif
Stratégies
Objectif fictif
Stratégie fictive
Stratégie fictive utilisant des moteurs de notation d'exemple
Stratégie fictive avec redimensionnement
Économie d'énergie
Stratégie d'économie d'énergie
Consolidation des serveurs
Consolidation basique des serveurs hors ligne
Stratégie de consolidation de charge de travail VM
Équilibrage de charge
Stratégie de migration d'équilibre de charge
Stratégie d'équilibre de capacité de stockage
Stabilisation de la charge de travail
Voisin bruyant
Voisin bruyant
Optimisation thermique
Stratégie basée sur la température de sortie
Optimisation du flux d'air
Stratégie de migration de flux d'air uniforme
Maintenance matérielle
Migration de zone
Non classifié
Actionneur
Objectif fictif — objectif réservé, utilisé à des fins de test.
Stratégies associées : Stratégie fictive, Stratégie fictive utilisant des moteurs de notation d'exemple et Stratégie fictive avec redimensionnement. La stratégie fictive est utilisée pour les tests d'intégration via Tempest. Cette stratégie n'offre aucune optimisation utile, son seul but est d'utiliser les tests Tempest.
La stratégie fictive utilisant des moteurs de notation d'exemple est similaire à la précédente, différant seulement par l'utilisation d'un "moteur de notation" échantillon qui calcule en utilisant des méthodes d'apprentissage automatique.
La stratégie fictive avec redimensionnement est similaire à la précédente, différant seulement par l'utilisation d'un changement de flavor (migration et redimensionnement).
Non utilisé en production.
Économie d'énergie — minimiser la consommation d'énergie. La stratégie de cet objectif, Stratégie d'économie d'énergie, associée à la Stratégie de consolidation de charge de travail VM (Consolidation des serveurs), est capable d'exécuter des fonctions de gestion de l'alimentation dynamique (DPM), qui économise de l'électricité grâce à la consolidation dynamique des charges de travail même pendant les périodes de faible utilisation des ressources : les machines virtuelles sont déplacées vers un nombre réduit de nœuds, et les nœuds inutiles sont éteints. Après la consolidation, la stratégie propose une solution pour allumer/éteindre les nœuds conformément aux paramètres définis : "min_free_hosts_num" — le nombre de nœuds libres allumés en attente de charge, et "free_used_percent" — le pourcentage de nœuds libres allumés par rapport au nombre de nœuds occupés par des machines. Pour que la stratégie fonctionne, Ironic doit être activé et configuré pour gérer l'allumage/l'extinction de l'alimentation sur les nœuds.
Paramètres de la stratégie
paramètre
le type
par défaut
des commandes.
free_used_percent
Nombre
10.0
le rapport entre le nombre de nœuds de calcul disponibles et le nombre de nœuds de calcul avec des machines virtuelles
min_free_hosts_num
Int
1
nombre minimal de nœuds de calcul disponibles
Le cloud doit avoir au moins deux nœuds. La méthode utilisée est le changement d'état d'alimentation du nœud (change_node_power_state). La stratégie de collecte de métriques n'est pas requise.
La consolidation des serveurs — minimiser le nombre de nœuds de calcul (consolidation). Elle a deux stratégies : Basic Offline Server Consolidation et VM Workload Consolidation Strategy.
La stratégie Basic Offline Server Consolidation minimise le nombre total de serveurs utilisés ainsi que le nombre de migrations.
La stratégie de base nécessite les métriques suivantes :
métrique
service
plugins
commentaire
compute.node.cpu.percent
aucun
cpu_util
aucun
Paramètres de la stratégie : migration_attempts — nombre de combinaisons pour trouver des candidats potentiels à l'arrêt (par défaut, 0, pas de limites), period — intervalle de temps en secondes pour obtenir une agrégation statique à partir de la source de données de métriques (par défaut, 700).
Méthodes utilisées : migration, changement de l'état du service nova (change_nova_service_state).
La stratégie VM Workload Consolidation Strategy est basée sur un algorithme heuristique de premier ajustement (first-fit), qui se concentre sur la charge CPU mesurée et essaie de minimiser les nœuds ayant une charge trop importante ou trop faible en tenant compte des contraintes de capacité des ressources. Cette stratégie offre une solution qui conduit à une utilisation plus efficace des ressources du cluster, en utilisant les quatre étapes suivantes :
- Phase de déchargement — traitement des ressources surconsommées;
- Phase de consolidation — traitement des ressources sous-utilisées;
- Optimisation de la solution — réduction du nombre de migrations;
- Désactivation des nœuds de calcul non utilisés.
La stratégie nécessite les métriques suivantes :
métrique
service
plugins
commentaire
memory
aucun
disk.root.size
aucun
Les métriques suivantes ne sont pas obligatoires, mais augmentent la précision de la stratégie si elles sont disponibles :
métrique
service
plugins
commentaire
memory.resident
aucun
cpu_util
aucun
Paramètres de la stratégie : period — intervalle de temps en secondes pour obtenir une agrégation statique à partir de la source de données de métriques (par défaut, 3600).
Utilise les mêmes méthodes que la stratégie précédente. En savoir plus .
Équilibrage de charge — équilibrer la charge de travail entre les nœuds de calcul. L'objectif comporte trois stratégies : Workload Balance Migration Strategy, Workload stabilization, Storage Capacity Balance Strategy.
La stratégie de migration basée sur la charge de travail lance des migrations de machines virtuelles en fonction de la charge de travail des nœuds virtuels. La décision de transfert est prise chaque fois que le % d'utilisation du CPU ou de la RAM du nœud dépasse le seuil spécifié. La machine virtuelle déplacée doit rapprocher le nœud de la charge de travail moyenne de tous les nœuds.
Exigences
- Utilisation des processeurs physiques ;
- Au moins deux nœuds de calcul physiques ;
- Le composant Ceilometer installé et configuré — ceilometer-agent-compute, fonctionnant sur chaque nœud de calcul, et l'API Ceilometer, ainsi que la collecte des métriques suivantes :
métrique
service
plugins
commentaire
cpu_util
aucun
memory.resident
aucun
Paramètres de la stratégie :
paramètre
le type
par défaut
des commandes.
metrics
Chaîne
'cpu_util'
Les métriques sous-jacentes : 'cpu_util', 'memory.resident'.
seuil
Nombre
25.0
Seuil de charge de travail pour la migration.
period
Nombre
300
Période cumulée de Ceilometer.
La méthode utilisée est la migration.
La stabilisation de la charge de travail — une stratégie visant à stabiliser la charge de travail par l'utilisation de la migration à chaud. La stratégie est basée sur un algorithme d'écart-type et détermine s'il existe une surcharge dans le cluster, réagissant en exécutant des migrations de machines pour stabiliser le cluster.
Exigences
- Utilisation des processeurs physiques ;
- Au moins deux nœuds de calcul physiques ;
- Le composant Ceilometer installé et configuré — ceilometer-agent-compute, fonctionnant sur chaque nœud de calcul, et l'API Ceilometer, ainsi que la collecte des métriques suivantes :
métrique
service
plugins
commentaire
cpu_util
aucun
memory.resident
aucun
La stratégie d'équilibre de capacité de stockage (mise en œuvre depuis Queens) — la stratégie déplace les disques en fonction de la charge des pools Cinder. La décision de transfert est prise chaque fois que le ratio d'utilisation du pool dépasse le seuil spécifié. Le disque déplacé doit rapprocher le pool de la charge moyenne de tous les pools Cinder.
Exigences et restrictions
- Au moins deux pools Cinder ;
- Capacité de migration des disques.
- Modèle de données du cluster — collecteur de données du cluster Cinder.
Paramètres de la stratégie :
paramètre
le type
par défaut
des commandes.
volume_threshold
Nombre
80.0
Valeur seuil des disques pour l'équilibrage des volumes.
La méthode utilisée est la migration de disque (volume_migrate).
Voisin bruyant — identifier et déplacer le 'voisin bruyant' — machine virtuelle de faible priorité qui affecte négativement les performances d'une machine virtuelle de haute priorité en raison d'une utilisation excessive du Last Level Cache. Stratégie propre : Voisin bruyant (paramètre de stratégie utilisé — cache_threshold (valeur par défaut — 35), une migration est lancée lorsque la performance chute au-dessous de la valeur spécifiée. Pour le fonctionnement de la stratégie, il est nécessaire d'activer les métriques LLC (Last Level Cache), dernier serveur Intel prenant en charge le CMT, ainsi que la collecte des métriques suivantes :
métrique
service
plugins
commentaire
cpu_l3_cache
aucun
Nécessite Intel .
Modèle de données de cluster (par défaut) : Collecteur de modèle de données du cluster Nova. Méthode appliquée : migration.
Le travail avec cet objectif via le Dashboard n'est pas entièrement réalisé dans Queens.
Optimisation thermique — optimiser le régime thermique. La température de sortie (air d'échappement) est l'un des systèmes de télémétrie thermique importants pour mesurer l'état de la charge thermique / de travail du serveur. Un seul objectif existe — la stratégie basée sur la température de sortie, qui prend des décisions sur le transfert des charges de travail vers des nœuds avec un régime thermique favorable (température de sortie la plus basse), lorsque la température de sortie des hôtes d'origine atteint un seuil configurable.
Pour faire fonctionner la stratégie, un serveur avec Intel Power Node Manager installé et configuré est nécessaire. , ainsi que la collecte des métriques suivantes :
métrique
service
plugins
commentaire
hardware.ipmi.node.outlet_temperature
IPMI
Paramètres de la stratégie :
paramètre
le type
par défaut
des commandes.
seuil
Nombre
35.0
Seuil de température pour la migration.
period
Nombre
30
Intervalle de temps en secondes pour obtenir une agrégation statistique à partir de la source de données métriques.
La méthode utilisée est la migration.
Optimisation du flux d'air — optimiser le mode de ventilation. La stratégie propre est : Uniform Airflow utilisant la migration en direct. La stratégie commence la migration de la machine virtuelle chaque fois que le flux d'air du ventilateur du serveur dépasse le seuil spécifié.
Pour faire fonctionner la stratégie, il est nécessaire :
- Matériel : nœuds de calcul < avec prise en charge de NodeManager 3.0 ;
- Au moins deux nœuds de calcul ;
- Composant ceilometer-agent-compute et Ceilometer API installé et configuré sur chaque nœud de calcul, capable de rapporter avec succès des métriques telles que le flux d'air, la puissance du système, la température à l'entrée :
métrique
service
plugins
commentaire
hardware.ipmi.node.airflow
IPMI
hardware.ipmi.node.temperature
IPMI
hardware.ipmi.node.power
IPMI
Pour faire fonctionner la stratégie, un serveur avec Intel Power Node Manager 3.0 ou version ultérieure installé et configuré est nécessaire.
Limitations : Le concept n'est pas destiné à la production.
Il est conseillé d'utiliser cet algorithme avec des audits continus, car une seule machine virtuelle est prévue pour migration à chaque itération.
Des migrations en direct sont possibles.
Paramètres de la stratégie :
paramètre
le type
par défaut
des commandes.
threshold_airflow
Nombre
400.0
Seuil de flux d'air pour la migration. L'unité est 0,1 CFM.
threshold_inlet_t
Nombre
28.0
Seuil de température à l'entrée pour la décision de migration.
threshold_power
Nombre
350.0
Seuil de puissance du système pour la décision de migration.
period
Nombre
30
Intervalle de temps en secondes pour obtenir une agrégation statistique à partir de la source de données métriques.
La méthode utilisée est la migration.
Maintenance matériel — maintenance du matériel. La stratégie liée à cet objectif est la migration de zone. Cette stratégie est un outil pour une migration automatique et minimale efficace des machines virtuelles et des disques en cas de nécessité d'entretien du matériel. La stratégie établit un plan d'action en fonction des poids : un ensemble d'actions ayant un poids plus important sera planifié avant d'autres. Il existe deux paramètres de configuration : les poids d'actions (action_weights) et la parallélisation (parallelization).
Restrictions : configuration des poids d'actions et de la parallélisation requise.
Paramètres de la stratégie :
paramètre
le type
par défaut
des commandes.
compute_nodes
array
TSSAA
Nœuds de calcul pour la migration.
storage_pools
array
TSSAA
Nœuds de stockage pour la migration.
parallel_total
integer
6
Nombre total d'actions devant être exécutées parallèlement.
parallel_per_node
integer
2
Nombre d'actions exécutées parallèlement pour chaque nœud de calcul.
parallel_per_pool
integer
2
Nombre d'actions exécutées parallèlement pour chaque pool de stockage.
priority
objet
TSSAA
Liste des priorités pour les machines virtuelles et les disques.
with_attached_volume
boolean
False
False — les machines virtuelles seront transférées après que tous les disques aient été déplacés. True — les machines virtuelles seront transférées après la migration de tous les disques attachés.
Éléments du tableau des nœuds de calcul :
paramètre
le type
par défaut
des commandes.
src_node
string
TSSAA
Nœud de calcul à partir duquel les machines virtuelles seront transférées (obligatoire).
dst_node
string
TSSAA
Nœud de calcul vers lequel les machines virtuelles migrent.
Éléments du tableau des nœuds de stockage :
paramètre
le type
par défaut
des commandes.
src_pool
string
TSSAA
Pool de stockage à partir duquel les disques sont transférés (obligatoire).
dst_pool
string
TSSAA
Pool de stockage vers lequel les disques sont transférés.
src_type
string
TSSAA
Type de disque source (obligatoire).
dst_type
string
TSSAA
Type de disque cible (obligatoire).
Éléments de priorité des objets :
paramètre
le type
par défaut
des commandes.
project
array
TSSAA
Noms des projets.
compute_node
array
TSSAA
Noms des nœuds de calcul.
storage_pool
array
TSSAA
Noms des pools de stockage.
compute
enum
TSSAA
Paramètres de la machine virtuelle [“vcpu_num”, “mem_size”, “disk_size”, “created_at”].
storage
enum
TSSAA
Paramètres des disques [“size”, “created_at”].
Méthodes utilisées — migration des machines virtuelles, migration des disques.
Non classifié — objectif auxiliaire utilisé pour faciliter le processus de développement de stratégie. Ne contient pas de spécifications et peut être utilisé à chaque fois que la stratégie n'est pas encore liée à un objectif existant. Cet objectif peut également être utilisé comme étape transitoire. La stratégie associée à cet objectif est Actuator.
Création d'un nouvel objectif
Moteur de Décision Watcher dispose d'une interface de plugin “cible externe”, qui permet d'intégrer une cible externe pouvant être atteinte par le biais d'une stratégie.
Avant de créer une nouvelle cible, assurez-vous qu'aucune des cibles existantes ne répond à vos besoins.
Créer un nouveau plugin
Pour créer une nouvelle cible, vous devez : étendre la classe cible, implémenter la méthode de la classe get_name () pour renvoyer un identifiant unique de la nouvelle cible que vous souhaitez créer. Cet identifiant unique doit correspondre au nom du point d'entrée que vous déclarerez plus tard.
Ensuite, vous devez implémenter la méthode de la classe get_display_name () pour renvoyer le nom affiché traduit de la cible que vous souhaitez créer (n'utilisez pas de variable pour renvoyer la chaîne traduite afin qu'elle puisse être automatiquement réunie par l'outil de traduction.).
Implémentez la méthode de la classe get_translatable_display_name (), pour renvoyer la clé de traduction (en fait, le nom affiché en anglais) de votre nouvelle cible. La valeur renvoyée doit correspondre à la chaîne traduite dans get_display_name ().
Implémentez sa méthode get_efficacy_specification (), pour renvoyer la spécification d'efficacité de votre cible. La méthode get_efficacy_specification () renvoie une instance de Unclassified (), fournie par Watcher. Cette spécification d'efficacité est utile lors du développement de votre cible, car elle correspond à une spécification vide.
→
Architecture de Watcher (plus de détails ).
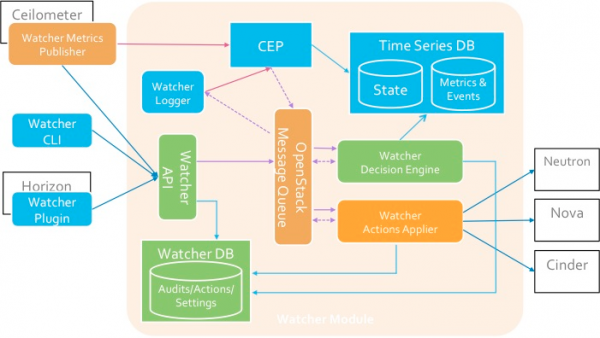
Composants
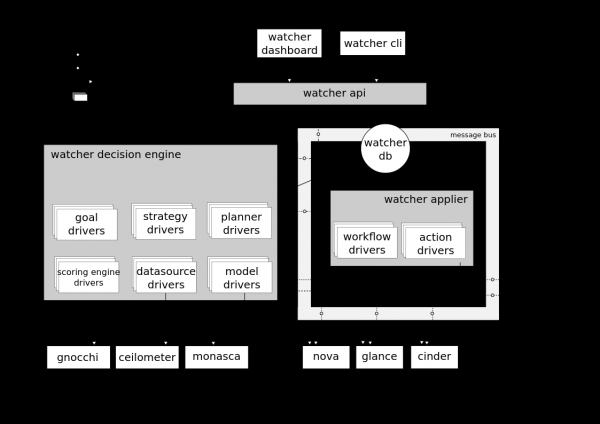
API Watcher — composant implémentant l'API REST fournie par Watcher. Mécanismes d'interaction : CLI, plugin Horizon, SDK Python.
Base de Données Watcher — base de données de Watcher.
Applier Watcher — composant mettant en œuvre l'exécution du plan d'action créé par le composant Moteur de Décision Watcher.
Moteur de Décision Watcher — composant responsable du calcul d'un ensemble d'actions potentielles d'optimisation à exécuter pour atteindre l'objectif d'audit. Si aucune stratégie n'est spécifiée, le composant choisit lui-même la plus appropriée.
Éditeur de Métriques Watcher — composant qui collecte et calcule certaines métriques ou événements et les publie à l'endpoint CEP. La fonctionnalité du composant peut également être fournie par l'éditeur Ceilometer.
Moteur de Traitement d'Événements Complexes (CEP) — moteur de traitement d'événements complet. Pour des raisons de performance, il peut y avoir plusieurs instances de CEP Engine fonctionnant simultanément, chacune traitant un type spécifique de métrique / événement. Dans le système Watcher, CEP déclenche deux types d'actions : — enregistrer les événements / métriques pertinents dans la base de données de séries temporelles ; — envoyer les événements pertinents au composant Watcher Decision Engine, lorsque cet événement peut influencer le résultat de la stratégie d'optimisation actuelle, car le cluster Openstack n'est pas un système statique.
L'interaction entre les composants se fait via le protocole AMQP.
→
Schéma d'interaction avec Watcher
Résultats des tests de Watcher
- Sur la page Optimization — Action plans, une erreur 500 se produit (tant sur un Queens vierge que sur un stand avec des modules Tionic), elle n'apparaît qu'après le lancement de l'audit et la génération du plan d'actions, la page vide s'ouvre normalement.
- Dans l'onglet Action details, des erreurs surviennent, impossible d'obtenir l'objectif et la stratégie d'audit (tant sur un Queens vierge que sur un stand avec des modules Tionic).
- Les audits avec l'objectif Dummy (tests) sont créés et lancés correctement, les plans d'actions sont générés.
- Les audits avec l'objectif Unclassified ne sont pas créés, car l'objectif n'est pas fonctionnel et est destiné à un réglage intermédiaire lors de la création de nouvelles stratégies.
- Les audits avec l'objectif Workload Balancing (stratégie de balance de capacité de stockage) sont créés avec succès, cependant, le plan d'actions n'est pas généré. L'optimisation des pools de stockage n'est pas requise.
- Les audits avec l'objectif Workload Balancing (stratégie de migration de balance de charge de travail) sont créés avec succès, cependant, le plan d'actions n'est pas généré.
- Les audits avec l'objectif Workload Balancing (stratégie de stabilization de charge de travail) échouent.
- Les audits avec l'objectif Noisy Neighbor sont créés avec succès, cependant, le plan d'actions n'est pas généré.
- Les audits avec l'objectif Hardware maintenance sont créés avec succès, le plan d'actions n'est pas généré dans son intégralité (les indicateurs de performance sont générés, mais la liste d'actions elle-même ne l'est pas).
- Les modifications dans les configs nova.conf (dans la section par défaut compute_monitors = cpu.virt_driver) sur les nœuds de calcul et de contrôle ne corrigent pas les erreurs.
- Les audits avec l'objectif Server Consolidation (stratégie Basic) échouent également.
- Les audits avec l'objectif Server Consolidation (stratégie de consolidation de charge de travail VM) échouent. Dans les logs, une erreur de récupération des données sources. Discussion de l'erreur, en particulier, .
Nous avons essayé de spécifier dans le fichier de configuration de Watcher (cela n’a pas aidé - résultat des erreurs sur toutes les pages d'Optimization, revenir au contenu d'origine du fichier de configuration ne corrige pas la situation) :[watcher_strategies.basic]
datasource = ceilometer, gnocchi - Les audits dans le but de Saving Energy échouent avec une erreur. Selon les journaux, le problème vient de l'absence d'Ironic, cela ne fonctionnera pas sans service baremetal.
- Les audits pour Thermal Optimization échouent avec une erreur. Le traceback est le même que pour Server Consolidation (stratégie de consolidation de charge de travail VM) (erreur de données source)
- Les audits pour Airflow Optimization échouent avec une erreur.
On rencontre également les erreurs suivantes lors de la fin de l'audit. Le traceback se trouve dans les journaux decision-engine.log (état du cluster non défini).
→ Discussion sur l'erreur
Conclusion
Le résultat de nos deux mois de recherches est que pour obtenir un système d'équilibrage de charge complet et fonctionnel, nous devrons, dans ce domaine, nous consacrer à l'amélioration des outils pour la plateforme Openstack.
Watcher s'est révélé être un produit sérieux et en rapide développement avec un énorme potentiel, pour une utilisation complète de lequel un travail important et sérieux sera nécessaire.
Mais nous en reparlerons dans les prochains articles de la série.
Source : habr.com
