

KDB+, produit de l'entreprise est une base de données en colonne, à la fois largement connue dans certains cercles et extrêmement rapide, conçue pour le stockage de séries temporelles et les calculs analytiques basés sur celles-ci. À l'origine, elle a rencontré (et continue de rencontrer) un immense succès dans le secteur financier — les 10 plus grandes banques d'investissement et de nombreux fonds spéculatifs, bourses et autres organisations l'utilisent. Récemment, KX a décidé d'élargir sa clientèle et propose désormais des solutions dans d'autres domaines où de grandes quantités de données sont ordonnées dans le temps ou d'une autre manière — télécommunications, bio-informatique, fabrication, etc. Ils sont notamment devenus partenaires de l'équipe Aston Martin Red Bull Racing en Formule 1, où ils aident à collecter et traiter les données des capteurs des voitures et à analyser les tests en soufflerie. Dans cet article, je vais raconter quelles sont les caractéristiques de KDB+ qui la rendent ultra-performante, pourquoi les entreprises sont prêtes à dépenser beaucoup d'argent pour elle et, enfin, pourquoi ce n'est en réalité pas une base de données.
Dans cet article, je vais essayer de donner un aperçu de ce qu'est KDB+, quelles possibilités et limites elle a, et quelle est son utilité pour les entreprises souhaitant traiter de grands volumes de données. Je ne plongerai pas dans les détails de la mise en œuvre de KDB+ ni dans ceux de son langage de programmation Q. Ces deux sujets sont très vastes et méritent des articles séparés. On peut trouver beaucoup d'informations sur ces sujets sur le site code.kx.com, y compris un livre sur Q — Q For Mortals (voir le lien ci-dessous).
Certains termes
- Base de données en mémoire. Base de données qui stocke les données dans la mémoire vive pour accélérer l'accès. Les avantages de ce type de base sont évidents, mais les inconvénients incluent la possibilité de perte de données et la nécessité de disposer de beaucoup de mémoire sur le serveur.
- Base de données en colonne. Base de données où les données sont stockées par colonnes et non par enregistrements. Le principal avantage de ce type de base est que les données d'une même colonne sont stockées ensemble sur le disque et en mémoire, ce qui accélère considérablement leur accès. Il n'est pas nécessaire de charger les colonnes qui ne sont pas utilisées dans la requête. Le principal inconvénient est qu'il est difficile de modifier et de supprimer des enregistrements.
- Série temporelle. Les données avec une colonne de type date ou heure. En général, pour ce type de données, il est important de respecter l'ordre chronologique afin de pouvoir facilement déterminer quelle entrée précède ou suit l'entrée actuelle, ou pour appliquer des fonctions dont le résultat dépend de l'ordre des enregistrements. Les bases de données classiques reposent sur un principe complètement différent — la représentation d'un ensemble d'enregistrements comme un ensemble, où l'ordre des enregistrements n'est en principe pas défini.
- Vecteur. Dans le contexte de KDB+, c'est une liste d'éléments de type atomique unique, comme des nombres. En d'autres termes, un tableau d'éléments. Les tableaux, contrairement aux listes, peuvent être stockés de manière compacte et traités à l'aide d'instructions vectorielles du processeur.
Contexte historique
La société KX a été fondée en 1993 par Arthur Whitney, qui auparavant travaillait à la banque Morgan Stanley sur le langage A+, le successeur d'APL — un langage très original et populaire à l'époque dans le domaine financier. Bien sûr, chez KX, Arthur a continué dans la même veine et a créé le langage fonctionnel vectoriel K, guidé par des idées de radical minimalisme. Les programmes en K ressemblent à un ensemble désordonné de signes de ponctuation et de symboles spéciaux, le sens des signes et des fonctions dépend du contexte, et chaque opération porte en elle beaucoup plus de sens que dans les langages de programmation habituels. Grâce à cela, un programme en K occupe un minimum d'espace — quelques lignes peuvent remplacer des pages de texte d'un langage verbeux comme Java — et constitue une réalisation hyper-concentrée d'un algorithme.
Une fonction en K implémentant la majeure partie d'un générateur de parseur LL1 selon une grammaire donnée :
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/1_r),"]";""]]}
Cette philosophie d'extrême efficacité avec un minimum de mouvement, Arthur l'a également incarnée dans KDB+, qui est apparue en 2003 (je pense qu'il est maintenant clair d'où vient la lettre K dans le nom) et qui n'est rien d'autre qu'un interpréteur de la quatrième version du langage K. Au-dessus de K, une version plus agréable à l'œil appelée Q a été ajoutée. Q prend également en charge un dialecte spécifique de SQL — QSQL, et l'interpréteur prend en charge les tables en tant que type de données système, ainsi que les outils de gestion des tables en mémoire et sur disque, etc.
Ainsi, du point de vue de l'utilisateur, KDB+ est simplement un interpréteur du langage Q avec prise en charge des tables et des expressions similaires à SQL dans le style de LINQ de C#. C'est la principale distinction de KDB+ par rapport aux autres bases de données et son principal avantage concurrentiel, souvent négligé. Ce n’est pas une base de données + un langage auxiliaire, mais un véritable langage de programmation puissant + un support intégré pour les fonctions de base de données. Cette distinction jouera un rôle déterminant lors de l'énumération de tous les avantages de KDB+. Par exemple...
Taille
Pour les normes modernes, KDB+ a une taille simplement microscopique. C'est littéralement un fichier exécutable de moins d'un mégaoctet et un petit fichier texte avec quelques fonctions système. Réellement — moins d'un mégaoctet, et pour ce programme, les entreprises paient des dizaines de milliers de dollars par an pour un processeur sur le serveur.
- Cette taille permet à KDB+ de fonctionner parfaitement sur n'importe quel matériel — du micro-ordinateur Pi aux serveurs avec des téraoctets de mémoire. Cela n’affecte en rien la fonctionnalité ; de plus, Q démarre instantanément, ce qui permet de l’utiliser également comme un langage de script.
- Avec une telle taille, l'interpréteur Q peut entièrement tenir dans le cache du processeur, ce qui accélère l'exécution des programmes.
- Avec une telle taille de fichier exécutable, le processus Q occupe très peu de place en mémoire, et on peut les exécuter par centaines. De plus, si nécessaire, Q peut également gérer des dizaines ou des centaines de gigaoctets de mémoire dans le cadre d'un seul processus.
Polyvalence
Q convient parfaitement à une grande variété de tâches. Le processus Q peut servir de base de données historique et fournir un accès rapide à des téraoctets d'informations. Par exemple, nous avons des dizaines de bases historiques, dont certaines contiennent plus de 100 gigaoctets de données non compressées pour une seule journée. Cependant, dans des limites raisonnables, une requête à la base sera exécutée en dizaines à centaines de millisecondes. En général, nous avons un délai d'attente universel pour les requêtes utilisateur de 30 secondes, et ce cas se produit très rarement.
Avec la même aisance, Q peut être une base de données en mémoire. L'ajout de nouvelles données aux tables en mémoire se fait si rapidement que le facteur limitant est les requêtes des utilisateurs. Les données dans les tables sont stockées par colonnes, ce qui signifie que toute opération sur une colonne utilisera pleinement le cache du processeur. De plus, dans KX, nous avons essayé de réaliser toutes les opérations de base comme les opérations arithmétiques via des instructions vectorielles du processeur, maximisant leur vitesse. Q peut également effectuer des tâches non typiques des bases de données — par exemple, traiter des données en streaming et calculer en « temps réel » (avec un délai de plusieurs dizaines de millisecondes à quelques secondes selon la tâche) diverses fonctions d'agrégation pour des instruments financiers sur différents intervalles de temps, ou construire un modèle d'impact d'une transaction réalisée sur le marché et en effectuer le profilage presque immédiatement après son exécution. Dans ce type de tâches, c'est souvent la nécessité de synchroniser des données provenant de différentes sources qui occasionne le principal délai. Une grande rapidité est atteinte grâce au fait que les données et les fonctions qui les traitent se trouvent dans un même processus, et le traitement se résume à l'exécution de plusieurs expressions QSQL et de jointures, qui ne sont pas interprétées mais exécutées en code binaire.
Enfin, il est possible d'écrire n'importe quel processus de service sur Q. Par exemple, des processus Gateway qui distribuent automatiquement les requêtes des utilisateurs aux bases de données et serveurs appropriés. Le programmeur a une totale liberté pour реализовать n'importe quel algorithme pour la répartition, la priorisation, la tolérance aux pannes, les droits d'accès, les quotas et tout ce qui lui plaît. Le principal problème ici est qu'il faudra tout cela implémenter soi-même.
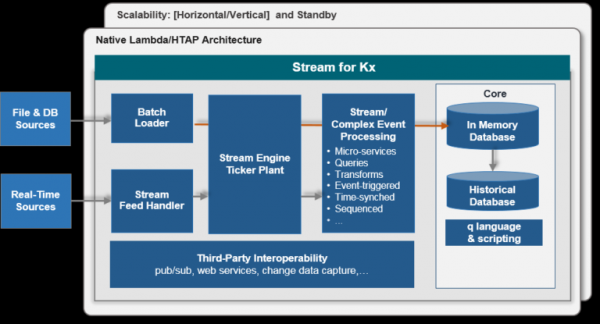
À titre d'exemple, je vais énumérer les types de processus que nous avons. Tous sont utilisés activement et travaillent ensemble, unissant en un tout des dizaines de bases différentes, traitant des données provenant de multiples sources et servant des centaines d'utilisateurs et d'applications.
- Connecteurs (feedhandler) aux sources de données. Ces processus utilisent généralement des bibliothèques externes, qui sont chargées dans Q. L'interface C en Q est extrêmement simple et permet de créer sans effort des fonctions proxy pour n'importe quelle bibliothèque C/C++. Q est suffisamment rapide pour gérer, par exemple, le traitement des flux de messages FIX de toutes les bourses européennes en même temps.
- Distributeurs de données (tickerplant), qui servent de lien intermédiaire entre les connecteurs et les consommateurs. En même temps, ils écrivent les données entrantes dans un journal binaire spécial, assurant la résilience des consommateurs face aux pertes de connexion ou aux redémarrages.
- Bases de données en mémoire (rdb). Ces bases offrent un accès très rapide aux données brutes fraîches, les stockant en mémoire. En général, elles accumulent des données dans des tables tout au long de la journée et les réinitialisent la nuit.
- Bases de données persistantes (pdb). Ces bases permettent de conserver les données de la journée en base historique. En général, contrairement aux rdb, elles ne stockent pas les données en mémoire, mais utilisent un cache spécial sur disque pendant la journée et copient les données à minuit dans la base historique.
- Bases de données historiques (hdb). Ces bases permettent d'accéder aux données des jours, mois et années précédents. Leur taille (en jours) est limitée uniquement par la capacité des disques durs. Les données peuvent être situées n'importe où, notamment sur différents disques pour accélérer l'accès. Il est possible de compresser les données en utilisant plusieurs algorithmes à choix. La structure de la base est bien documentée et simple, les données étant stockées colonne par colonne dans des fichiers ordinaires, ce qui permet de les traiter, y compris à l'aide des outils du système d'exploitation.
- Bases de données avec informations agrégées. Elles stockent diverses agrégations, généralement groupées par nom d'instrument et intervalle de temps. Les bases en mémoire mettent à jour leur état à chaque message entrant, tandis que les historiques conservent les données précalculées pour accélérer l'accès aux données historiques.
- Enfin, processus gateway, qui prennent en charge des applications et des utilisateurs. Q permet une gestion entièrement asynchrone des messages entrants, leur répartition dans des bases de données, la vérification des droits d'accès, etc. Je souligne que les messages ne sont pas limités et ne sont souvent pas des expressions SQL, comme c'est le cas dans d'autres bases de données. Le plus souvent, l'expression SQL est cachée dans une fonction spéciale et est construite en fonction des paramètres demandés par l'utilisateur — il y a conversion de temps, filtrage, les données sont normalisées (par exemple, le prix des actions est ajusté en cas de versement de dividendes), etc.
Architecture typique pour un type de données :
Vitesse
Bien que Q soit un langage interprété, c'est aussi un langage vectoriel. Cela signifie que de nombreuses fonctions intégrées, en particulier arithmétiques, acceptent des arguments de toute forme — nombres, vecteurs, matrices, listes, et l'on s'attend à ce que le programmeur réalise le programme comme des opérations sur des tableaux. Dans un tel langage, si vous additionnez deux vecteurs de un million d'éléments, il n'a plus d'importance que le langage soit interprété, l'addition sera effectuée par une fonction binaire ultra-optimisée. Étant donné que la majorité du temps dans les programmes Q est consacrée aux opérations sur les tables utilisant ces fonctions vectorisées de base, nous avons une vitesse de fonctionnement très décente, permettant de traiter d'énormes volumes de données même dans un seul processus. C'est comparable aux bibliothèques mathématiques en Python — bien que Python soit un langage plutôt lent, il existe de nombreuses bibliothèques excellentes comme numpy, qui permettent de traiter des données numériques à la vitesse d'un langage compilé (au fait, numpy est idéologiquement proche de Q).
En outre, KX a porté une attention particulière à la conception des tables et à l'optimisation de leur utilisation. Tout d'abord, plusieurs types d'index sont supportés, qui sont pris en charge par des fonctions intégrées et peuvent être appliqués non seulement aux colonnes des tables, mais aussi à n'importe quels vecteurs — regroupement, tri, attribut d'unicité et regroupement spécial pour les bases de données historiques. L'index est appliqué de manière élémentaire et est automatiquement ajusté lors de l'ajout d'éléments dans une colonne/vecteur. Les index peuvent être appliqués avec succès aux colonnes des tables tant en mémoire qu sur disque. Lors de l'exécution d'une requête QSQL, les index sont utilisés automatiquement si possible. Deuxièmement, le travail avec des données historiques se fait à travers un mécanisme de mappage de fichiers du système d'exploitation (memory map). De grandes tables ne sont jamais chargées en mémoire, au lieu de cela, les colonnes nécessaires sont directement mappées en mémoire et seule la partie qui est réellement nécessaire (ce qui est aidé notamment par les index) est chargée. Pour le programmeur, il n'y a pas de différence entre les données étant en mémoire ou non, le mécanisme de travail avec mmap est entièrement caché dans les entrailles de Q.
KDB+ est une base de données non relationnelle, les tables peuvent contenir des données arbitraires, tout en maintenant l'ordre des lignes dans la table lors de l'ajout de nouveaux éléments, ce qui doit être utilisé lors de l'écriture de requêtes. Cette caractéristique est particulièrement nécessaire pour le travail avec des séries temporelles (données boursières, télémétrie, journaux d'événements), car si les données sont triées par le temps, l'utilisateur n'a pas besoin d'appliquer des astuces SQL pour trouver dans la table la première ou la dernière ligne temporelle ou N lignes, déterminer quelle ligne suit la N-ème ligne, etc. Les jointures de tables sont encore plus simplifiées, par exemple, trouver pour 16000 transactions VOD.L (Vodafone) le dernier cours dans une table de 500 millions d'éléments prend environ une seconde sur le disque et une dizaine de millisecondes en mémoire.
Un exemple de jointure par le temps — la table des quotes est mappée en mémoire, donc il n'est pas nécessaire de spécifier VOD.L dans le where, on utilise implicitement l'index sur la colonne sym et le fait que les données sont triées par le temps. Presque toutes les jointures dans Q sont des fonctions ordinaires, et non pas une partie de l'expression select :
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Enfin, il convient de noter que les ingénieurs de KX, à commencer par Arthur Whitney lui-même, sont réellement obsédés par l'efficacité et font tout pour tirer le meilleur parti des fonctionnalités standard de Q et optimiser les modèles d'utilisation les plus courants.
Conclusion
KDB+ est populaire auprès des entreprises principalement en raison de sa polyvalence exceptionnelle — elle fonctionne aussi bien comme base de données en mémoire que comme base de stockage de téraoctets de données historiques, ainsi que comme plateforme d'analyse de données. Grâce au traitement des données directement dans la base, une grande rapidité et des économies de ressources sont réalisées. Un langage de programmation complet, intégré aux fonctions de la base de données, permet de réaliser sur une seule plateforme l'ensemble des processus nécessaires — de l'acquisition de données à la traitement des requêtes des utilisateurs.
Informations supplémentaires
Inconvénients
Un inconvénient majeur de KDB+/Q est la haute barrière d'entrée. Le langage a une syntaxe étrange, certaines fonctions sont fortement surchargées (par exemple, value a environ 11 usages différents). Surtout, il nécessite une approche radicalement différente de l'écriture de programmes. Dans un langage vectoriel, il faut constamment penser en termes de transformations de tableaux, tous les boucles doivent être mises en œuvre via plusieurs variantes des fonctions map/reduce (appelées adverbs dans Q), et il ne faut jamais essayer d'économiser en remplaçant des opérations vectorielles par des opérations atomiques. Par exemple, pour trouver l'index de la N-ième occurrence d'un élément dans un tableau, on doit écrire :
1. (where element=vector)[N]
bien que cela semble terriblement inefficace selon les normes de C/Java (= cela crée un vecteur booléen, où where retourne les indices des éléments true dans celui-ci). Mais cette rédaction rend le sens de l'expression plus clair et vous utilisez des opérations vectorielles rapides au lieu d'opérations atomiques lentes. La différence conceptuelle entre un langage vectoriel et les autres est comparable à la différence entre les approches impérative et fonctionnelle en programmation, et il faut s'y préparer.
Certains utilisateurs peuvent également être mécontents de QSQL. En effet, il ressemble seulement à un vrai SQL. En réalité, il s'agit simplement d'un interpréteur d'expressions SQL-like qui ne prend pas en charge l'optimisation des requêtes. L'utilisateur doit lui-même écrire des requêtes optimales, ce qui n'est pas à la portée de tout le monde. D'un autre côté, il est toujours possible d'écrire soi-même une requête optimale, plutôt que de compter sur une boîte noire d'optimisation.
Un point positif est que le livre sur Q — Q For Mortals est disponible gratuitement sur , où de nombreux autres matériels utiles sont également rassemblés.
Un autre gros inconvénient est le coût de la licence. Cela représente des dizaines de milliers de dollars par an pour un CPU. Seules de grandes entreprises peuvent se permettre de telles dépenses. Récemment, KX a rendu sa politique de licence plus flexible et permet de payer uniquement pour le temps d'utilisation ou de louer KDB+ dans les nuages de Google et Amazon. KX propose également un téléchargement. (version 32 bits ou 64 bits sur demande).
Concurrents
Il existe de nombreuses bases de données spécialisées, construites sur des principes similaires : colonnes, en mémoire, et orientées vers de très grands volumes de données. Le problème est qu'il s'agit précisément de bases de données spécialisées. Un exemple marquant est Clickhouse. Cette base de données partage un principe de stockage des données sur disque et de construction d'index semblable à celui de KDB+, certains de ses requêtes sont exécutées plus rapidement que celles de KDB+, bien que cela ne soit pas significatif. Mais même en tant que base de données, Clickhouse est plus spécialisée que KDB+ — analyse web contre séries temporelles arbitraires (cette distinction est très importante, car c'est pour cela, par exemple, qu'il n'est pas possible d'utiliser l'ordre des enregistrements dans Clickhouse). Cependant, l'essentiel est que Clickhouse ne possède pas l'universalité de KDB+, le langage qui permettrait de traiter les données directement dans la base, sans les charger au préalable dans une application distincte, de construire des expressions SQL arbitraires, d'appliquer des fonctions personnalisées dans la requête, et de créer des processus non liés à l'exécution des fonctions de la base historique. Par conséquent, il est difficile de comparer KDB+ avec d'autres bases, celles-ci peuvent être meilleures dans certains scénarios d'utilisation ou simplement meilleures pour des tâches de bases de données classiques, mais je ne connais pas d'autre outil aussi efficace et universel pour le traitement des données temporelles.
Intégration avec Python
Pour simplifier le travail avec KDB+ pour les personnes peu familières avec la technologie, KX a créé des bibliothèques pour une intégration étroite avec Python dans un même processus. Il est possible d'appeler n'importe quelle fonction Python depuis Q, et inversement, d'appeler n'importe quelle fonction Q depuis Python (en particulier, des expressions QSQL). Les bibliothèques convertissent les données du format d'un langage au format de l'autre, si nécessaire (pour l'efficacité, ce n'est pas toujours le cas). En conséquence, Q et Python vivent dans un tel symbiose étroite que les frontières entre eux s'effacent. Ainsi, le programmeur a, d'un côté, un accès complet à de nombreuses bibliothèques utiles de Python, et de l'autre, il dispose d'une base rapide intégrée à Python pour travailler avec de grandes quantités de données, ce qui est particulièrement utile pour ceux qui s'occupent d'apprentissage automatique ou de modélisation.
Travailler avec Q dans Python :
1. >>> q()
2. q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
Liens
Site de l'entreprise —
Site pour développeurs —
Livre Q For Mortals (en anglais) —
Articles sur les applications de KDB+/Q par des employés de kx —
Source : habr.com
