

Nous avons réussi à concevoir la structure de notre base PostgreSQL pour stocker les messages, cela fait un an, les utilisateurs l'emplissent activement, et il y a déjà des millions d'enregistrements, et… tout a commencé à ralentir.
- Partie 2 : partitionnement en temps réel
Le fait est que avec l'augmentation du volume de la table, la « profondeur » des index augmente également — même de manière logarithmique. Mais avec le temps, cela oblige le serveur à traiter beaucoup plus de pages de données pour accomplir les mêmes tâches de lecture/écriture, qu'au début.
C'est ici que le partitionnement.
Entre parenthèses, il s'agit ici non pas de sharding, c'est-à-dire de la répartition des données entre différentes bases ou serveurs. Parce que, même en divisant les données entre plusieurs les serveurs, vous ne vous débarrasserez pas de la problématique de « gonflement » des index avec le temps. Il est clair que si vous pouvez vous permettre d'introduire un nouveau serveur chaque jour, alors vos problèmes seront tout à fait différents de ceux d'une base de données spécifique.
Nous examinerons non pas des scripts spécifiques pour mettre en œuvre le partitionnement « en dur », mais l'approche elle-même — ce que et comment il convient de « découper en tranches », et à quoi cela conduit.
Concept
Redéfinissons notre objectif : nous voulons faire en sorte que, aujourd'hui, demain et dans un an, le nombre de données PostgreSQL lisibles lors de toute opération de lecture/écriture reste à peu près le même.
Pour toute donnée accumulée chronologiquement (messages, documents, journaux, archives, …) le choix naturel comme clé de partitionnement est la date/heure de l'événement. Dans notre cas, cet événement est le moment de l'envoi du message.
Remarquons que les utilisateurs travaillent presque toujours uniquement avec les « derniers » de ces données — ils lisent les derniers messages, analysent les derniers journaux,… Non, bien sûr, ils peuvent faire défiler plus loin dans le temps, mais ils le font très rarement.
De ces restrictions, il devient évident que la solution optimale pour les messages sera des sections « quotidiennes » — car presque toujours, notre utilisateur lira ce qui est arrivé « aujourd'hui » ou « hier ».
Si, au cours de la journée, nous écrivons et lisons presque exclusivement dans une seule section, cela nous donne également une utilisation plus efficace de la mémoire et du disque — puisque tous les index de la section peuvent facilement tenir en mémoire vive, contrairement aux « gros et gras » de toute la table.
étape par étape
En général, tout ce qui a été dit ci-dessus sonne comme un profit continu. Et il est réalisable, mais pour cela, nous devrons bien travailler — car la décision de sectionner l'une des entités entraîne la nécessité de « couper » également les entités associées.
Le message, ses propriétés et projections
Puisque nous avons décidé de découper les messages par dates, il est également raisonnable de diviser les entités-propriétés qui en dépendent (fichiers joints, liste des destinataires), et aussi par date de message.
Étant donné que l'une de nos tâches typiques est de consulter les registres de messages (non lus, entrants, tous), il est également logique de les « inclure » dans le sectionnement par date des messages.
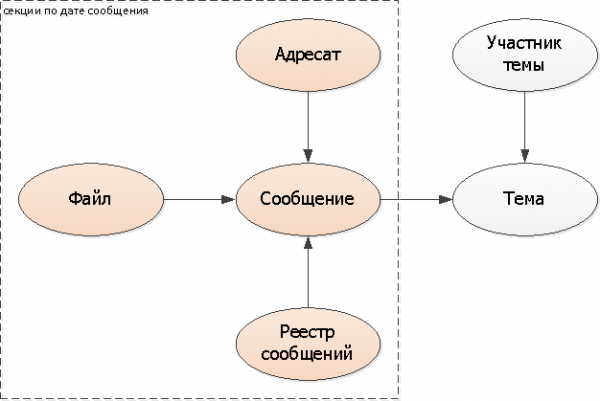
Nous ajoutons la clé de sectionnement (date du message) dans toutes les tables : destinataires, fichier, registres. Dans le message lui-même, il n'est pas nécessaire de l'ajouter, mais d'utiliser l'Horodatage existant.
Thèmes
Puisque le sujet est commun à plusieurs messages, il ne peut pas être « découpé » dans le même modèle, nous devons nous appuyer sur autre chose. Dans notre cas, cela convient parfaitement la date du premier message dans la correspondance — c'est-à-dire le moment de création, proprement dit, du sujet.
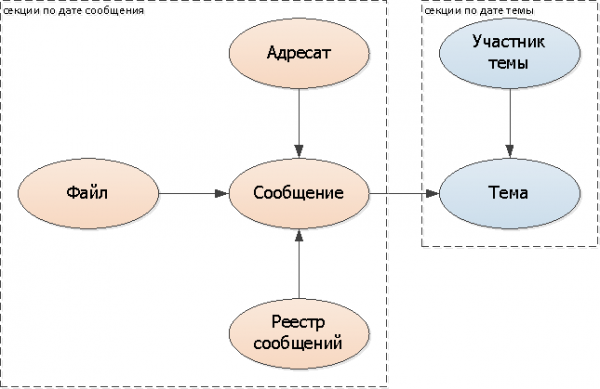
Nous ajoutons la clé de sectionnement (date du sujet) dans toutes les tables : sujet, participant.
Mais maintenant, nous avons deux problèmes qui surgissent immédiatement :
- dans quelle section chercher des messages par sujet ?
- dans quelle section rechercher le sujet d'un message ?
Nous pourrions, bien sûr, continuer à chercher dans toutes les sections, mais ce serait très triste et effacerait tous nos gains. Donc, pour savoir où chercher précisément, nous allons faire des liens logiques / pointeurs vers les sections :
- dans le message, nous ajouterons un champ avec la date du sujet
- au sujet, nous ajouterons un ensemble de dates de messages de cette correspondance (cela peut être une table séparée ou un tableau de dates)
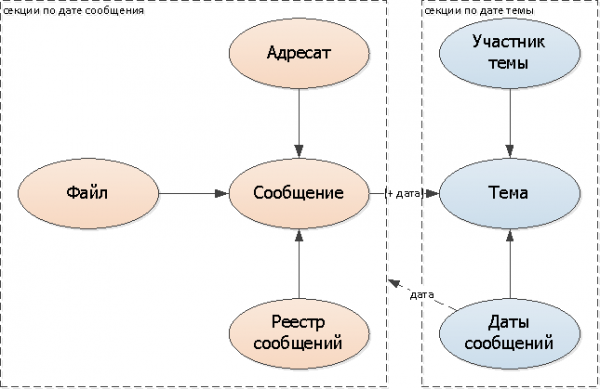
Étant donné que les modifications de la liste des dates de messages pour chaque correspondance individuelle seront peu nombreuses (puisque presque tous les messages tombent dans 1-2 jours voisins), je vais m'en tenir à cette option.
Au total, la structure de notre base a pris la forme suivante en tenant compte du sectionnement :
Tables : RU, si vous n'aimez pas le cyrillique dans les noms de tables / champs, il vaut mieux ne pas regarder
-- sections par date de message
CREATE TABLE "Message_YYYYMMDD"(
  "Message"
    uuid
      PRIMARY KEY
, "Sujet"
    uuid
, "DateSujet"
    date
, "Auteur"
    uuid
, "DateHeure" -- utilisé comme date
    timestamp
, "Texte"
    text
);

CREATE TABLE "Destinataire_YYYYMMDD"(
  "DateMessage"
    date
, "Message"
    uuid
, "Personne"
    uuid
, PRIMARY KEY("Message", "Personne")
);

CREATE TABLE "Fichier_YYYYMMDD"(
  "DateMessage"
    date
, "Fichier"
    uuid
      PRIMARY KEY
, "Message"
    uuid
, "BLOB"
    uuid
, "Nom"
    text
);

CREATE TABLE "RegistreMessages_YYYYMMDD"(
  "DateMessage"
    date
, "Propriétaire"
    uuid
, "TypeRegistre"
    smallint
, "DateHeure"
    timestamp
, "Message"
    uuid
, PRIMARY KEY("Propriétaire", "TypeRegistre", "Message")
);
CREATE INDEX ON "RegistreMessages_YYYYMMDD"("Propriétaire", "TypeRegistre", "DateHeure" DESC);

-- sections par date de sujet
CREATE TABLE "Sujet_YYYYMMDD"(
  "DateSujet"
    date
, "Sujet"
    uuid
      PRIMARY KEY
, "Document"
    uuid
, "Titre"
    text
);

CREATE TABLE "ParticipantSujet_YYYYMMDD"(
  "DateSujet"
    date
, "Sujet"
    uuid
, "Personne"
    uuid
, PRIMARY KEY("Sujet", "Personne")
);

CREATE TABLE "DatesMessagesSujet_YYYYMMDD"(
  "DateSujet"
    date
, "Sujet"
    uuid
      PRIMARY KEY
, "Date"
    date
);
Économisons quelques centimes
Eh bien, si nous n'utilisons pas basée sur la distribution des valeurs d'un champ (via des triggers et l'héritage ou PARTITION BY), mais «manuellement» au niveau de l'application, on peut remarquer que la valeur de la clé de partitionnement est déjà stockée dans le nom même de la table.
Donc, si vous vous préoccupez vraiment tant du volume de données stockées, alors vous pouvez vous débarrasser de ces «champs superflus» et vous adresser directement à des tables spécifiques. Cependant, toutes les sélections de plusieurs sections devront alors être transférées côté application.
Source : habr.com
