

Bonjour, j'ai récemment eu une tâche intéressante à réaliser : configurer un stockage pour la sauvegarde d'un grand nombre de dispositifs de stockage en bloc.
Chaque semaine, nous effectuons des sauvegardes de toutes les machines virtuelles de notre cloud, ce qui nécessite de pouvoir gérer des milliers de sauvegardes et de le faire aussi rapidement et efficacement que possible.
Malheureusement, les configurations standard RAID5, RAID6 ne conviennent pas dans ce cas car le processus de restauration sur des disques aussi grands que les nôtres sera douloureusement long et risque fort de ne jamais se terminer.
Considérons les alternatives :
— L'équivalent de RAID5, RAID6, mais avec un niveau de parité configurable. La sauvegarde se fait non pas par blocs, mais pour chaque objet séparément. Le moyen le plus simple de tester l'Erasure Coding est de déployer .
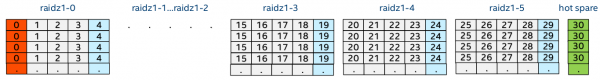
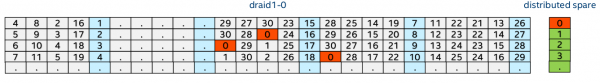
— c'est une fonctionnalité de ZFS qui n'est pas encore sortie. Contrairement à RAIDZ, DRAID dispose d’un bloc de parité distribué et utilise tous les disques du pool lors de la restauration, ce qui permet de mieux surmonter les pannes de disque et d'accélérer la récupération après une défaillance.
Nous disposons d'un serveur Fujitsu Primergy RX300 S7 avec un processeur Intel Xeon CPU E5-2650L 0 @ 1.80GHz, neuf modules de mémoire vive Samsung DDR3-1333 8Gb PC3L-10600R ECC Registered (M393B1K70DH0-YH9), un châssis de disques Supermicro SuperChassis 847E26-RJBOD1, connecté via Dual LSI SAS2X36 Expander et 45 disques Seagage ST6000NM0115-1YZ110 pour 6 To chacun.
Avant de prendre une décision, nous devons d'abord tout tester correctement.
Pour cela, je me suis préparé et j'ai effectué des tests de différentes configurations. J'ai utilisé minio, qui servait de backend S3, et je l'ai lancé en différents modes avec un nombre variable de cibles.
Le cas test principal était minio en mode Erasure Coding contre RAID logiciel avec le même nombre de disques et de disques de parité, soit : RAID6, RAIDZ2 et DRAID2.
Pour information : lorsque vous lancez minio avec une seule cible, minio fonctionne en mode passerelle S3 en fournissant votre système de fichiers local sous forme de stockage S3. Si vous lancez minio en spécifiant plusieurs cibles, le mode Erasure Coding s'active automatiquement, ce qui répartit les données entre vos cibles tout en fournissant une redondance.
Par défaut, minio divise les cibles en groupes de 16 disques, où chaque groupe a 2 parités. Cela signifie que deux disques peuvent tomber en panne simultanément sans perte de données.
Pour tester les performances, j'ai utilisé 16 disques de 6 To chacun et écrit dessus de petits objets de 1 Mo. Cela décrivait avec précision notre future charge de travail, car tous les outils modernes de sauvegarde divisent les données en blocs de plusieurs mégaoctets et les écrivent de cette manière.
Pour effectuer le benchmark, j'ai utilisé l'outil s3bench, exécuté sur un serveur distant, qui envoyait des dizaines de milliers de tels objets dans minio par centaine de flux. Ensuite, il essayait de les demander à nouveau de la même manière.
Les résultats du benchmark sont présentés dans le tableau suivant :
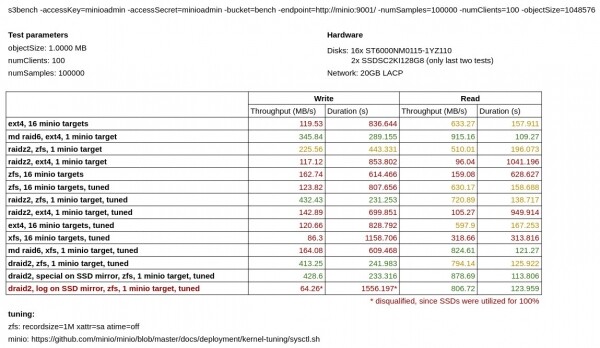
Comme nous le voyons, minio en mode erasure coding fonctionne beaucoup moins bien en écriture que minio exécuté sur un RAID logiciel RAID6, RAIDZ2 et DRAID2 dans la même configuration.
Separément, on m de tester minio sur ext4 contre XFS. Étonnamment, pour mon type de charge, XFS s'est avéré significativement plus lent qu'ext4.
Lors de la première série de tests, Mdadm a montré une supériorité sur ZFS, mais plus tard , qu'il est possible d'améliorer les performances de ZFS en installant les options suivantes :
xattr=sa atime=off recordsize=1Met après cela, les tests avec ZFS sont devenus bien meilleurs.
On peut également noter que DRAID ne procure pas de gains de performance significatifs par rapport à RAIDZ, mais en théorie, il devrait être beaucoup plus sûr.
Dans les deux derniers tests, j'ai également tenté de transférer les métadonnées (special) et ZIL (log) sur un miroir à partir du SSD. Cependant, le transfert des métadonnées n'a pas entraîné de gains significatifs en vitesse d'écriture, et lors du transfert de ZIL, mes ont atteint un plafond avec 100 % d'utilisation, donc je considère ce test comme un échec. Je n'exclus pas que si j'avais eu des disques SSD plus rapides, cela aurait pu considérablement améliorer mes résultats, mais malheureusement, je ne les avais pas.
En fin de compte, j'ai décidé de m'en tenir à l'utilisation de DRAID et malgré son statut bêta, il représente la solution la plus rapide et efficace pour le stockage dans notre cas.
J'ai créé un simple DRAID2 dans une configuration avec trois groupes et deux spares distribués :
# zpool status data
  pool: data
 state: ONLINE
  scan: none requested
config:

    NAME                 STATE     READ WRITE CKSUM
    data                 ONLINE       0     0     0
      draid2:3g:2s-0     ONLINE       0     0     0
        sdy              ONLINE       0     0     0
        sdam             ONLINE       0     0     0
        sdf              ONLINE       0     0     0
        sdau             ONLINE       0     0     0
        sdab             ONLINE       0     0     0
        sdo              ONLINE       0     0     0
        sdw              ONLINE       0     0     0
        sdak             ONLINE       0     0     0
        sdd              ONLINE       0     0     0
        sdas             ONLINE       0     0     0
        sdm              ONLINE       0     0     0
        sdu              ONLINE       0     0     0
        sdai             ONLINE       0     0     0
        sdaq             ONLINE       0     0     0
        sdk              ONLINE       0     0     0
        sds              ONLINE       0     0     0
        sdag             ONLINE       0     0     0
        sdi              ONLINE       0     0     0
        sdq              ONLINE       0     0     0
        sdae             ONLINE       0     0     0
        sdz              ONLINE       0     0     0
        sdan             ONLINE       0     0     0
        sdg              ONLINE       0     0     0
        sdac             ONLINE       0     0     0
        sdx              ONLINE       0     0     0
        sdal             ONLINE       0     0     0
        sde              ONLINE       0     0     0
        sdat             ONLINE       0     0     0
        sdaa             ONLINE       0     0     0
        sdn              ONLINE       0     0     0
        sdv              ONLINE       0     0     0
        sdaj             ONLINE       0     0     0
        sdc              ONLINE       0     0     0
        sdar             ONLINE       0     0     0
        sdl              ONLINE       0     0     0
        sdt              ONLINE       0     0     0
        sdah             ONLINE       0     0     0
        sdap             ONLINE       0     0     0
        sdj              ONLINE       0     0     0
        sdr              ONLINE       0     0     0
        sdaf             ONLINE       0     0     0
        sdao             ONLINE       0     0     0
        sdh              ONLINE       0     0     0
        sdp              ONLINE       0     0     0
        sdad             ONLINE       0     0     0
    spares
      s0-draid2:3g:2s-0  AVAIL
      s1-draid2:3g:2s-0  AVAIL

errors: No known data errors
Bien, le stockage est réglé, maintenant parlons de ce que nous allons utiliser pour la sauvegarde. Ici, il est immédiatement intéressant de parler de trois solutions que j'ai pu essayer, à savoir :
— un fork , une solution spécialisée pour la sauvegarde des dispositifs de bloc, a une intégration étroite avec Ceph. Elle peut récupérer les diffs entre les snapshots et en créer des sauvegardes incrémentielles. Elle prend en charge un grand nombre de backends de stockage, y compris locaux et S3. Elle nécessite une base de données distincte pour stocker la table de hachage de déduplication. Parmi les inconvénients : elle est écrite en python, et son interface en ligne de commande est un peu peu réactive.
— un fork , un outil bien connu et éprouvé pour la sauvegarde, capable de sauvegarder des données et de les dédupliquer efficacement. Il peut sauvegarder localement ou sur un serveur distant via scp. Il peut sauvegarder des dispositifs de bloc s'il est lancé avec le drapeau --special, parmi les inconvénients : lors de la création d'une sauvegarde, le dépôt est complètement verrouillé, donc il est recommandé de créer un dépôt distinct pour chaque machine virtuelle, ce qui en soi n'est pas un problème, d'autant plus qu'ils sont très faciles à créer.
— un projet en plein développement, écrit en go, assez rapide et prenant en charge un grand nombre de backends de stockage, y compris le stockage local, scp, S3 et bien d'autres. Il est à noter qu'il existe un spécialement conçu pour restic, qui permet d'exporter le stockage le plus rapidement possible pour une utilisation à distance. Parmi tous les outils mentionnés, c'est celui que je préfère. Il peut sauvegarder à partir de stdin. Il n'a presque pas de défauts notables, mais il y a quelques particularités :
Tout d'abord, j'ai essayé de l'utiliser en mode dépôt commun pour toutes les machines virtuelles (comme Benji) et cela a fonctionné plutôt bien, mais les opérations de restauration prenaient beaucoup de temps, car à chaque fois avant de restaurer, restic tente de lire les métadonnées de toutes les sauvegardes. Ce problème a été résolu, tout comme avec borg, en créant un dépôt distinct pour chaque machine virtuelle. Cette approche s'est également révélée très efficace pour la gestion des sauvegardes. Les dépôts isolés peuvent avoir un mot de passe distinct pour accéder aux données, et nous n'avons pas à craindre que le dépôt global puisse se casser d'une manière ou d'une autre. Créer de nouveaux dépôts est aussi simple que la sauvegarde borg.
Dans tous les cas, la déduplication se fait uniquement par rapport à la version précédente de la sauvegarde, cette version précédente étant déterminée par le chemin pour la sauvegarde spécifiée. Si vous sauvegardez différents objets depuis stdin dans un dépôt commun, n'oubliez pas de spécifier l'option
--stdin-filename, ou de spécifier explicitement l'option à chaque fois--parent.
Deuxièmement, la restauration dans stdout prend beaucoup plus de temps que la restauration sur le système de fichiers en raison de sa parallélisation. À l'avenir, nous prévoyons d'ajouter un support plus étroit pour les sauvegardes des appareils bloc.
Troisièmement, à l'heure actuelle, il est recommandé d'utiliser , car la version 0.9.6 a un bug avec la restauration lente des gros fichiers.
Pour tester l'efficacité de la sauvegarde et la vitesse d'écriture / de récupération depuis la sauvegarde, j'ai créé un dépôt séparé et essayé de sauvegarder une petite image de machine virtuelle (21 Go). Deux sauvegardes ont été effectuées sans modifier l'original, en utilisant chacune des solutions énumérées, pour vérifier à quelle vitesse les données dédupliquées sont copiées.
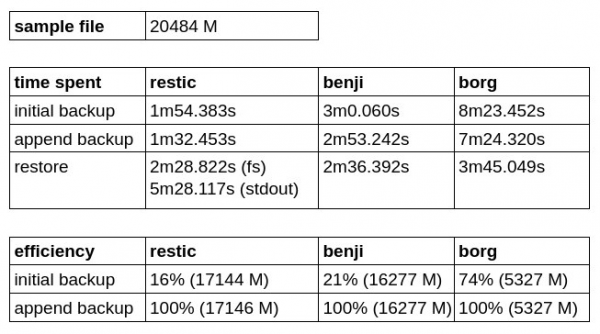
Comme nous pouvons le constater, Borg Backup a le meilleur coefficient d'efficacité pour la sauvegarde initiale, mais il est moins performant en matière de vitesse d'écriture et de restauration.
Restic s'est avéré plus rapide que Benji Backup, mais il met plus de temps à restaurer dans stdout, et malheureusement, il ne sait pas encore écrire directement sur un appareil bloc.
Après avoir pesé le pour et le contre, j'ai décidé de me concentrer sur restic avec rest-server comme la solution la plus pratique et prometteuse pour la sauvegarde.
Dans ce screencast, vous pouvez voir comment un canal de 10 Go est entièrement utilisé lors de plusieurs opérations de sauvegarde lancées simultanément. Il convient de noter que l'utilisation des disques ne dépasse pas 30 %.
Je suis plus que satisfait de la solution obtenue !
Source : habr.com
