

Bonjour à tous ! Je m'appelle Dmitry Samsonov, je suis administrateur système principal chez « Odnoklassniki ». Nous avons plus de 7000 serveurs physiques, 11 000 conteneurs dans notre cloud et 200 applications qui, dans diverses configurations, forment 700 clusters différents. La grande majorité des serveurs fonctionnent sous CentOS 7.
Le 14 août 2018, des informations sur la vulnérabilité FragmentSmack ont été publiées.
() et SegmentSmack (). Ce sont des vulnérabilités avec un vecteur d'attaque réseau et une évaluation assez élevée (7.5), ce qui entraîne une déni de service (DoS) en raison de l'épuisement des ressources (CPU). Un correctif pour FragmentSmack n'avait pas été proposé à l'époque, de plus, il a été publié bien après la publication des informations sur la vulnérabilité. Pour corriger SegmentSmack, il était conseillé de mettre à jour le noyau. Le paquet de mise à jour a été publié le même jour, il ne restait plus qu'à l'installer.
Non, nous ne sommes absolument pas contre la mise à jour du noyau ! Cependant, il y a des nuances...
Comment nous mettons à jour le noyau en production
En fait, rien de compliqué :
- Télécharger les paquets ;
- Les installer sur un certain nombre de serveurs (y compris les serveurs hébergeant notre cloud) ;
- S'assurer que rien ne s'est cassé ;
- Vérifier que toutes les configurations par défaut du noyau se sont appliquées sans erreurs ;
- Attendre quelques jours ;
- Contrôler les indicateurs des serveurs ;
- Basculer le déploiement des nouveaux serveurs vers le nouveau noyau ;
- Mettre à jour tous les serveurs par centres de données (un centre de données à la fois, pour minimiser l'impact pour les utilisateurs en cas de problèmes) ;
- Redémarrer tous les serveurs.
Répéter pour toutes les versions de noyaux que nous avons. Actuellement, il s'agit de :
- CentOS 7 de base 3.10 — pour la plupart des serveurs standards ;
- Vanille 4.19 — pour notre , car nous avons besoin de BFQ, BBR, etc. ;
- Elrepo kernel-ml 5.2 — pour , car 4.19 se comportait auparavant de manière instable, et les fonctionnalités restent les mêmes.
Comme vous l'avez peut-être deviné, le plus de temps est consacré au redémarrage de milliers de serveurs. Étant donné que non toutes les vulnérabilités ne sont pas critiques pour tous les serveurs, nous redémarrons uniquement ceux qui sont directement accessibles depuis Internet. Dans le cloud, afin de ne pas limiter la flexibilité, nous ne lions pas les conteneurs accessibles de l'extérieur à des serveurs individuels avec un nouveau noyau, mais redémarrons tous les hôtes sans exception. Heureusement, la procédure y est plus simple que pour les serveurs classiques. Par exemple, les conteneurs sans état peuvent simplement se déplacer vers un autre serveur durant le redémarrage.
Cependant, le travail reste considérable et peut prendre plusieurs semaines, voire plusieurs mois en cas de problèmes avec la nouvelle version. Les cybercriminels en sont bien conscients, c'est pourquoi un plan « B » est nécessaire.
FragmentSmack/SegmentSmack. Solution de contournement
Heureusement, pour certaines vulnérabilités, ce plan « B » existe et s'appelle Solution de contournement. Il s'agit le plus souvent de modifier les paramètres du noyau/des applications pour minimiser l'effet potentiel ou éliminer complètement l'exploitation des vulnérabilités.
Dans le cas de FragmentSmack/SegmentSmack une telle Solution de contournement :
«On peut changer les valeurs par défaut de 4MB et 3MB dans net.ipv4.ipfrag_high_thresh et net.ipv4.ipfrag_low_thresh (et leurs équivalents pour ipv6 net.ipv6.ipfrag_high_thresh et net.ipv6.ipfrag_low_thresh) à respectivement 256 kB et 192 kB ou moins. Les tests montrent une diminution de l'utilisation du CPU allant de légère à significative pendant l'attaque, en fonction du matériel, des paramètres et des conditions. Cependant, il pourrait y avoir un impact sur les performances à cause de ipfrag_high_thresh=262144 bytes, car seulement deux fragments de 64K peuvent tenir simultanément dans la file d'attente de reconstruction. Par exemple, il existe un risque que les applications traitant de gros paquets UDP rencontrent des problèmes.».
Les paramètres eux-mêmes sont décrits comme suit :
ipfrag_high_thresh - LONG INTEGER
     Mémoire maximale utilisée pour réassembler les fragments IP.
ipfrag_low_thresh - ENTIER LONG
     Mémoire maximale utilisée pour réassembler les fragments IP avant que le noyau
     commence à supprimer les files d'attente de fragments incomplets pour libérer des ressources.
     Le noyau accepte toujours de nouveaux fragments pour la défragmentation.
Nous n'avons pas de services UDP importants en production. Le trafic fragmenté est absent en LAN, présent en WAN, mais pas significatif. Rien ne le prévoit — nous pouvons appliquer la Solution de contournement !
FragmentSmack/SegmentSmack. Premier sang
Le premier problème que nous avons rencontré était que les conteneurs cloud appliquaient parfois de nouveaux paramètres uniquement partiellement (seulement ipfrag_low_thresh), et parfois pas du tout, échouant simplement au démarrage. Il était difficile de reproduire le problème de manière cohérente (les paramètres s'appliquaient manuellement sans aucune difficulté). Comprendre pourquoi le conteneur échoue au démarrage n'est pas non plus simple : aucune erreur n'a été détectée. Une chose était sûre : revenir aux paramètres précédents résolvait le problème des conteneurs qui échouaient.
Pourquoi ne suffit-il pas d'appliquer Sysctl sur l'hôte ? Le conteneur vit dans son propre espace de noms réseau dédié, donc au moins dans le conteneur peut différer de ceux de l'hôte.
Comment les paramètres Sysctl sont-ils appliqués dans le conteneur ? Comme nos conteneurs sont non privilégiés, il est impossible de modifier n'importe quel paramètre Sysctl en accédant directement au conteneur – les droits sont insuffisants. À l'époque, notre cloud utilisait Docker pour exécuter les conteneurs (ce qui a désormais changé). Les paramètres du nouveau conteneur, y compris les paramètres Sysctl nécessaires, étaient transmis à Docker via l'API. . Il a été constaté au cours de l'examen des versions que l'API Docker ne renvoyait pas toutes les erreurs (du moins dans la version 1.10). En essayant de démarrer le conteneur avec 'docker run', nous avons enfin vu quelque chose :
write /proc/sys/net/ipv4/ipfrag_high_thresh: argument invalide docker : Réponse d'erreur du démon : Impossible de démarrer le conteneur <...> : [9] Erreur système : impossible de synchroniser avec le processus du conteneur.
La valeur du paramètre n'est pas valide. Mais pourquoi ? Et pourquoi n'est-elle pas valide seulement parfois ? Il s'est avéré que Docker ne garantit pas l'ordre d'application des paramètres Sysctl (la dernière version vérifiée est 1.13.1), donc parfois ipfrag_high_thresh tentait de se définir à 256K, lorsque ipfrag_low_thresh était encore à 3M, ce qui signifie que la limite supérieure était inférieure à la limite inférieure, ce qui entraînait une erreur.
À ce moment-là, nous utilisions déjà notre propre mécanisme de reconfiguration du conteneur après le démarrage (gel du conteneur via
cgroup freezer ip netns FragmentSmack/SegmentSmack. Première goutte de sang 2
FragmentSmack/SegmentSmack. Première goutte de sang 2
Nous n'avons pas eu le temps de comprendre l'application de Workaround dans le cloud que les premières plaintes rares des utilisateurs ont commencé à arriver. À ce moment-là, quelques semaines s'étaient écoulées depuis le début de l'application de Workaround sur les premiers serveurs. Une enquête préliminaire a montré que les plaintes concernaient des services spécifiques, et non tous les serveurs de ces services. Le problème a de nouveau acquis un caractère extrêmement indéfini.
Avant tout, nous avons bien sûr essayé de rétablir les paramètres Sysctl, mais cela n'a eu aucun effet. Diverses manœuvres avec les paramètres du serveur et de l'application n'ont pas non plus aidé. Un redémarrage a fait l'affaire. Redémarrer sous Linux est tout aussi contre nature qu'il l'était naguère pour Windows. Néanmoins, cela a fonctionné, et nous avons mis cela sur le compte d'un « bogue dans le noyau » lors de l'application des nouveaux paramètres dans Sysctl. Comme c'était léger d'esprit...
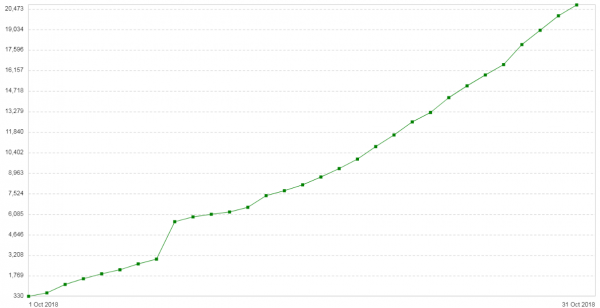
Trois semaines plus tard, le problème est réapparu. La configuration de ces serveurs était assez simple : Nginx en mode proxy/équilibrage. Le trafic était faible. Nouvel indice : le nombre d'erreurs 504 chez les clients augmente chaque jour (). Le graphique montre le nombre d'erreurs 504 par jour pour ce service :
Toutes les erreurs concernent le même backend — celui qui se trouve dans le cloud. Le graphique de consommation de mémoire sous les fragments de paquets sur ce backend ressemblait à ceci :
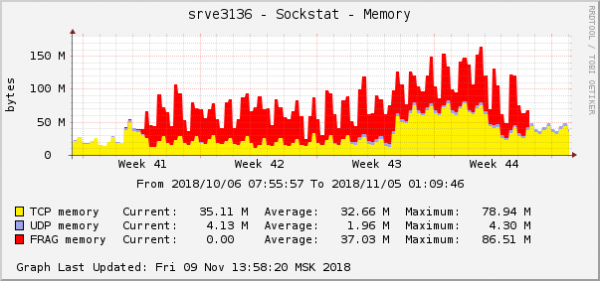
C'est l'une des manifestations les plus frappantes du problème sur les graphiques du système d'exploitation. À ce moment-là, une autre problématique réseau avec les configurations QoS (Traffic Control) a été corrigée dans le cloud. Le graphique de consommation de mémoire sous les fragments de paquets avait exactement le même aspect :
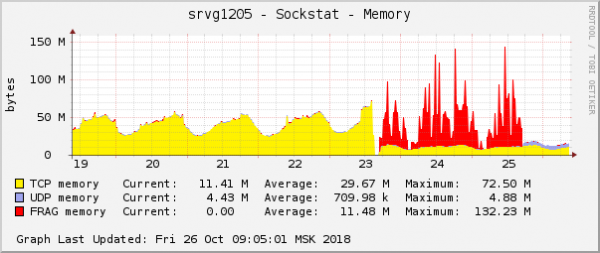
L'hypothèse était simple : si les graphiques ont l'air identiques, alors la cause est la même. D'autant plus que les problèmes de ce type de mémoire se produisent extrêmement rarement.
Le cœur du problème corrigé était que nous utilisions dans QoS le planificateur de paquets fq avec les paramètres par défaut. Par défaut, pour une seule connexion, il permet d'ajouter 100 paquets dans la file d'attente, et certaines connexions, en cas de saturation de la bande passante, ont commencé à remplir la file d'attente à saturation. Dans ce cas, les paquets sont abandonnés. Dans les statistiques tc (tc -s qdisc), cela se voit comme suit :
qdisc fq 2c6c : parent 1:2c6c limit 10000p flow_limit 100p buckets 1024 orphan_mask 1023 quantum 3028 initial_quantum 15140 refill_delay 40.0ms
  Envoyé 454701676345 octets 491683359 pkt (perdus 464545, dépassements 0 requeues 0)
  backlog 0b 0p requeues 0
   1024 flux (1021 inactifs, 0 ralentis)
   0 gc, 0 haute priorité, 0 ralentis, 464545 flux_plimit
«464545 flows_plimit» désigne les paquets rejetés en raison du dépassement de la limite de la file d'attente d'une connexion, tandis que «dropped 464545» est la somme de tous les paquets rejetés par ce planificateur. Après avoir augmenté la longueur de la file à 1 000 et redémarré les conteneurs, le problème a cessé de se manifester. On peut s'installer confortablement dans un fauteuil et déguster un smoothie.
FragmentSmack/S segmentSmack. Le dernier patch
Premièrement, plusieurs mois après l'annonce des vulnérabilités du noyau, un correctif pour FragmentSmack est enfin arrivé (rappelons qu'à l'époque de l'annonce en août, seul un correctif pour SegmentSmack avait été publié), ce qui a permis d'abandonner le Workaround qui nous avait causé pas mal de soucis. Au cours de cette période, nous avons déjà commencé à migrer certains serveurs vers le nouveau noyau, et il fallait donc recommencer. Pourquoi avons-nous mis à jour le noyau sans attendre le correctif de FragmentSmack ? La raison est que le processus de protection contre ces vulnérabilités a coïncidé (et s'est amalgamé) avec le processus de mise à jour de CentOS lui-même (ce qui prend encore plus de temps que la simple mise à jour du noyau). De plus, SegmentSmack est une vulnérabilité plus grave, et le correctif correspondant est arrivé immédiatement, donc il y avait un sens quel qu'en soit le cas. Cependant, nous ne pouvions tout simplement pas mettre à jour le noyau sur CentOS, car la vulnérabilité FragmenSmack, apparue avec CentOS 7.5, n'a été corrigée qu'avec la version 7.6, ce qui nous a donc obligés à interrompre la mise à jour vers la 7.5 et à tout recommencer avec la mise à jour vers la 7.6. Cela arrive aussi.
Deuxièmement, nous avons reçu des plaintes rares des utilisateurs concernant des problèmes. Nous savons maintenant avec certitude qu'elles sont toutes liées au téléchargement de fichiers de la part des clients sur certains de nos serveurs. De plus, très peu de téléchargements passant par ces serveurs ont été effectués par rapport à la masse totale.
Comme nous l'avons mentionné précédemment, le rollback de Sysctl n'a pas été efficace. Un redémarrage a aidé, mais temporairement.
Les soupçons concernant Sysctl n’ont pas été écartés, mais cette fois, il fallait rassembler autant d'informations que possible. Il manquait également désespérément la capacité de reproduire le problème de téléchargement du côté du client afin d'étudier plus précisément ce qui se passe.
L'analyse de toutes les statistiques et journaux disponibles ne nous a pas rapprochés de la compréhension de la situation. Il manquait cruellement la possibilité de reproduire le problème pour « toucher » une connexion spécifique. Enfin, les développeurs sur une version spéciale de l'application ont réussi à reproduire de manière stable les problèmes sur un appareil de test lors de la connexion via Wi-Fi. Cela a marqué une avancée dans l'enquête. Le client se connectait à Nginx, qui proxyfi ait vers le backend, qui était notre application Java.
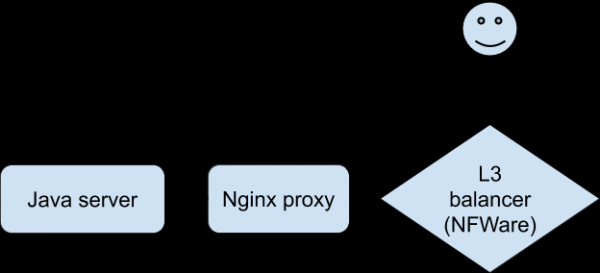
Le dialogue en cas de problème était le suivant (enregistré du côté du proxy Nginx) :
- Client : demande d'information pour le téléchargement d'un fichier.
- Serveur Java : réponse.
- Client : POST avec fichier.
- Serveur Java : erreur.
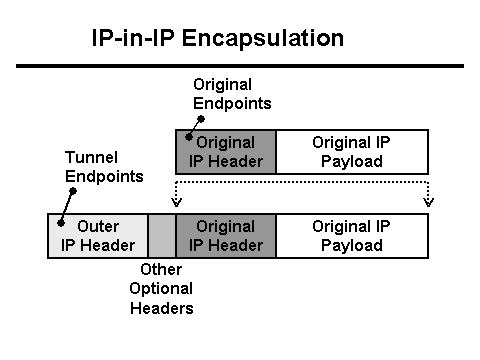
Le serveur Java indique dans les logs qu'il a reçu 0 octets de données du client, tandis que le proxy Nginx indique que la demande a duré plus de 30 secondes (30 secondes est le temps de timeout de l'application cliente). Pourquoi y a-t-il eu timeout et pourquoi 0 octet ? Du point de vue de HTTP, tout fonctionne comme prévu, mais le POST avec le fichier semble disparaître du réseau. En fait, il disparaît entre le client et Nginx. Il est temps de se munir de Tcpdump ! Mais d'abord, il faut comprendre la configuration du réseau. Le proxy Nginx se trouve derrière un équilibreur de charge L3. . Un tunnel est utilisé pour acheminer les paquets de l'équilibreur de charge L3 au serveur, qui ajoute ses propres en-têtes dans les paquets :
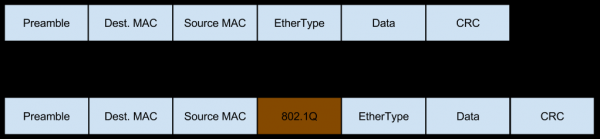
En outre, le réseau vers ce serveur arrive sous forme de trafic étiqueté Vlan, qui ajoute également ses propres champs dans les paquets :
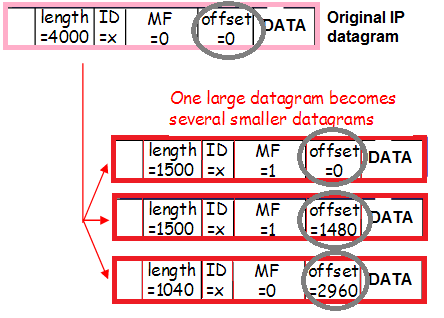
De plus, ce trafic peut être fragmenté (ce petit pourcentage de trafic entrant fragmenté dont nous avons parlé lors de l'évaluation des risques liés à la solution de contournement), ce qui modifie également le contenu des en-têtes :
Encore une fois : les paquets sont encapsulés par une étiquette Vlan, encapsulés par un tunnel, fragmentés. Pour mieux comprendre comment cela se produit, suivons le chemin d'un paquet du client au proxy Nginx.
- Le paquet arrive sur l'équilibreur de charge L3. Pour une routage correct à l'intérieur du centre de données, le paquet est encapsulé dans un tunnel et envoyé à la carte réseau.
- Comme le paquet + les en-têtes du tunnel ne tiennent pas dans le MTU, le paquet est coupé en fragments et envoyé dans le réseau.
- Le switch après l'équilibreur de charge L3, à la réception du paquet, ajoute une étiquette Vlan et l'envoie plus loin.
- Le commutateur devant le proxy Nginx voit (selon les paramètres de port) que le serveur attend un paquet encapsulé VLAN, donc il l'envoie tel quel, sans enlever l'étiquette VLAN.
- Linux reçoit des fragments de paquets distincts et les assemble en un grand paquet.
- Ensuite, le paquet passe sur l'interface VLAN, où la première couche — l'encapsulation VLAN — est retirée.
- Puis Linux l'envoie sur l'interface Tunnel, où une autre couche — l'encapsulation Tunnel — est désenveloppée.
La difficulté réside dans le fait de transmettre tout cela sous forme de paramètres à tcpdump.
Commençons par la fin : y a-t-il des paquets IP purs (sans en-têtes superflus) provenant des clients, sans encapsulation VLAN et Tunnel ?
tcpdump host
Non, il n'y avait pas de tels paquets sur le serveur. Ainsi, le problème doit se situer plus tôt. Y a-t-il des paquets sans uniquement l'encapsulation VLAN retirée ?
tcpdump ip[32:4]=0xx390x2xx
0xx390x2xx est l'adresse IP du client au format hexadécimal.
32:4 — désigne l'adresse et la longueur du champ dans lequel l'adresse IP SCR est enregistrée dans le paquet Tunnel.
L'adresse du champ a dû être trouvée par essais et erreurs, car internet mentionne 40, 44, 50, 54, mais aucune adresse IP n'y figurait. On peut aussi examiner un des paquets en hexadécimal (paramètre -xx ou -XX dans tcpdump) et calculer l'adresse de l'IP connue.
Y a-t-il des fragments de paquets sans désencapsulation VLAN et Tunnel ?
tcpdump ((ip[6:2] > 0) and (not ip[6] = 64))
Cette magie nous montrera tous les fragments, y compris le dernier. Il est probablement possible de filtrer cela par IP, mais je n'ai pas essayé, car il n'y a pas beaucoup de tels paquets, et parmi le flux général, j'ai trouvé facilement ce dont j'avais besoin. Les voici :
14:02:58.471063 Dans 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), longueur 1516 : (tos 0x0, ttl 63, id 53652, décalage 0, drapeaux [+], proto IPIP (4), longueur 1500)
     11.11.11.11 > 22.22.22.22 : ip tronqué - 20 octets manquants ! (tos 0x0, ttl 50, id 57750, décalage 0, drapeaux [DF], proto TCP (6), longueur 1500)
     33.33.33.33.33333 > 44.44.44.44.80 : Drapeaux [.], seq 0:1448, ack 1, win 343, options [nop,nop,TS val 11660691 ecr 2998165860], longueur 1448
         0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
         0x0010: 4500 05dc d194 2000 3f09 d5fb 0a66 387d E.......?....f8}
         0x0020: 1x67 7899 4500 06xx e198 4000 3206 6xx4 .faEE.....@.2.m.
         0x0030: b291 x9xx x345 2541 83b9 0050 9740 0x04 .......A...P.@..
         0x0040: 6444 4939 8010 0257 8c3c 0000 0101 080x dDI9...W.......
         0x0050: 00b1 ed93 b2b4 6964 xxd8 ffe1 006a 4578 ......ad.....jEx
         0x0060: 6966 0000 4x4d 002a 0500 0008 0004 0100 if..MM.*........
14:02:58.471103 In 00:de:ff:1a:94:11 éthertype IPv4 (0x0800), longueur 62 : (tos 0x0, ttl 63, id 53652, offset 1480, flags [none], proto IPIP (4), longueur 40)
11.11.11.11 > 22.22.22.22 : ip-proto-4
0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
0x0010: 4500 0028 d194 00b9 3f04 faf6 2x76 385x E..(....?....f8}
0x0020: 1x76 6545 xxxx 1x11 2d2c 0c21 8016 8e43 .faE...D-,.!...C
0x0030: x978 e91d x9b0 d608 0000 0000 0000 7c31 .x............|Q
0x0040: 881d c4b6 0000 0000 0000 0000 0000 ..............
Ce sont deux fragments d'un même paquet (même ID 53652) avec une photographie (on peut voir le mot Exif dans le premier paquet). Du fait que les paquets existent à ce niveau, mais qu'ils ne figurent pas dans les dumps assemblés, le problème est clairement lié à l'assemblage. Enfin, cela a une confirmation documentaire !
Le décodeur de paquets n'a révélé aucun problème empêchant l'assemblage. J'ai essayé ici : . D'abord, lorsque j'ai essayé d'y insérer quelque chose, le décodeur n'a pas apprécié le format du paquet. Il s'est avéré qu'il y avait deux octets superflus entre Srcmac et Ethertype (non liés aux informations sur les fragments). Après les avoir supprimés, le décodeur a fonctionné. Cependant, il n'a montré aucun problème.
Quoi qu'il en soit, à part ces fameux Sysctl, rien d'autre n'a été trouvé. Il restait à trouver un moyen d'identifier les serveurs problématiques, afin de comprendre l'ampleur de la situation et de prendre une décision concernant les actions à entreprendre. Assez rapidement, le compteur nécessaire a été trouvé :
netstat -s | grep "échecs de réassemblage de paquets"
Il est également présent dans snmpd sous OID=1.3.6.1.2.1.4.31.1.1.16.1 ().
« Le nombre d'échecs détectés par l'algorithme de réassemblage IP (pour diverses raisons : délai, erreurs, etc.) ».
Parmi le groupe de serveurs sur lesquels le problème a été étudié, ce compteur augmentait plus rapidement sur deux d'entre eux, plus lentement sur deux autres, et il n'augmentait pas du tout sur les deux restants. La comparaison de la dynamique de ce compteur avec celle des erreurs HTTP sur le serveur Java a révélé une corrélation. Autrement dit, le compteur pouvait être mis en surveillance.
La présence d'un indicateur fiable de problèmes est très importante afin de pouvoir déterminer précisément si le retour arrière de Sysctl aide, car comme nous l'avons vu dans le récit précédent, il n'est pas possible de le comprendre immédiatement par l'application. Cet indicateur permettrait d'identifier tous les points problématiques en production avant qu'ils ne soient découverts par les utilisateurs.
Après le retour arrière de Sysctl, les erreurs de surveillance ont cessé, prouvant ainsi que la cause des problèmes était établie, tout comme le fait que le retour arrière était efficace.
Nous avons restauré les paramètres de fragmentation sur d'autres serveurs, où un nouveau suivi a été activé, et ailleurs, nous avons même alloué plus de mémoire aux fragments qu'auparavant par défaut (il s'agissait de statistiques UDP, dont la perte partielle n'était pas perceptible au milieu du reste).
Les questions les plus importantes
Pourquoi nos paquets sont-ils fragmentés sur le répartiteur L3 ? La plupart des paquets envoyés par les utilisateurs vers les répartiteurs sont des SYN et des ACK. La taille de ces paquets est petite. Mais comme la proportion de ces paquets est très grande, nous n'avons pas remarqué la présence de gros paquets qui ont commencé à se fragmenter.
La cause était un script de configuration défectueux sur les serveurs avec des interfaces Vlan (il y avait très peu de serveurs avec du trafic tagué en production à ce moment-là). Advmss permet de faire savoir au client que les paquets envoyés vers nous doivent être plus petits, afin qu'après avoir ajouté les en-têtes de tunnel, ils ne doivent pas être fragmentés.
Pourquoi le rollback de Sysctl ne fonctionnait-il pas, alors qu'un redémarrage fonctionnait ? Le rollback de Sysctl modifiait la quantité de mémoire disponible pour l'assemblage des paquets. Il semble que le simple fait de débordement de la mémoire réservée pour les fragments a causé des ralentissements des connexions, entraînant des retards importants des fragments dans la file d'attente. Ainsi, le processus se répétait.
Le redémarrage réinitialisait la mémoire et tout redevenait normal.
Aurait-on pu se passer du Workaround ? Oui, mais il y a un grand risque de laisser les utilisateurs sans service en cas d'attaque. Bien sûr, l'application du Workaround a entraîné divers problèmes, y compris le ralentissement d'un des services pour les utilisateurs, mais néanmoins nous considérons que les actions étaient justifiées.
Un grand merci à Andreï Timofeïev () pour son aide dans l'enquête, ainsi qu'à Alexeï Krenyev () — pour son travail titanesque de mise à jour de Centos et des noyaux sur les serveurs. Un processus qu'il a fallu parfois recommencer plusieurs fois, ce qui a prolongé la durée à plusieurs mois.
Source : habr.com
