

Les filtres de paquets Berkeley (BPF) sont une technologie du noyau Linux qui fait les gros titres des publications techniques anglophones depuis plusieurs années. Les conférences sont remplies de présentations sur l'utilisation et le développement de BPF. David Miller, mainteneur du sous-système réseau de Linux, qualifie sa présentation lors de Linux Plumbers 2018. (XDP étant l'un des usages possibles de BPF). Brendan Gregg présente des conférences intitulées . Toke Høiland-Jørgensen , affirmant que le noyau est désormais un micro-noyau. Thomas Graf promeut l'idée que .
Il n'existe toujours pas de description systématique de BPF sur Habré, et c'est pourquoi, à travers une série d'articles, je m'efforcerai de raconter l'histoire de cette technologie, de décrire son architecture et ses outils de développement, et de délimiter ses domaines d'application et ses pratiques d'utilisation. Dans cet article inaugural de la série, je vais parler de l'histoire et de l'architecture du BPF classique, ainsi que révéler les mystères des principes de fonctionnement tcpdump, seccomp, strace, et bien plus encore.
Le développement de BPF est contrôlé par la communauté réseau Linux, et ses principales applications actuelles sont liées aux réseaux. Donc, avec la permission de , j'ai intitulé cette série "BPF pour les nuls", en hommage à la grande série .
Un bref cours sur l'histoire de BPF (c)
La technologie BPF moderne est une version améliorée et enrichie de l'ancienne technologie portant le même nom, désormais appelée, pour éviter toute confusion, BPF classique. Des outils bien connus ont été créés sur la base du BPF classique tcpdump, un mécanisme seccomp, ainsi que des modules moins connus xt_bpf pour iptables et un classificateur cls_bpf. Dans le Linux moderne, les programmes BPF classiques sont automatiquement traduits en une nouvelle forme, cependant, du point de vue de l'utilisateur, l'API est restée la même et les nouvelles applications du BPF classique, comme nous le verrons dans cet article, existent toujours. Pour cette raison, et parce que suivre l'histoire de l'évolution du BPF classique dans Linux clarifiera comment et pourquoi il a évolué en sa forme moderne, j'ai décidé de commencer par un article sur le BPF classique.
À la fin des années 1980, des ingénieurs du célèbre Lawrence Berkeley Laboratory se sont intéressés à la question de la bonne filtration des paquets réseau sur le matériel moderne de l'époque. L'idée de base de la filtration, initialement mise en œuvre dans la technologie CSPF (CMU/Stanford Packet Filter), consistait à filtrer les paquets superflus le plus tôt possible, c'est-à-dire dans l'espace noyau, car cela permet d'éviter de copier des données inutiles dans l'espace utilisateur. Pour garantir la sécurité d'exécution lors du lancement de code utilisateur dans l'espace noyau, une machine virtuelle — une sandbox — était utilisée.
Cependant, les machines virtuelles pour les filtres existants étaient conçues pour fonctionner sur des machines avec une architecture à pile et ne fonctionnaient pas aussi efficacement sur les nouvelles machines RISC. En conséquence, les efforts des ingénieurs des Berkeley Labs ont abouti à la création d'une nouvelle technologie BPF (Berkeley Packet Filters), dont l'architecture de la machine virtuelle a été conçue sur la base du processeur Motorola 6502 — un travailleur acharné de produits aussi connus que ou . La nouvelle machine virtuelle augmentait de plusieurs dizaines de fois les performances des filtres par rapport aux solutions existantes.
Architecture de la machine BPF
Nous nous familiariserons avec l'architecture de manière pratique en examinant des exemples. Cependant, d'abord, disons que la machine avait deux registres 32 bits disponibles pour l'utilisateur, un accumulateur A et un registre d'index X, 64 octets de mémoire (16 mots) accessibles en écriture et lecture, et un ensemble d'instructions limité pour travailler avec ces objets. Les programmes disposaient également d'instructions de saut pour mettre en œuvre des expressions conditionnelles, mais pour garantir la fin opportune de l'exécution du programme, les sauts ne pouvaient se faire que vers l'avant, c'est-à-dire que la création de boucles était notamment interdite.
Le schéma général de l'activation de la machine est le suivant. L'utilisateur crée un programme pour l'architecture BPF et, à l'aide de quelque mécanisme du noyau (par exemple, un appel système), charge et attache le programme à quelque générateur d'événements dans le noyau (par exemple, un événement est l'arrivée d'un paquet sur la carte réseau). Lorsqu'un événement se produit, le noyau lance le programme (par exemple, dans un interpréteur), tandis que la mémoire de la machine correspond. quelque de la région mémoire du noyau (par exemple, les données du paquet reçu).
Ce qui précède sera suffisant pour commencer à examiner des exemples : nous nous familiariserons avec le système et le format des commandes si nécessaire. Si vous souhaitez immédiatement découvrir le système de commandes de la machine virtuelle et connaître toutes ses capacités, vous pouvez lire l'article original et/ou la première moitié du fichier de la documentation du noyau. De plus, vous pouvez consulter la présentation , dans laquelle McCanne, l'un des auteurs du BPF, raconte l'histoire de sa création. libpcap.
Nous allons maintenant examiner tous les exemples significatifs de l'application du BPF classique sous Linux : tcpdump (libpcap), seccomp, xt_bpf, cls_bpf.
tcpdump
Le développement du BPF a été réalisé parallèlement au développement d'un frontend pour le filtrage des paquets — l'outil bien connu tcpdump. Et comme c'est le plus ancien et le plus connu des exemples d'utilisation du BPF classique, présent sur de nombreux systèmes d'exploitation, nous commencerons notre étude de la technologie par celui-ci.
(Tous les exemples de cet article ont été exécutés sur Linux 5.6.0-rc6. La sortie de certaines commandes a été modifiée pour plus de lisibilité.)
Exemple : observer les paquets IPv6
Imaginons que nous souhaitons voir tous les paquets IPv6 sur l'interface eth0. Pour cela, nous pouvons lancer le programme tcpdump avec un filtre très simple ip6:
$ sudo tcpdump -i eth0 ip6En même temps, tcpdump compiler le filtre ip6 en bytecode pour l'architecture BPF et l'envoyer au noyau (voir les détails dans la section ). Le filtre chargé sera exécuté pour chaque paquet traversant l'interface eth0. Si le filtre retourne une valeur non nulle n, alors n les octets du paquet seront copiés dans l'espace utilisateur et nous les verrons dans la sortie tcpdump.
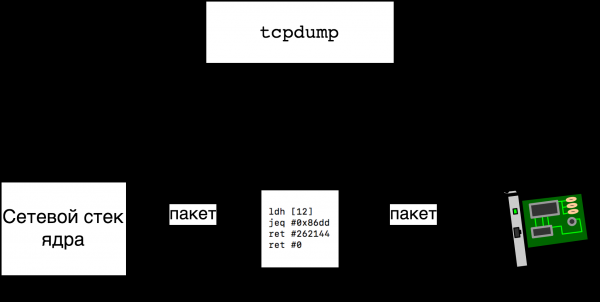
Il s'avère que nous pouvons facilement savoir quel bytecode a été envoyé au noyau tcpdump en utilisant le même tcpdump, si nous l'exécutons avec l'option -d:
$ sudo tcpdump -i eth0 -d ip6
(000) ldh      [12]
(001) jeq      #0x86dd          jt 2    jf 3
(002) ret      #262144
(003) ret      #0
Sur la première ligne, nous lançons la commande ldh [12], qui se traduit par « charger dans le registre A un demi-mot (16 bits) situé à l'adresse 12 » et la seule question est — quelle mémoire adressons-nous ? La réponse est que à l'adresse x commence (x+1)-ème octet du paquet réseau analysé. Nous lisons les paquets depuis l'interface Ethernet eth0, ce qui signifie , ce paquet se présente comme suit (pour simplifier, nous considérons qu'il n'y a pas de balises VLAN dans le paquet) :
       6              6          2
|Destination MAC|Source MAC|Ether Type|...|
Cela signifie qu'après l'exécution de la commande ldh [12] dans le registre A se trouvera le champ Ether Type — le type de paquet transmis dans ce cadre Ethernet. À la ligne 1, nous comparons le contenu du registre A (type de paquet) avec 0x86dd, ce qui signifie le type IPv6 qui nous intéresse. À la ligne 1, en plus de la commande de comparaison, il y a deux colonnes supplémentaires — jt 2 et jf 3 — des étiquettes vers lesquelles il faut aller en cas de succès de la comparaison (A == 0x86dd) et d'échec. Ainsi, dans le cas de réussite (IPv6), nous passons à la ligne 2, et dans le cas d'échec — à la ligne 3. À la ligne 3, le programme se termine avec le code 0 (ne copie pas le paquet), et à la ligne 2, il se termine avec le code 262144 (copie-moi au maximum 256 kilo-octets du paquet).
Un exemple un peu plus compliqué : examinons les paquets TCP sur le port de destination
Voyons à quoi ressemble le filtre qui copie tous les paquets TCP avec le port de destination 666. Nous considérerons le cas IPv4, car le cas IPv6 est plus simple. Après avoir étudié cet exemple, vous pouvez comme exercice étudier vous-même le filtre pour IPv6 (ip6 and tcp dst port 666) et le filtre pour le cas général (tcp dst port 666). Donc, le filtre qui nous intéresse ressemble à ceci :
$ sudo tcpdump -i eth0 -d ip and tcp dst port 666
(000) ldh      [12]
(001) jeq      #0x800           jt 2    jf 10
(002) ldb      [23]
(003) jeq      #0x6             jt 4    jf 10
(004) ldh      [20]
(005) jset     #0x1fff          jt 10   jf 6
(006) ldxb     4*([14]&0xf)
(007) ldh      [x + 16]
(008) jeq      #0x29a           jt 9    jf 10
(009) ret      #262144
(010) ret      #0
Que font les lignes 0 et 1, nous le savons déjà. À la ligne 2, nous avons vérifié que c'est un paquet IPv4 (Ether Type = 0x800) et nous chargeons dans le registre A le 24ème octet du paquet. Notre paquet se présente comme
       14            8      1     1
|en-tête ethernet|champs ip|ttl|protocole|...
ce qui signifie que nous chargeons dans le registre A le champ Protocole de l'en-tête IP, ce qui est logique, car nous voulons uniquement copier les paquets TCP. Nous comparons Protocole avec 0x6 () à la ligne 3.
Aux lignes 4 et 5, nous chargeons des demi-mots situés à l'adresse 20, et à l'aide de la commande jset nous vérifions si l'un des trois — dans le masque donné jset les trois bits supérieurs sont nettoyés. Deux bits sur trois nous indiquent si le paquet fait partie d'un paquet IP fragmenté, et si oui, s'il s'agit du dernier fragment. Le troisième bit est réservé et doit être égal à zéro. Nous ne voulons pas vérifier les paquets incohérents ou corrompus, donc nous vérifions les trois bits.
La ligne 6 est la plus intéressante de ce listing. L'expression ldxb 4*([14]&0xf) signifie que nous chargeons dans le registre X les quatre bits de poids faible du quinzième octet du paquet, multipliés par 4. Les quatre bits de poids faible du quinzième octet constituent le champ de l'en-tête IPv4, où est stockée la longueur de l'en-tête en mots, d'où la nécessité de le multiplier ensuite par 4. Il est intéressant de noter que l'expression 4*([14]&0xf) est une désignation d'un format d'adressage spécial qui ne peut être utilisé que de cette manière et uniquement pour le registre X, c'est-à-dire que nous ne pouvons pas dire ni ldb 4*([14]&0xf) ni ldxb 5*([14]&0xf) (nous ne pouvons qu'indiquer un autre offset, par exemple, ldxb 4*([16]&0xf)). Il est évident que ce format d'adressage a été ajouté dans le BPF précisément pour obtenir dans X (le registre d'index) la longueur de l'en-tête IPv4.
Ainsi, à la ligne 7, nous essayons de charger un demi-mot à l'adresse (X+16). En nous rappelant que 14 octets sont occupés par l'en-tête Ethernet et que X contient la longueur de l'en-tête IPv4, nous comprenons que dans A est chargé le port de destination TCP :
       14           X           2             2
|en-tête ethernet|en-tête ip|port source|port destination|
Enfin, à la ligne 8, nous comparons le port de destination avec la valeur recherchée et aux lignes 9 ou 10, nous retournons le résultat : copier le paquet ou non.
Tcpdump : chargement
Dans les exemples précédents, nous ne nous sommes pas attardés sur la manière dont nous chargeons le code machine BPF dans le noyau pour le filtrage des paquets. En général, tcpdump porté sur de nombreux systèmes et pour travailler avec les filtres utilise la bibliothèque . En résumé, pour appliquer un filtre sur l'interface à l'aide de libpcap, il faut faire ce qui suit :
- créer un descripteur de type
pcap_tà partir du nom de l'interface : , - activer l'interface : ,
- compiler le filtre : ,
- connecter le filtre : .
Pour voir comment la fonction pcap_setfilter est mise en œuvre dans Linux, nous utilisons strace (certaines lignes ont été supprimées) :
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Dans les deux premières lignes de la sortie, nous créons pour lire tous les trames Ethernet et le lions à l'interface eth0. De , nous savons que le filtre ip se composera de quatre instructions BPF, et à la troisième ligne nous voyons comment, à l'aide de l'option de l'appel système setsockopt Nous chargeons et connectons le filtre de longueur 4. C'est notre filtre.
Il convient de noter que dans le BPF classique, le chargement et la connexion du filtre se font toujours comme une opération atomique, tandis que dans la nouvelle version de BPF, le chargement du programme et son attachement à un générateur d'événements sont séparés dans le temps.
La vérité cachée
Une version légèrement plus complète de la sortie ressemble à ceci :
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=1, filter=0xbeefbeefbeef}, 16) = 0
recvfrom(3, 0x7ffcad394257, 1, MSG_TRUNC, NULL, NULL) = -1 EAGAIN (Ressource temporairement indisponible)
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Comme mentionné ci-dessus, nous chargeons et connectons notre filtre au socket à la ligne 5, mais que se passe-t-il aux lignes 3 et 4 ? Il s'avère que cela libpcap prend soin de nous — pour que les paquets qui ne répondent pas aux critères de notre filtre ne soient pas inclus, la bibliothèque un filtre factice ret #0 (rejeter tous les paquets), met le socket en mode non-bloquant et essaie de lire tous les paquets qui ont pu rester des filtres précédents.
En résumé, pour filtrer les paquets sous Linux avec le BPF classique, il est nécessaire d'avoir un filtre sous la forme d'une structure de type struct sock_fprog et un socket ouvert, après quoi le filtre peut être attaché au socket par un appel système. setsockopt.
Il est intéressant de noter que le filtre peut être attaché à n'importe quel socket, pas seulement à un socket raw. Voici un programme qui coupe tout sauf les deux premiers octets de toutes les datagrammes UDP entrants. (J'ai ajouté des commentaires dans le code pour ne pas surcharger l'article.)
Pour plus d'informations sur l'utilisation setsockopt pour attacher des filtres, voir , et concernant l'écriture de vos propres filtres de type struct sock_fprog sans aide tcpdump , nous en parlerons dans la section .
BPF classique et XXIe siècle
Le BPF a été intégré au Linux en 1997 et est longtemps resté un cheval de bataille libpcap sans changements majeurs (les modifications spécifiques à Linux, bien sûr, , mais elles n'ont pas changé la vue d'ensemble). Les premiers signes sérieux que le BPF allait évoluer sont apparus en 2011, lorsque Eric Dumazet a proposé , ajoutant au noyau un compilateur Just In Time — un traducteur pour convertir le bytecode BPF en code natif. x86_64 Le compilateur JIT a été le premier dans la chaîne de modifications : en 2012
la possibilité d'écrire des filtres pour , utilisant BPF, en janvier 2013 a été un module modèle xt_bpf, permettant d'écrire des règles pour iptables à l'aide de BPF, et en octobre 2013, il y avait aussi un module , permettant d'écrire à l'aide de BPF des classificateurs de trafic. cls_bpfNous examinerons bientôt tous ces exemples plus en détail, mais d'abord, il sera utile d'apprendre à écrire et à compiler des programmes arbitraires pour BPF, car les capacités offertes par la bibliothèque
sont limitées (un exemple simple : un filtre généré libpcap peut ne retourner que deux valeurs — 0 ou 0x40000) ou, comme dans le cas de seccomp, inappliquable. libpcap Familiarisons-nous avec le format binaire des instructions BPF, qui est très simple :
Programmer BPF avec ses propres mains
16 8 8 32 | code | jt | jf | k |
Chaque instruction occupe 64 bits, dont les 16 premiers bits sont le code de l'instruction, suivis de deux décalages de 8 bits,jt jf et , et 32 bits pour l'argument, dont la destination varie en fonction de l'instruction. Par exemple, l'instruction K, qui termine le programme, a le code , et la valeur de retour est prise dans la constante. En langage C, une instruction BPF est représentée sous forme de structure 6struct sock_filter { __u16 code; __u8 jt; __u8 jf; __u32 k; } Ket un programme entier — sous forme de structure
struct sock_fprog {
        unsigned short len;
        struct sock_filter *filter;
}
Ainsi, nous pouvons déjà écrire des programmes (les codes d'instructions que nous connaissons, disons, de
). Voici à quoi ressemblera le filtrestruct sock_filter code[] = { { 0x28, 0, 0, 0x0000000c }, { 0x15, 0, 1, 0x000086dd }, { 0x06, 0, 0, 0x00040000 }, { 0x06, 0, 0, 0x00000000 }, }; struct sock_fprog prog = { .len = ARRAY_SIZE(code), .filter = code, }; prog ip6 de :
nous pouvons l'utiliser légalement dans l'appelLe programme setsockopt(sk, SOL_SOCKET, SO_ATTACH_FILTER, &prog, sizeof(prog)) Écrire des programmes sous forme de codes machine n'est pas très pratique, mais parfois c'est nécessaire (par exemple, pour le débogage, la création de tests unitaires, la rédaction d'articles sur Habr, etc.). Pour plus de commodité, dans le fichier
<linux/filter.h>sont définis des macros d'assistance — le même exemple que ci-dessus pourrait être réécrit comme struct sock_filter code[] = { BPF_STMT(BPF_LD|BPF_H|BPF_ABS, 12), BPF_JUMP(BPF_JMP|BPF_JEQ|BPF_K, ETH_P_IPV6, 0, 1), BPF_STMT(BPF_RET|BPF_K, 0x00040000), BPF_STMT(BPF_RET|BPF_K, 0), } Cependant, cette variante n'est pas très pratique non plus. C'est ainsi que les programmeurs du noyau Linux en ont décidé, et donc dans le répertoire
tools/bpfdu noyau, on peut trouver un assembleur et un débogueur pour travailler avec le BPF classique. , mais en plus, nous pouvons spécifier des étiquettes symboliques. Par exemple, voici un programme qui drope tous les paquets sauf TCP/IPv4 :
Le langage d'assemblage ressemble beaucoup à la sortie de débogage tcpdump, mais en plus, nous pouvons indiquer des étiquettes symboliques. Par exemple, voici un programme qui élimine tous les paquets sauf TCP/IPv4:
$ cat /tmp/tcp-over-ipv4.bpf
ldh [12]
jne #0x800, drop
ldb [23]
jneq #6, drop
ret #-1
drop: ret #0
Par défaut, l'assembleur génère du code au format , ,..., pour notre exemple avec TCP, cela donnera
$ tools/bpf/bpf_asm /tmp/tcp-over-ipv4.bpf
6,40 0 0 12,21 0 3 2048,48 0 0 23,21 0 1 6,6 0 0 4294967295,6 0 0 0,
Pour faciliter le travail des programmateurs C, un autre format de sortie peut être utilisé :
$ tools/bpf/bpf_asm -c /tmp/tcp-over-ipv4.bpf
{ 0x28,  0,  0, 0x0000000c },
{ 0x15,  0,  3, 0x00000800 },
{ 0x30,  0,  0, 0x00000017 },
{ 0x15,  0,  1, 0x00000006 },
{ 0x06,  0,  0, 0xffffffff },
{ 0x06,  0,  0, 0000000000 },
Ce texte peut être copié dans la définition de la structure de type struct sock_filter, comme nous l'avons fait au début de cette section.
Extensions de Linux et netsniff-ng
En plus des instructions BPF standard, Linux et tools/bpf/bpf_asm supportent également . Principalement, les instructions servent à accéder aux champs de la structure struct sk_buff, qui décrit le paquet réseau dans le noyau. Cependant, il existe aussi d'autres types d'instructions d'aide, comme ldw cpu qui charge dans le registre A le résultat de l'exécution de la fonction noyau raw_smp_processor_id(). (Dans la nouvelle version de BPF, ces extensions non standards ont été élargies pour fournir aux programmes un ensemble de helpers du noyau pour accéder à la mémoire, aux structures, et générer des événements.) Voici un exemple intéressant de filtre où nous copions dans l'espace utilisateur uniquement les en-têtes des paquets, en utilisant l'extension poff, offset de charge utile :
ld poff
ret a
Les extensions BPF ne pourront pas être utilisées dans tcpdump, mais c'est une bonne occasion de découvrir le paquet d'utilitaires , qui, entre autres, contient un programme avancé netsniff-ng, qui, en plus de filtrer avec BPF, comprend également un générateur de trafic efficace, et un assembleur BPF plus avancé nommé tools/bpf/bpf_asmbpfc . Ce paquet contient une documentation assez détaillée, voir aussi les liens à la fin de l'article.Ainsi, nous savons déjà comment écrire des programmes BPF de complexité arbitraire et sommes prêts à examiner de nouveaux exemples, le premier étant la technologie seccomp, qui permet, à l'aide de filtres BPF, de gérer de nombreux et d'ensembles d'arguments d'appels système, accessibles à ce processus et à ses descendants.
seccomp
La première version de seccomp a été ajoutée au noyau en 2005 et n'a pas suscité un grand engouement, car elle offrait uniquement la possibilité de restreindre l'ensemble des appels système accessibles au processus, suivant :
sigreturn read, write, exit et , et le processus qui enfreint les règles était tué par, et le processus qui enfreignait les règles était tué à l'aide de SIGKILL. Cependant, en 2012, la possibilité d'utiliser des filtres BPF a été ajoutée à seccomp, permettant de définir de nombreux appels système autorisés et même d'effectuer des vérifications sur leurs arguments. (Il est intéressant de noter qu'un des premiers utilisateurs de cette fonctionnalité était Chrome, et actuellement, l'équipe de Chrome développe un mécanisme KRSI basé sur une nouvelle version de BPF, permettant de personnaliser les modules de sécurité Linux.) Des liens vers une documentation supplémentaire se trouvent à la fin de l'article.
Notons qu'il y a déjà eu des articles sur Habr concernant l'utilisation de seccomp, certains pourraient vouloir les lire avant (ou à la place) de lire les prochaines sections. Dans l'article des exemples d'utilisation de seccomp, tant dans sa version de 2007 que dans la version utilisant BPF (les filtres sont générés à l'aide de libseccomp), la relation entre seccomp et Docker est expliquée, ainsi que de nombreux liens utiles. Dans l'article il est notamment expliqué comment ajouter des listes noires ou blanches d'appels système pour les démons sous gestion de systemd.
Nous allons ensuite voir comment écrire et charger des filtres pour seccomp en C pur et à l'aide de la bibliothèque libseccomp et quels sont les avantages et les inconvénients de chaque option, pour finir par examiner comment seccomp est utilisé par le programme strace.
Écrivons et chargeons des filtres pour seccomp
Nous savons déjà écrire des programmes BPF, alors commençons par l'Interface de programmation de seccomp. Un filtre peut être installé au niveau du processus, et tous les processus enfants hériteront des restrictions. Cela se fait en utilisant l'appel système :
seccomp(SECCOMP_SET_MODE_FILTER, flags, &filter)où &filter — c'est un pointeur sur la structure que nous connaissons déjà, struct sock_fprogc'est-à-dire un programme BPF.
Qu'est-ce qui distingue les programmes pour seccomp des programmes pour les sockets ? Le contexte transmis. Dans le cas des sockets, une région de mémoire contenant le paquet était transmise, tandis que dans le cas de seccomp, une structure de ce type est transmise.
struct seccomp_data {
    int   nr;
    __u32 arch;
    __u64 instruction_pointer;
    __u64 args[6];
};
Ici nr — c'est le numéro de l'appel système en cours d'exécution, arch — l'architecture actuelle (nous y reviendrons), args — jusqu'à six arguments pour l'appel système, et instruction_pointer — est un indicateur vers l'instruction dans l'espace utilisateur qui a effectué cet appel système. Par conséquent, par exemple, pour charger le numéro de l'appel système dans le registre A nous devons dire
ldw [0]Pour les programmes seccomp, il existe d'autres particularités, par exemple, l'accès au contexte n'est possible qu'avec un alignement sur 32 bits et il est impossible de charger un demi-mot ou un octet — lors de la tentative de charger un filtre ldh [0] appel système seccomp renverra EINVAL. La vérification des filtres chargés est effectuée par la fonction du noyau. (D'une manière amusante, dans le commit original ajoutant la fonctionnalité seccomp, cette fonction a oublié d'ajouter la permission d'utiliser l'instruction mod et maintenant elle n'est pas accessible pour les programmes BPF seccomp, car son ajout l'ABI.)
En principe, nous savons déjà tout pour écrire et lire des programmes seccomp. Généralement, la logique d'un programme est organisée comme une liste blanche ou noire d'appels système, par exemple le programme
ld [0]
jeq #304, bad
jeq #176, bad
jeq #239, bad
jeq #279, bad
good: ret #0x7fff0000 /* SECCOMP_RET_ALLOW */
bad: ret #0
vérifie la liste noire de quatre appels système portant les numéros 304, 176, 239, 279. Quels sont ces appels système ? Nous ne pouvons pas dire avec certitude, car nous ne savons pas pour quelle architecture le programme a été écrit. C'est pourquoi les auteurs de seccomp de commencer tous les programmes par une vérification de l'architecture (l'architecture actuelle est indiquée dans le contexte comme le champ arch de la structure struct seccomp_data). Avec la vérification de l'architecture, le début de l'exemple ressemblerait à :
ld [4]
jne #0xc000003e, bad_arch ; SCMP_ARCH_X86_64
et alors nos numéros d'appels système auraient des valeurs définies.
Nous écrivons et chargeons des filtres pour seccomp à l'aide de libseccomp
Écrire des filtres en codes machine ou pour l'assembleur BPF permet d'avoir un contrôle total sur le résultat, mais parfois il est préférable d'avoir un code portable et/ou lisible. C'est là que nous aide la bibliothèque , qui fournit une interface standard pour l'écriture de filtres noirs ou blancs.
Écrivons, par exemple, un programme qui exécute un fichier binaire au choix de l'utilisateur, en établissant d'abord une liste noire des appels système provenant de (le programme est simplifié pour plus de clarté, la version complète peut être trouvée ):
#include <seccomp.h>
#include <unistd.h>
#include <err.h>

static int sys_numbers[] = {
        __NR_mount,
        __NR_umount2,
       // ... еще 40 системных вызовов ...
        __NR_vmsplice,
        __NR_perf_event_open,
};

int main(int argc, char **argv)
{
        scmp_filter_ctx ctx = seccomp_init(SCMP_ACT_ALLOW);

        for (size_t i = 0; i < sizeof(sys_numbers)/sizeof(sys_numbers[0]); i++)
                seccomp_rule_add(ctx, SCMP_ACT_TRAP, sys_numbers[i], 0);

        seccomp_load(ctx);

        execvp(argv[1], &argv[1]);
        err(1, "execlp: %s", argv[1]);
}
Tout d'abord, nous définissons un tableau sys_numbers parmi plus de 40 appels système pour le blocage. Ensuite, nous initialisons le contexte ctx et nous disons à la bibliothèque que nous voulons autoriser (SCMP_ACT_ALLOW) tous les appels système par défaut (il est plus facile de construire des listes noires). Ensuite, un par un, nous ajoutons tous les appels système de la liste noire. En réponse à un appel système de la liste, nous demandons SCMP_ACT_TRAP, dans ce cas, seccomp enverra un signal au processus SIGSYS avec une description de quel appel système a enfreint les règles. Enfin, nous chargeons le programme dans le noyau à l'aide de seccomp_load, qui compilera le programme et l'associera au processus via un appel système seccomp(2).
Pour réussir la compilation, le programme doit être lié à la bibliothèque libseccomp, par exemple :
cc -std=c17 -Wall -Wextra -c -o seccomp_lib.o seccomp_lib.c
cc -o seccomp_lib seccomp_lib.o -lseccomp
Exemple de lancement réussi :
$ .\/seccomp_lib echo ok
ok
Exemple d'appel système bloqué :
$ sudo .\/seccomp_lib mount -t bpf bpf \/tmp
Mauvais appel système
Utiliser strace, pour plus de détails :
$ sudo strace -e seccomp .\/seccomp_lib mount -t bpf bpf \/tmp
seccomp(SECCOMP_SET_MODE_FILTER, 0, {len=50, filter=0x55d8e78428e0}) = 0
--- SIGSYS {si_signo=SIGSYS, si_code=SYS_SECCOMP, si_call_addr=0xboobdeadbeef, si_syscall=__NR_mount, si_arch=AUDIT_ARCH_X86_64} ---
+++ tué par SIGSYS (vidage mémoire) +++
Mauvais appel système
d'où nous pouvons savoir que le programme a été arrêté en raison de l'utilisation d'un appel système interdit mount(2).
En résumé, nous avons écrit un filtre à l'aide de la bibliothèque libseccomp, en intégrant un code non trivial dans quatre lignes. Dans l'exemple ci-dessus, en présence d'un grand nombre d'appels système, le temps d'exécution peut diminuer considérablement, car la vérification est simplement une liste de comparaisons. Pour optimiser, un patch a récemment été inclus dans libseccomp SCMP_FLTATR_CTL_OPTIMIZE . Si cet attribut est défini sur 2, le filtre sera transformé en un programme de recherche binaire.Si vous souhaitez voir comment sont construits les filtres avec recherche binaire, jetez un œil à
un simple script $ echo 1 3 6 8 13 | .\/generate_bin_search_bpf.py ld [0] jeq #6, bad jgt #6, check8 jeq #1, bad jeq #3, bad ret #0x7fff0000 check8: jeq #8, bad jeq #13, bad ret #0x7fff0000 bad: ret #0
Rien de fondamentalement plus rapide ne pourra être écrit car les programmes BPF ne peuvent pas faire de sauts conditionnels (nous ne pouvons pas faire, par exemple,jmp A jmp [label+X] ou ) et par conséquent, tous les sauts sont statiques.seccomp et strace
Tout le monde connaît l'utilitaire
Tout le monde connaît l'outil strace — un outil indispensable pour l'analyse du comportement des processus sur Linux. Cependant, beaucoup sont également au courant des lors de l'utilisation de cet utilitaire. En effet, strace il est mis en œuvre grâce à ptrace(2), et dans ce mécanisme, nous ne pouvons pas spécifier sur quel ensemble de systèmes d'appels nous devons arrêter le processus, c'est-à-dire, par exemple, les commandes
$ time strace du /usr/share/ >/dev/null 2>&1

real    0m3.081s
user    0m0.531s
sys     0m2.073s
et
$ time strace -e open du /usr/share/ >/dev/null 2>&1

real    0m2.404s
user    0m0.193s
sys     0m1.800s
s'exécutent en à peu près le même temps, bien que dans le deuxième cas, nous souhaitions tracer un seul appel système.
Une nouvelle option --seccomp-bpf, ajoutée dans strace la version 5.3, permet d'accélérer considérablement le processus et le temps de lancement sous traçage d'un seul appel système est désormais comparable au temps de lancement normal :
$ time strace --seccomp-bpf -e open du /usr/share/ >/dev/null 2>&1

real    0m0.148s
user    0m0.017s
sys     0m0.131s

$ time du /usr/share/ >/dev/null 2>&1

real    0m0.140s
user    0m0.024s
sys     0m0.116s
(Ici, bien sûr, il y a une petite tromperie dans le fait que nous ne traçons pas l'appel système principal de cette commande. Si nous traçons, par exemple, newfsstat, alors strace il ralentirait autant que sans --seccomp-bpf.)
Comment fonctionne cette option ? Sans elle strace se connecte au processus et le lance grâce à PTRACE_SYSCALL. Lorsque le processus contrôlé effectue (n'importe quel) appel système, le contrôle est transféré strace, qui examine les arguments de l'appel système et le lance grâce à PTRACE_SYSCALL. Après un certain temps, le processus termine l'appel système et en sort, le contrôle est à nouveau transféré strace, qui examine les valeurs retournées et relance le processus grâce à PTRACE_SYSCALL, etc.
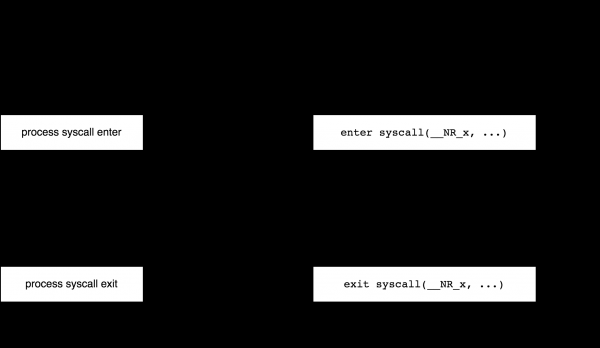
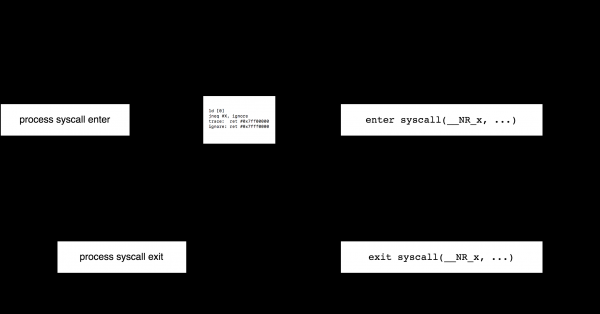
Cependant, avec seccomp, ce processus peut être optimisé exactement comme nous le souhaitons. En effet, si nous voulons surveiller uniquement l'appel système X, nous pouvons écrire un filtre BPF qui pour X renvoie la valeur SECCOMP_RET_TRACE, et pour les appels qui ne nous intéressent pas — SECCOMP_RET_ALLOW:
ld [0]
jneq #X, ignore
trace: ret #0x7ff00000
ignore: ret #0x7fff0000
Dans ce cas, strace il démarre initialement le processus comme PTRACE_CONT, pour chaque appel système, notre filtre s'exécute, si l'appel système n'est pas X, le processus continue de fonctionner, mais si c'est X, alors seccomp transfère le contrôle strace, qui examinera les arguments et lancera le processus comme PTRACE_SYSCALL (comme seccomp ne peut pas lancer un programme à la sortie d'un appel système). Lorsque l'appel système revient, strace redémarrera le processus à l'aide de PTRACE_CONT et attendra de nouveaux messages de seccomp.
Lors de l'utilisation de l'option --seccomp-bpf il y a deux limitations. Premièrement, il n'est pas possible de se joindre à un processus déjà existant (option -p programme strace), car cela n'est pas supporté par seccomp. Deuxièmement, il n'est pas possible ne de regarder les processus enfants, car les filtres seccomp sont hérités par tous les processus enfants sans possibilité de désactiver cela.
Un peu plus de détails sur la façon dont strace fonctionne avec seccomp peut être trouvé dans . Pour nous, le fait le plus intéressant est que le BPF classique sous la forme de seccomp est encore utilisé aujourd'hui.
xt_bpf
Revenons maintenant dans le monde des réseaux.
Contexte : il y a longtemps, en 2007, un module a été ajouté au noyau modèle xt_u32 pour netfilter. Il a été écrit par analogie avec un classificateur de trafic encore plus ancien cls_u32 et permettait d'écrire des règles binaires arbitraires pour iptables à l'aide des opérations simples suivantes : charger 32 bits du paquet et effectuer un ensemble d'opérations arithmétiques. Par exemple,
sudo iptables -A INPUT -m u32 --u32 "6&0xFF=1" -j LOG --log-prefix "seen-by-xt_u32"Charge 32 bits de l'en-tête IP, à partir du décalage 6, et applique un masque 0xFF (prendre l'octet le moins significatif). Cela correspond au champ protocol de l'en-tête IP et nous le comparons à 1 (ICMP). Dans une règle, il est possible de combiner plusieurs vérifications, et il est également possible d'effectuer l'opérateur @ — se déplacer de X octets à droite. Par exemple, la règle
iptables -m u32 --u32 "6&0xFF=0x6 && 0>>22&0x3C@4=0x29"vérifie si le numéro de séquence TCP 0x29. Je ne vais pas m'étendre sur les détails, car il est déjà clair que rédiger de telles règles à la main n'est pas très pratique. Dans l'article , il y a plusieurs liens avec des exemples d'utilisation et de génération de règles pour xt_u32. Voir aussi les liens à la fin de cet article.
Depuis 2013, le module au lieu du module xt_u32 peut utiliser un module basé sur BPF. xt_bpfÀ tous ceux qui ont lu jusqu'ici, le principe de son fonctionnement doit déjà être clair : exécuter du code bytecode BPF comme règles iptables. Une nouvelle règle peut être créée, par exemple comme suit :
iptables -A INPUT -m bpf --bytecode -j LOGici <байткод> — c'est le code au format de sortie assembleur bpf_asm par défaut, par exemple,
$ cat /tmp/test.bpf
ldb [9]
jneq #17, ignore
ret #1
ignore: ret #0

$ bpf_asm /tmp/test.bpf
4,48 0 0 9,21 0 1 17,6 0 0 1,6 0 0 0,

# iptables -A INPUT -m bpf --bytecode "$(bpf_asm /tmp/test.bpf)" -j LOG
Dans cet exemple, nous filtrons tous les paquets UDP. Le contexte pour le programme BPF dans le module xt_bpf, bien sûr, indique les données du paquet, dans le cas d'iptables — le début de l'en-tête IPv4. La valeur de retour du programme BPF , où faux signifie que le paquet ne correspond pas.
Il est clair que le module xt_bpf prend en charge des filtres plus complexes que dans l'exemple ci-dessus. Voyons maintenant de véritables exemples de la société Cloudfare. Jusqu'à récemment, ils utilisaient le module xt_bpf pour se protéger contre les attaques DDoS. Dans l'article , ils expliquent comment (et pourquoi) ils génèrent des filtres BPF et publient des liens vers un ensemble d'outils pour créer de tels filtres. Par exemple, avec l'outil bpfgen , on peut créer un programme BPF qui correspond à une requête DNS pour le nom habr.com:
$ ./bpfgen --assembly dns -- habr.com
ldx 4*([0]&0xf)
ld #20
add x
tax

lb_0:
    ld [x + 0]
    jneq #0x04686162, lb_1
    ld [x + 4]
    jneq #0x7203636f, lb_1
    ldh [x + 8]
    jneq #0x6d00, lb_1
    ret #65535

lb_1:
    ret #0
Dans le programme, nous chargeons d'abord dans le registre X l'adresse de début de la chaîne x04habrx03comx00 à l'intérieur du datagramme UDP, puis nous vérifions la requête : 0x04686162 "x04hab" etc.
Peu après, Cloudfare a publié le code du compilateur p0f -> BPF. Dans l'article , ils expliquent ce qu'est p0f et comment transformer les signatures p0f en BPF :
$ ./bpfgen p0f -- 4:64:0:0:*,0::ack+:0
39,0 0 0 0,48 0 0 8,37 35 0 64,37 0 34 29,48 0 0 0,
84 0 0 15,21 0 31 5,48 0 0 9,21 0 29 6,40 0 0 6,
...
Actuellement, Cloudfare n'utilise plus xt_bpf, car ils ont migré vers XDP — l'une des options d'utilisation de la nouvelle version de BPF, voir .
cls_bpf
Le dernier exemple d'utilisation du BPF classique dans le noyau est un classificateur cls_bpf pour le sous-système de contrôle de trafic sous Linux, ajouté à Linux à la fin de 2013 et qui remplace conceptuellement l'ancien cls_u32.
Cependant, nous ne allons pas décrire son fonctionnement maintenant cls_bpf, car en termes de connaissances sur le BPF classique, cela ne nous apportera rien de nouveau — nous avons déjà exploré toute sa fonctionnalité. De plus, dans les prochains articles, qui parleront de BPF étendu, nous rencontrerons à plusieurs reprises ce classificateur.
Une autre raison de ne pas parler de l'utilisation du BPF classique avec cls_bpf réside dans le fait qu'en comparaison avec le BPF étendu, le champ d'application est radicalement restreint : les programmes classiques ne peuvent pas modifier le contenu des paquets et ne peuvent pas conserver d'état entre les appels.
Il est donc temps de dire adieu au BPF classique et de jeter un œil vers l'avenir.
Adieu au BPF classique
Nous avons examiné comment la technologie BPF, développée au début des années 1990, a réussi à survivre un quart de siècle tout en trouvant de nouvelles applications. Cependant, tout comme le passage des machines à pile aux RISC, qui a servi de coup d'envoi au développement du BPF classique, les années 2000 ont vu la transition des machines 32 bits vers des machines 64 bits, rendant le BPF classique obsolète. De plus, les fonctionnalités du BPF classique sont fortement limitées, car au-delà de l'architecture obsolète, nous ne pouvons pas conserver l'état entre les appels de programmes BPF, nous n'avons pas la possibilité d'interagir directement avec l'utilisateur, et il n'y a pas de possibilité d'interaction avec le noyau, à part lire un nombre limité de champs de structure. sk_buff et exécuter les fonctions d'assistance les plus simples, il n'est pas possible de modifier le contenu des paquets ni de les rediriger.
En réalité, à l'heure actuelle, il ne reste de BPF classique dans Linux que l'interface API, et à l'intérieur du noyau, tous les programmes classiques, qu'ils soient des filtres de sockets ou des filtres seccomp, sont automatiquement traduits dans un nouveau format, Extended BPF. (Nous expliquerons comment cela se passe dans l'article suivant.)
La transition vers la nouvelle architecture a commencé en 2013, lorsque Alexey Starovoytov a proposé un schéma de mise à jour de BPF. En 2014, des correctifs correspondants dans le noyau. D'après ce que je comprends, il était initialement prévu d'optimiser l'architecture et le compilateur JIT pour un fonctionnement plus efficace sur des machines 64 bits, mais au lieu de cela, ces optimisations ont ouvert un nouveau chapitre dans le développement de Linux.
Les prochains articles de cette série parleront de l'architecture et des applications de la nouvelle technologie, initialement connue sous le nom de internal BPF, puis extended BPF, et maintenant simplement BPF.
Liens
- Steven McCanne et Van Jacobson, "Le filtre de paquets BSD : une nouvelle architecture pour la capture de paquets au niveau utilisateur",
https://www.tcpdump.org/papers/bpf-usenix93.pdf - Steven McCanne, "libpcap : une architecture et une méthodologie d'optimisation pour la capture de paquets",
https://sharkfestus.wireshark.org/sharkfest.11/presentations/McCanne-Sharkfest'11_Keynote_Address.pdf tcpdump,libpcap:- .
- BPF — le bytecode oublié :
https://blog.cloudflare.com/bpf-the-forgotten-bytecode/ - Présentation de l'outil BPF :
https://blog.cloudflare.com/introducing-the-bpf-tools/ bpf_cls:http://man7.org/linux/man-pages/man8/tc-bpf.8.html- Aperçu de seccomp :
https://lwn.net/Articles/656307/ https://github.com/torvalds/linux/blob/master/Documentation/userspace-api/seccomp_filter.rst- Paul Chaignon, "strace —seccomp-bpf : un aperçu sous le capot",
https://fosdem.org/2020/schedule/event/debugging_strace_bpf/ netsniff-ng:http://netsniff-ng.org/
Source : habr.com
