

Le Niveau de Capacité (ou comme nous l'appelons en interne chez Vima — captir) est apparu à l'époque de Veeam Backup and Replication 9.5 Update 4 sous le nom de Niveau d'Archive. L'idée qu'il véhicule est de permettre le déplacement des sauvegardes qui sont en dehors de ce que l'on appelle la fenêtre de restauration opérationnelle, vers des stockages d'objets. Cela aidait à libérer de l'espace disque pour les utilisateurs qui en avaient peu. Cette option était appelée Mode de Déplacement.
Pour effectuer cette action simple (comme elle semble l'être), deux conditions doivent être respectées : tous les points de la sauvegarde à déplacer doivent être en dehors de la fenêtre de restauration opérationnelle mentionnée, qui est définie explicitement dans l'interface utilisateur. Et deuxièmement : la chaîne doit être dans ce qu'on appelle un « état scellé » (sealed backup chain ou Inactive Backup Chain). Cela signifie qu'avec le temps, cette chaîne ne subit pas de modifications.
Mais dans VBR v10, le concept a été enrichi de nouvelles fonctionnalités — sont apparus le Mode de Copie, le Mode Scellé et une chose avec un nom difficile à prononcer, l'Inaltérabilité.
C'est de ces choses fascinantes dont nous allons parler aujourd'hui. D'abord de son fonctionnement dans VBR9.5u4, puis des changements dans la dixième version.
Et que les défenseurs de la langue pure me pardonnent, mais trop de termes est impossible à traduire.
Ainsi, il y aura une multitude d'anglicismes.
Et beaucoup de GIFs.
Et d'images.
- Sans le moindre regret. L'auteur de l'article.
Comment c'était
Eh bien, commençons par examiner la fenêtre de restauration opérationnelle et la sauvegarde scellée (ou comme elle est appelée dans la documentation, Inactive Backup Chain). Sans leur compréhension, il n'est pas possible d'expliquer davantage.
Comme nous le voyons sur l'image, nous avons une certaine chaîne de sauvegarde avec des blocs de données, qui est située sur le niveau de performance du dépôt SOBR, auquel est connecté le Niveau de Capacité. Notre fenêtre de sauvegarde opérationnelle est de trois jours.
Ainsi, la sauvegarde .vbk créée lundi scelle la chaîne précédente, dont la fenêtre est fixée à trois jours. Par conséquent, nous pouvons tranquillement commencer à transférer au niveau de capacité tout ce qui est plus ancien que ces trois jours.
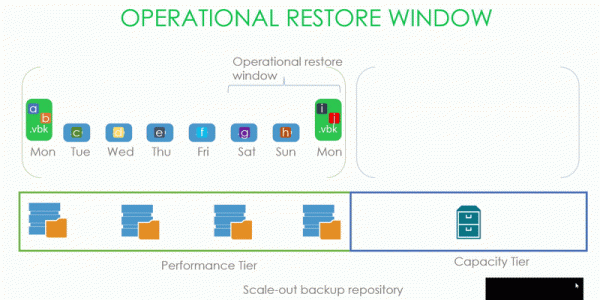
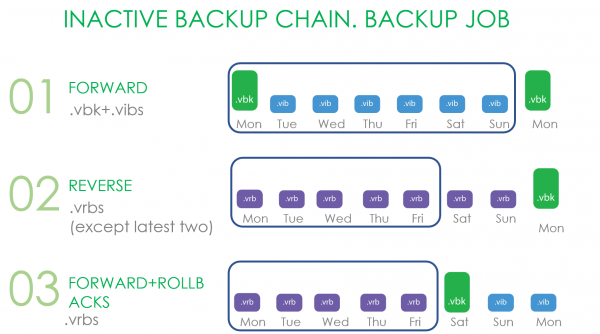
Mais que signifie exactement une chaîne scellée et que pouvait-on envoyer au niveau de capacité dans la mise à jour 4 ?
Pour les Incrémentales Avancées, le signe de la chaîne scellée est la création d'une nouvelle sauvegarde complète. Peu importe comment cette sauvegarde complète est obtenue : les sauvegardes complètes synthétiques et actives sont toutes prises en compte.
Dans le cas des Inversées, ce sont tous les fichiers qui ne rentrent pas dans la fenêtre opérationnelle.
Dans le cas d'un incrementation Forward avec des rollbacks, tous les rollbacks et .vbk, si sur l'extent de performance il y a un autre .vbk.
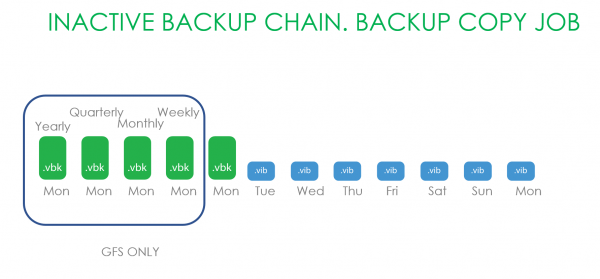
Considérons maintenant le cas des chaînes de copies de sauvegarde. Ici, seules celles entrant sous la rétention GFS sont prises en compte. Car tout ce qui est conservé dans des chaînes de copies de sauvegarde plus récentes peut être modifié d'une manière ou d'une autre.
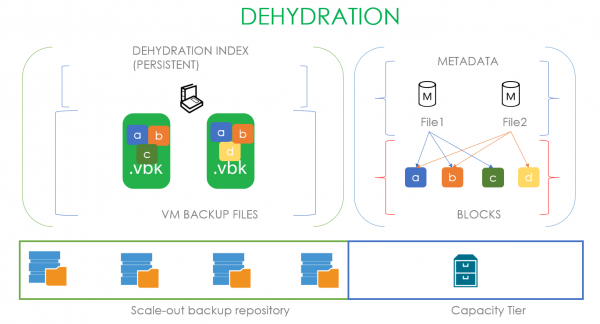
Jetons maintenant un coup d'œil sous le capot. Là, se déroule un processus appelé déshydratation - laissant des fichiers de sauvegarde vides sur l'extent et déplaçant des blocs de ces fichiers vers le stockage de capacité. Pour optimiser ce processus, on utilise ce qu'on appelle un index de déshydratation, qui permet de ne pas copier les blocs qui ont déjà été copiés dans le stockage de capacité.
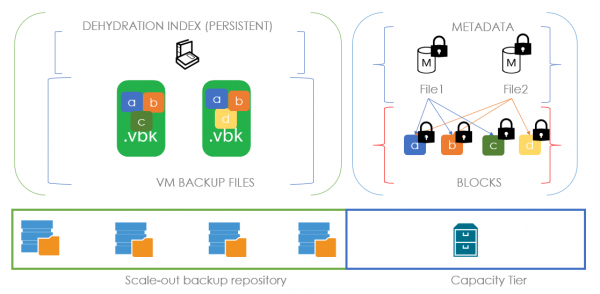
Voyons à quoi cela ressemble avec un exemple : supposons que nous avons un .vbk qui est sorti de la fenêtre opérationnelle et appartient à une chaîne scellée. Cela signifie que nous avons tout à fait le droit de le déplacer vers le stockage de capacité. Au moment du déménagement, un fichier de métadonnées est créé dans le stockage de capacité et les blocs du fichier transféré. Dans le fichier de métadonnées au niveau des liens, il est décrit de quels blocs notre fichier se compose. Dans le cas de l'image, notre premier fichier est composé des blocs a, b, c et les métadonnées contiennent des liens vers ces blocs. Lorsque nous obtenons un deuxième fichier .vbk, prêt à être déplacé et composé des blocs a, b et d, en analysant l'index de déshydratation, nous comprenons que nous n'avons besoin de déplacer que le bloc d. Et son fichier de métadonnées contiendra des liens vers les deux blocs précédents et un nouveau.
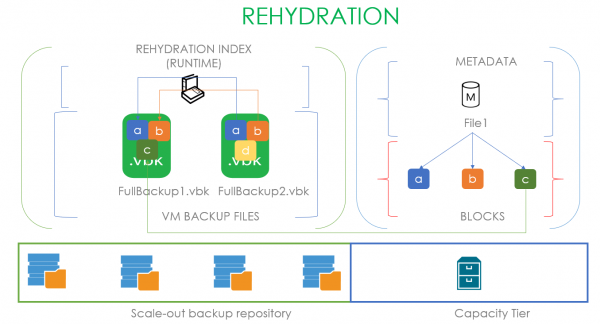
Par conséquent, le processus de remplissage inverse de ces vides avec des données s'appelle régénération. Ici, un index de régénération est utilisé, basé sur le fichier .vbk le plus ancien de l'extent de performance local. Donc, si un utilisateur souhaite récupérer un fichier du stockage de capacité, nous créons d'abord un index des blocs de la plus ancienne sauvegarde complète et transférons du stockage de capacité uniquement les blocs manquants. Dans l'exemple présenté sur l'image, pour régénérer FullBackup1.vbk selon l'index de régénération, il ne nous manque que le bloc C, que nous récupérons du stockage de capacité. Si le stockage de capacité est un stockage d'objet cloud, cela permet d'économiser des sommes considérables.
Il peut sembler que cette technologie soit identique à celle utilisée dans les accélérateurs WAN, mais ce n'est qu'une apparence. Dans les accélérateurs, la déduplication est globale, tandis qu'ici, elle est locale dans chaque fichier à un certain décalage. Cela est dû à la différence des tâches à accomplir : ici, nous devons copier de grands fichiers de sauvegardes complètes, et selon nos recherches, même si un long laps de temps s'écoule entre eux, cet algorithme de déduplication donne les meilleurs résultats.
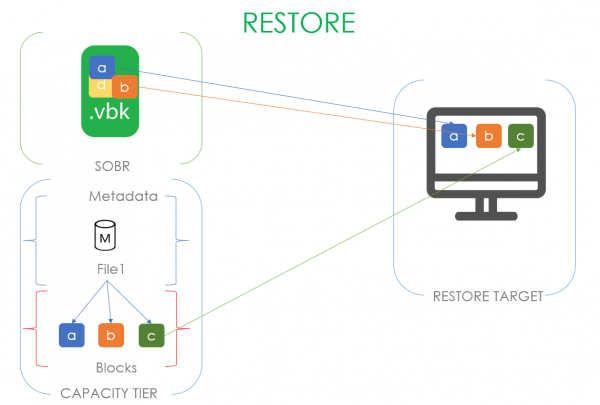
Mais trop d'index ne sont jamais trop ! Il existe encore un index pour la récupération des données ! Lorsque nous lançons la restauration d'une machine se trouvant dans le stockage de capacité, nous ne lirons que les blocs de données uniques, qui ne se trouvent pas dans le stockage de performance.
Comme cela est devenu
C'est tout pour l'introduction. Elle est assez détaillée, mais comme mentionné précédemment, sans ces détails, il n'est pas possible d'expliquer comment fonctionnent les nouvelles fonctionnalités. Donc, sans plus de préambules, passons au premier.
Mode copie
Il est en grande partie basé sur des technologies existantes, mais il comporte une logique d'utilisation complètement différente.
L'objectif de ce mode est de garantir que toutes les données situées sur l'extent local ont une copie dans le stockage de capacité.
Si l'on compare directement les modes Move et Copy, il en ressort ceci :
- On ne peut déplacer qu'une chaîne scellée. Dans le cas du mode copie, tout est transféré, peu importe ce qui se passe dans le travail de sauvegarde.
- Le déplacement se déclenche lorsque les fichiers sortent des limites de la fenêtre de sauvegarde opérationnelle, tandis que la copie se déclenche dès qu'un fichier de sauvegarde apparaît.
- Le suivi des nouvelles données à copier se fait en continu, tandis que pour le déplacement, cela se produisait une fois toutes les 4 heures.
Dans l'examen du nouveau mode, je propose de passer des exemples simples aux plus complexes.
Dans le cas le plus banal, nous avons simplement de nouveaux fichiers avec des incréments, et nous les copions simplement dans le stockage de capacité. Peu importe quel mode est utilisé dans le travail de sauvegarde, peu importe s'il appartient à la partie scellée de la chaîne ou non, peu importe si notre fenêtre opérationnelle a expiré. Nous avons simplement pris et copié.
Le processus derrière cela reste la déshydratation telle que décrite ci-dessus. En mode copie, il veille également à ce que nous ne copions pas les blocs qui sont déjà présents dans notre stockage. La seule différence est que, dans le mode de déplacement, nous remplaçons les fichiers réels par des fichiers vides, tandis qu'ici, nous ne les touchons pas et laissons tout tel quel. Pour le reste, c'est exactement le même indice de déshydratation qui essaie soigneusement d'économiser votre argent et votre temps.
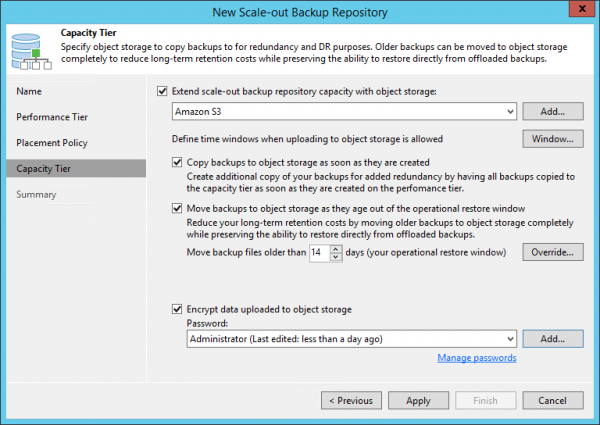
La question se pose — si l'on regarde l'interface utilisateur, il est possible de choisir les deux options en même temps. Comment un tel mode combiné fonctionnera-t-il ?
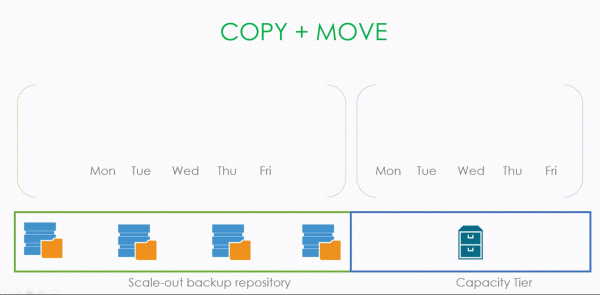
Voyons cela de plus près.
Le début est standard : un fichier de sauvegarde est créé et copié immédiatement. Un incrément est créé et est également copié. Cela se produit jusqu'au moment où nous comprenons que les fichiers ont dépassé notre fenêtre opérationnelle et qu'une chaîne scellée est apparue. À ce moment-là, nous effectuons l'opération de déshydratation et remplaçons ces fichiers par des fichiers vides. Bien sûr, nous ne copions rien à nouveau sur le niveau de capacité.
Tout cela est régi par une simple case à cocher dans l'interface : Copy backups to object storage as soon as they are created.
Mais à quoi sert ce mode Copy ?
Il serait même préférable de reformuler la question ainsi : de quels risques nous protégeons-nous avec son aide ? Quel problème nous aide-t-il à résoudre ?
La réponse est évidente : c'est bien sûr la récupération des données. Si nous avons une copie complète des données locales dans l'objet de stockage, peu importe ce qui arrive à notre production, nous pouvons toujours récupérer les données à partir des fichiers situés dans un certain Amazon.
Examinons donc les scénarios possibles, du plus simple au plus complexe.
Le malheur le plus simple qui peut frapper nos têtes est l'inaccessibilité d'un des fichiers dans la chaîne de sauvegarde.
Une histoire plus triste — un de nos extents de notre dépôt SOBR est tombé en panne.
Il devient encore pire lorsque tout le dépôt SOBR devient inaccessible, mais le niveau de capacité fonctionne.
Et tout va encore plus mal — lorsque le serveur de sauvegarde est mort et que votre premier désir est d'essayer de courir jusqu'à la frontière canadienne en dix minutes.
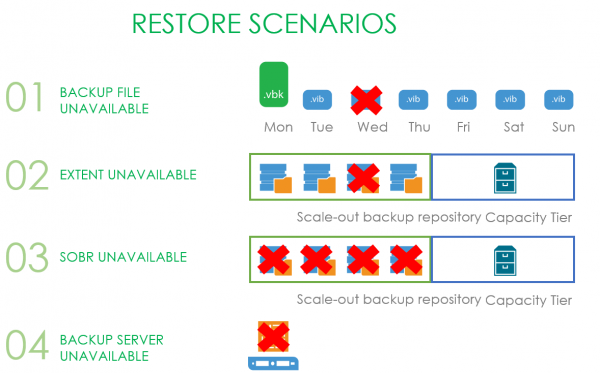
Maintenant, examinons chaque situation séparément.
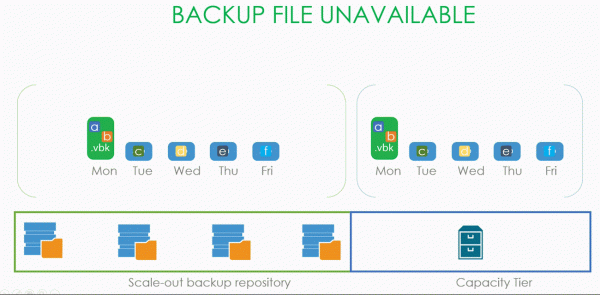
Lorsque nous perdons un (et même plusieurs) fichiers de sauvegarde, il suffit de lancer le processus de rescannage du référentiel, et le fichier perdu sera remplacé par un fichier vide. Grâce au processus de régénération (décrit au début de l'article), l'utilisateur pourra télécharger les données du tir de capacité vers le stockage local.
Maintenant, la situation est plus complexe. Supposons que notre SOBR soit constitué de deux étendues fonctionnant en mode Performance, ce qui signifie que nos fichiers .vbk et .vib sont répartis de manière inégale entre eux. À un moment donné, l'une des étendues devient indisponible, et l'utilisateur doit rapidement restaurer une machine dont une partie des données se trouve précisément sur cette étendue.
L'utilisateur lance l'assistant de récupération, sélectionne le point vers lequel il souhaite restaurer, et au cours du processus, l'assistant réalise qu'il n'a pas toutes les données nécessaires à la récupération localement, et donc il doit les télécharger depuis le tir de capacité. Les blocs qui sont restés dans le stockage local ne seront pas téléchargés depuis le cloud. Grâce à l'index de restauration (oui, cela a également été mentionné au début de l'article).
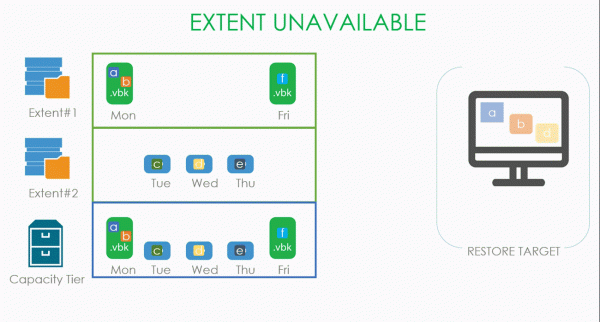
Une variante de ce cas est que l'ensemble du référentiel SOBR est devenu indisponible. Dans ce cas, nous n'avons rien à copier depuis les stockages locaux, et tous les blocs sont téléchargés depuis le cloud.
La situation la plus intéressante est que le serveur de sauvegarde est tombé en panne. Il y a deux options : l'administrateur a bien fait son travail et a effectué des sauvegardes de configuration, ou l'administrateur est son propre ennemi et n'a pas effectué de sauvegarde de configuration.
Dans le premier cas, il lui suffira de déployer une installation propre de VBR quelque part et de restaurer sa base à partir d'une sauvegarde avec les outils standards. À la fin de ce processus, tout reviendra à la normale. Sinon, il sera restauré selon l'un des scénarios ci-dessus.
Mais si l'administrateur est son propre ennemi, ou si une malchance mythique a également frappé la sauvegarde de la configuration, même ici nous ne le laisserons pas à son sort. Pour ce cas, nous avons introduit une nouvelle procédure appelée Import Object Storage. Elle permet de sauter le processus de recréation manuelle du référentiel SOBR et de son attachement à la capacité, suivi d'un rescannage, et d'ajouter simplement le stockage d'objets dans l'interface de Vima et de lancer la procédure Import Storage Repository. La seule chose qui peut se dresser entre vous et vos sauvegardes, c'est une demande de saisie de mot de passe si vos sauvegardes ont été cryptées.
C'est tout pour le mode Copy, et nous passons à
Sealed Mode
Le concept principal est que de nouvelles sauvegardes ne peuvent pas apparaître sur l'extent sélectionné du référentiel SOBR. Avant la version 10, nous avions seulement le mode Maintenance, qui interdisait complètement toute opération sur le référentiel. Un mode hardcore de mise hors service de stockage, où seul le bouton Evacuate était disponible, transférant les sauvegardes vers un autre extent.
Le mode Sealed est une sorte de version "douce" : nous interdisons la création de nouvelles sauvegardes et supprimons progressivement les anciennes selon la rétention choisie, mais tout en conservant la possibilité de restaurer à partir des points stockés. C'est très utile, notamment lorsque la durée de vie de la machine est sur le point de se terminer et qu'elle doit être remplacée, ou qu'il faut simplement libérer de l'espace pour quelque chose de plus important, sans avoir à tout transférer en une seule fois. Ou il n'est pas possible de supprimer.
Ainsi, le principe de fonctionnement est assez simple : il faut interdire toutes les opérations d'écriture (l'apparition de nouvelles données), tout en laissant les opérations de lecture (restaurations) et de suppression (rétention).
Les deux modes peuvent être utilisés simultanément, mais il faut tenir compte du fait que le mode Maintenance a une priorité plus élevée.
Prenons l'exemple d'un SOBR composé de deux extents. Supposons que pendant les quatre premiers jours, nous avons créé des sauvegardes en mode Forward Forever Incremental, puis nous scellons l'extent. Cela entraîne la création d'un nouveau full active sur le deuxième extent disponible. Si notre rétention est de quatre, alors lorsque toute la chaîne située sur l'extent scellé dépasse cette limite, elle est supprimée en toute quiétude.
Il existe des situations où la suppression se produit plus tôt. Par exemple, dans le cas d'une sauvegarde incrémentielle forward avec des sauvegardes complètes périodiques. Si nous avons créé des sauvegardes complètes pendant les deux premiers jours, et que jeudi nous décidons de sceller le dépôt, alors vendredi, lorsque la nouvelle sauvegarde complète sera créée, le fichier du lundi sera supprimé, car à ce point, il n'y a pas de dépendances. Et ce point ne dépend de personne. Ensuite, nous attendons que quatre points soient créés sur l'extent disponible et nous supprimons les trois restants, qui ne peuvent pas être supprimés indépendamment les uns des autres.
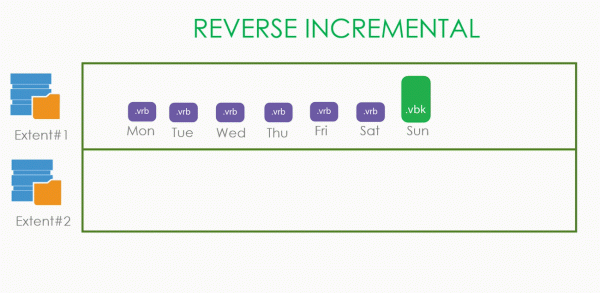
Les choses sont plus simples avec l'incrémentiel reverse. Dans ce cas, les points les plus anciens ne dépendent de rien et peuvent être supprimés sans problème. Par conséquent, dès qu'un nouveau .vbk est créé sur un nouvel extent, les anciens .vrb seront supprimés un par un.
D'ailleurs, pourquoi créons-nous à chaque fois un nouveau .vbk : si nous ne le créons pas et continuons la chaîne d'incréments précédente, l'ancien .vbk resterait bloqué indéfiniment quel que soit le mode, empêchant sa suppression. Il a donc été décidé que dès qu'un extent est scellé, nous créons une sauvegarde complète sur un extent libre.
Les choses sont plus difficiles avec le niveau de capacité.
Commençons par le mode de copie. Supposons que nous avons créé activement des sauvegardes pendant quatre jours, puis que le niveau de capacité a été scellé. Nous ne supprimons rien, mais subissons la rétention, après quoi nous supprimons les données du niveau de capacité.
En gros, la même chose se passe en mode de déplacement : nous attendons la rétention, supprimons les anciennes données dans le stockage local, supprimons celles qui sont dans le stockage d'objets.
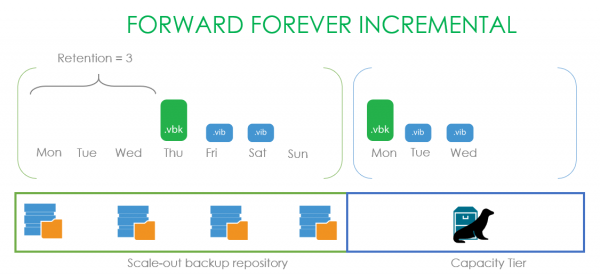
Un exemple intéressant avec l'incrémentiel forward éternel. Nous définissons la rétention à trois points et commençons à faire des sauvegardes depuis lundi, qui sont correctement copiées dans le cloud. Après le scellement du stockage, les sauvegardes continuent à être créées, en maintenant trois points, mais les données stockées dans le niveau de capacité restent dépendantes et ne peuvent pas être supprimées. Par conséquent, nous attendons jeudi, lorsque notre .vbk dépasse la rétention, et seulement alors nous supprimons tranquillement toute la chaîne sauvegardée.
Et une petite remarque : tous les exemples ici sont présentés avec une seule machine. Si vous en avez plusieurs dans la sauvegarde, la rétention sera différente selon que vous avez fait un Active Full ou non.
C'est en gros tout. Passons donc à la fonctionnalité la plus hardcore —
Immutabilité
Comme pour les points précédents, commençons par le problème que cette fonction résout. Dès que nous sauvegardons nos sauvegardes ailleurs pour les stocker, il y a un besoin pressant de garantir leur sécurité, c'est-à-dire d'interdire physiquement leur suppression et toute modification pendant la durée de rétention spécifiée. Cela inclut les administrateurs, même sous leurs comptes root. Cela permet de les protéger contre la corruption accidentelle ou délibérée. Ceux qui travaillent avec AWS ont pu rencontrer une fonction similaire appelée Object Lock.
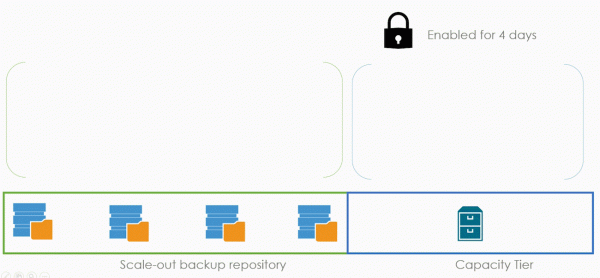
Examinons maintenant le mode en termes généraux, puis approfondissons les détails. Dans notre exemple, l'Immutabilité sera activée pour notre capacité de stockage avec une rétention de quatre jours. Et dans la sauvegarde, le mode Copy est activé.
L'Immutabilité n'interfère en rien avec la rétention générale. Par exemple, elle n'ajoute pas de points supplémentaires ou autre chose de ce genre. Pendant quatre jours, une personne ne peut pas supprimer les fichiers de sauvegarde. Si une sauvegarde est effectuée le lundi, le fichier ne pourra être supprimé que le vendredi.
Tous les concepts de déshydratation, d'index et de métadonnées précédemment expliqués continuent à fonctionner de la même manière. Mais avec une condition — le verrou est appliqué non seulement aux données, mais également aux métadonnées. Cela a été fait au cas où un malfaiteur rusé déciderait de supprimer notre base de métadonnées et pour que les blocs de données ne se transforment pas en une bouillie binaire inutile.
Et maintenant, c'est le moment idéal pour expliquer notre technologie de génération de blocs. Ou block generation. Pour cela, considérons la situation qui a conduit à son apparition.
Prenons une chronologie de six jours et marquons en bas le temps d'expiration attendu de l'immutabilité. Nous commençons par créer le premier jour un fichier, composé d'un bloc de données a et de ses métadonnées. Si l'immutabilité est fixée à trois jours, il est logique de supposer qu'au quatrième jour, les données seront déverrouillées et supprimées. Le deuxième jour, nous ajouterons un nouveau file2, composé d'un bloc b avec les mêmes paramètres. Le bloc a devrait toujours être supprimé le quatrième jour. Mais au troisième jour, quelque chose de terrible se produit : un fichier File3 est créé, composé d'un nouveau bloc d et d'un lien vers l'ancien bloc a. Cela signifie que pour le bloc a, son drapeau d'immutabilité doit être réajusté à une nouvelle durée, qui est décalée au sixième jour. Et ici se pose un problème : dans les sauvegardes réelles de tels blocs, un nombre énorme de ces derniers se crée. Et pour prolonger leur période d'immutabilité, il faut chaque fois effectuer un nombre énorme de requêtes. Et en fait, cela sera un processus presque infini quotidien, car avec une forte probabilité, à chaque copie, nous trouverons d'énormes paquets de blocs dédupliqués. Et que signifie un grand nombre de requêtes pour les fournisseurs de stockage d'objets ? Correct ! Une facture énorme à la fin du mois.
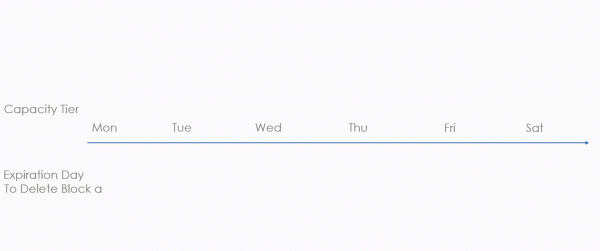
Et pour ne pas faire payer une somme considérable à ses clients adorés pour un rien, un mécanisme de génération de blocs a été conçu. C'est une période additionnelle que nous ajoutons à la période d'immutabilité fixée. Dans l'exemple ci-dessous, cette période équivaut à deux jours. Mais cela n'est qu'un exemple. En réalité, une formule propre est utilisée, donnant environ dix jours supplémentaires lors d'un verrouillage mensuel.
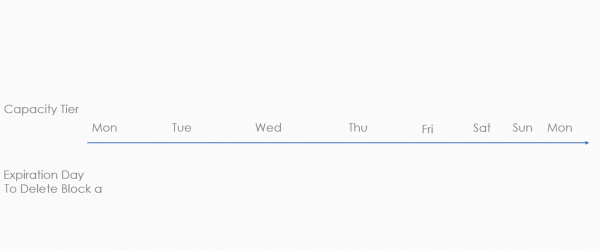
Nous allons continuer à examiner la même situation, mais avec la génération de blocs. Nous créons, le premier jour, file1 à partir du bloc a et des métadonnées. Nous accumulons la période de génération et l'immuabilité — ce qui signifie que la possibilité de supprimer le fichier sera au sixième jour. Si, le deuxième jour, nous créons File2, composé du bloc b et d'un lien vers le bloc a, alors la date prévue de suppression reste inchangée. Elle est toujours fixée au sixième jour. En agissant ainsi, nous essayons d'économiser de l'argent sur le nombre de requêtes. La seule situation où la date peut être déplacée, c'est si la période de génération est écoulée. Autrement dit, si le troisième jour, le nouveau File3 contient un lien vers le bloc a, la génération 2 sera ajoutée car Gen1 est déjà écoulée. La date prévue de suppression du bloc a sera alors décalée au huitième jour. Cela nous permet de réduire de manière significative le nombre de requêtes pour prolonger la durée de vie des blocs dédupliqués, ce qui fait économiser beaucoup d'argent aux clients.
La technologie elle-même est accessible aux utilisateurs S3 et à tout matériel compatible S3, dont les fabricants garantissent que leur mise en œuvre ne diffère pas de celle d'Amazon. D'où la réponse à la question légitime de pourquoi Azure n'est pas pris en charge — ils ont une fonctionnalité similaire, mais elle fonctionne au niveau des conteneurs, et non des objets individuels. À propos, chez Amazon, l'object lock existe en deux modes : compliance et governance. Dans le deuxième cas, il reste possible que le plus grand administrateur des administrateurs et le root des roots, malgré l'object lock, supprime tout de même des données. En mode compliance, tout est solidement fixé et personne ne peut supprimer les sauvegardes. Même pas les administrateurs d'Amazon (selon leurs déclarations officielles). Nous soutenons précisément ce mode.
Et, traditionnellement, quelques liens utiles :
- À propos de en tous détails.
- Toutes les informations sur de la meilleure manière
- O en détails
Source : habr.com
