

Aujourd'hui, il existe 100500 cours sur le Data Science et il est bien connu que le plus d'argent dans ce domaine provient justement des cours de Data Science (pourquoi creuser quand on peut vendre des pelles ?). Le principal inconvénient de ces cours est qu'ils n'ont rien à voir avec le travail réel : personne ne vous fournira des données propres, traitées au format souhaité. Et quand vous terminez un cours et commencez à résoudre un problème réel, de nombreux nuances émergent.
C'est pourquoi nous commençons une série de notes intitulée « Qu'est-ce qui peut mal tourner avec le Data Science », basées sur des événements réels qui se sont produits avec moi, mes amis et collègues. Nous allons examiner à travers des exemples concrets des tâches typiques en Data Science : comment cela se passe réellement. Commençons aujourd'hui par la tâche de collecte de données.
Et le premier obstacle que rencontrent les gens en commençant à travailler avec des données réelles est justement la collecte de ces données pertinentes. Le message clé de cet article :
Nous sous-estimons systématiquement le temps, les ressources et les efforts nécessaires à la collecte, au nettoyage et à la préparation des données.
Et surtout, nous discuterons de ce qu'il faut faire pour éviter cela.
Selon différentes estimations, le nettoyage, la transformation, le traitement des données, l'ingénierie des caractéristiques, etc., prennent 80 à 90 % du temps, tandis que l'analyse ne représente que 10 à 20 %, alors que tout le matériel éducatif se concentre exclusivement sur l'analyse.
Analysons, à titre d'exemple, une tâche analytique simple en trois variantes et voyons quelles peuvent être les « circonstances aggravantes ».
Et pour l'exemple, nous allons encore examiner de telles variations de la tâche de collecte de données et de comparaison entre communautés pour :
- Deux sous-reddits Reddit
- Deux sections de Habr
- Deux groupes Odnoklassniki
Approche conditionnelle en théorie
Ouvrir le site et lire des exemples, si c'est clair, consacrer quelques heures à lire, quelques heures à coder selon les exemples et à déboguer. Ajouter plusieurs heures pour la collecte. Prévoir quelques heures supplémentaires (multiplier par deux et ajouter N heures).
Point clé : l'estimation temporelle repose sur des hypothèses et des conjectures sur le temps que cela prendra.
Commencer l'analyse temporelle nécessite d'évaluer les paramètres suivants pour la tâche conditionnelle décrite ci-dessus :
- Quelle est la taille des données et combien il faut les collecter physiquement (*voir ci-dessous*).
- Quel temps de collecte est nécessaire pour un enregistrement et combien de temps faut-il attendre avant de pouvoir en collecter un second.
- Prévoir l'écriture d'un code qui sauvegarde l'état et redémarre lorsque (et non si) tout échoue.
- Déterminer si nous avons besoin d'une autorisation et prévoir le temps d'accès via l'API.
- Prévoir le nombre d'erreurs comme une fonction de la complexité des données — évaluer en fonction de la tâche spécifique : la structure, le nombre de transformations, ce que nous extrayons et comment.
- Prévoir les erreurs réseau et les problèmes de comportement anormal du projet.
- Évaluer si les fonctions nécessaires sont dans la documentation et si non, combien de temps et comment il faudra pour un contournement.
Le plus important pour évaluer le temps est que vous devez réellement consacrer du temps et des efforts à une 'reconnaissance' — ce n'est qu'alors que votre planification sera adéquate. Donc, peu importe combien on vous pousse à dire 'combien de temps faut-il pour collecter les données' — accordez-vous du temps pour une analyse préliminaire et argumentez par rapport au fait que le temps variera en fonction des paramètres réels de la tâche.
Et maintenant, nous allons présenter des exemples concrets où ces paramètres changeront.
Point clé : l'évaluation est basée sur l'analyse des facteurs clés influençant le volume et la complexité du travail.
Une évaluation basée sur des hypothèses est une bonne approche lorsque les éléments fonctionnels sont assez petits et qu'il n'y a pas beaucoup de facteurs pouvant influencer significativement la structure de la tâche. Mais dans le cas de certaines tâches de Data Science, ces facteurs deviennent extrêmement nombreux et cette approche devient inadéquate.
Comparaison des communautés Reddit
Commençons par le cas le plus simple (comme il s'avérera par la suite). En fait, si nous parlons honnêtement, nous avons pratiquement un cas idéal, vérifions notre liste de contrôle de complexité :
- Il existe une API soignée, claire et documentée.
- Le token est extrêmement simple à obtenir et, surtout, s'obtient automatiquement.
- Oui — avec de nombreux exemples.
- La communauté qui s'occupe de l'analyse et de la collecte de données sur Reddit (jusqu'à des vidéos YouTube expliquant comment utiliser le wrapping Python) .
- Les méthodes dont nous avons besoin existent probablement dans l'API. De plus, le code semble compact et propre, ci-dessous un exemple de fonction collectant les commentaires d'un post.
def get_comments(submission_id):
    reddit = Reddit(check_for_updates=False, user_agent=AGENT)
    submission = reddit.submission(id=submission_id)
    more_comments = submission.comments.replace_more()
    if more_comments:
        skipped_comments = sum(x.count for x in more_comments)
        logger.debug('Skipped %d MoreComments (%d comments)',
                     len(more_comments), skipped_comments)
    return submission.comments.list()
Extrait de une sélection d'outils pratiques pour l'encapsulation.
Bien que nous soyons devant le meilleur des cas, il convient cependant de prendre en compte plusieurs facteurs importants de la vie réelle :
- Limites de l'API — nous sommes contraints de prendre des données par lots (faire des pauses entre les requêtes, etc.).
- Temps de collecte — pour une analyse et une comparaison complètes, il faudra prévoir un temps considérable simplemente pour que le crawler parcourt le subreddit.
- Le bot doit tourner sur un serveur — vous ne pouvez pas simplement le lancer sur un ordinateur portable, le mettre dans un sac à dos et partir faire vos affaires. C'est pourquoi j'ai tout lancé sur un VPS. Avec le code promo habrahabr10, vous pouvez économiser encore 10 % du coût.
- Inaccessibilité physique de certaines données (elles sont visibles pour les admins ou sont trop difficiles à collecter) — cela doit être pris en compte, toutes les données ne peuvent pas être collectées dans un temps raisonnable.
- Erreurs de fonctionnement du réseau : travailler avec le réseau est compliqué.
- Ce sont des données réelles et vivantes — elles ne sont jamais propres.
Bien sûr, il est nécessaire de prendre en compte ces nuances dans le développement. Les heures/jours spécifiques dépendent de l'expérience en développement ou de l'expérience sur des tâches similaires, néanmoins nous voyons que cette tâche est purement technique et ne nécessite pas de mouvements supplémentaires pour être résolue — tout peut être bien évalué, décrit et réalisé.
Comparaison des sections de Habr
Passons à un cas plus intéressant et non trivial, la comparaison des flux et/ou des sections de Habr.
Vérifions notre liste de contrôle de la complexité — ici, pour comprendre chaque point, il faudra déjà un peu s'essayer à la tâche elle-même et expérimenter.
- Au début, vous pensez qu'il existe une API, mais il n'y en a pas. Oui, Habr a une API, mais elle n'est accessible qu'aux admins (ou peut-être qu'elle ne fonctionne pas du tout).
- Ensuite, vous commencez simplement à parser le html — «import requests», que peut-il mal se passer ?
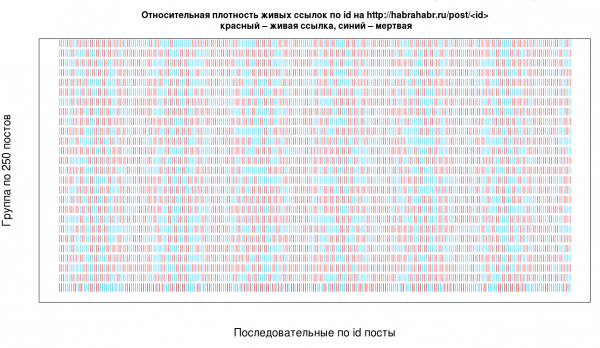
- Et comment parser, en fait ? L'approche la plus simple et la plus couramment utilisée consiste à itérer par ID, à noter que ce n'est pas forcément la plus efficace et qu'il faudra gérer différents cas — voici par exemple la densité des ID réels parmi tous les ID existants.

Extrait de articles. - Les données brutes enveloppées dans du HTML sur le réseau sont un vrai casse-tête. Par exemple, si vous souhaitez collecter et sauvegarder la note d'un article : vous extrayez le score du HTML et décidez de le conserver comme un nombre pour un traitement ultérieur.
1) int(score) génère une erreur : car sur Habr, le moins, comme dans la ligne "–5" — c'est un tiret court, pas un signe moins (surprenant, n'est-ce pas ?), donc à un moment, il a fallu nous redonner vie au parseur avec une solution aussi affreuse.
try:
      score_txt = post.find(class_="score").text.replace(u"–","-").replace(u"+","+")
      score = int(score_txt)
      if check_date(date):
        post_score += score
Les dates, les plus et les moins peuvent totalement manquer (comme nous le voyons ci-dessus avec la fonction check_date, et cela s'est produit).
2) Les caractères spéciaux non échappés — ils arriveront, il faut être prêt.
3) La structure varie en fonction du type de post.
4) Les anciens posts peuvent avoir une **structure étrange**.
- En réalité, le traitement des erreurs et ce qui peut ou ne peut pas se produire devront être gérés et il est impossible de prévoir avec certitude ce qui peut mal tourner et quelle pourrait être la structure, et où cela pourrait échouer — il faudra juste essayer et prendre en compte les erreurs que le parseur renvoie.
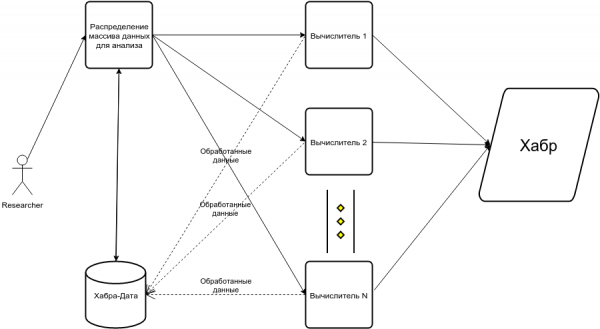
- Puis vous comprenez qu'il faut parser en plusieurs threads sinon le parsing en un seul prendra 30+ heures (c'est purement le temps d'exécution d'un parseur à thread unique, qui dort et n'encourt aucune interdiction). Dans l'article, cela a conduit à un moment donné à schémas comme celui-ci :
Au final, une checklist par rapport à la complexité :
- Travailler avec le réseau et le parsing HTML avec itération et parcours par ID.
- Documents de structure hétérogène.
- De nombreux endroits où le code peut facilement échouer.
- Il est nécessaire d'écrire || du code.
- Documentation manquante, exemples de code et/ou communauté.
L'évaluation conditionnelle du temps pour cette tâche sera de 3 à 5 fois plus élevée que pour la collecte de données sur Reddit.
Comparaison des groupes de Odnoklassniki
Passons au cas techniquement le plus intéressant parmi ceux décrits. Pour moi, il était fascinant en raison du fait qu'à première vue, il semble assez trivial, mais il ne l'est pas du tout — dès que vous le poussez avec un bâton.
Commençons avec notre checklist de complexité et notons que beaucoup d'entre elles se révéleront beaucoup plus compliquées qu'elles n'en ont l'air au départ :
- L'API existe, mais elle est presque entièrement dépourvue des fonctions nécessaires.
- Pour certaines fonctions, il faut demander un accès par e-mail, ce qui signifie que l'octroi d'accès n'est pas instantané.
- Il est horriblement documenté (pour commencer, les termes russes et anglais s'entremêlent partout, de manière totalement incohérente — parfois, il faut simplement deviner ce qui est attendu) et, de plus, il n'est pas conçu pour obtenir des données, par exemple, .
- Il nécessite une session dans la documentation, mais dans les faits, elle n'est pas utilisée — et il n'y a aucun moyen de comprendre les subtilités des modes d'API, sauf à tâtonner et espérer que quelque chose fonctionne.
- Il manque des exemples et une communauté, le seul point de référence pour recueillir des informations étant un petit en Python (avec peu d'exemples d'utilisation).
- La solution la plus efficace semble être Selenium, car de nombreuses données nécessaires sont sous clé.
1) Cela signifie qu'une authentification est effectuée via un utilisateur fictif (et une inscription manuelle).2) Cependant, avec Selenium, aucune garantie de fonctionnement correct et répétable (en tout cas dans le cas de ok.ru, c'est sûr).
3) Le site ok.ru contient des erreurs JavaScript et se comporte parfois de manière étrange et incohérente.
4) Il faut gérer la pagination, le chargement des éléments, etc.
5) Les erreurs d'API renvoyées par le wrapper devront être traitées de manière artisanale, par exemple, comme ceci (un extrait de code expérimental) :
def get_comments(args, context, discussions):
    pause = 1
    if args.extract_comments:
        all_comments = set()
#makes sense to keep track of already processed discussions
        for discussion in tqdm(discussions):
            try:
                comments = get_comments_from_discussion_via_api(context, discussion)
            except odnoklassniki.api.OdnoklassnikiError as e:
                if "NOT_FOUND" in str(e):
                    comments = set()
                else:
                    print(e)
                    bp()
                    pass
            all_comments |= comments
            time.sleep(pause)
        return all_comments
Mon erreur préférée était :
OdnoklassnikiError("Erreur(code: 'None', description: 'Erreur HTTP', method: 'discussions.getComments', params: …)")6) En fin de compte, la combinaison Selenium + API semble être l'option la plus rationnelle.
- Un état de conservation et un redémarrage du système sont nécessaires, le traitement de nombreuses erreurs, y compris le comportement incohérent du site — ces erreurs étant assez difficiles à imaginer (si vous ne rédigez pas des parseurs de manière professionnelle, bien sûr).
L'évaluation conditionnelle du temps pour cette tâche sera de 3 à 5 fois plus élevée que pour la collecte de données depuis Habr. Bien que dans le cas de Habr, nous utilisions une approche directe avec le parsing HTML, alors que dans le cas de OK, nous pouvons intervenir avec l'API dans des endroits critiques.
Conclusions
Peu importe la manière dont on vous demande une estimation des délais « sur place » (après tout, nous sommes en phase de planification aujourd'hui !), évaluer le temps de réalisation d'un module volumineux de pipeline de traitement de données est pratiquement impossible, même qualitativement, sans une analyse approfondie des paramètres de la tâche.
Pour parler de manière un peu plus philosophique, les stratégies d'évaluation en agile conviennent assez bien aux tâches d'ingénierie, mais lorsqu'il s'agit de tâches plus expérimentales et, en quelque sorte, « créatives » et de recherche, c'est-à-dire, moins prévisibles, des difficultés apparaissent, comme dans les exemples que nous avons analysés ici.
Bien sûr, la collecte de données est un exemple illustratif évident — cette tâche paraît habituellement incroyablement simple et techniquement peu complexe, et c'est là que se cache le diable, dans les détails. C'est précisément dans cette tâche que l'on peut démontrer tout le spectre des scénarios où les choses peuvent mal tourner et combien le travail peut réellement s'éterniser.
Si l'on jette un œil aux caractéristiques de la tâche sans expérimentations supplémentaires, Reddit et OK semblent similaires : il y a une API, un wrapper python, mais en réalité, la différence est énorme. Sur la base de ces paramètres, parser Habr paraît plus complexe que OK — alors qu'en pratique, c'est tout le contraire, et cela peut être déterminé en menant de simples expérimentations sur l'analyse des paramètres de la tâche.
D'après mon expérience, l'approche la plus efficace est de faire une estimation approximative du temps nécessaire pour la pré-analyse et les premières expérimentations, ainsi que pour la lecture de la documentation — c'est cela qui vous permettra de donner une estimation précise pour l'ensemble du travail. En termes de méthodologie agile populaire, je demande à ouvrir un ticket pour « l'évaluation des paramètres de la tâche », sur la base duquel je peux fournir une estimation de ce qui peut être réalisé dans le cadre d'un « sprint » et donner une estimation plus précise pour chaque tâche.
Par conséquent, l'argument qui semble le plus efficace est celui qui montre à un spécialiste « non technique » à quel point le temps et les ressources varieront en fonction des paramètres qui restent à évaluer.
Source : habr.com
