

Le marché de l'informatique répartie et des données volumineuses, si l'on en croit , croît de 18 à 19 % par an. Cela signifie que la question du choix des logiciels pour ces objectifs reste d'actualité. Dans cet article, nous commencerons par expliquer pourquoi l'informatique répartie est nécessaire, nous examinerons plus en détail le choix des logiciels, nous parlerons de l'utilisation de Hadoop avec Cloudera et, enfin, nous aborderons le choix du matériel et la manière dont il influence la performance de différentes manières.
Pourquoi l'informatique répartie est-elle nécessaire dans les entreprises ordinaires ? C'est à la fois simple et complexe. Simple — car dans la plupart des cas, nous réalisons des calculs relativement simples par unité d'information. Complexe — parce que cette information est abondante. Très abondante. En conséquence, nous devons . Ainsi, les scénarios d'utilisation sont plutôt universels : les calculs peuvent être appliqués partout où il est nécessaire de prendre en compte un grand nombre de métriques sur des ensembles de données encore plus vastes.
Un des exemples récents : la chaîne de pizzerias Dodo Pizza sur la base de l'analyse de la base de données des commandes des clients, que lors du choix d'une pizza à garniture aléatoire, les utilisateurs se basent généralement sur six ensembles d'ingrédients de base, plus quelques aléatoires. En conséquence, la pizzeria a ajusté ses achats. De plus, cela lui a permis de mieux recommander des produits supplémentaires lors de la commande, ce qui a permis d'augmenter les profits.
Un autre exemple : des articles a permis au magasin H&M de réduire son assortiment dans certains magasins de 40 %, tout en maintenant son niveau de ventes. Cela a été possible en excluant les articles peu vendus, en tenant compte de la saisonnalité.
Choix de l'outil
La norme industrielle pour ce type de calcul est Hadoop. Pourquoi ? Parce que Hadoop est un excellent framework bien documenté (même Habr publie de nombreux articles détaillés à ce sujet), qui est accompagné d'un ensemble d'outils et de bibliothèques. Vous pouvez lui soumettre d'énormes ensembles de données à la fois structurées et non structurées, et le système s'occupera de les répartir entre les ressources de calcul. De plus, ces ressources peuvent être accrus ou diminués à tout moment — c'est la scalabilité horizontale en action.
En 2017, la société de conseil influente Gartner , que Hadoop serait bientôt obsolète. La raison est assez banale : les analystes estiment que les entreprises commenceront à migrer massivement vers le cloud, car elles pourront payer en fonction de leur utilisation des ressources de calcul. Un deuxième facteur important qui pourrait prétendument « enterrer » Hadoop est la vitesse de fonctionnement. En effet, des options comme Apache Spark ou Google Cloud DataFlow fonctionnent plus rapidement que MapReduce, qui est à la base de Hadoop.
Hadoop repose sur plusieurs piliers, les plus notables étant les technologies MapReduce (un système de répartition des données pour des calculs entre serveurs) et le système de fichiers HDFS. Ce dernier est spécifiquement conçu pour stocker des informations réparties entre les nœuds d'un cluster : chaque bloc de taille fixe peut être placé sur plusieurs nœuds, et grâce à la réplication, la résilience du système face aux pannes de certains nœuds est garantie. Au lieu d'un tableau de fichiers, un serveur spécial appelé NameNode est utilisé.
L'illustration ci-dessous montre le schéma de fonctionnement de MapReduce. Au premier stade, les données sont divisées selon un critère défini, au second, elles sont réparties sur les ressources de calcul, et au troisième, le calcul intervient.
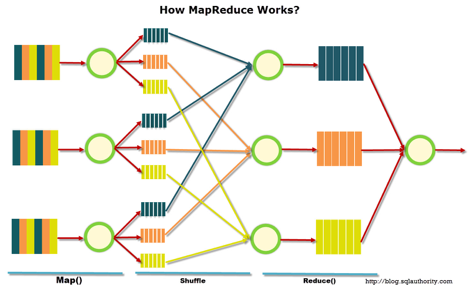
Initialement, MapReduce a été créé par Google pour ses besoins en recherche. Ensuite, MapReduce est devenu open source, et le projet a été pris en charge par Apache. Quant à Google, il a progressivement migré vers d'autres solutions. Un point intéressant : actuellement, Google a un projet appelé Google Cloud Dataflow, présenté comme la prochaine étape après Hadoop, comme une substitution rapide.
À un examen détaillé, on constate que Google Cloud Dataflow est basé sur une variante d'Apache Beam, qui inclut le framework bien documenté Apache Spark, ce qui permet d'affirmer que la vitesse d'exécution des solutions est pratiquement équivalente. De plus, Apache Spark fonctionne parfaitement sur le système de fichiers HDFS, ce qui permet de le déployer sur des serveurs Hadoop.
Ajoutons à cela le volume de documentation et de solutions prêtes concernant Hadoop et Spark par rapport à Google Cloud Dataflow, et le choix de l'outil devient évident. De plus, les ingénieurs peuvent décider eux-mêmes quel code exécuter — pour Hadoop ou Spark — en fonction de la tâche, de leur expérience et de leur qualification.
Cloud ou serveur local
La tendance à la migration vers le cloud a même engendré un terme intéressant comme Hadoop-as-a-service. Dans ce scénario, l'administration des serveurs connectés est devenue très importante. Car, malheureusement, malgré sa popularité, Hadoop pur reste un outil assez complexe à configurer, car beaucoup de choses doivent être faites manuellement. Par exemple, configurer individuellement les serveurs, surveiller leurs indicateurs, et ajuster soigneusement de nombreux paramètres. En gros, c'est un travail pour les amateurs et il y a un grand risque de faire des erreurs ou de laisser passer quelque chose.
C'est pourquoi divers distributions sont devenues très populaires, car elles sont initialement équipées d'outils de déploiement et d'administration pratiques. L'une des distributions les plus populaires qui supportent Spark et simplifient tout est Cloudera. Elle a des versions payantes et gratuites — et dans la dernière, toutes les fonctionnalités principales sont disponibles, sans limitation du nombre de nœuds.
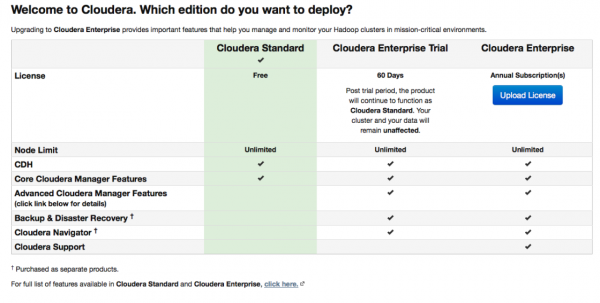
Lors de la configuration, Cloudera Manager se connectera à vos serveurs via SSH. Un point intéressant : lors de l'installation, il est préférable d'indiquer que cela se fasse avec des packages: des paquets spéciaux, chacun contenant tous les composants nécessaires, configurés pour fonctionner ensemble. En gros, c'est une version améliorée du gestionnaire de paquets.
Après l'installation, nous obtenons un tableau de bord de gestion du cluster, où l'on peut voir la télémétrie des clusters, les services installés, et vous pourrez ajouter/supprimer des ressources et modifier la configuration du cluster.
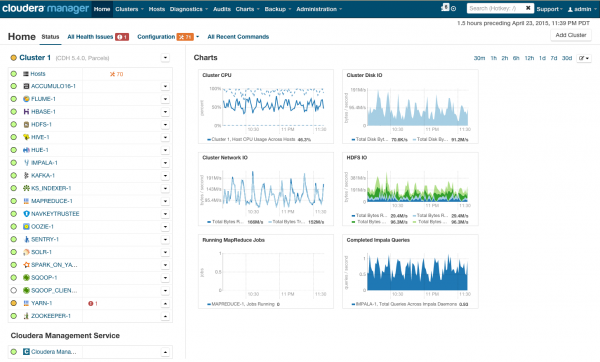
Vous avez devant vous la découpe de la fusée qui vous emmènera vers un avenir radieux avec BigData. Mais avant de dire « c'est parti », jetons un œil sous le capot.
Exigences matérielles
Sur son site, Cloudera mentionne différentes configurations possibles. Les principes généraux sur lesquels elles sont basées sont présentés dans l'illustration :
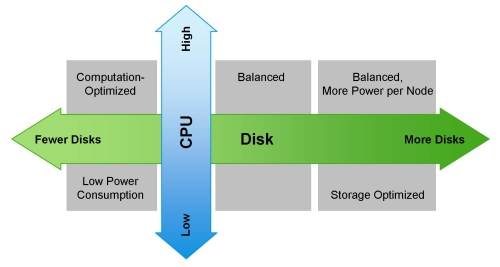
Cette image optimiste peut être assombrie par MapReduce. En regardant à nouveau le schéma du chapitre précédent, il devient évident que presque dans tous les cas, une tâche MapReduce peut rencontrer un « goulot d'étranglement » lors de la lecture des données depuis un disque ou un réseau. Cela est également noté dans le blog de Cloudera. Par conséquent, pour des calculs rapides, y compris ceux via Spark, qui est souvent utilisé pour des calculs en temps réel, la vitesse d'entrée/sortie est primordiale. C'est pourquoi, lors de l'utilisation de Hadoop, il est essentiel que le cluster soit composé de machines équilibrées et rapides, ce qui, pour dire les choses simplement, n'est pas toujours garanti dans une infrastructure cloud.
L'équilibrage de la charge est atteint grâce à l'utilisation de la virtualisation Openstack sur des serveurs avec des processeurs multi-cœurs puissants. Les nœuds de données se voient attribuer leurs propres ressources processeur et disques spécifiques. Dans notre solution Atos Codex Data Lake Engine une large virtualisation est réalisée, ce qui nous permet de bénéficier à la fois de performances accrues (impact minimal de l'infrastructure réseau) et de coûts totaux de possession réduits (suppression des serveurs physiques superflus).
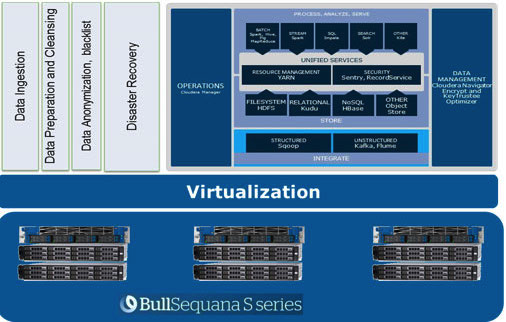
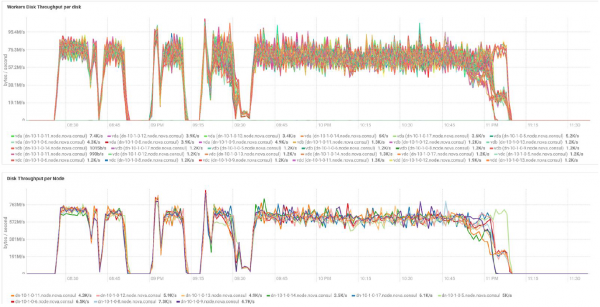
En utilisant des serveurs BullSequana S200, nous obtenons une charge de travail très uniforme, dépourvue de certains goulots d'étranglement. La configuration minimale comprend 3 serveurs BullSequana S200, chacun avec deux JBOD, plus des S200 supplémentaires pouvant être connectés, contenant quatre nœuds de données chacun. Voici un exemple de la charge dans le test TeraGen :
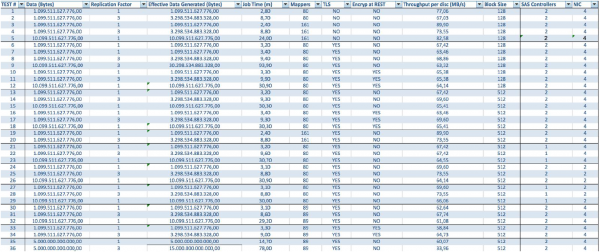
Des tests avec différents volumes de données et valeurs de réplication montrent des résultats identiques en termes de répartition de la charge entre les nœuds du cluster. Ci-dessous se trouve un graphique de la répartition de l'accès au disque lors des tests de performance.
Les calculs ont été réalisés sur la base d'une configuration minimale composée de 3 serveurs BullSequana S200. Cela inclut 9 nœuds de données et 3 nœuds principaux, ainsi que des machines virtuelles réservées au cas où la protection serait déployée sur la base de l'OpenStack Virtualization. Le résultat du test TeraSort : taille de bloc de 512 Mo avec un facteur de réplication de trois, avec chiffrement, est de 23,1 minutes.
Comment peut-on étendre le système ? Divers types d'extensions sont disponibles pour Data Lake Engine :
- Nœuds de transfert de données : pour chaque 40 To d'espace utile
- Nœuds analytiques avec possibilité d'installation de GPU
- Autres options selon les besoins de l'entreprise (par exemple, si Kafka est nécessaire, etc.)
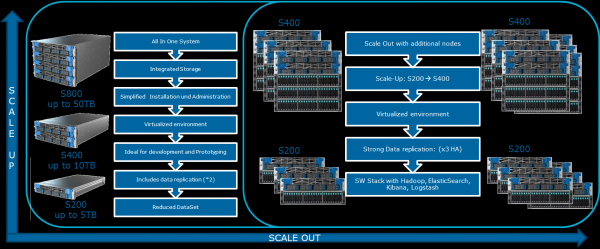
Le complexe Atos Codex Data Lake Engine comprend à la fois les serveurs eux-mêmes et le logiciel préinstallé, comprenant le package Cloudera avec licence ; Hadoop lui-même, OpenStack avec des machines virtuelles basées sur le noyau RedHat Enterprise Linux, système de réplication des données et de sauvegarde (notamment via le nœud de sauvegarde et Cloudera BDR - Backup and Disaster Recovery). Atos Codex Data Lake Engine a été la première solution à utiliser la virtualisation et a été certifiée. .
Si vous souhaitez plus de détails, nous serons ravis de répondre à vos questions dans les commentaires.
Source : habr.com
