

Bonjour !
Je m'appelle Mikhaïl, je suis le directeur adjoint des technologies de l'information chez « Sportmaster ». Je veux partager une histoire sur la façon dont nous avons surmonté les difficultés survenues pendant la pandémie.
Dans les premiers jours de la nouvelle réalité, le format traditionnel de vente hors ligne de « Sportmaster » s'est figé, et la charge sur notre canal en ligne, en particulier en ce qui concerne la livraison à l'adresse des clients, a augmenté dix fois. En quelques semaines, nous avons transformé un immense volume d'affaires hors ligne en ligne, adaptant le service aux besoins de nos clients.
En gros, ce qui était essentiellement notre opération secondaire est devenu notre activité principale. L'importance de chaque commande en ligne a considérablement augmenté. Nous devions sauvegarder chaque rouble que le client apportait à l'entreprise.
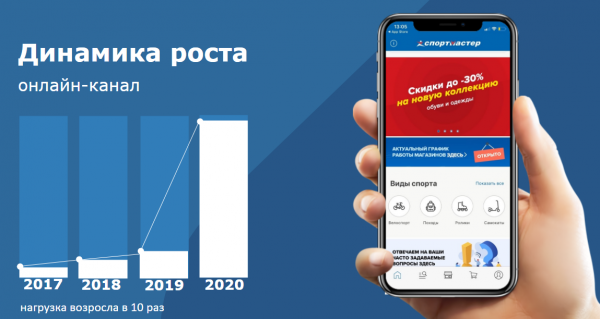
Pour réagir rapidement aux demandes des clients, nous avons ouvert un centre de contact supplémentaire dans le bureau principal de l'entreprise, et nous pouvons désormais traiter environ 285 000 appels par semaine. En même temps, nous avons transformé 270 magasins en un nouveau format de travail sans contact et sécurisé, ce qui a permis aux clients de recevoir leurs commandes et aux employés de conserver leurs emplois.
Au cours de la transformation, nous avons rencontré deux problèmes majeurs. D'une part, la charge sur nos ressources en ligne a considérablement augmenté (Sergueï expliquera comment nous y avons fait face). D'autre part, le flux d'opérations rares (avant COVID) a augmenté de manière exponentielle, ce qui a nécessité un volume substantiel d'automatisation rapide. Pour résoudre ce problème, nous avons dû redéployer rapidement des ressources depuis des domaines qui étaient auparavant principaux. Elena expliquera comment nous avons géré cela.
Exploitation des services en ligne
Kolessnikov Sergueï, responsable de l'exploitation de la boutique en ligne et des microservices
Depuis le moment où nos magasins physiques ont commencé à fermer leurs portes aux visiteurs, nous avons commencé à constater une augmentation de métriques telles que le nombre d'utilisateurs, le nombre de commandes passées dans notre application, le nombre de requêtes aux applications.
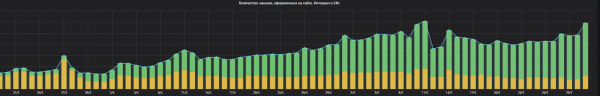 Nombre de commandes du 18 au 31 mars
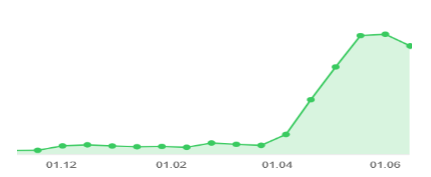 Nombre de requêtes aux microservices de paiement en ligne
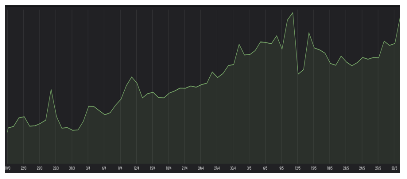 Nombre de commandes passées sur le site
Dans le premier graphique, nous voyons que l'augmentation est d'environ 14 fois, dans le second — 4 fois. Nous considérons que la métrique du temps de réponse de nos applications est la plus révélatrice à cet égard.
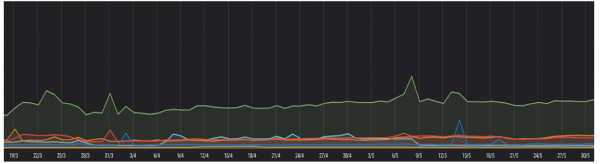
Sur ce graphique, nous voyons la réponse des fronts et des applications, et pour nous, nous avons déterminé qu'il n'y avait pas eu de croissance significative.
Tout d'abord, cela est lié au fait que nous avons commencé les travaux préparatoires à la fin de 2019. Actuellement, nos services sont réservés, offrant une tolérance aux pannes au niveau des serveurs physiques, des systèmes de virtualisation, des conteneurs, ainsi que des services qui en dépendent. De plus, la capacité de nos ressources serveur permet de supporter une charge multiple.
L'outil principal qui nous a aidés dans toute cette histoire a été notre système de surveillance. Cependant, il n'y a pas si longtemps, nous n'avions pas de système uniforme capable de collecter des métriques à tous les niveaux, de l'équipement physique et matériel aux métriques commerciales.
Formellement, la surveillance existait dans l'entreprise, mais en règle générale, elle était dispersée et sous la responsabilité de départements spécifiques. En fait, lorsque survenait un incident, nous n'avions presque jamais une compréhension unique de ce qui s'était passé, il n'y avait pas d'information, ce qui entraînait souvent une course en rond pour trouver et localiser le problème afin de le résoudre.
À un moment donné, nous avons pensé et décidé qu'il était temps d'arrêter cela — nous avions besoin d'un système unique pour voir l'ensemble du tableau. Les principales technologies de notre pile incluent Zabbix comme centre d'alerte et de stockage des métriques, Prometheus pour la collecte et le stockage des métriques des applications, la stack ELK pour la journalisation et le stockage des données de tout le système de surveillance, ainsi que Grafana pour la visualisation, Swagger, Docker et d'autres outils utiles et déjà connus de vous.
Nous n'utilisons pas seulement les technologies disponibles sur le marché, mais nous développons aussi certaines choses nous-mêmes. Par exemple, nous créons des services pour intégrer les systèmes entre eux, à savoir une sorte d'API pour la collecte de métriques. De plus, nous travaillons sur nos propres systèmes de surveillance — au niveau des métriques commerciales, nous utilisons des tests d'interface utilisateur. Nous avons également un bot sur Telegram pour notifier les équipes.
De plus, nous essayons de rendre le système de surveillance accessible aux équipes, afin qu'elles puissent stocker leurs métriques et travailler avec elles de manière autonome, y compris configurer des alertes sur certaines métriques spécifiques ayant une utilité limitée.
Au sein de tout le système, nous visons la proactivité et une localisation rapide des incidents. De plus, le nombre de nos microservices et systèmes a considérablement augmenté ces derniers temps, ce qui accroît également le nombre d'intégrations. Dans le cadre de l'optimisation du processus de diagnostic des incidents au niveau de l'intégration, nous développons un système permettant d'effectuer des vérifications croisées entre systèmes et de fournir des résultats, ce qui permet d'identifier les principaux problèmes liés aux imports et à l'interaction entre les systèmes.
Naturellement, il nous reste encore des progrès à faire et à développer en matière d'exploitation des systèmes, et nous travaillons activement là-dessus. Vous pouvez en savoir plus sur notre système de surveillance. .
Essais techniques
Sergueï Orlov, dirige le centre de compétence en développement web et mobile
Depuis la fermeture des magasins physiques, nous avons dû faire face à divers défis en matière de développement. En premier lieu, l'augmentation de la charge elle-même. Il est évident que si des mesures appropriées ne sont pas prises, sous une forte charge, le système peut se transformer tristement en citrouille, soit en dégringolant en performance, soit en perdant complètement son efficacité.
Le deuxième aspect, un peu moins évident, est que le système devait être modifié très rapidement sous une forte charge, en s'adaptant aux changements des processus d'affaires. Parfois plusieurs fois par jour. Dans de nombreuses entreprises, il existe une règle selon laquelle, lors de grandes activités marketing, il ne faut apporter aucune modification au système. Absolute aucune, laissez-le fonctionner, tant qu'il fonctionne.
Et pour nous, c'était en quelque sorte un Black Friday sans fin, pendant lequel il fallait changer le système. Et chaque erreur, problème, ou échec dans le système aurait coûté cher à l'entreprise.
Pour devancer, je dirai que nous avons réussi à faire face à ces défis, tous les systèmes ont supporté la charge, se sont facilement redimensionnés et nous n'avons pas eu de pannes techniques majeures.
Il existe quatre piliers sur lesquels repose la capacité d'un système à gérer des charges élevées et soudaines. Le premier est la surveillance, dont vous avez déjà entendu parler un peu plus haut. Sans un système de surveillance efficace, il est pratiquement impossible d'identifier les goulets d'étranglement du système. Un bon système de surveillance est comme des vêtements de maison, il doit être confortable et adapté à vos besoins.
Le deuxième aspect est le test. Nous prenons ce point très au sérieux : nous écrivons à la fois des tests unitaires classiques, des tests d'intégration, des tests de charge et bien d'autres pour chaque système. Nous rédigeons également une stratégie de test et nous nous efforçons d'atteindre un niveau de test tel que les contrôles manuels ne soient plus nécessaires.
Le troisième pilier est le pipeline CI/CD. Les processus de construction, de test et de déploiement de l'application doivent être le plus automatisés possible, sans aucune intervention manuelle. La thématique du pipeline CI/CD est assez vaste, et je ne vais l'aborder qu'en surface. Il suffit de mentionner que nous avons une liste de contrôle pour le pipeline CI/CD, par laquelle chaque équipe produit passe avec l'aide de centres de compétence.
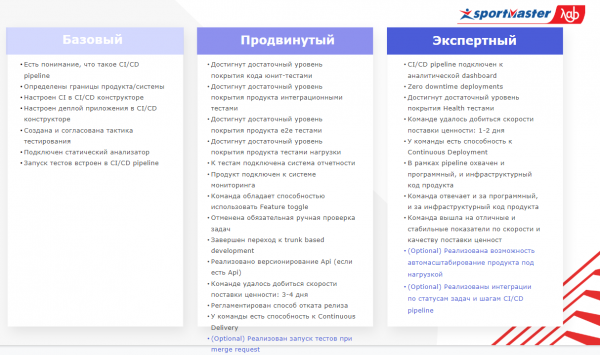 Voici la liste de contrôle
Cela permet d'atteindre de nombreux objectifs. Il s'agit de la version API, des fonctionnalités de commutation pour éviter les lancements en série, et de la couverture des différents tests à un niveau où les tests sont entièrement automatisés, rendant les déploiements transparents, et bien plus encore.
Le quatrième pilier est constitué des principes architecturaux et des solutions techniques. On peut parler longuement de l'architecture, mais je souhaite souligner quelques principes sur lesquels j'aimerais attirer votre attention.
Tout d'abord, il est essentiel de choisir des outils spécialisés en fonction des tâches spécifiques. Cela semble évident, et il est clair que pour enfoncer des clous, il faut un marteau, et pour démonter une montre, des tournevis spécialisés. Cependant, dans notre époque actuelle, de nombreux outils tendent vers l'universalité, afin de toucher un maximum d'utilisateurs : bases de données, caches, frameworks, et autres. Prenons par exemple la base de données MongoDB qui fonctionne avec des transactions multi-documents, alors que la base de données Oracle travaille avec des JSON. On pourrait penser que tout peut être utilisé pour tout. Mais si nous prônons la performance, il est crucial de comprendre clairement les forces et les faiblesses de chaque outil, et de n'utiliser que ceux qui conviennent à notre classe de tâches.
Deuxièmement, lors de la conception des systèmes, chaque augmentation de la complexité doit être justifiée. Nous devons toujours garder cela à l'esprit, le principe du faible couplage est bien connu. Je pense qu'il doit être appliqué à la fois au niveau de chaque service, au niveau de l'ensemble du système et au niveau de l'architecture globale. Il est également important que chaque composant du système puisse se mettre à l'échelle horizontalement face à la charge. Disposer de cette capacité rendra le processus d'escalade beaucoup plus simple.
Concernant les solutions techniques, nous avons demandé aux équipes produit de préparer un nouvel ensemble de recommandations, d'idées et de solutions qu'elles ont mises en œuvre dans le cadre de la préparation de la prochaine vague de charge.
Caches
Il est nécessaire d'aborder consciemment le choix entre caches locaux et répartis. Parfois, il peut être judicieux d'utiliser les deux dans un même système. Par exemple, nous avons des systèmes où une partie des données est essentiellement un cache d'affichage, c'est-à-dire que la source de mises à jour se trouve en dehors du système lui-même, et ces données ne sont pas modifiées par le système. Pour cette approche, nous utilisons un cache local Caffeine.
Il existe également des données que le système modifie activement pendant son fonctionnement, et c'est ici que nous appliquons un cache distribué avec Hazelcast. Cette approche nous permet de tirer parti des avantages d'un cache distribué là où ils sont réellement nécessaires, tout en minimisant les frais de service liés à la circulation des données du cluster Hazelcast quand nous pouvons faire sans. et .
De plus, le changement de sérialiseur en Kryo dans Hazelcast nous a donné un bon gain de performance. Le passage de ReplicatedMap à IMap + Near Cache dans Hazelcast nous a permis de minimiser le mouvement des données à travers le cluster.
Un petit conseil : lors d'une invalidation massive du cache, il est parfois utile d'appliquer une stratégie de préchauffage d'un deuxième cache avant de basculer vers celui-ci. Il semblerait que cette approche entraîne une double consommation de mémoire, mais en pratique, dans les systèmes où cela a été expérimenté, la consommation de mémoire a diminué.
Stack réactif
Nous utilisons le stack réactif déjà dans un nombre assez important de systèmes. Dans notre cas, il s'agit de Webflux ou de Kotlin avec des coroutines. Le stack réactif s'avère particulièrement utile lorsque nous attendons des opérations d'input-output lentes. Par exemple, lors des appels de services lents, le travail avec le système de fichiers ou les systèmes de stockage.
Le principe le plus important est d'éviter les appels bloquants. Sous le capot des frameworks réactifs, il y a un nombre réduit de threads de service actifs. Si nous faisons un appel bloquant direct non prudent comme avec un pilote JDBC, le système s'arrête simplement.
Essayez de transformer les erreurs en vos propres exceptions d'exécution. Le fil d'exécution réel du programme se déplace vers des frameworks réactifs, ce qui rend l'exécution du code non linéaire. En conséquence, il est très difficile de diagnostiquer les problèmes en se basant sur les traces de pile. Une solution serait de créer des exceptions d'exécution claires et objectives pour chaque erreur.
Elasticsearch
Lors de l'utilisation d'Elasticsearch, ne sélectionnez pas de données non utilisées. C'est, en théorie, un conseil très simple, mais c'est souvent ce que l'on oublie. Si vous devez sélectionner plus de 10 000 enregistrements à la fois, vous devez utiliser Scroll. Pour faire une analogie, cela ressemble un peu à un curseur dans une base de données relationnelle.
N'utilisez pas postfilter sans nécessité. Lors de la gestion de grandes quantités de données dans la sélection principale, cette opération surcharge fortement la base de données.
Utilisez des opérations bulk là où c'est applicable.
API
Lors de la conception d'API, prenez en compte les exigences de minimisation des données transmises. Cela est particulièrement pertinent lors de l'interfaçage avec le front : c'est précisément à cette jonction que nous sortons des canaux de nos centres de données et travaillons sur le canal reliant le client à nous. Si des problèmes mineurs surviennent, un trafic trop élevé entraîne une expérience utilisateur négative.
Et enfin, ne déversez pas toutes vos données, abordez clairement le contrat entre les consommateurs et les fournisseurs.
Transformation organisationnelle
Elena Erochkina, directrice adjointe des TI
Au moment où le confinement a eu lieu et qu'il est devenu nécessaire d'accélérer le développement en ligne et d'implémenter des services omnicanaux, nous étions déjà en cours de transformation organisationnelle.
Une partie de notre structure a été transférée à un fonctionnement basé sur des principes et des pratiques axés sur le produit. Des équipes se sont formées pour être responsables du fonctionnement et du développement de chaque produit. Les employés de ces équipes sont pleinement impliqués à 100% et organisent leur travail selon Scrum ou Kanban, selon ce qui leur convient le mieux, configurent le pipeline de déploiement, mettent en œuvre des pratiques techniques, des pratiques d'assurance qualité et bien d'autres choses.
Par chance, la majorité de ces équipes produit étaient déjà dans le domaine des services en ligne et omnicanaux. Cela nous a permis de passer en mode de télétravail en un temps record (sérieusement, littéralement en deux jours) sans perte d'efficacité. Le processus mis en place nous a permis de nous adapter rapidement aux nouvelles conditions de travail et de maintenir un rythme élevé de livraison de nouvelles fonctionnalités.
De plus, nous avons ressenti le besoin de renforcer les équipes qui sont à l'avant-garde du commerce en ligne. À ce moment-là, il est devenu clair que nous pouvions le faire uniquement avec des ressources internes. Environ 50 personnes ont changé de domaine de travail en deux semaines et se sont intégrées au travail sur un nouveau produit pour elles.
Pour cela, aucun effort de gestion spécial n'était nécessaire, car en plus de l'organisation de notre propre processus, de l'amélioration technique du produit, de la mise en œuvre de pratiques d'assurance qualité, nous enseignons à nos équipes l'auto-organisation — gérer leur propre processus de production sans avoir recours à des ressources administratives.
Nous avons pu concentrer notre ressource de gestion exactement là où cela était nécessaire à ce moment-là, - sur la coordination avec les affaires : Qu'est-ce qui est important pour notre client en ce moment, quelle fonctionnalité doit être mise en œuvre en premier, que devons-nous faire pour augmenter notre capacité en matière de livraison et de traitement des commandes. Tout cela, ainsi qu'un modèle de rôle clair, nous a permis, durant cette période, de charger nos flux de production de création de valeur avec ce qui est vraiment important et nécessaire.
Il est évident que dans le cadre du travail à distance et d'un rythme de changement élevé, où la performance de chaque individu impacte les indicateurs économiques, il n'est pas possible de se fier uniquement à des ressentis internes du genre « Est-ce que tout va bien ? Ça semble aller ». Des métriques objectives du processus de production sont nécessaires. Nous en avons, elles sont accessibles à tous ceux qui s'intéressent aux métriques des équipes produit. Avant tout, à l'équipe elle-même, aux affaires, aux partenaires et à la direction.
Tous les quinze jours, nous faisons un point avec chaque équipe, où pendant 10 minutes, nous analysons les métriques, identifions les points de congestion du processus de production et élaborons une solution conjointe : que peut-on faire pour éliminer ces points de congestion. C'est également l'occasion de demander de l'aide à la direction si un problème identifié échappe au contrôle des équipes, ou d'obtenir des conseils d'experts qui ont peut-être déjà rencontré un problème similaire.
Néanmoins, nous comprenons que pour accélérer de manière exponentielle (et c'est précisément ce but que nous nous fixons), nous devons encore beaucoup apprendre et intégrer dans notre travail quotidien. En ce moment, nous continuons à étendre l'approche produit à d'autres équipes et à de nouveaux produits. Pour cela, nous avons dû nous familiariser avec un nouveau format pour nous, celui d'une école en ligne pour méthodologistes.
Les méthodologistes, ces personnes qui aident les équipes à structurer le processus, à établir des communications et à améliorer l'efficacité du travail, sont en réalité des agents de changement. En ce moment, les diplômés de notre première promotion travaillent avec des équipes et les aident à réussir.
Je pense que la situation actuelle nous ouvre des possibilités et des perspectives que nous ne réalisons peut-être pas encore pleinement. Mais l'expérience et la pratique que nous acquérons en ce moment confirment que nous avons choisi la bonne voie de développement, que nous ne manquerons pas ces nouvelles opportunités à l'avenir et que nous pourrons également répondre efficacement aux défis auxquels "Sportmaster" sera confronté.
Conclusions
Pendant cette période difficile, nous avons formulé les principaux principes sur lesquels repose le développement de logiciels, qui, je pense, seront pertinents pour chaque entreprise qui s’y consacre.
Les gens. C'est là-dessus que tout repose. Les employés doivent prendre plaisir à travailler, comprendre les objectifs de l'entreprise et des produits sur lesquels ils travaillent. Et, bien sûr, pouvoir se développer professionnellement.
Technologie. Il est essentiel que l'entreprise approche de manière mûre travail avec sa pile technologique et développe des compétences là où cela est vraiment nécessaire. Cela semble très simple et évident. Et cela est souvent ignoré.
Processus. Il est important de bien structurer le travail des équipes produit et des centres de compétences, d'établir des interactions avec les affaires afin de travailler avec elles en tant que partenaires.
En gros, c'est ainsi que nous avons survécu. Le principal postulat de notre époque a été confirmé une fois de plus, en frappant sur le front.
Même si vous êtes une grande entreprise physique avec de nombreux magasins et une multitude de villes présentes, développez votre présence en ligne. Ce n'est pas seulement un canal de vente supplémentaire ou une belle application par laquelle vous pouvez acheter quelque chose (et aussi parce que les concurrents en ont une belle aussi). Ce n'est pas une roue de secours pour les jours de tempête.
C'est une nécessité absolue. À laquelle non seulement vos capacités techniques et votre infrastructure doivent être prêtes, mais aussi vos personnes et vos processus. Après tout, il est possible d'acheter rapidement de la mémoire, de l'espace, de déployer de nouvelles instances et autres en quelques heures. Mais les personnes et les processus doivent être préparés à cela à l'avance.
Source : habr.com
