

Le 9 janvier, la version 1.0.0rc de Pandas a été publiée. La version précédente de la bibliothèque était la 0.25.
Ce premier lancement majeur contient de nombreuses nouveautés intéressantes, y compris une meilleure synthèse automatique des DataFrames, plus de formats de sortie, de nouveaux types de données et même un nouveau site de documentation.
Tous les changements peuvent être consultés , dans cet article nous nous limiterons à un petit aperçu moins technique des plus importants.
Vous pouvez installer la bibliothèque comme d'habitude avec pip, mais comme au moment de la rédaction de cet article, Pandas 1.0 est toujours release candidate, vous devez spécifier explicitement la version :
pip install --upgrade pandas==1.0.0rc0Attention : comme il s'agit d'une version majeure, la mise à jour peut casser du code ancien !
D'ailleurs, à partir de cette version, le support de Python 2 est complètement abandonné (ce qui peut être une bonne raison — note de l'éditeur.). Pandas 1.0 nécessite au minimum Python 3.6+, donc si vous n'êtes pas sûr, vérifiez quelle version vous avez :
$ pip --version
pip 19.3.1 from /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
Vérifier la version de Pandas est très simple :
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Amélioration de la synthèse automatique avec DataFrame.info
Ma nouveauté préférée est la mise à jour de la méthode DataFrame.info. La fonction est devenue beaucoup plus lisible, ce qui rend l'exploration des données encore plus facile :
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["goodbye", "cruel", "world"],
...:   'C': [False, True, False]
...:})
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      object
 2   C       3 non-null      object
dtypes: int64(1), object(2)
memory usage: 200.0+ bytes
Sortie de tableaux au format Markdown
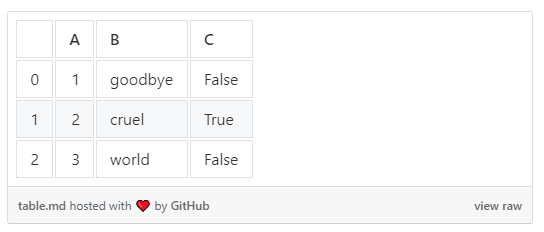
Une autre nouveauté agréable est la possibilité d'exporter des DataFrames en tableaux Markdown avec DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | goodbye | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | world   | False |
Cela simplifie grandement la publication de tableaux sur des sites comme Medium en utilisant des gist GitHub.
Nouveaux types pour les chaînes et les valeurs booléennes
La version Pandas 1.0 a également ajouté de nouveaux types expérimentaux. Leur API peut encore changer, donc utilisez-les avec précaution. Mais en général, Pandas recommande d'utiliser les nouveaux types partout où cela a du sens.
Pour l'instant, les conversions doivent être effectuées explicitement :
>>> B = pd.Series(["goodbye", "cruel", "world"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      string
 2   C       3 non-null      bool
dtypes: int64(1), object(1), string(1)
memory usage: 200.0+ bytes
Notez comment la colonne Dtype affiche de nouveaux types - string et bool.
La caractéristique la plus utile du nouveau type de chaîne est la possibilité de sélectionner uniquement des colonnes de chaînes à partir des DataFrames. Cela peut considérablement simplifier l'analyse des données textuelles :
df.select_dtypes("string")Auparavant, il n'était pas possible de sélectionner les colonnes de chaînes sans indiquer explicitement les noms.
Pour en savoir plus sur les nouveaux types, vous pouvez lire .
Merci d'avoir lu ! La liste complète des modifications, comme mentionné, peut être consultée .
Source : habr.com
