

La définition de DevOps est très complexe, c'est pourquoi il faut chaque fois relancer la discussion à ce sujet. Rien que sur Habr, il y a des milliers de publications à ce propos. Mais si vous lisez ceci, vous savez probablement ce qu'est DevOps. Parce que moi, je ne le sais pas. Bonjour, je m'appelle Alexandre Titov (@), et nous allons simplement parler de DevOps et je vais partager mon expérience.
J'ai longuement réfléchi à la manière de rendre mon récit utile, c'est pourquoi il y aura beaucoup de questions ici - celles que je me pose et celles que je pose aux clients de notre entreprise. En répondant à ces questions, la compréhension s'améliore. Je vais vous expliquer pourquoi DevOps est nécessaire selon mon point de vue, ce que c'est, encore une fois, de ma position, et comment comprendre si vous vous dirigez vers DevOps, encore une fois de ma perspective. Le dernier point viendra à travers des questions. En répondant à celles-ci, vous pourrez comprendre si votre entreprise évolue vers DevOps ou si elle rencontre des problèmes.
Un temps, j'ai navigué dans les eaux des fusions et acquisitions. D'abord, j'ai travaillé dans une petite startup llamada Qik, puis elle a été achetée par une entreprise un peu plus grosse, Skype, qui a ensuite été acquise par une entreprise encore plus grande, Microsoft. À ce moment-là, j'ai eu accès à une vision sur la façon dont la perception de DevOps se transforme dans des entreprises de différentes tailles. Par la suite, j'ai commencé à m'intéresser à DevOps du point de vue du marché et, avec mes collègues, nous avons créé l'entreprise Express 42. Cela fait déjà 6 ans que nous naviguons sur les vagues du marché.
En plus de cela, je suis l'un des organisateurs de la communauté DevOps Moscow et l'organisateur de DevOps Days 2017, mais je n'ai pas organisé l'édition de 2018. Express 42 travaille avec de nombreuses entreprises. Nous y développons DevOps, observons comment cela se passe, tirons des conclusions, analysons, partageons nos réflexions avec tout le monde, et formons les gens aux pratiques DevOps. En gros, nous cultivons toutes sortes d'expériences et d'expertises dans ce domaine.
Pourquoi DevOps
La première question qui taraude tout le monde tout le temps - pourquoi ? Beaucoup pensent que DevOps n'est qu'une simple automatisation ou quelque chose de semblable, qui a déjà été mis en place dans chaque entreprise.
— Nous avions déjà une intégration continue - cela signifie qu'il y avait déjà du DevOps, alors à quoi bon tout ça ? Là-bas, ils s'amusent, tandis que nous, on nous empêche de travailler !
Après 9 ans d'évolution de la communauté et de la méthodologie, il est déjà clair que ce ne sont pas des paillettes marketing, mais on ne sait toujours pas vraiment à quoi ça sert. Comme pour tout outil et processus, DevOps a des objectifs concrets qu'il résout finalement.
Tout cela est lié au fait que le monde change. Il s'éloigne de l'approche entreprise, où les sociétés avancent tout de suite vers leur rêve, comme le chantait notre classique de Saint-Pétersbourg, du point A au point B selon une stratégie définie, avec une structure spécifique construite pour cela.
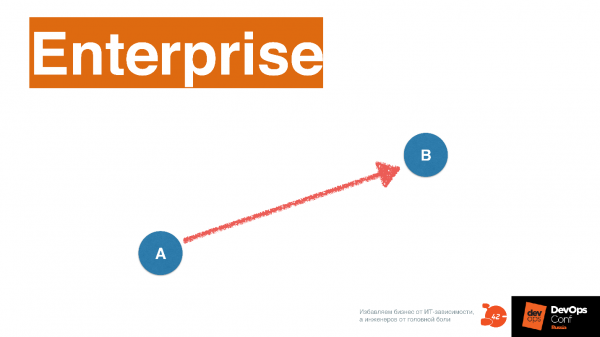
En principe, tout dans l'IT devrait être construit selon cette approche. Ici, l'IT est utilisée exclusivement pour l'automatisation des processus.
L'automatisation ne change pas souvent, car quand une entreprise suit une voie trébuchante - que changer ? Si ça fonctionne, ne touche pas. Actuellement, le monde évolue, et celui qui s'appelle Agile parle du fait que la destination finale B n'est pas immédiatement visible.
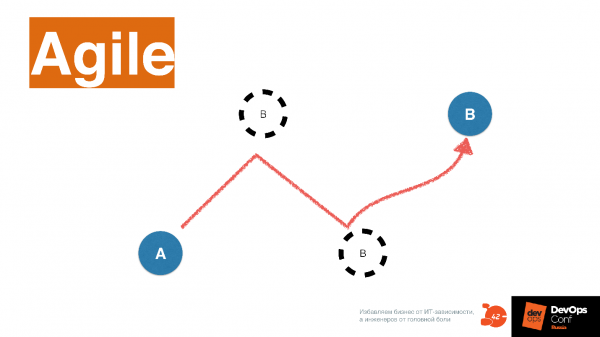
Lorsque l'entreprise opère sur le marché, travaille avec le client - elle explore constamment le marché et modifie le point final B. De plus, plus une entreprise change souvent sa direction, plus elle est finalement réussie, car elle choisit davantage de niches de marché.
Une stratégie est démontrée par une entreprise intéressante dont j'ai récemment entendu parler. One Box Shave - un service de livraison de rasoirs et d'articles de rasage par abonnement dans une boîte. Ils savent personnaliser leur « boîte » pour différents clients. Cela est géré par un logiciel spécifique qui envoie ensuite la commande à une usine coréenne produisant le produit.
Ce produit a été acheté par la société Unilever pour 1 milliard de dollars. Il est maintenant en concurrence avec Gillette et a pris une part significative des consommateurs sur le marché américain. One Box Shave déclare :
— 4 lames ? Vous êtes sérieux ? Pourquoi avez-vous besoin de cela - cela n'améliore en rien la qualité du rasage. Une crème spécialement sélectionnée, un parfum et un rasoir de qualité avec deux lames résolvent bien plus de problèmes que ces stupides 4 lames Gillette ! Bientôt, nous atteindrons 10 ?
Ainsi, le monde change. Unilever déclare disposer d'un super système IT qui permet cela. Au final, cela ressemble à un concept Time-to-market, dont beaucoup ont déjà parlé.
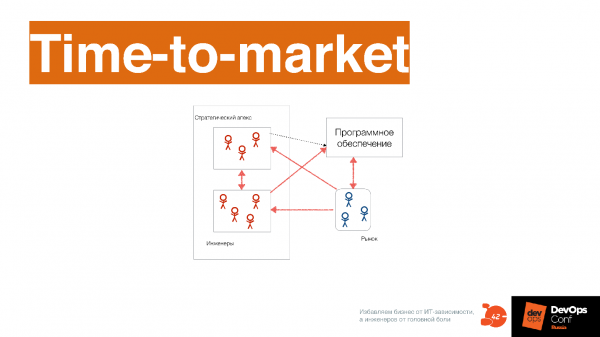
Le sens du Time-to-market ne réside pas dans la fréquence de nos déploiements. On peut déployer souvent, mais les cycles de release peuvent être longs. Si l'on superpose des cycles de release de trois mois en les décalant d'une semaine, on a l'impression que l'entreprise déploie une fois par semaine. Pourtant, il faut trois mois entre l'idée et la réalisation finale.
Le Time-to-market concerne la minimisation du temps entre l'idée et la réalisation finale.
Dans ce cas, le logiciel interagit avec le marché. Ainsi, le site de One Box Shave interagit avec le client. Ils n'ont pas de vendeurs - juste un site où les visiteurs cliquent et laissent leurs souhaits. Par conséquent, le site doit constamment proposer quelque chose de nouveau, l'actualiser en fonction des souhaits. Par exemple, en Corée du Sud, on se rase différemment qu'en Russie, et ils préfèrent des senteurs telles que la vanille plutôt que l'odeur du pin.
Étant donné qu'il faut changer rapidement le contenu du site, le développement logiciel évolue considérablement. À travers le logiciel, nous devons comprendre ce que veut le client. Autrefois, nous le découvrions par des moyens détournés, par exemple, via la gestion des affaires. Ensuite, nous concevions le projet en intégrant les exigences dans le système informatique, et tout était parfait. Maintenant, c'est différent - le logiciel est conçu par tous ceux qui sont impliqués dans le processus, y compris les ingénieurs, car ils apprennent à travers les caractéristiques techniques comment fonctionne le marché et partagent également leurs insights avec le business.
Par exemple, dans l'entreprise Qik, nous avons soudainement découvert que les gens adoraient télécharger des listes de contacts sur le serveur, et ils ont développé une application pour cela. À l'origine, nous n'y avions pas pensé. Dans une entreprise classique, tout le monde aurait considéré cela comme un bug, car ce n’était pas spécifié que cela devait fonctionner correctement et c'était en fait développé à la va vite, on aurait désactivé cette fonction en disant : « Ce n’est pas nécessaire, l’essentiel est que la fonctionnalité de base fonctionne. » Alors qu'une entreprise technologique voit une opportunité et commence à modifier le logiciel en conséquence.
En 1968, le visionnaire Melvin Conway a formulé l'idée suivante.
Une organisation qui crée un système est limitée par le design qui reproduit la structure de communication au sein de cette organisation.
Pour en savoir plus, pour créer des systèmes d'un autre type, il est en plus nécessaire d'avoir une structure de communication au sein de l'entreprise d'un autre type. Si vous avez une structure de communication hiérarchique, cela ne vous permettra pas de créer des systèmes qui peuvent garantir un très bon délai de mise sur le marché.
Lire est possible . Elle est importante pour comprendre la culture ou la philosophie DevOps, car la seule chose qui change fondamentalement dans DevOps, c'est précisément la structure de communication entre les équipes..
D'un point de vue processuel, avant DevOps, toutes les étapes : analyse, développement, tests, exploitation, se déroulaient de manière linéaire.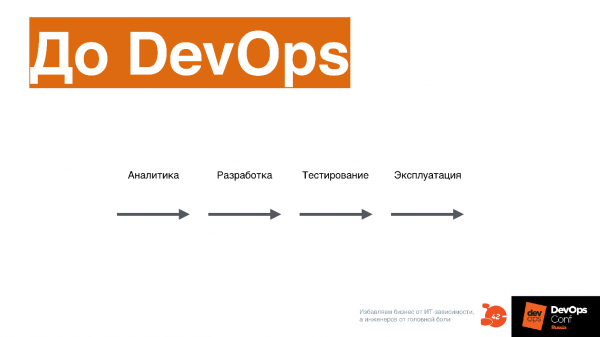
Avec DevOps, tous ces processus se déroulent simultanément.
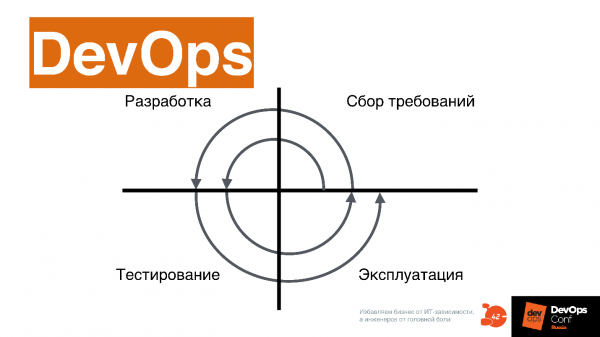
Le délai de mise sur le marché ne peut être respecté que de cette manière. Pour les personnes qui ont travaillé dans l'ancien process, cela semble quelque peu futuriste, et même pas terrible.
Alors, pourquoi DevOps est-il nécessaire?
Pour le développement de produits numériques. Si vous n'avez pas de produit numérique dans votre entreprise, DevOps n'est pas nécessaire — c'est très important.
DevOps surmonte les limitations de vitesse du schéma de production séquentiel du logiciel. Dans celui-ci, tous les processus se déroulent simultanément.
La complexité augmente. Lorsque les évangélistes DevOps affirment qu'avec lui vous trouverez plus facile de publier du logiciel, c'est des absurdités.
Avec DevOps, ce sera juste plus complexe.
Lors de la conférence, sur le stand d'Avito, il était possible de voir ce que signifie déployer un conteneur Docker — une tâche irréelle. La complexité devient abyssale, il faut jongler avec plusieurs éléments en même temps.
DevOps change complètement le processus et l'organisation dans l'entreprise — en fait, ce n'est pas DevOps qui change, mais le produit numérique. Pour arriver à DevOps, il faut néanmoins changer complètement ce processus.
Questions pour le spécialiste
Et chez vous ? Questions que vous pouvez vous poser en travaillant dans l'entreprise et en vous développant en tant que spécialiste.
Avez-vous une stratégie pour créer un produit numérique ? S'il y en a une, c'est déjà bien. Cela signifie que votre entreprise progresse vers DevOps.
Votre entreprise crée-t-elle déjà un produit numérique ? Cela signifie que vous pouvez monter d'un cran, vous occuper de choses plus intéressantes — du point de vue de DevOps, encore une fois. C'est uniquement sous cet angle que je parle.
Votre entreprise est-elle l'un des leaders du marché dans le secteur des produits numériques ? Spotify, Yandex, Uber - des entreprises qui sont à la pointe du progrès technologique aujourd'hui.
Posez-vous ces questions, et si toutes les réponses sont négatives, peut-être qu'il ne vaut mieux pas s'engager dans le DevOps au sein de cette entreprise. En revanche, si le DevOps vous intéresse réellement, peut-être devriez-vous envisager de changer d'entreprise ? Si votre compagnie souhaite se tourner vers le DevOps, mais que vous avez répondu « Non » à toutes les questions, alors elle ressemble à ce magnifique rhinocéros qui ne changera jamais.
Organisation
Comme je l'ai déjà mentionné, selon la loi de Conway, l'organisation au sein de l'entreprise évolue. Commençons par ce qui entrave l'infiltration du DevOps au sein de l'entreprise, notamment du point de vue de l'organisation.
Le problème des « silos »
Le mot anglais « Silo » est traduit ici par « silo » en français. La signification de ce problème réside dans le fait que il n'y a pas d'échange d'informations entre les équipes. Chaque équipe approfondit son expertise sans établir de carte commune sur laquelle se repérer.
C'est quelque chose qui rappelle une personne qui vient d'arriver à Moscou et qui ne sait pas encore s'orienter avec la carte du métro. Les Moscovites connaissent généralement très bien leur quartier, et se déplacent dans toute la ville grâce à la carte du métro. Lorsque vous arrivez à Moscou pour la première fois, vous n'avez pas cette compétence, et vous êtes juste désorienté.
Le DevOps propose de surmonter ce moment de désorientation et de construire ensemble une carte d'interaction pour tous les départements.
Deux facteurs entravent cela.
Un effet du système de gestion d'entreprise. Il est construit sur des « silos » hiérarchiques séparés. Par exemple, il existe des KPI dans les entreprises qui soutiennent ce système. D'autre part, les mentalités des individus empêchent souvent de sortir de leurs zones d'expertise et de s'orienter dans l'ensemble du système. C'est simplement inconfortable. Imaginez-vous en train d'arriver à l'aéroport de Bangkok - il n'est pas facile de s'y retrouver rapidement. Il est également difficile de s'orienter dans le DevOps, et c'est pourquoi les gens disent qu'il faut trouver un guide pour y arriver.
Mais surtout, le problème des « silos » pour un ingénieur qui a été imprégné de l'esprit DevOps, qui a lu Fowler et beaucoup d'autres livres, se traduit par le fait que les « silos » ne permettent pas de faire des choses « évidentes ». Nous nous réunissons souvent après le DevOps Moscow, parlons entre nous, et les gens se plaignent :
— Nous voulions simplement lancer CI, mais il s'avère que la direction n'en a pas besoin.
Cela se produit justement à cause de CI et Processus de livraison continue se trouvent à la frontière de nombreuses expertises. Il est tout simplement impossible d'avancer sans surmonter le problème des « puits » au niveau organisationnel, peu importe ce que vous faites et à quel point cela peut paraître triste.
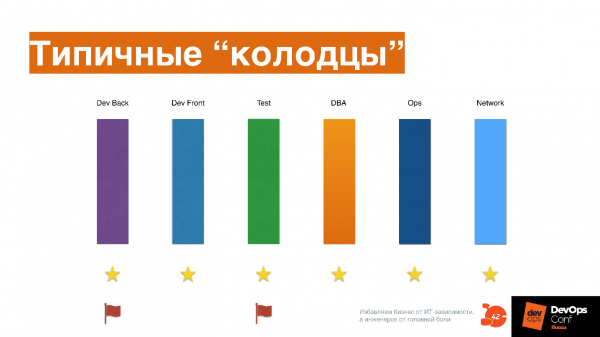
Chaque participant au processus dans l'entreprise : développeurs backend et frontend, testeurs, DBA, opérations, réseau, creuse dans son propre sens, et personne n’a de carte commune, excepté le gestionnaire qui les observe d'une certaine manière et gère selon la méthode « diviser pour régner ».
Les gens se battent pour des étoiles ou des drapeaux, chacun creuse dans sa propre expertise.
Au final, lorsque la tâche se présente de tout rassembler et de construire un pipeline commun, et qu'il n'est plus nécessaire de se battre pour des étoiles et des drapeaux, la question se pose — que faire alors ? Il faut trouver un moyen de se mettre d'accord, mais personne ne nous a appris à le faire à l'école. Nous avons été éduqués à l'école : la huitième classe — wow ! — par rapport à la septième classe ! C'est exactement la même chose ici.
Est-ce aussi le cas dans votre entreprise ?
Pour vérifier cela, on peut se poser les questions suivantes.
Les équipes utilisent-elles des outils communs, contribuent-elles aux modifications de ces outils communs ?
À quelle fréquence les équipes se reconfigurent-elles — certains spécialistes d'une équipe passent-ils à une autre équipe ? Dans l'environnement DevOps, cela devient normal, car parfois une personne ne peut tout simplement pas comprendre ce que fait une autre zone d'expertise. Elle passe à un autre département, y travaille deux semaines pour établir une carte d'orientation et d'interaction avec ce département.
Peut-on créer un comité de changement et modifier quelque chose ? Ou est-ce qu’il faut une main forte de la haute direction et un ordre ? Récemment, j'ai écrit sur Facebook comment une banque peu connue implémente des outils par des ordres : ils ont écrit un ordre, l'ont mis en œuvre pendant un an et regardent ce qui se passe. C'est, bien sûr, long et triste.
À quel point est-il important pour les managers d'obtenir des réalisations personnelles indépendamment des réalisations de l'entreprise ?
Si vous répondez à ces questions, il sera plus clair si vous avez un tel problème dans votre entreprise.
Infrastructure en tant que code
Une fois ce problème résolu, la première pratique essentielle pour progresser dans DevOps est de l'infrastructure en tant que code.
L'infrastructure en tant que code est souvent perçue comme suit :
— Automatisons tout avec bash, empilons les scripts pour réduire le travail manuel des administrateurs !
Mais ce n'est pas le cas.
L'infrastructure en tant que code signifie que vous décrivez le système informatique avec lequel vous travaillez sous forme de code, afin de toujours comprendre son état.
En collaboration avec d'autres équipes, vous créez une carte sous forme de code, compréhensible par tous, sur laquelle vous pouvez vous orienter et naviguer. Peu importe la technologie utilisée — Chef, Ansible, Salt, ou l'utilisation de fichiers YAML dans Kubernetes — la méthode n'a pas d'importance.
Lors d'une conférence, un collègue de 2GIS a parlé de leur outil interne pour Kubernetes, qui décrit le fonctionnement de systèmes distincts. Pour décrire 500 systèmes, ils ont eu besoin d'un outil distinct qui génère cette description. Lorsqu'il existe cette description, tout le monde peut se référer les uns aux autres, surveiller les modifications, voir comment il peut être modifié et amélioré, et ce qui manque.
Vous conviendrez que les scripts bash individuels ne fournissent généralement pas cette compréhension. Dans l'une des entreprises où j'ai travaillé, il y avait même un terme « script write only » — lorsque le script est écrit, mais qu'il est impossible de le relire. Je pense que cela vous est familier également.
L'infrastructure en tant que code est du code qui décrit l'état actuel de l'infrastructure. Ce code est coécrit par de nombreuses équipes produit, infrastructure et service, et, surtout, tous doivent comprendre comment ce code fonctionne.
Le code est maintenu selon les meilleures pratiques de développement: développement collaboratif, revues de code, XP-programming, tests, pull requests, CI pour l'infrastructure en tant que code — tout cela est pertinent et peut être utilisé.
Le code devient un langage commun pour tous les ingénieurs.
Modifier l'infrastructure dans le code ne prend pas beaucoup de temps. Oui, le code d'infrastructure peut également accumuler une dette technique. En général, les équipes y font face environ un an et demi après avoir commencé à mettre en œuvre « l'infrastructure en tant que code » sous forme d'une multitude de scripts ou même d'Ansible qu'ils écrivent comme du code spaghetti, tout en y ajoutant encore des scripts bash dans le tas !
Important: Si vous n'avez pas encore essayé cette chose, souvenez-vous que Ansible n'est pas bash! Lisez attentivement la documentation, étudiez ce qui s'écrit à ce sujet.
L'infrastructure en tant que code est la séparation du code d'infrastructure en couches distinctes.
Nous dans notre entreprise identifions 3 couches de base, qui sont très claires et simples, mais il peut y en avoir plus. Vous pouvez examiner votre code d'infrastructure et dire si vous avez ce critère ou non. Si aucune couche n'est identifiée, il faut prendre le temps de faire un peu de refactorisation.
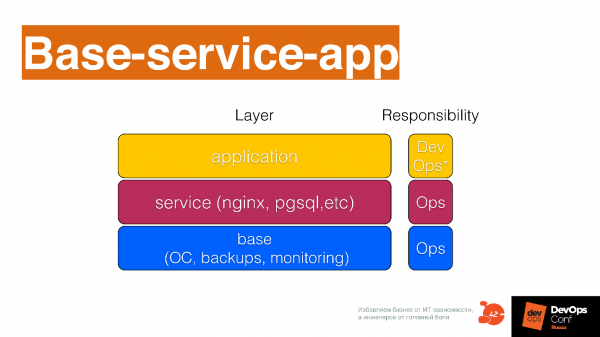
Couche de base — c'est comment le système d'exploitation, les sauvegardes et d'autres choses de bas niveau sont configurés, par exemple, comment Kubernetes est déployé à un niveau fondamental.
Niveau des services — ce sont les services que vous offrez aux développeurs : journalisation en tant que service, surveillance en tant que service, base de données en tant que service, équilibreur de charge en tant que service, file d'attente en tant que service, livraison continue en tant que service — une multitude de services que différentes équipes peuvent fournir au développement. Tous ceux-ci doivent être décrits en modules distincts dans votre système de gestion de configuration.
Couche où les applications sont développées et décrite, comment elles seront déployées sur les deux couches précédentes.
Questions de contrôle
Avez-vous dans votre entreprise un référentiel d'infrastructure commun ? Contrôlez-vous la dette technique dans l'infrastructure ? Utilisez-vous des pratiques de développement dans le référentiel d'infrastructure ? Votre infrastructure est-elle découpée en couches ? Vous pouvez vérifier avec le schéma Base-service-APP. À quel point est-il difficile d'apporter une modification ?
Si vous avez rencontré des situations où apporter des modifications prenait un jour et demi, cela signifie que vous avez accumulé une dette technique avec laquelle il faut travailler. Vous êtes juste tombé sur les pièges de la dette technique dans le code d'infrastructure. Je me souviens de nombreuses histoires, où pour changer un CCTL, il fallait réécrire la moitié du code d'infrastructure, parce que la créativité et le désir d'automatiser tout ont conduit à une situation où tout est compliqué, toutes les manipulations sont supprimées, et il est nécessaire de faire une refactorisation.
Livraison continue
Faisons le point sur le débit et le crédit. D'abord, une description de l'infrastructure apparaît, qui peut être assez basique. Il n'est pas nécessaire de tout décrire en détail, mais une description de base est requise pour que vous puissiez travailler avec cela. Sinon, il est difficile de comprendre sur quoi construire la livraison continue par la suite. Toutes ces pratiques se déroulent simultanément lorsque vous arrivez à DevOps, mais il faut d'abord commencer par comprendre ce que vous avez et comment le gérer. C'est précisément la pratique de l'infrastructure en tant que code.
Après avoir compris ce que vous avez et comment le gérer, vous commencez à réfléchir à la manière d'envoyer le code du développeur en production le plus rapidement possible. Je parle de le faire en collaboration avec le développeur - n'oublions pas le problème des « puits », c'est-à-dire que ce ne sont pas des personnes distinctes qui le pensent, mais une équipe.
Quand nous avons René Evtoukhovitch vu le premier livre Jez Hammble et le groupe d'auteurs « Continuous Delivery », qui est sorti en 2009, nous avons longtemps réfléchi à la manière de traduire son titre en français. Nous voulions le traduire par « Livraison continue », mais malheureusement, nous l'avons traduit par « Livraison ininterrompue ». Je pense qu'il y a quelque chose de russe dans notre titre, avec du caractère.
Livrer constamment signifie
Le code qui se trouve dans le dépôt produit peut toujours être déployé en production. Il peut ne pas être déployé, mais il est toujours prêt pour cela. Par conséquent, vous écrivez toujours le code avec un sentiment difficile à expliquer d'une certaine inquiétude au creux du ventre. Ce sentiment d'inquiétude doit être présent - il déclenche des processus mentaux qui permettent d'écrire le code d'une manière légèrement différente. Cela doit être enregistré dans les règles au sein du développement.
Pour livrer constamment, il faut un format d'artéfact qui traverse la plateforme d'infrastructure. Si vous jetez différents formats de « déchets de fonctionnement » sur la plateforme d'infrastructure, elle devient non unifiée, difficile à entretenir, et cela crée un problème de dette technique. Le format d'artéfact doit être aligné - c'est aussi une tâche collective : tout le monde doit se rassembler, réfléchir ensemble et inventer ce format.
L'objet est constamment amélioré et évolue en fonction de l'environnement de production tout au long de son parcours dans le pipeline de livraison. Lorsque l'objet progresse dans le pipeline, il se heurte tout le temps à des éléments qui lui posent problème, semblables à ceux que rencontre l'objet que vous déployez en production. Si, dans le développement classique, cela est géré par un administrateur système qui effectue le déploiement, dans le processus DevOps, cela se produit en permanence : ici, il a été soumis à des tests, là, il a été placé dans un cluster Kubernetes qui ressemble plus ou moins à la production, et là, des tests de charge ont été soudainement lancés.
Cela ressemble un peu à un jeu de Pac-Man : l'objet traverse une sorte d'histoire. Il est important de contrôler si le code suit réellement cette histoire et si elle est liée à votre production. Les histoires liées à la production peuvent être intégrées dans le processus de Continuous Delivery : cela se passait ainsi, lorsque quelque chose échouait, maintenant programmons simplement ce scénario dans le système. À chaque fois, le code passera également par ce scénario, et vous ne rencontrerez plus ce problème la prochaine fois. Vous serez au courant bien avant qu'il n'apparaisse pour votre client.
Différentes stratégies de déploiement. Par exemple, vous utilisez des tests A/B ou des déploiements canari pour tester le code sur différents clients, recueillant des informations sur le fonctionnement du code, bien avant qu'il ne soit lancé pour 100 millions d'utilisateurs.
Le terme « livraison continue » se présente comme suit.
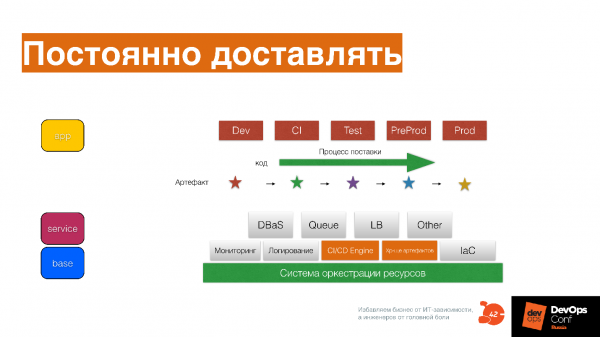
Le processus de livraison Dev, CI, Test, PreProd, Prod n'est pas un environnement distinct, ce sont des étapes ou des stations avec des montants non brûlables que votre objet traverse.
Si vous avez un code d'infrastructure décrit comme Base Service APP, alors il aide à ne pas oublier tous les scénarios, et à les enregistrer également sous forme de code pour cet objet, à faire progresser l'objet et à le modifier en cours de route.
Questions d'auto-évaluation
Le temps entre la description d'une fonctionnalité et le déploiement en production est-il inférieur à une semaine dans 95 % des cas ? La qualité de l'objet s'améliore-t-elle à chaque étape du pipeline ? Y a-t-il une histoire à travers laquelle il passe ? Utilisez-vous différentes stratégies de déploiement ?
Si toutes les réponses sont oui, alors vous êtes incroyablement géniaux ! Écrivez vos réponses dans les commentaires - je serais ravi).
Retour d'information
C'est la pratique la plus complexe de toutes. Lors de la conférence DevOpsConf, un collègue d'Infobip, en parlant de cela, avait un peu de mal à trouver ses mots, car c'est vraiment une pratique très complexe qui consiste à surveiller absolument tout !
Par exemple, il y a longtemps, quand je travaillais chez Qik et que nous avons réalisé qu'il fallait surveiller absolument tout. Nous l'avons fait, et nous avons eu 150 000 éléments dans Zabbix qui étaient surveillés en continu. C'était effrayant, le directeur technique se moquait :
— Les gars, pourquoi abusez-vous du serveur sans raison ?
Mais ensuite, il y a eu un cas qui a montré que c'est en effet une stratégie vraiment géniale.
L'un des services a commencé à tomber constamment. Au départ, il ne tombait pas, ce qui est intéressant, aucun code n'y était ajouté, car c'était un courtier de base, qui n'avait pratiquement pas de fonctionnalité métier — il ne faisait que transmettre des messages entre différents services. Le service n'avait pas changé pendant 4 mois, et soudain il a commencé à tomber avec une erreur « Segmentation fault ».
Nous étions sous le choc, nous avons ouvert nos graphiques dans Zabbix, et il s'est avéré qu'il y a une semaine et demie, le comportement des requêtes dans le service API avait fortement changé. Ensuite, nous avons regardé et vu que la fréquence d'envoi d'un certain type de messages avait changé. Nous avons découvert que c'était les clients Android. Nous avons demandé :
— Les gars, qu'est-ce qui s'est passé il y a une semaine et demie ?
En réponse, nous avons entendu une histoire intéressante sur le fait qu'ils avaient refait l'interface utilisateur. Peu de gens diraient immédiatement qu'ils ont changé la bibliothèque HTTP. Pour les clients Android, c'est comme changer de savon dans la salle de bain — ils ne s'en souviennent tout simplement pas. Au final, après 40 minutes de conversation, nous avons découvert qu'ils avaient effectivement changé la bibliothèque HTTP, et que les temps par défaut avaient changé. Cela a entraîné un changement de comportement du trafic sur le serveur API, ce qui a causé une course à l'intérieur du courtier, et il a commencé à tomber.
Sans une surveillance approfondie, il serait impossible de détecter cela.. Cependant, s'il y a encore un problème de « puits » dans l'organisation, où chacun renvoie la faute à l'autre, cela peut durer des années. Vous redémarrez simplement le serveur, car il est impossible de résoudre le problème. Lorsque vous surveillez, suivez et tracez tous les événements que vous avez et utilisez la surveillance comme un test — vous écrivez du code et indiquez immédiatement comment le surveiller, également sous forme de code (nous avons déjà une infrastructure comme code), tout devient clair comme de l'eau de roche. Même les problèmes complexes sont facilement traçables.
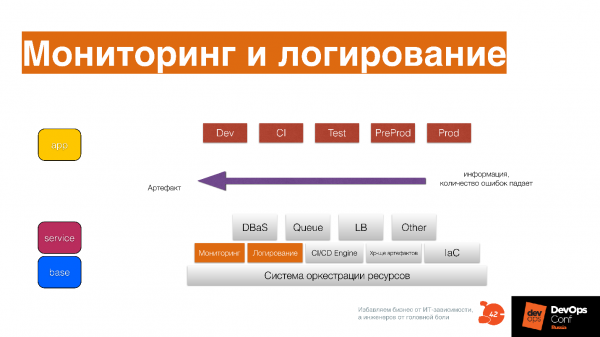
Collectez toutes les informations sur ce qui se passe avec l'artefact à chaque étape du processus de livraison — pas en production.
Chargez la surveillance sur le CI, et là-bas, certaines choses de base seront visibles. Ensuite, vous les verrez à la fois en Test, en PredProd, et lors des tests de charge. Collectez des informations à toutes les étapes, non seulement des métriques et des statistiques, mais aussi des journaux : comment l'application a été déployée, les anomalies — collectez tout.
Dans le cas contraire, il sera difficile de s'y retrouver. J'ai déjà dit que le DevOps représente une plus grande complexité. Pour faire face à cette complexité, il est nécessaire d'avoir une bonne analytique..
Questions pour l'auto-évaluation
Votre surveillance et votre journalisation sont-elles des outils de développement pour vous ? Vos développeurs, y compris vous-même, lorsqu'ils écrivent du code, pensent-ils à la façon de le surveiller ?
Apprenez-vous les problèmes de la part des clients ? Comprenez-vous mieux le client grâce à la surveillance et à la journalisation ? Comprenez-vous mieux le système grâce à la surveillance et à la journalisation ? Changez-vous le système simplement parce que vous avez vu que la tendance dans le système augmente et que vous comprenez qu'encore trois semaines et tout sera à l’arrêt ?
Lorsque vous avez ces trois composants, vous pouvez réfléchir à l'infrastructure de votre entreprise.
Plateforme d'infrastructure
Le sens n'est pas que ce soit un ensemble d'outils disparates qui existent dans chaque entreprise.
Le sens de la plateforme d'infrastructure est que toutes les équipes utilisent ces outils et les développent ensemble.
Il est clair qu'il y a des équipes distinctes qui sont responsables du développement de morceaux spécifiques de la plateforme d'infrastructure. Mais en même temps, la responsabilité du développement, de la fonctionnalité et de la promotion de la plateforme d'infrastructure incombe à chaque ingénieur. Au niveau interne, cela devient un outil commun..
Toutes les équipes développent la plateforme d'infrastructure, en prenant soin d'elle comme de leur propre IDE.. Dans votre IDE, vous installez différents plugins pour que tout soit beau et rapide, vous configurez des raccourcis. Lorsque vous ouvrez Sublime, Atom ou Visual Studio Code, vous êtes envahis par des erreurs de code et vous réalisez qu'il est impossible de travailler, cela vous rend immédiatement triste et vous vous dépêchez de réparer votre IDE.
Traitez votre plateforme d'infrastructure de la même manière. Si vous sentez qu'il y a un problème, laissez une demande si vous ne pouvez pas le réparer vous-même. Si c'est quelque chose de simple, corrigez-le vous-même, envoyez une demande de tirage - les gars l'examinent, ajoutent. C'est une approche un peu différente de l'outillage ingénierie dans l'esprit du développeur.
La plateforme d'infrastructure permet le transfert d'artefacts du développement au client avec une amélioration continue de la qualité.. Dans la plateforme d'infrastructure, un ensemble d'histoires est programmé, qui se produisent avec le code en production. Au fil des années de développement, le nombre d'histoires devient très important, certaines d'entre elles sont uniques et ne vous concernent que vous - elles sont impossibles à trouver sur Google.
À ce moment-là, la plateforme d'infrastructure devient votre avantage concurrentiel., parce qu'elle intègre des éléments qui ne se trouvent pas dans l'outil des concurrents. Plus votre plateforme d'infrastructure est profonde, plus votre avantage concurrentiel en termes de temps de mise sur le marché est important. Ici, se pose le problème du verrouillage fournisseur.: Vous pouvez adopter une plateforme tierce, mais en utilisant l'expérience d'autrui, vous ne serez pas en mesure de juger de sa pertinence pour vous. Oui, toute entreprise ne peut pas construire une plateforme comme Amazon. C'est une démarche complexe où l'expérience de l'entreprise est pertinente en fonction de sa position sur le marché, et il ne faut pas permettre un verrouillage fournisseur. Il est également important d'y réfléchir.
Configuration
C'est le schéma de base de la plateforme d'infrastructure qui vous aidera à établir toutes les pratiques et processus dans une entreprise DevOps.
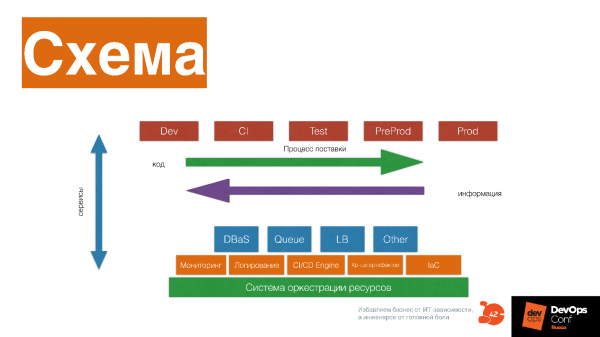
Examinons de quoi elle se compose.
Système d'orchestration des ressources, qui fournit CPU, mémoire, disque aux applications et à d'autres services. Au-dessus de cela - services de niveau inférieur: surveillance, journalisation, moteur CI/CD, stockage d'artefacts, infrastructure en tant que code.
Services de niveau supérieur.: base de données comme service, files d'attente comme service, Load Balance comme service, redimensionnement d'images comme service, Big Data fabrique comme service. En plus de cela — pipeline qui fournit un code constamment modifié à votre client.
Vous obtenez des informations sur le fonctionnement de votre logiciel chez le client, vous modifiez, vous renvoyez ce code, vous obtenez des informations — et vous développez constamment à la fois votre infrastructure et votre logiciel.
Sur le schéma, le delivery pipeline se compose de plusieurs étapes. Mais c'est un schéma principal, présenté à titre d'exemple — il ne faut pas le reproduire à l'identique. Les étapes interagissent avec des services, comme des services — chaque brique de la plateforme a sa propre histoire : comment les ressources sont allouées, comment l'application est lancée, fonctionne avec les ressources, est surveillée, et modifiée.
Il est important de comprendre que chaque partie de la plateforme a une histoire, et de se poser la question — quelle histoire porte cette brique, peut-être vaut-il mieux la jeter et la remplacer par un service tiers. Par exemple, peut-on remplacer une brique par Okmeter ? Peut-être que les gars ont déjà développé cette expertise bien plus que nous. Mais peut-être que non — peut-être que nous avons une expertise unique, nous devons mettre en place Prometheus et développer cela davantage.
Création de plateforme
C'est un processus de communication complexe. Lorsque vous avez des pratiques de base, vous lancez la communication entre différents ingénieurs et spécialistes, qui développent des exigences et des normes, et les modifient continuellement à propos des différents outils et approches. Ici, la culture qui existe dans le DevOps est importante.
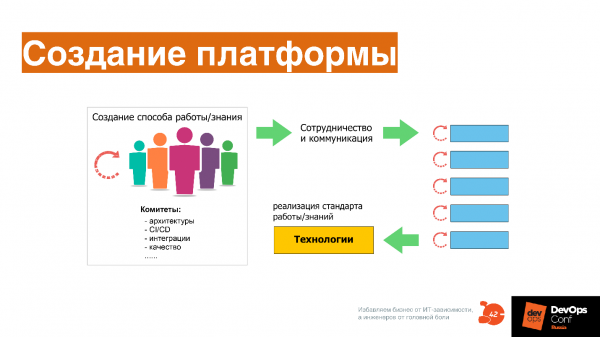
Avec la culture, tout est très simple — c'est la collaboration et la communication, c'est-à-dire le désir de travailler ensemble dans un même espace, le désir de maîtriser un seul outil ensemble. Il n'y a rien de rocket science ici — tout est très simple, banale. Par exemple, nous vivons tous dans le même immeuble et maintenons sa propreté — c'est ce niveau de culture.
Et chez vous ?
Encore une fois des questions que vous pouvez vous poser.
La plateforme d'infrastructure est-elle définie ? Qui est responsable de son développement ? Comprenez-vous les avantages concurrentiels de votre plateforme d'infrastructure ?
Ces questions doivent toujours être posées. Si quelque chose peut être externalisé à des services tiers, il faut le faire. Si un service tiers commence à bloquer vos activités, il faut alors construire un système en interne.
Et donc, DevOps…
… c'est un système complexe, il doit contenir :
- Un produit numérique.
- Des modules d'affaires qui développent ce produit numérique.
- Des équipes produits qui écrivent le code.
- Des pratiques de livraison continue.
- Des plateformes en tant que service.
- Une infrastructure en tant que service.
- Une infrastructure en tant que code.
- Des pratiques spécifiques de maintenance de la fiabilité, intégrées au sein de DevOps.
- Une pratique de feedback qui décrit tout cela.
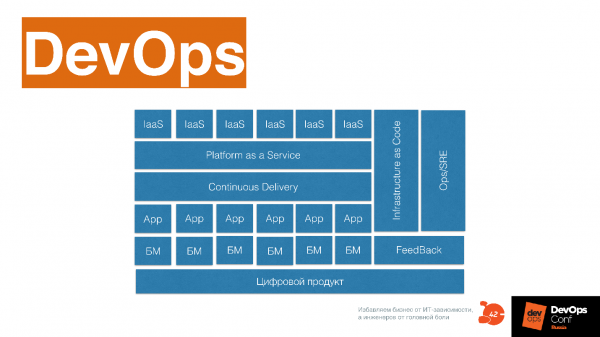
Vous pouvez utiliser ce schéma, en mettant en valeur ce que vous avez déjà dans votre entreprise sous une forme quelconque : cela a évolué ou doit encore évoluer.
Dans seulement quelques semaines, . dans le cadre de RIT++. Venez à la conférence où vous attendent de nombreuses présentations passionnantes sur la livraison continue, l'infrastructure en tant que code et la transformation DevOps. , la dernière date limite pour les tarifs est le 20 mai
Source : habr.com
