

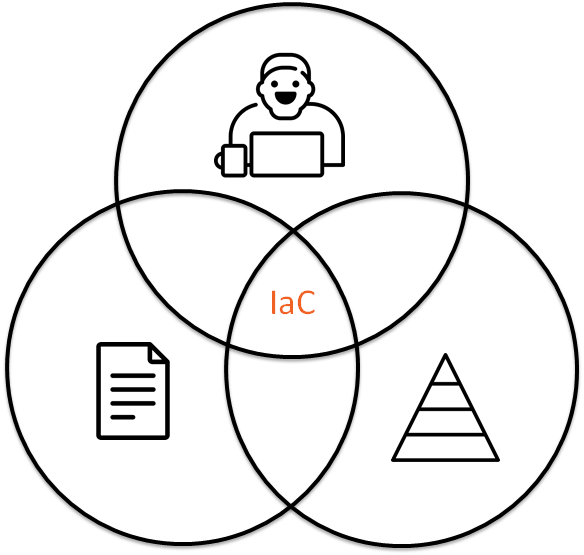
Approche IaC (Infrastructure as Code) ne se compose pas seulement du code qui est stocké dans un référentiel, mais aussi des personnes et des processus qui entourent ce code. Peut-on réutiliser les approches du développement logiciel dans la gestion et la description de l'infrastructure ? Il peut être utile de garder cette idée en tête pendant votre lecture.
C'est la transcription de ma sur .
Diapositives et vidéos
- Exécution à blanc 2019-04-24
Infrastructure comme historique bash
Supposons que vous arriviez sur un nouveau projet, et qu'on vous dise : « chez nous Infrastructure as Code». En réalité, il s'avère que Infrastructure comme historique bash ou par exemple Documentation comme historique bash. C'est une situation tout à fait réelle, par exemple, Denis Lysenko a décrit un cas similaire dans sa présentation , il a expliqué comment, à partir de l'historique bash, ils ont obtenu une infrastructure cohérente pour le projet.
Avec une certaine volonté, on peut dire que Infrastructure comme historique bash c'est comme du code :
- la reproductibilité: vous pouvez prendre l'historique bash, exécuter les commandes à partir de là, et il est possible, d'ailleurs, que vous obteniez une configuration fonctionnelle en sortie.
- versionnage: vous savez qui est intervenu et ce qu'il a fait, encore une fois, ce n'est pas sûr que cela vous amène à une configuration fonctionnelle en sortie.
- histoire: une histoire de qui a fait quoi. Mais vous ne pourrez pas l'utiliser si vous perdez le serveur.
Que faire ?
Infrastructure as Code
Même un cas aussi étrange que Infrastructure comme historique bash peut être tiré par les cheveux vers Infrastructure as Code, mais quand nous souhaiterons faire quelque chose de plus complexe qu'un vieux bon serveur LAMP, nous en viendrons à l'idée que ce code doit être modifié, changé, amélioré. Ensuite, nous examinerons les parallèles entre Infrastructure as Code et le développement logiciel.
D.R.Y.
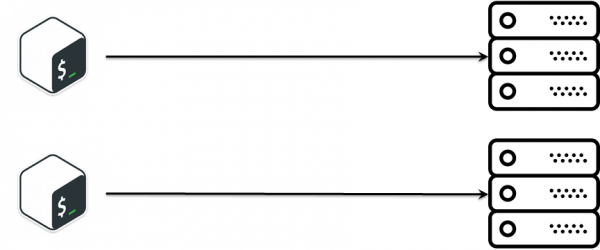
Dans un projet de développement de systèmes de stockage, une sous-tâche était : nous sortons une nouvelle version — elle doit être déployée pour les tests ultérieurs. La tâche est extrêmement simple :
- connectez-vous ici par ssh et exécutez la commande.
- copiez le fichier là-bas.
- modifiez la configuration ici.
- lancez le service là-bas
- …
- PROFIT!
Pour la logique décrite, bash est largement suffisant, surtout aux premières étapes du projet, lorsqu'il commence à peine. Ce n'est , mais avec le temps, des demandes apparaissent pour déployer quelque chose de similaire, mais légèrement différent. La première chose qui me vient à l'esprit : le copier-coller. Et voilà, nous avons déjà deux scripts très similaires qui font presque la même chose. Au fil du temps, le nombre de scripts a augmenté, et nous avons été confrontés à une certaine logique métier de déploiement d'installation qui doit être synchronisée entre différents scripts, ce qui est assez complexe.
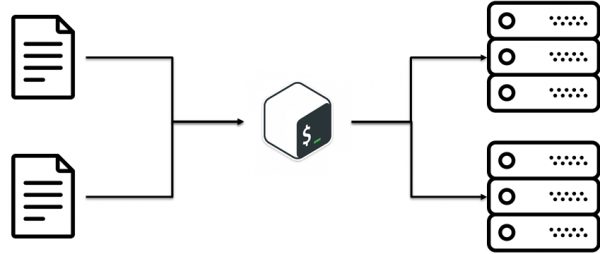
Il s'avère qu'il existe une pratique appelée D.R.Y. (Do not Repeat Yourself). L'idée est de réutiliser le code existant. Ça paraît simple, mais nous n'y sommes pas arrivés immédiatement. Dans notre cas, c'était une idée banale : séparer les configurations des scripts. C'est-à-dire que la logique métier de déploiement d'installation est distincte, les configurations sont séparées.
S.O.L.I.D. pour CFM
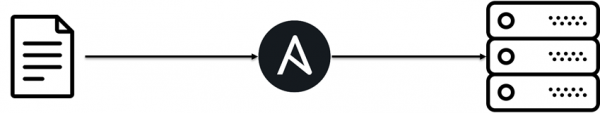
Au fil du temps, le projet a grandi et a été l'émergence d'Ansible. La principale raison de son apparition est l'expertise au sein de l'équipe et le fait que bash n'est pas conçu pour des logiques complexes. Ansible a également commencé à contenir des logiques complexes. Afin que cette logique complexe ne devienne pas chaotique, il existe des principes d'organisation du code dans le développement logiciel. S.O.L.I.D. Par exemple, Grigory Petrov dans sa présentation « Pourquoi un informaticien a besoin d'une marque personnelle » a abordé la question que l'homme, tel qu'il est conçu, trouve plus simple de travailler avec certaines entités sociales, et dans le développement logiciel, ce sont des objets. Si l'on combine ces deux idées et qu'on continue à les développer, on peut remarquer qu'il est également possible d'utiliser S.O.L.I.D. afin que par la suite, il soit plus facile de maintenir et de modifier cette logique.
Le principe de la responsabilité unique
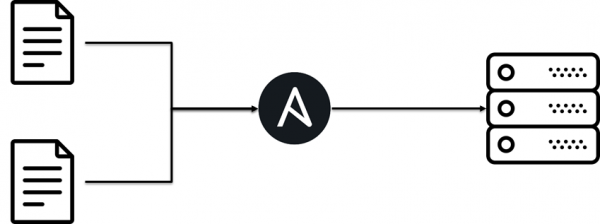
Chaque classe n'accomplit qu'une seule tâche.
Il ne faut pas mélanger le code et créer des monstres de spaghetti monolithiques. L'infrastructure doit être composée de briques simples. Il s'avère que si l'on décompose un playbook Ansible en petits morceaux, c'est-à-dire en rôles Ansible, il est plus facile de les maintenir.
Le principe ouvert/fermé
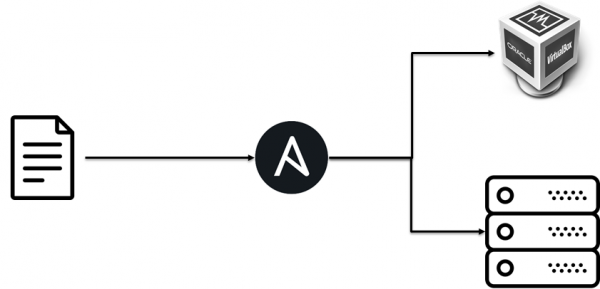
Le principe d'ouverture/fermeture.
- Ouvert à l'extension : cela signifie que le comportement d'une entité peut être étendu en créant de nouveaux types d'entités.
- Fermé à la modification : suite à l'extension du comportement de l'entité, aucune modification ne doit être apportée au code qui utilise ces entités.
Au départ, nous avons déployé l'infrastructure de test sur des machines virtuelles, mais grâce au fait que la logique métier de déploiement était séparée de sa mise en œuvre, nous avons pu facilement ajouter le déploiement sur bare metal.
Le principe de substitution de Liskov
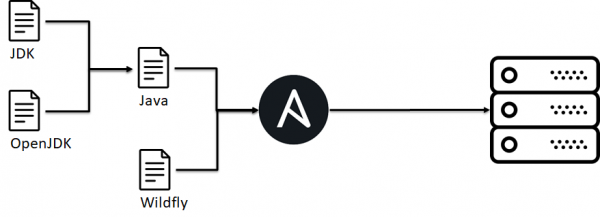
Le principe de substitution de Barbara Liskov. Les objets dans le programme doivent pouvoir être remplacés par des instances de leurs sous-types sans altérer la correction du fonctionnement du programme.
Si l'on regarde plus largement, il ne s'agit pas d'une spécificité d'un projet particulier, mais il y a plusieurs applications possibles. S.O.L.I.D., cela concerne en général le CFM, par exemple, sur un autre projet, il est nécessaire de déployer une application Java empaquetée au-dessus de différents serveurs Java, bases de données, systèmes d'exploitation, etc. Sur cet exemple, je vais examiner les principes suivants. S.O.L.I.D.
Dans notre cas, au sein de l'équipe d'infrastructure, il y a un accord selon lequel si nous avons installé le rôle imbjava ou oraclejava, alors nous avons un fichier binaire exécutable java. Cela est nécessaire car les rôles supérieurs dépendent de ce comportement, ils s'attendent à ce que java soit présent. En même temps, cela nous permet de remplacer une implémentation/version de java par une autre sans changer la logique de déploiement de l'application.
Le problème réside dans le fait qu'il est impossible de réaliser cela dans Ansible, ce qui entraîne l'apparition de certains accords au sein de l'équipe.
Le principe de séparation des interfaces
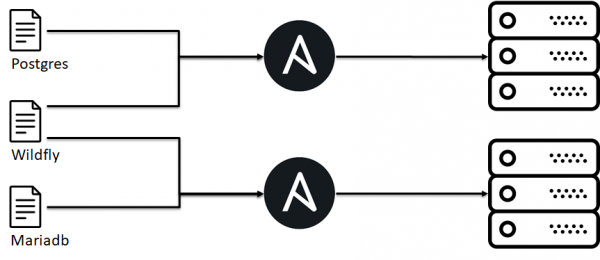
Le principe de séparation des interfaces : « plusieurs interfaces, spécialement conçues pour les clients, sont meilleures qu'une seule interface générale.
Au départ, nous avons essayé de regrouper toute la variabilité du déploiement de l'application dans un seul playbook Ansible, mais cela s'est avéré difficile à maintenir. Le fait que notre interface soit spécifiée à l'extérieur (le client s'attend au port 443) permet de composer l'infrastructure à partir de blocs séparés pour chaque implémentation.
Le principe d'inversion des dépendances.
Le principe d'inversion des dépendances. Les modules de niveau supérieur ne doivent pas dépendre des modules de niveau inférieur. Les deux types de modules doivent dépendre des abstractions. Les abstractions ne doivent pas dépendre des détails. Les détails doivent dépendre des abstractions.
Cet exemple sera basé sur un antipattern.
- Un de nos clients avait un cloud privé.
- À l'intérieur du cloud, nous avons commandé des machines virtuelles.
- Cependant, en raison des spécificités du cloud, le déploiement de l'application était lié au type de hyperviseur sur lequel la VM était exécutée.
C'est-à-dire que la logique de déploiement de l'application de haut niveau, avec ses dépendances, s'étendait aux niveaux inférieurs de l'hyperviseur, et cela signifiait des problèmes lors de la réutilisation de cette logique. Ne faites pas cela.
Interaction
L'infrastructure comme code ne concerne pas seulement le code, mais aussi la relation entre le code et l'humain, ainsi que les interactions entre les développeurs d'infrastructure.
Bus factor
Supposons que vous ayez quelqu'un nommé Vasya sur votre projet. Vasya sait tout sur votre infrastructure, que se passera-t-il si Vasya venait à disparaître ? C'est une situation bien réelle, car il pourrait se faire accidentellement écraser par un bus. Cela arrive parfois. Si cela se produit et que les connaissances sur le code, sa structure, son fonctionnement, ainsi que les identifiants et mots de passe ne sont pas partagées au sein de l'équipe, cela peut entraîner une série de situations désagréables. Pour minimiser ces risques et partager les connaissances au sein de l'équipe, différentes approches peuvent être utilisées.
Pair Devopsing
Ce n'est pas comme , où les admins buvaient de la bière, changeaient les mots de passe, à l'instar du développement en binôme. C'est-à-dire que deux ingénieurs s'assoient à un même ordinateur, une même clavier et commencent à configurer ensemble votre infrastructure : configurer un serveur, écrire un rôle Ansible, etc. Cela semble beau, mais cela n'a pas fonctionné chez nous. Cependant, des cas particuliers de cette pratique ont fonctionné. Un nouvel employé arrive, son mentor prend une tâche réelle avec lui, travaille — transmet son savoir.
Un autre cas particulier est l'incident call. Lors d'un problème, un groupe de personnes de garde et concernées se réunit, un leader est désigné, qui partage son écran et exprime son raisonnement. Les autres participants suivent le fil de pensée du leader, comparent des astuces dans la console, vérifient les lignes qu'il n'a pas manquées dans les logs, apprennent des nouvelles sur le système. Cette approche a plutôt fonctionné que le contraire.
Code Review
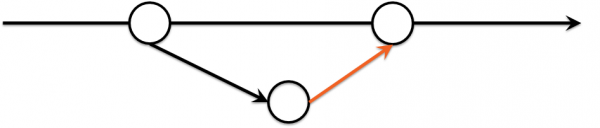
Subjectivement, la diffusion des connaissances sur l'infrastructure et son fonctionnement se faisait plus efficacement par le biais de revues de code :
- L'infrastructure est décrite par le code dans le dépôt.
- Les changements se produisent dans une branche séparée.
- Lors de la demande de fusion, on peut voir le delta des changements d'infrastructure.
L'originalité ici était que les évaluateurs étaient choisis à tour de rôle, selon un calendrier, c'est-à-dire qu'il y avait une certaine probabilité que vous exploriez un nouvel aspect de l'infrastructure.
Style de Code
Avec le temps, des conflits ont commencé à surgir lors des revues, car les réviseurs avaient chacun leur propre style, et la rotation des réviseurs les confrontait à différents styles : 2 espaces ou 4, camelCase ou snake_case. L'implémentation de cela n'a pas été immédiate.
- La première idée était de recommander d'utiliser un linter, après tout, les ingénieurs sont tous intelligents. Mais les différents éditeurs et systèmes d'exploitation compliquaient les choses.
- Cela a évolué en un bot qui, pour chaque commit problématique, écrivait dans Slack et joignait la sortie du linter. Mais dans la plupart des cas, il y avait des affaires plus importantes, et le code restait non corrigé.
Green Build Master
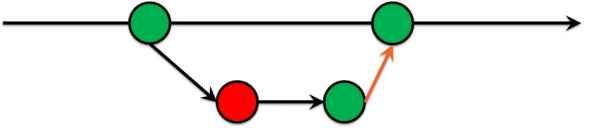
Le temps passe, et nous en sommes venus à la conclusion qu'il ne fallait pas autoriser dans la branche principale des commits qui n'avaient pas passé certains tests. Voilà ! Nous avons inventé le Green Build Master, qui est déjà largement pratiqué dans le développement logiciel :
- Le développement se fait dans une branche séparée.
- Des tests sont exécutés sur cette branche.
- Si les tests échouent, le code ne sera pas intégré dans la branche principale.
La prise de cette décision fut douloureuse, car elle a suscité de nombreux débats, mais cela en valait la peine, car les demandes de fusion ont commencé à arriver sans divergences de style, et avec le temps, le nombre de problèmes a commencé à diminuer.
Tests IaC
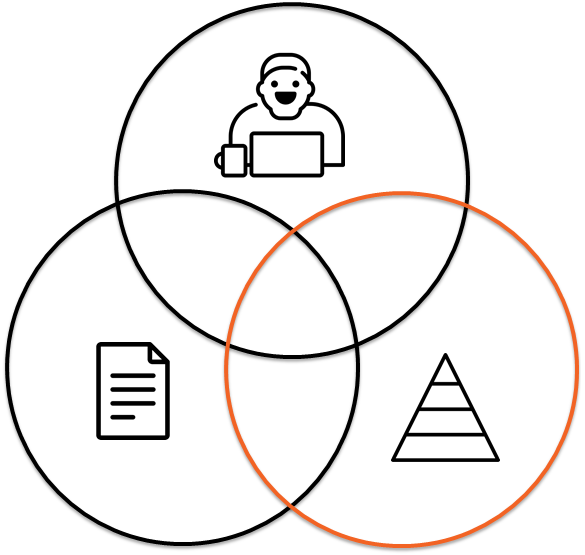
Au-delà de la vérification du style, il est possible d'utiliser d'autres outils, par exemple, vérifier que votre infrastructure peut réellement être déployée. Ou s'assurer que les modifications apportées à l'infrastructure ne coûtent pas d'argent. Pourquoi cela peut-il être nécessaire ? La question est complexe et philosophique, il est préférable de répondre par une anecdote : il y avait un auto-scaler sur PowerShell qui, sans vérifier les conditions limites, a créé plus de VM que nécessaire, entraînant des coûts pour le client supérieurs à ceux prévus. Ce n'est pas agréable, mais cette erreur aurait pu être détectée à un stade précoce.
On peut se demander pourquoi rendre une infrastructure complexe encore plus complexe ? Les tests pour l'infrastructure, tout comme pour le code, ne concernent pas la simplification, mais la compréhension de la manière dont votre infrastructure doit fonctionner.
Pyramide des tests IaC
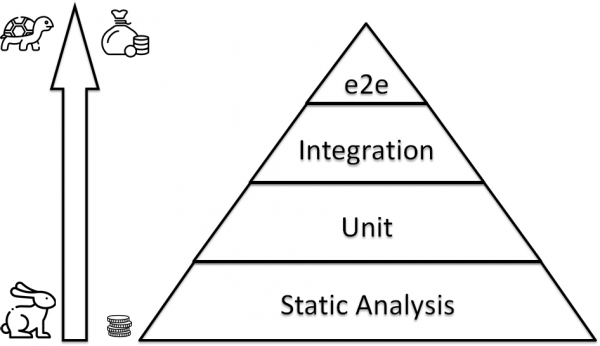
Tests IaC : Analyse statique
Si l'on déploie immédiatement toute l'infrastructure et qu'on vérifie qu'elle fonctionne, il se peut que cela prenne beaucoup de temps et nécessite énormément d'efforts. Il faut donc commencer par quelque chose de rapide, qui est en quantité et couvre de nombreux cas primitifs.
Bash est délicat
Prenons un exemple banal. Choisissez tous les fichiers dans le répertoire actuel et copiez-les à un autre endroit. La première chose qui vient à l'esprit :
for i in * ; do
    cp $i /some/path/$i.bak
done
Et si le nom de fichier contient un espace ? Eh bien, d'accord, nous sommes intelligents, nous savons utiliser des guillemets :
for i in * ; do cp "$i" "/some/path/$i.bak" ; doneBravo ? Non ! Que se passe-t-il s'il n'y a rien dans le répertoire, c'est-à-dire que le globbing ne fonctionne pas.
find . -type f -exec mv -v {} dst/{}.bak ;Alors, bravo ? Non… Vous avez oublié qu'il peut y avoir n.
touch x
mv x "$(printf "foonbar")"
find . -type f -print0 | xargs -0 mv -t /path/to/target-dir
Outils d'analyse statique
Le problème de l'étape précédente aurait pu être détecté quand nous avons oublié les guillemets, il existe de nombreux outils pour cela. , il y en a beaucoup, et vous pourrez probablement trouver un linter pour votre IDE adapté à votre stack.
Langue
Outil
bash
Ruby
python
ansible
Tests IaC : Tests unitaires
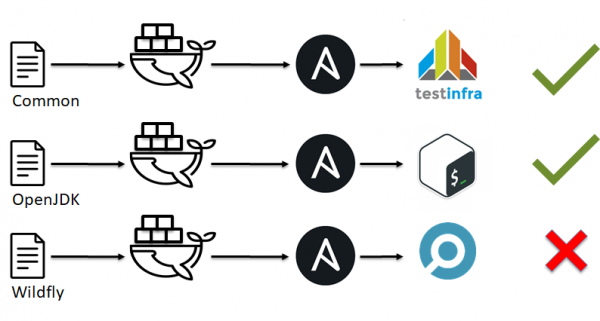
Comme nous l'avons vu dans l'exemple précédent, les linters ne sont pas omnipotents et ne peuvent pas indiquer tous les endroits problématiques. En suivant l'analogie avec le test dans le développement logiciel, on pourrait se souvenir des tests unitaires. Tout de suite vient à l'esprit , , , . Mais que faire avec ansible, chef, saltstack et autres ?
Au début, nous avons parlé de S.O.L.I.D. et du fait que notre infrastructure doit être composée de petits briques. Leur temps est venu.
- L'infrastructure est divisée en petites briques, par exemple, des rôles Ansible.
- Un certain environnement est déployé, que ce soit docker ou une VM.
- Nous appliquons notre rôle Ansible à cet environnement de test.
- Nous vérifions que tout fonctionne comme prévu (nous exécutons des tests).
- Nous décidons si c'est bon ou pas.
Tests IaC : Outils de tests unitaires
La question est, qu'est-ce que des tests pour CFM ? On peut simplement exécuter un script, ou on peut utiliser des solutions prêtes à l'emploi pour cela :
CFM
Outil
Ansible
Chef
Chef
saltstack
Exemple pour testinfra, vérifions que les utilisateurs test1, test2 existent et appartiennent au groupe sshusers:
def test_default_users(host):
    users = ['test1', 'test2' ]
    for login in users:
        assert host.user(login).exists
        assert 'sshusers' in host.user(login).groups
Que choisir ? C'est une question complexe et ambiguë, voici un exemple de changements dans des projets sur github entre 2018 et 2019 :
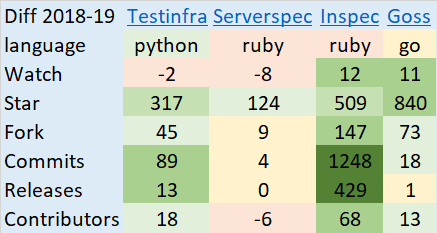
Cadres de tests IaC
Comment assembler et exécuter tout cela ? On peut si l'on a suffisamment d'ingénieurs. On peut aussi utiliser des solutions prêtes à l'emploi, bien qu'il n'y en ait pas beaucoup :
CFM
Outil
Ansible
Chef
Terraform
Exemple de changements dans des projets sur github entre 2018 et 2019 :
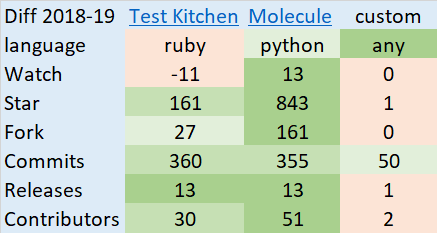
Molecule vs. Testkitchen
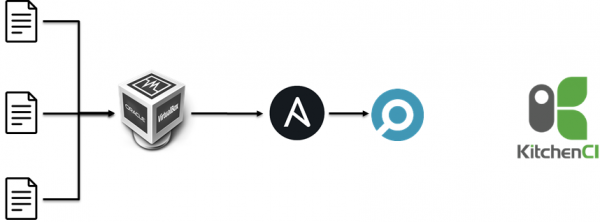
Au départ, nous :
- Créer une VM en parallèle.
- Appliquer des rôles Ansible.
- Exécuter inspec.
Pour 25 à 35 rôles, cela a pris entre 40 et 70 minutes, ce qui était long.
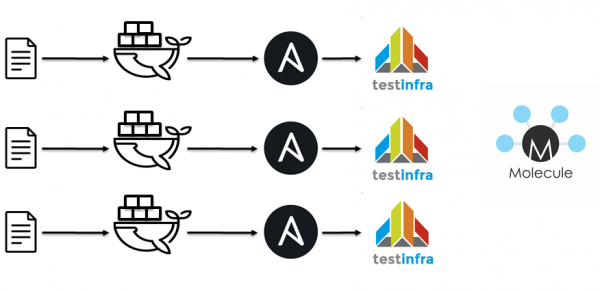
L'étape suivante a été de passer à jenkins / docker / ansible / molecule. Ideologiquement, c'est la même chose.
- Lint les playbooks.
- Lint les rôles.
- Démarrer le conteneur.
- Appliquer des rôles Ansible.
- Exécuter testinfra.
- Vérifier l'idempotence.
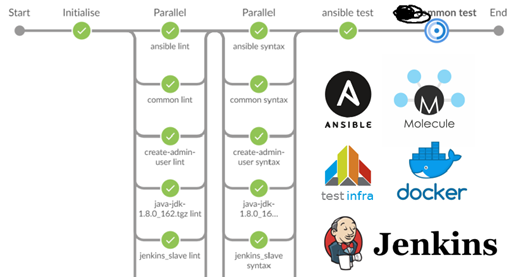
Le linting pour 40 rôles et les tests pour une dizaine ont pris environ 15 minutes.
Le choix dépend de nombreux facteurs, tels que la pile utilisée, l'expertise de l'équipe, etc. Chacun décide comment aborder la question des tests unitaires.
Tests IaC : Tests d'intégration.
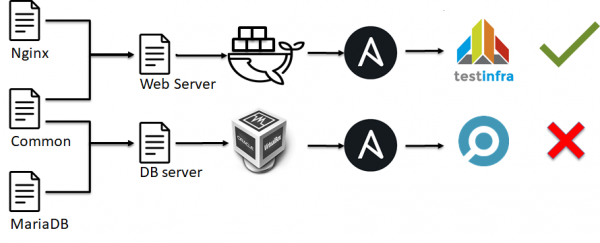
Au prochain niveau de la pyramide des tests d'infrastructure, apparaissent les tests d'intégration. Ils ressemblent aux tests unitaires :
- L'infrastructure est décomposée en petites briques, par exemple, les rôles Ansible.
- Un certain environnement est déployé, que ce soit docker ou une VM.
- Cet environnement de test est appliqué de nombreux des rôles Ansible.
- Nous vérifions que tout a fonctionné comme prévu (nous exécutons les tests).
- Nous décidons si c'est bon ou pas.
En gros, nous ne vérifions pas la fonctionnalité d'un élément individuel du système comme dans les tests unitaires, nous vérifions comment le serveur est configuré dans son ensemble.
Tests IaC : Tests de bout en bout.
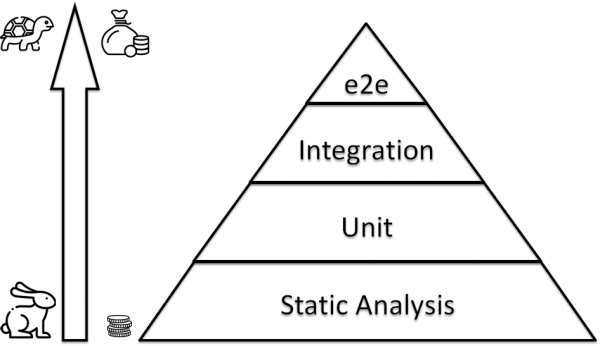
Au sommet de la pyramide, nous rencontrons les tests de bout en bout. C'est-à-dire que nous ne vérifions pas la fonctionnalité d'un serveur particulier, d'un script particulier, d'une brique particulière de notre infrastructure. Nous vérifions que plusieurs serveurs, réunis, fonctionnent comme nous l'attendions. Malheureusement, je n'ai pas vu de solutions prêtes à l'emploi, probablement parce que l'infrastructure est souvent unique et qu'il est difficile de la modéliser et de créer un cadre pour son test. En fin de compte, tout le monde crée ses propres solutions. La demande existe, mais la réponse n'est pas là. C'est pourquoi je vais partager ce qui existe pour inspirer les autres ou me corriger si tout cela a déjà été inventé.
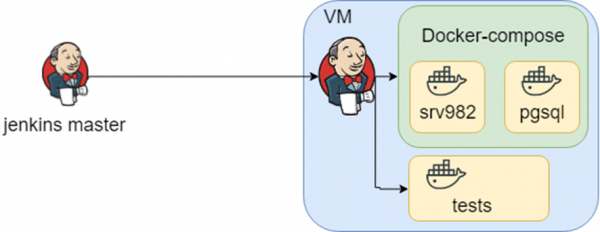
Un projet avec une riche histoire. Utilisé dans de grandes organisations et probablement que chacun d'entre vous y a été impliqué indirectement. L'application prend en charge de nombreuses bases de données, intégrations, etc. Savoir à quoi peut ressembler l'infrastructure, c'est avoir de nombreux fichiers docker-compose, et savoir quels tests exécuter dans quel environnement - c'est jenkins.
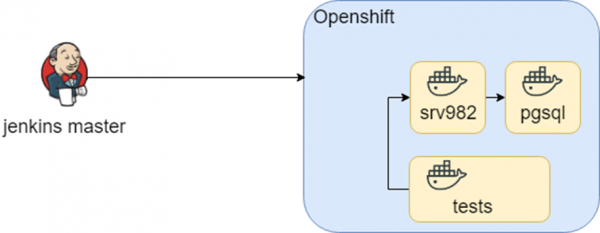
Ce schéma a fonctionné assez longtemps, jusqu'à ce que dans le cadre nous ayons essayé de le transférer dans Openshift. Les conteneurs sont restés les mêmes, mais l'environnement d'exécution a changé (bonjour D.R.Y. encore une fois).
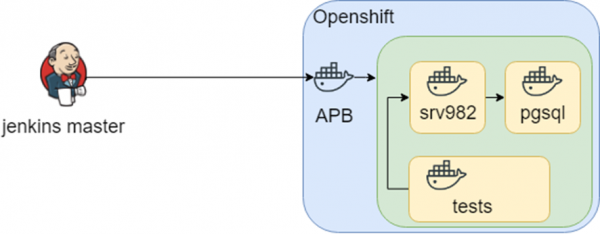
L'idée de la recherche a évolué, et dans OpenShift, il a été trouvé un outil appelé APB (Ansible Playbook Bundle), qui permet de conditionner le savoir sur le déploiement d'une infrastructure dans un conteneur. Autrement dit, il existe un point de connaissance reproductible et testable sur la manière de déployer l'infrastructure.
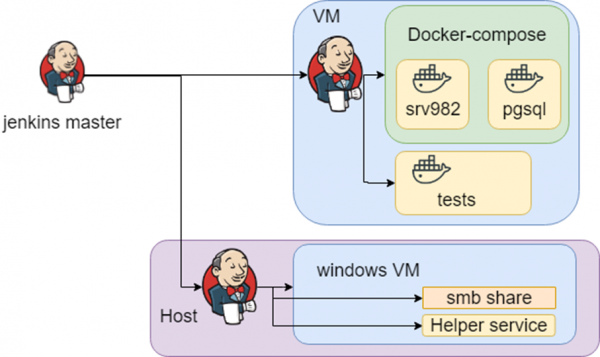
Tout cela semblait bon jusqu'à ce que nous soyons confrontés à une infrastructure hétérogène : pour nos tests, nous avons besoin de Windows. En fin de compte, le savoir sur où, comment déployer et tester est stocké dans Jenkins.
Conclusion
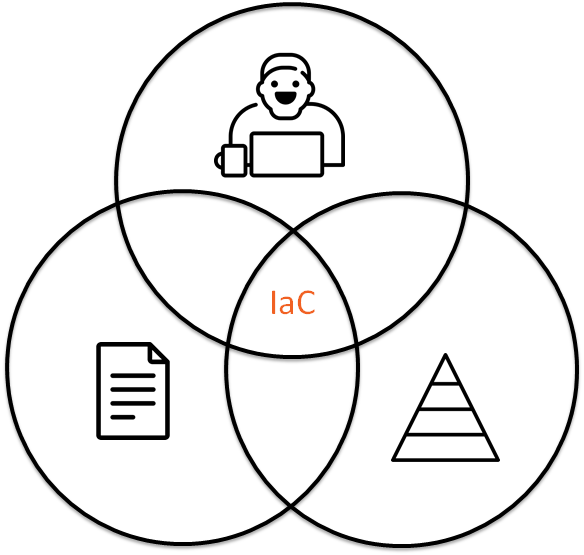
L'infrastructure en tant que code, c'est
- Le code dans le dépôt.
- L'interaction entre les personnes.
- Tester l'infrastructure.
liens
- Exécution à blanc 2019-04-24
- &
Source : habr.com
