

Bonjour, habr.
Si quelqu'un exploite le système et rencontre un problème de performance de stockage (IO, espace disque consommé), alors la probabilité que ClickHouse ait été envisagé comme remplacement doit tendre vers un. Cette affirmation implique que, comme métriques, un démon tiers est déjà utilisé, par exemple ou .
ClickHouse résout bien les problèmes décrits. Par exemple, après avoir transféré 2TiB de données de whisper, elles ont été compressées dans 300GiB. Je ne vais pas m’arrêter en détail sur la comparaison, il y a suffisamment d'articles à ce sujet. De plus, jusqu'à récemment, notre stockage ClickHouse n'était pas parfait.
Problèmes de consommation d'espace
À première vue, tout devrait fonctionner correctement. En suivant , créons un config pour le schéma de stockage des métriques (ci-après retention), puis créons une table selon les recommandations du backend choisi pour graphite-web : + ou , selon la pile utilisée. Et... une bombe à retardement est activée.
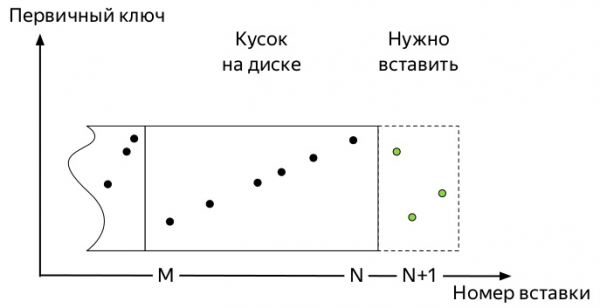
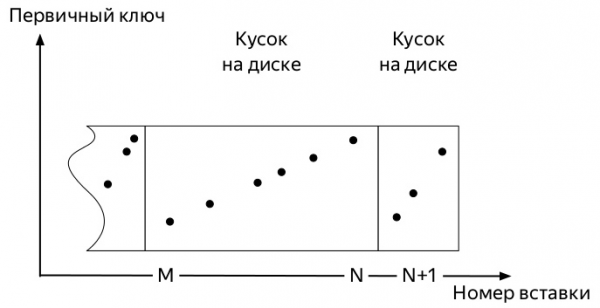
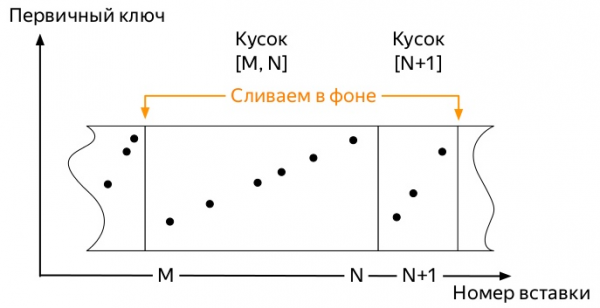
Pour comprendre laquelle, il faut savoir comment fonctionnent les insertions et le parcours de vie des données dans les tables des moteurs de la famille *MergeTree ClickHouse (les diagrammes proviennent de Alexei Zatelepin) :
- Un
blocde données est inséré. Dans notre cas, ce sont les métriques qui sont arrivées.

- Chaque bloc est trié avant l'écriture sur disque selon la clé
ORDER BY, spécifiée lors de la création de la table. - Après le tri,
un morceau(part) de données est écrit sur le disque.
- Le serveur surveille en arrière-plan pour que ces morceaux ne soient pas trop nombreux et lance des
fusions(fusionner, ensuite les merges).
- Le serveur arrête de lancer des merges automatiquement dès que les données cessent d'affluer activement dans
la partition(partition), mais il est possible de lancer le processus manuellement avec la commandeOPTIMIZE. - Si une seule pièce reste dans la partition, il ne sera pas possible de lancer un merge avec une commande classique, il faut utiliser
OPTIMIZE ... FINAL
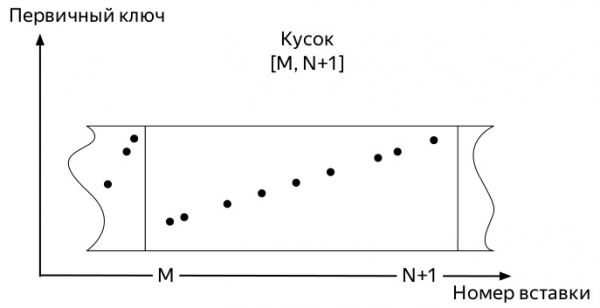
Ainsi, les premières métriques arrivent. Et elles occupent un certain espace. Les événements suivants peuvent varier en fonction de nombreux facteurs :
- La clé de partitionnement peut être très petite (un jour) ou très grande (plusieurs mois).
- La configuration de retention peut contenir plusieurs seuils significatifs d'agrégation des données dans la partition active (où les métriques sont écrites), ou pas.
- Si les données sont très nombreuses, les premiers morceaux, qui peuvent déjà être énormes en raison des fusions en arrière-plan (lorsque l’on choisit une clé de partitionnement non optimale), ne seront pas fusionnés eux-mêmes avec les nouveaux petits morceaux.
Et tout se termine toujours de la même manière. L’espace occupé par les métriques dans ClickHouse ne fait qu’augmenter si :
- vous ne l’appliquez pas
OPTIMIZE ... FINALmanuellement ou - vous n’insérez pas de données dans toutes les partitions de manière continue, afin de lancer tôt ou tard une fusion en arrière-plan
La deuxième méthode semble être la plus simple à mettre en œuvre et, par conséquent, elle est incorrecte et a été testée en premier.
J'ai écrit un script assez simple en python, qui envoyait des métriques fictives pour chaque jour des 4 dernières années et s'exécutait chaque heure par cron.
Comme tout le travail du système de gestion de base de données ClickHouse repose sur le fait que ce système fera tôt ou tard tout le travail en arrière-plan, mais on ne sait pas quand, attendre le moment où les vieux énormes morceaux daigneront commencer à fusionner avec les nouveaux petits n’a pas réussi. Il est devenu clair qu'il fallait chercher un moyen d'automatiser les optimisations forcées.
Les informations dans les tables système ClickHouse
Examinons la structure de la table . Cela fournit des informations complètes sur chaque morceau de toutes les tables sur le serveur ClickHouse. Elle contient, entre autres, les colonnes suivantes :
- nom de la base de données (
database); - nom de la table (
table); - nom et ID de la partition (
partition&partition_id); - quand le morceau a été créé (
modification_time); - date minimale et maximale dans le morceau (le partitionnement se fait par jour) (
min_date&max_date);
Il y a aussi une table , avec les champs intéressants suivants :
- nom de la base de données (
Tables.database); - nom de la table (
Tables.table); - l'âge de la métrique, quand la prochaine agrégation doit être appliquée (
age);
Donc :
- Nous avons une table de morceaux et une table de règles d'agrégation.
- Nous unissons leurs intersections et obtenons toutes les tables *GraphiteMergeTree.
- Nous recherchons toutes les partitions où :
- il y a plus d'un morceau
- ou le moment est venu d'appliquer la prochaine règle d'agrégation, et
modification_timeelles sont plus anciennes que ce moment.
Mise en œuvre
Cette requête
SÉLECTIONNER
    concat(p.database, '.', p.table) AS table,
    p.partition_id AS partition_id,
    p.partition AS partition,
    -- La règle "la plus ancienne" pouvant être appliquée à
    -- la partition, mais pas dans le futur, voir (*)
    max(g.age) AS age,
    -- Nombre de morceaux dans la partition
    countDistinct(p.name) AS parts,
    -- La métrique la plus ancienne dans la partition est considérée comme 00:00:00 le lendemain
    toDateTime(max(p.max_date + 1)) AS max_time,
    -- Quand la partition doit être optimisée
    max_time + age AS rollup_time,
    -- Quand le morceau le plus ancien dans la partition a été mis à jour
    min(p.modification_time) AS modified_at
DE system.parts AS p
JOINTURE INTERNE
(
    -- Toutes les règles pour toutes les tables *GraphiteMergeTree
    SÉLECTIONNER
        Tables.database AS database,
        Tables.table AS table,
        age
    DE system.graphite_retentions
    ARRAY JOIN Tables
    GROUPE PAR
        database,
        table,
        age
) AS g ON
    (p.table = g.table)
    ET (p.database = g.database)
OÙ
    -- Seulement les morceaux actifs
    p.active
    -- (*) Et seulement les lignes où les règles d'agrégation doivent déjà être appliquées
    ET ((toDateTime(p.max_date + 1) + g.age) < maintenant())
GROUPE PAR
    table,
    partition
AYANT
    -- Seulement les partitions plus jeunes que le moment d'optimisation
    (modified_at  1)
ORDONNER PAR
    table ASC,
    partition ASC,
    age ASC
renvoie chacune des partitions des tables *GraphiteMergeTree, dont la fusion doit libérer de l'espace disque. Il ne reste plus qu'à traiter chacune d'elles avec la requête OPTIMIZE ... FINAL. Dans la mise en œuvre finale, il a également été pris en compte que les partitions avec des écritures actives n'ont pas besoin d'être touchées.
C'est exactement ce que fait le projet . Anciens collègues de Yandex.Market l'ont testé en production, le résultat peut être vu ci-dessous.
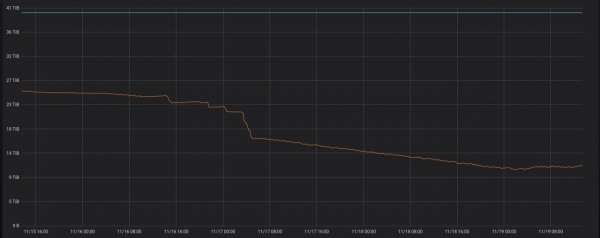
Si vous exécutez le programme sur un serveur avec ClickHouse, il commencera simplement à fonctionner en mode démon. Une fois par heure, il exécutera une requête pour vérifier s'il y a de nouvelles partitions de plus de trois jours pouvant être optimisées.
Les projets à venir incluent la fourniture, au moins, de paquets deb, et idéalement aussi de rpm.
En conclusion
Au cours des neuf derniers mois, j'ai passé beaucoup de temps à l'intérieur de ma société à travailler à l'intersection de ClickHouse et graphite-web. C'était une bonne expérience, dont le résultat a permis une transition imminente de whisper à ClickHouse comme stockage de métriques. J'espère que cet article sera comme le début d'une série sur les améliorations que nous avons apportées à différentes parties de cette pile, et sur ce qui sera fait à l'avenir.
Le développement de cette demande a nécessité plusieurs litres de bière et des jours d'administration en collaboration avec , pour lesquels je tiens à exprimer ma gratitude. Ainsi que pour la révision de cet article.
Source : habr.com
