

Le sujet de DevOps est actuellement en vogue. Le pipeline d'intégration et de livraison continues est mis en œuvre par tous ceux qui le souhaitent. Cependant, la plupart n'accordent pas toujours l'attention nécessaire à la fiabilité des systèmes d'information à différentes étapes du pipeline CI/CD. Dans cet article, je souhaite partager mon expérience sur l'automatisation des vérifications de qualité logicielle et la mise en œuvre de scénarios possibles pour son « auto-réparation ».
Je travaille en tant qu'ingénieur dans le département de gestion des services informatiques de l'entreprise . Ma spécialité est l'implémentation de divers systèmes de surveillance des performances et de la disponibilité des applications. Je suis en contact fréquent avec des clients du secteur IT sur des questions d'actualité liées à la surveillance de la qualité de leurs services informatiques. L'objectif principal est de minimiser le temps de cycle de publication et d'augmenter la fréquence de leurs versions. C'est, bien sûr, une bonne chose : plus de versions – plus de nouvelles fonctionnalités – plus d'utilisateurs satisfaits – plus de bénéfices. Mais en réalité, tout ne se passe pas toujours bien. Avec des rythmes de déploiement très élevés, la question de la qualité de nos versions émerge immédiatement. Même avec un pipeline entièrement automatisé, l'un des plus grands problèmes est la transition des services de la phase de test à la production, sans affecter le temps de disponibilité et l'interaction des utilisateurs avec l'application.
D'après de nombreuses discussions avec les clients, je peux dire que le contrôle de la qualité des versions, la fiabilité de l'application et la possibilité de « auto-réparation » (par exemple, revenir à une version stable) à différentes étapes du pipeline CI/CD figurent parmi les sujets les plus préoccupants et d'actualité.
Récemment, j'ai travaillé du côté du client – dans le service de support du logiciel de banque en ligne. L'architecture de notre application utilisait un grand nombre de microservices sur mesure. Le plus triste, c'est que tous les développeurs n'étaient pas capables de suivre le rythme élevé de développement, la qualité de certains microservices en pâtissait, entraînant des surnoms amusants pour eux et leurs créateurs. Des légendes circulaient sur la manière dont ces produits étaient fabriqués.
« Énoncé du problème »
La fréquence élevée des mises à jour et le grand nombre de microservices compliquent la compréhension du fonctionnement de l'application dans son ensemble, tant lors des tests que lors de l'exploitation. Les modifications se produisent constamment, et il est très difficile de les contrôler sans de bons outils de surveillance. Souvent, après une mise à jour nocturne, les développeurs sont anxieux le matin, craignant que quelque chose ne se casse, alors que toutes les vérifications étaient passées avec succès lors des tests.
Il y a encore un point à considérer. Pendant la phase de test, la fonctionnalité du logiciel est vérifiée : l'exécution des principales fonctions de l'application et l'absence d'erreurs. Les évaluations de performance sont souvent inexistantes ou ne prennent pas en compte tous les aspects du fonctionnement de l'application et de la couche d'intégration. Certaines métriques ne sont même pas vérifiées. En fin de compte, lorsque un problème survient en production, le support technique en est informé seulement quand de vrais utilisateurs commencent à se plaindre. Nous souhaitons minimiser l'impact des logiciels de mauvaise qualité sur les utilisateurs finaux.
Une des solutions consiste à intégrer des processus de vérification de la qualité des logiciels à différentes étapes du pipeline CI/CD, en ajoutant divers scénarios de récupération du système en cas d'incident. N'oublions pas que nous travaillons en mode DevOps. Les entreprises s'attendent à recevoir de nouveaux produits le plus rapidement possible. Par conséquent, toutes nos vérifications et scénarios doivent être automatisés.
La tâche se divise en deux éléments :
- contrôle de la qualité des builds pendant la phase de test (automatiser le processus de détection des builds de mauvaise qualité);
- contrôle de la qualité des logiciels en environnement de production (mécanismes de détection automatique des problèmes et scénarios possibles d'auto-récupération).
Outil pour la surveillance et la collecte de métriques
Pour réaliser les objectifs fixés, un système de surveillance capable de détecter les problèmes et de les transmettre aux systèmes d'automatisation à différentes étapes du pipeline CI/CD est nécessaire. Il serait également utile que ce système fournisse des métriques pertinentes pour les différentes équipes : développement, test, exploitation. Et ce serait idéal si cela beneficiait également l'entreprise.
Pour collecter des métriques, on peut utiliser un ensemble de systèmes différents (Prometheus, ELK Stack, Zabbix, etc.), mais à mon avis, les solutions de type APM sont les plus adaptées à ces tâches.), qui peuvent grandement vous simplifier la vie.
Dans le cadre de mon travail au service d'assistance, j'ai commencé à développer un projet similaire en utilisant une solution APM de la société Dynatrace. Maintenant, travaillant chez un intégrateur, je connais assez bien le marché des systèmes de surveillance. À mon avis, Dynatrace est le mieux adapté pour résoudre de telles tâches.
La solution Dynatrace fournit une représentation horizontale de chaque opération utilisateur avec un degré de détail profond jusqu'au niveau d'exécution du code. On peut suivre toute la chaîne d'interaction entre différents services d'information : des niveaux frontend des applications web et mobiles, aux serveurs d'applications back-end, à travers le bus d'intégration jusqu'à l'appel spécifique dans la base de données.
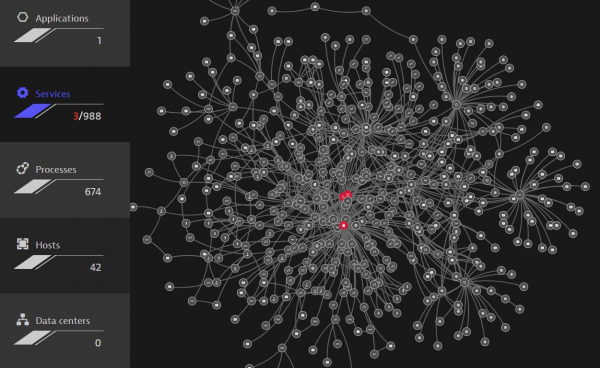 . Construction automatique de toutes les dépendances entre les composants du système.
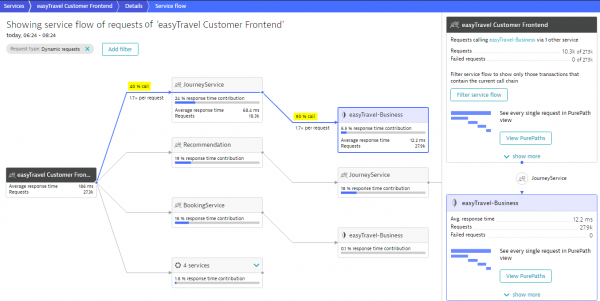 . Détection et construction automatique du chemin de traitement de l'opération du service.
N'oublions pas également que nous devons nous intégrer avec divers outils d'automatisation. Ici, la solution dispose d'une API conviviale qui permet d'envoyer et de recevoir diverses métriques et événements.
Passons maintenant à un examen plus détaillé de la façon de résoudre les tâches définies à l'aide du système Dynatrace.
Tâche 1. Automatisation du contrôle qualité des builds au stade de test.
La première tâche consiste à détecter les problèmes le plus tôt possible dans les étapes du pipeline de livraison de l'application. Seules les builds de code 'satisfaisantes' doivent atteindre l'environnement de production. Pour cela, votre pipeline doit inclure des moniteurs supplémentaires pour vérifier la qualité de vos services au stade de test.
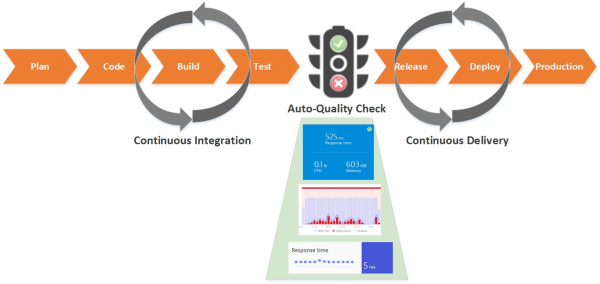
Voyons étape par étape comment réaliser et automatiser ce processus :
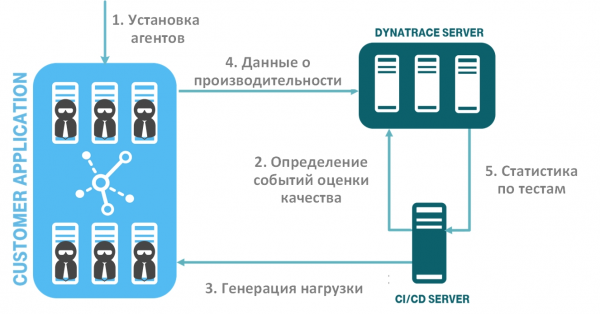
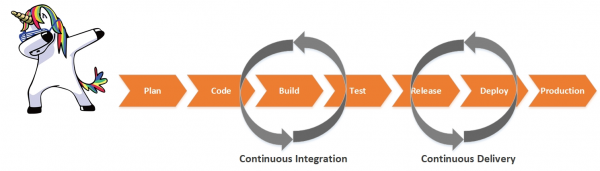
L'illustration montre le flux des étapes automatisées de vérification de la qualité du logiciel :
- déploiement du système de surveillance (installation d'agents);
- définition des événements d'évaluation de la qualité de votre logiciel (métriques et seuils) et leur transmission au système de surveillance;
- génération de charge et tests de performance;
- collecte de données sur la performance et la disponibilité dans le système de surveillance;
- transfert des données des tests basés sur des événements d'évaluation de la qualité des logiciels, du système de surveillance vers le système CI/CD. Analyse automatique des builds.
Étape 1. Déploiement du système de surveillance
Tout d'abord, vous devez installer des agents dans votre environnement de test. La solution Dynatrace a une caractéristique agréable – elle utilise un agent universel, OneAgent, qui s'installe sur l'instance OS (Windows, Linux, AIX), découvre automatiquement vos services et commence à recueillir des données de surveillance à leur sujet. Vous n'avez pas besoin de configurer un agent séparé pour chaque processus. La même situation s'appliquera aux plateformes cloud et conteneurisées. De plus, vous pouvez également automatiser le processus d'installation des agents. Dynatrace s'intègre parfaitement dans le concept d'« infrastructure en tant que code » (): des scripts et des instructions prêts à l'emploi existent pour toutes les plateformes populaires. Vous intégrez l'agent dans la configuration de votre service, et lors de son déploiement, vous obtenez immédiatement un nouveau service avec un agent fonctionnel.
Étape 2. Détermination des événements d'évaluation de la qualité de votre logiciel
Il est maintenant nécessaire de déterminer la liste des services et des opérations commerciales. Il est important de tenir compte des opérations des utilisateurs qui sont critiques pour votre service. Je vous recommande de consulter des analystes commerciaux et système.
Ensuite, il est nécessaire de définir quelles métriques vous souhaitez inclure dans la vérification pour chacun des niveaux. Par exemple, cela peut inclure le temps d'exécution (réparti par moyenne, médiane, percentiles, etc.), les erreurs (logiques, de service, d'infrastructure, etc.) et diverses métriques d'infrastructure (memory heap, garbage collector, thread count, etc.).
Pour automatiser et faciliter l'utilisation par l'équipe DevOps, le concept de « Monitoring as code » émerge. Ce que cela signifie, c'est qu'un développeur/testeur peut écrire un simple fichier JSON qui définit les indicateurs de qualité des logiciels.
Considérons un exemple de tel fichier JSON. Comme paire clé/valeur, des objets de l'API Dynatrace sont utilisés (la description de l'API peut être consultée ici ).
{
    "timeseries": [
    {
      "timeseriesId": "service.ResponseTime",
      "aggregation": "avg",
      "tags": "Frontend",
      "severe": 250000,
      "warning": 1000000
    },
    {
      "timeseriesId": "service.ResponseTime ",
      "aggregation": "avg",
      "tags": "Backend",
      "severe": 4000000,
      "warning": 8000000
    },
    {
      "timeseriesId": "docker.Container.Cpu",
      "aggregation": "avg",
      "severe": 50,
      "warning": 70
    }
  ]
}
Le fichier représente un tableau de définitions de séries temporelles (timeseries):
- timeseriesId – la métrique à vérifier, par exemple, Temps de réponse, Comptage des erreurs, Mémoire utilisée, etc.;
- aggregation — le niveau d'agrégation des métriques, dans notre cas avg, mais vous pouvez utiliser tout ce qui est nécessaire pour vous (avg, min, max, sum, count, percentile);
- tags – étiquette de l'objet dans le système de surveillance, ou vous pouvez spécifier un identifiant d'objet spécifique;
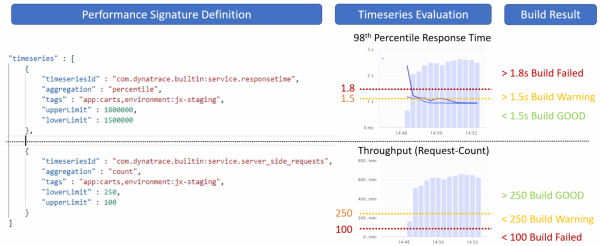
- severe et warning – ces indicateurs régulent les valeurs seuils de nos métriques, si la valeur des tests dépasse le seuil severe, alors notre assemblage est marqué comme non réussi.
L'illustration suivante montre un exemple d'utilisation de tels seuils.
Étape 3. Génération de charge
Après avoir défini les niveaux de qualité de notre service, il est nécessaire de générer une charge de test. Vous pouvez utiliser n'importe quel outil de test qui vous convient, par exemple, Jmeter, Selenium, Neotys, Gatling, etc.
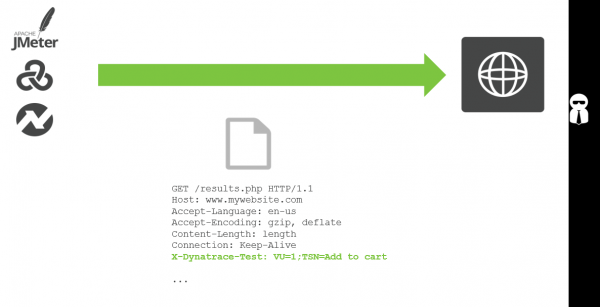
Le système de surveillance Dynatrace permet de capturer diverses métadonnées de vos tests et de reconnaître quel test appartient à quel cycle de version et à quel service. Il est recommandé d'ajouter des en-têtes supplémentaires dans les requêtes HTTP de test.
L'illustration suivante montre un exemple où, par le biais d'un en-tête supplémentaire X-Dynatrace-Test, nous signalons que ce test est lié à l'opération d'ajout de produit au panier.
Lors de l'exécution de chaque test de charge, vous envoyez des informations contextuelles supplémentaires à Dynatrace via l'API d'événements du serveur CI/CD. Ainsi, le système peut distinguer les différents tests entre eux.
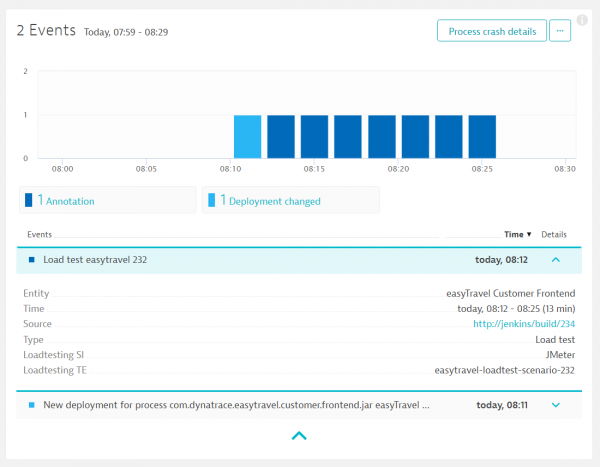 . Événement dans le système de surveillance concernant le lancement de tests de charge
Étape 4-5. Collecte des données de performance et transmission des données au système CI/CD
Avec le test généré, un événement est transmis au système de surveillance pour la nécessité de collecter des données sur l'évaluation de la qualité du service. Notre fichier JSON, dans lequel les métriques clés sont définies, est également spécifié.
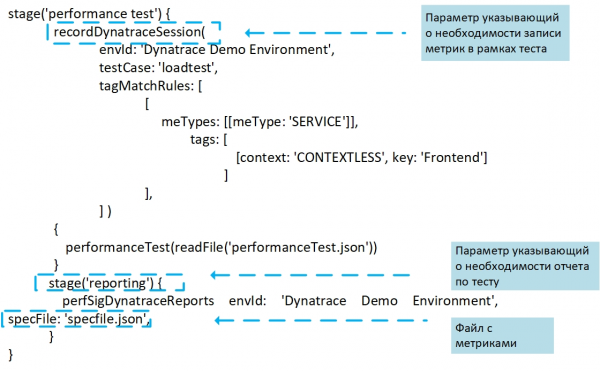 Un événement indiquant la nécessité de vérifier la qualité du logiciel, généré sur le serveur CI/CD pour être envoyé au système de surveillance
Dans notre exemple, l'événement de vérification de la qualité s'appelle perfSigDynatraceReport (Performance_Signature) – c'est un modèle prêt pour une intégration avec Jenkins, développé par l'équipe de T-Systems Multimedia Solutions. Chaque événement de lancement de vérification contient des informations sur le service, le numéro de version et le moment des tests. Le plugin collecte les valeurs de performance pendant la construction, les évalue et compare le résultat avec les constructions précédentes et les exigences non fonctionnelles.
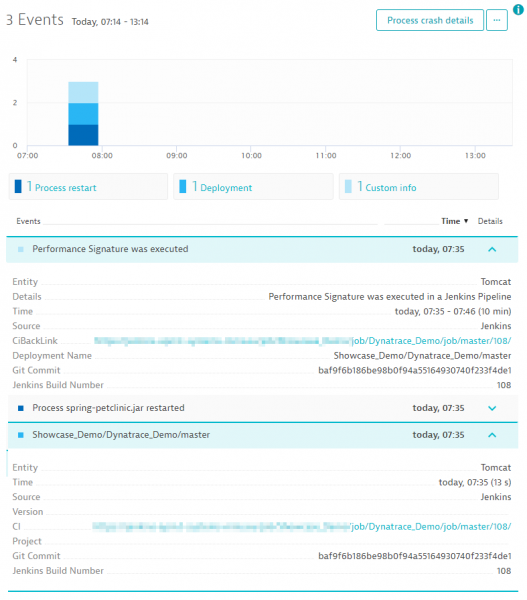 Événement dans le système de surveillance au démarrage de la vérification de la qualité de la construction.
Après la fin du test, toutes les métriques évaluant la qualité du logiciel sont renvoyées dans le système d'intégration continue, par exemple, Jenkins, qui génère un rapport sur les résultats.
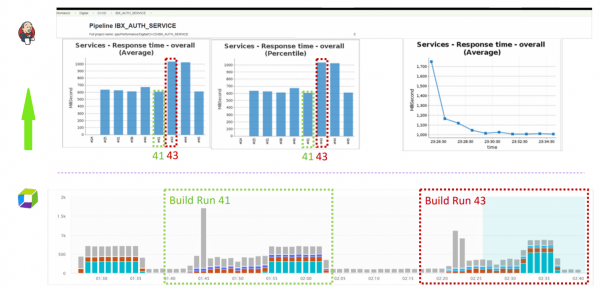 Résultat des statistiques sur les constructions sur le serveur CI/CD.
Pour chaque construction distincte, nous voyons les statistiques pour chaque métrique que nous avons définie tout au long de l'exécution du test. Nous voyons également s'il y a eu des violations dans certaines valeurs seuils (avertissement et seuils sévères). Sur la base des indicateurs cumulés, chaque construction est marquée comme stable, instable ou échouée. De plus, pour plus de commodité, vous pouvez ajouter au rapport des indicateurs comparant la construction actuelle à la précédente.
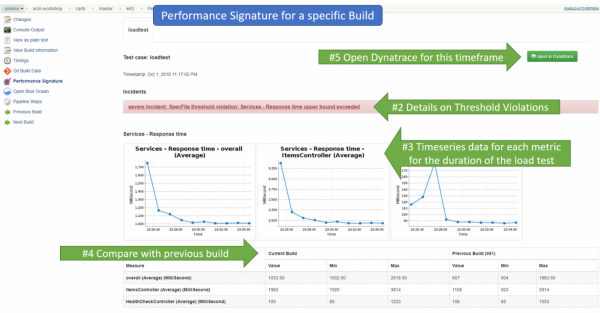 Consultation des statistiques détaillées sur les constructions sur le serveur CI/CD.
Comparaison détaillée de deux constructions
Si nécessaire, vous pouvez accéder à l'interface Dynatrace et examiner plus en détail les statistiques de chaque construction et les comparer entre elles.
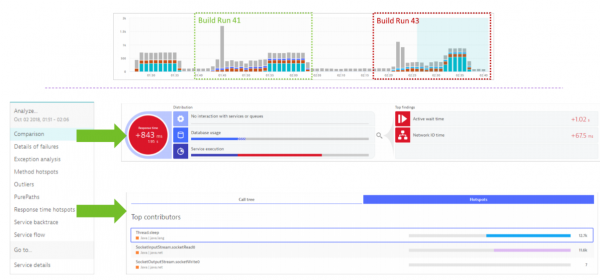 Comparaison des statistiques de construction dans Dynatrace.
Conclusions
En fin de compte, nous obtenons un service de « surveillance en tant que service », automatisé dans le pipeline d'intégration continue. Le développeur ou le testeur n'a qu'à définir la liste des métriques dans un fichier JSON, et tout le reste se fait automatiquement. Nous obtenons un contrôle transparent de la qualité des versions : toutes les notifications concernant les performances, la consommation de ressources ou les régressions architecturales.
Tâche 2. Automatisation du contrôle de la qualité du logiciel dans l'environnement de production
Ainsi, nous avons résolu le problème de l'automatisation du processus de surveillance lors de la phase de test dans le pipeline. Ainsi, nous minimisons le pourcentage de constructions de mauvaise qualité atteignant l'environnement de production.
Mais que faire si un mauvais logiciel parvient tout de même à la production, ou si quelque chose se casse simplement ? Pour notre utopie, nous souhaitions que des mécanismes de détection automatique des problèmes soient présents, et que, si possible, le système rétablisse lui-même son bon fonctionnement, ne serait-ce que pendant la nuit.
Pour cela, nous devons, à l'instar de la section précédente, prévoir des vérifications automatiques de la qualité des logiciels en environnement de production et concevoir des scénarios de rétablissement automatique du système.
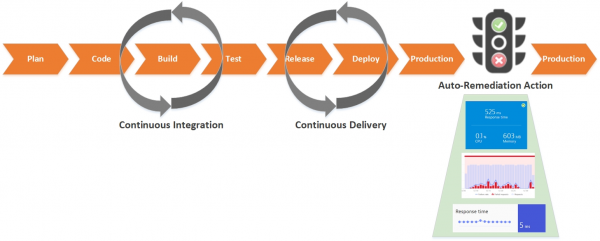
L'auto-correction comme code
Dans la plupart des entreprises, une base de connaissances a déjà été accumulée concernant divers types de problèmes courants et une liste d'actions pour les résoudre, par exemple, le redémarrage de processus, le nettoyage des ressources, le retour à des versions antérieures, la restauration de modifications de configuration incorrectes, l'augmentation ou la diminution du nombre de composants dans le cluster, le basculement du contour bleu ou vert, etc.
Bien que ces cas d'utilisation soient connus depuis de nombreuses années par de nombreuses équipes avec lesquelles je communique, peu d'entre elles ont pensé et investi dans leur automatisation.
En y réfléchissant, il n'y a rien de très compliqué dans la mise en œuvre de processus de rétablissement de la fonctionnalité de l'application. Il suffit de représenter des scénarios de travail de vos administrateurs, déjà connus, sous forme de scénarios de code (concept de « l'auto-correction comme code »), que vous avez préalablement rédigés pour chaque cas spécifique. Les scénarios de correction automatique doivent viser à éliminer la cause profonde du problème. Vous définissez vous-même les actions appropriées à entreprendre en réponse à un incident.
Comme déclencheur pour lancer un scénario, n'importe quelle métrique de votre système de surveillance peut jouer, tant que ces métriques définissent précisément que tout va mal, car il ne serait pas souhaitable d'obtenir de fausses alertes en environnement de production.
Vous pouvez utiliser n'importe quel système ou combinaison de systèmes : Prometheus, ELK Stack, Zabbix, etc. Mais je vais donner quelques exemples sur la base d'une solution APM (Dynatrace étant à nouveau utilisé comme exemple), qui facilitera également votre vie.
Tout d'abord, cela couvre tout ce qui concerne la fonctionnalité du point de vue du fonctionnement de l'application. La solution fournit des centaines de métriques à différents niveaux que vous pouvez utiliser comme déclencheurs :
- niveau des utilisateurs (navigateurs, applications mobiles, appareils IoT, comportement des utilisateurs, conversion, etc.) ;
- niveau de service et d'opérations (performance, disponibilité, erreurs, etc.) ;
- niveau d'infrastructure de l'application (métriques OS de l'hôte, JMX, MQ, serveur web, etc.) ;
- niveau des plateformes (virtualisation, cloud, conteneurs, etc.).
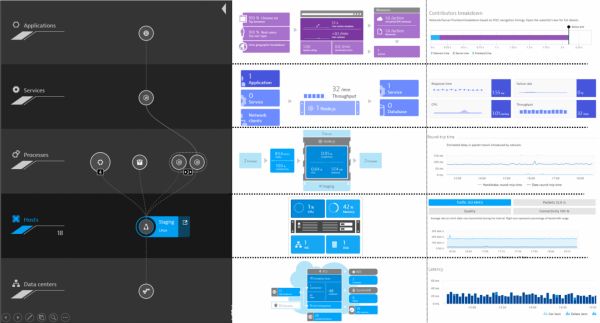 Niveaux de surveillance dans Dynatrace.
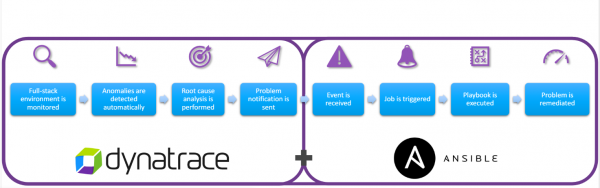
Deuxièmement, comme je l'ai mentionné précédemment, Dynatrace a une API ouverte qui permet une intégration très pratique avec divers systèmes tiers. Par exemple, envoyer une notification dans le système d'automatisation en cas de dépassement des paramètres de contrôle.
Voici un exemple d'interaction avec Ansible.
Je vais maintenant donner quelques exemples des automatisations possibles. Ce n'est qu'une partie des cas d'utilisation, leur liste dans votre environnement peut être limitée uniquement par votre imagination et les capacités de vos outils de surveillance.
1. Mauvais déploiement – retour à l'ancienne version
Même si nous vérifions tous très soigneusement dans l'environnement de test, il y a toujours une chance qu'une nouvelle version puisse faire tomber votre application en production. Le facteur humain n'est pas à négliger.
Dans le graphique suivant, nous voyons qu'il y a un pic soudain dans le temps d'exécution des opérations sur le service. Le début de ce pic coïncide avec le moment du déploiement de l'application. Nous transmettons toutes ces informations sous forme d'événements au système d'automatisation. Si la performance du service ne se normalise pas après le temps que nous avons fixé, un script est automatiquement lancé pour revenir à l'ancienne version.
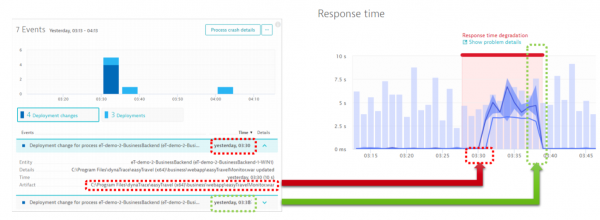 Dégradation de la performance des opérations après le déploiement.
2. Utilisation des ressources à 100 % – ajouter un nœud à la routage
Dans l'exemple suivant, le système de surveillance détecte qu'un des composants est soumis à une charge CPU à 100 %.
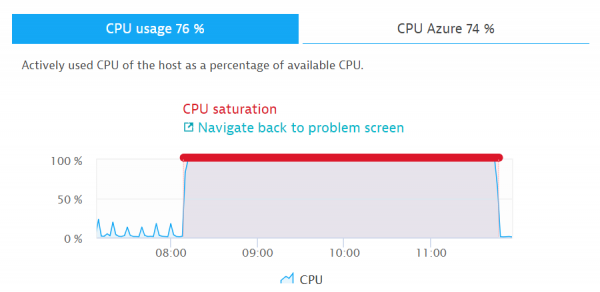 Charge CPU 100%
Pour cet événement, plusieurs scénarios différents sont possibles. Par exemple, le système de surveillance vérifie si le manque de ressources est lié à une augmentation de la charge sur le service. Si oui, un script est exécuté pour ajouter automatiquement un nœud au routage, rétablissant ainsi la fonctionnalité du système dans son ensemble.
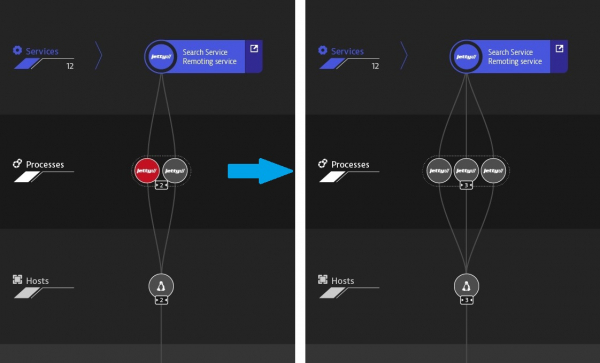 Mise à l'échelle après un incident
3. Manque d'espace sur le disque dur – nettoyage du disque
Je pense que ces processus sont déjà automatisés pour beaucoup. Avec APM, on peut également surveiller l'espace disponible sur le sous-système de stockage. En cas d'absence d'espace ou de lenteur du disque, nous appelons un script pour nettoyer ou ajoutons de l'espace.
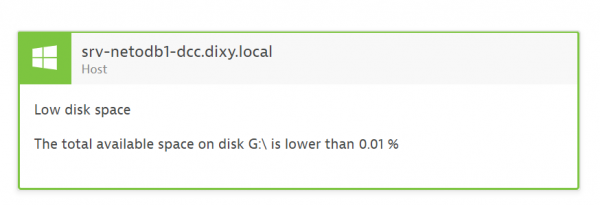
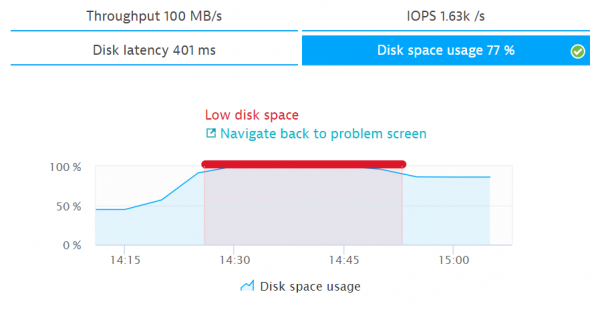 Chargement du disque 100%
4. Faible activité des utilisateurs ou faible conversion – commutation entre la branche bleue et la branche verte
Je rencontre souvent des clients qui utilisent deux brins (déploiement blue-green) pour des applications en environnement de production. Cela permet de passer rapidement d'une branche à l'autre lors de la livraison de nouvelles versions. Souvent, après un déploiement, des changements radicaux peuvent se produire, qui ne sont pas immédiatement perceptibles. De plus, la dégradation des performances et de la disponibilité peut ne pas être observée. Pour réagir rapidement à ces changements, il est préférable d'utiliser différentes métriques reflétant le comportement des utilisateurs (nombre de sessions et d'actions des utilisateurs, conversion, taux de rebond). Dans l'image suivante, on montre un exemple où une chute de conversion entraîne un basculement entre les branches du logiciel.
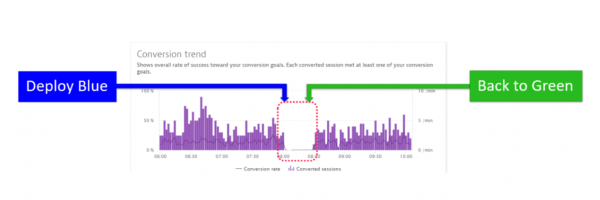 Chute de conversion après le basculement entre les branches du logiciel.
Mécanismes de détection automatique des problèmes
À la fin, je donnerai un autre exemple de ce que j'aime le plus dans Dynatrace.
Dans le cadre de mon récit sur l'automatisation de la vérification de la qualité des builds en environnement de test, tous les seuils ont été définis manuellement. Pour l'environnement de test, cela est normal, le testeur définit lui-même les indicateurs avant chaque vérification en fonction de la charge. En production, il est souhaitable que les problèmes soient détectés automatiquement en tenant compte de différents mécanismes de baseline.
Dynatrace possède des outils d'intelligence artificielle intégrés intéressants qui, sur la base de mécanismes de détection d'anomalies (baselining) et de construction d'une carte d'interaction entre tous les composants, en corrélant et en associant les événements, identifient les anomalies dans le fonctionnement de votre service et fournissent des informations détaillées sur chaque problème et sa cause profonde.
Grâce à l'analyse automatique des dépendances entre les composants, Dynatrace détermine non seulement si le service problématique est la cause principale, mais aussi sa dépendance vis-à-vis d'autres services. Dans l'exemple ci-dessous, Dynatrace surveille automatiquement et évalue la performance de chaque service au cours des transactions, identifiant le service Golang comme la cause principale.
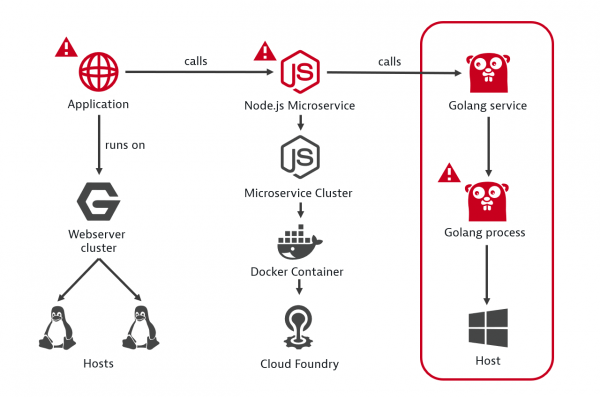 Exemple de détermination de la cause racine d'une panne.
L'illustration suivante montre le processus de surveillance des problèmes de votre application depuis le début de l'incident.
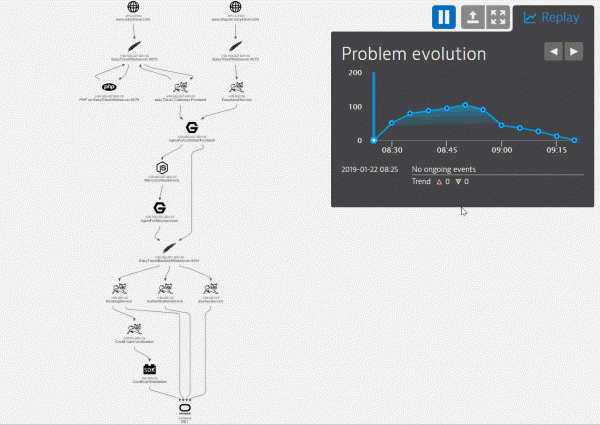 Visualisation du problème émergent avec l'affichage de tous les composants et des événements qui les concernent.
Le système de surveillance a collecté une chronologie complète des événements liés au problème survenu. Dans la fenêtre sous le graphique temporel, nous voyons tous les événements clés pour chacun des composants. Sur la base de ces événements, vous pouvez établir des procédures d'automatisation de correction sous forme de scripts de code.
Je recommande également d'intégrer le système de surveillance avec un Service Desk ou un bug tracker. En cas de problème, les développeurs reçoivent rapidement toutes les informations nécessaires à son analyse au niveau du code en environnement de production.
Conclusion
Au final, nous avons obtenu un pipeline CI/CD avec des vérifications de qualité logicielle automatisées intégrées dans le Pipeline. Nous minimisons le nombre de builds de mauvaise qualité, augmentons la fiabilité du système dans son ensemble et, en cas de défaillance, nous activons des mécanismes de récupération.
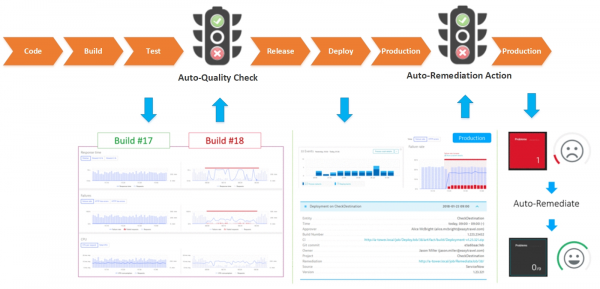
Il vaut vraiment la peine de concentrer des efforts sur l'automatisation de la surveillance de la qualité logicielle ; ce n'est pas toujours un processus rapide, mais avec le temps, il portera ses fruits. Je recommande qu'après avoir résolu un nouvel incident en production, vous réfléchissiez immédiatement aux moniteurs à ajouter pour les vérifications en environnement de test afin d'éviter qu'une mauvaise version ne pénètre en production, ainsi que d'élaborer un script pour corriger automatiquement ces problèmes.
J'espère que mes exemples vous aideront dans vos initiatives. Je serais également intéressé de voir vos exemples de métriques utilisées pour réaliser l'auto-récupération des systèmes.
Source : habr.com
