

SQL, que peut-il y avoir de plus simple ? Chacun d'entre nous peut écrire une requête basique — nous tapons select, énumérons les colonnes nécessaires, puis from, le nom de la table, quelques conditions dans où et voilà — les données utiles sont à portée de main, et ce, presque indépendamment de la base de données utilisée en dessous (ou peut-être même ). En conséquence, le travail avec pratiquement n'importe quelle source de données (relationnelle ou pas) peut être considéré sous l'angle d'un code classique (avec toutes les implications — contrôle de version, révision de code, analyse statique, tests automatisés, et tout ça). Et cela concerne non seulement les données, les schémas et les migrations, mais aussi tout le fonctionnement du stockage. Dans cet article, nous allons parler des tâches quotidiennes et des problèmes rencontrés avec diverses bases de données en mettant en avant « la base de données comme code ».
Et commençons par . Les premiers débats du genre « SQL contre ORM » ont été observés dès .
Mapping objet-relationnel
Les partisans de l'ORM apprécient traditionnellement la rapidité et la simplicité de développement, l'indépendance vis-à-vis de la base de données et la propreté du code. Pour beaucoup d'entre nous, le code de travail avec la base de données (et souvent la base de données elle-même)
semble généralement ressembler à ceci…
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
Le modèle est agrémenté d'annotations intelligentes, tandis qu'en coulisses, le valeureux ORM génère et exécute des tonnes de code SQL. À propos, les développeurs tentent par tous les moyens de se distancer de leur base de données avec des kilomètres d'abstractions, ce qui indique une certaine .
De l'autre côté des barricades, les partisans du SQL « fait main » soulignent la capacité à tirer le meilleur parti de leur base de données sans couches et abstractions supplémentaires. Ce qui donne lieu à des projets « centrés sur les données », où des personnes spécifiquement formées (elles-mêmes appelées « baseurs », « databasiens », « basoristes », etc.) s'occupent de la base, tandis que les développeurs se contentent de « tirer » les vues et procédures stockées prêtes, sans entrer dans les détails.
Que se passerait-il si nous prenions le meilleur des deux mondes ? Comme c'est le cas dans cet outil remarquable au nom affermissant . Je vais donner quelques lignes de la conception générale dans ma traduction libre, et vous pouvez vous familiariser plus en détail avec cela. .
Clojure est un langage formidable pour créer des DSL, mais SQL est déjà un excellent DSL en soi, et nous n'avons pas besoin d'un autre. Les S-expressions sont belles, mais elles n'apportent rien de nouveau ici. Au final, nous avons des parenthèses pour des parenthèses. Pas d'accord ? Alors attendez que l'abstraction sur la base de données commence à fuir, et vous commencerez à vous battre avec la fonction. (raw-sql)
Que faire ? Laissons SQL être simplement SQL — un fichier pour une requête :
-- name: users-by-country
select *
  from users
 where country_code = :country_code
… puis lisez ce fichier, en le transformant en une fonction Clojure simple :
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; Une fonction nommée `users-by-country` a été créée.
;;; Utilisons-la :
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
En respectant le principe "SQL séparé, Clojure séparé", vous obtenez :
- Pas de surprises syntaxiques. Votre base de données (comme toutes les autres) ne respecte pas le standard SQL à 100 % — mais pour Yesql, cela n'a pas d'importance. Vous ne perdrez jamais de temps à chasser des fonctions ayant une syntaxe équivalente à SQL. Vous ne serez jamais contraint de revenir à la fonction (raw-sql "some (‘funky’ :: SYNTAX)")).
- Meilleure prise en charge de l'éditeur. Votre éditeur a déjà un excellent support SQL. En conservant SQL en tant que SQL, vous pouvez simplement l'utiliser.
- Compatibilité d'équipe. Vos DBA peuvent lire et écrire SQL, que vous utilisez dans votre projet Clojure.
- Une configuration de performance plus simple. Vous devez construire un plan pour une requête problématique ? Ce n'est pas un problème lorsque votre requête est un SQL ordinaire.
- Réutilisation des requêtes. Glissez ces mêmes fichiers SQL dans d'autres projets, car ce n'est qu'un vieux bon SQL — il suffit de le partager.
À mon avis, l'idée est très cool et en même temps très simple, ce qui a permis au projet d'avoir beaucoup de dans une grande variété de langages. Et nous essaierons ensuite d'appliquer une philosophie similaire de séparation du code SQL de tout le reste, bien au-delà de l'ORM.
IDE & gestionnaires de base de données
Commençons par une tâche quotidienne simple. Souvent, nous devons rechercher certains objets dans la base de données, par exemple, trouver une table dans un schéma et examiner sa structure (les colonnes utilisées, les clés, les index, les contraintes, etc.). Et de la part de toute IDE graphique ou de tout gestionnaire de base de données, nous attendons avant tout ces capacités. Pour que cela soit rapide et que nous n'ayons pas à attendre une demi-heure qu'une fenêtre avec les informations nécessaires s'ouvre (surtout avec une connexion lente à une base de données distante), tout en veillant à ce que les informations obtenues soient fraîches et actualisées, et non pas d'anciennes données en cache. En effet, plus la base de données est complexe et volumineuse, et plus leur nombre est élevé, plus cela devient difficile.
Mais en général, je délaisse la souris et je me contente d'écrire du code. Supposons que nous devons savoir quelles tables (et avec quelles propriétés) se trouvent dans le schéma "HR". Dans la plupart des SGBD, nous pouvons obtenir le résultat souhaité avec cette simple requête depuis information_schema :
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
D'une base à l'autre, le contenu de ces tables de référence varie en fonction des capacités de chaque SGBD. Par exemple, pour MySQL, à partir de ce même répertoire, nous pouvons obtenir des paramètres spécifiques à ce SGBD pour la table :
select table_name
     , storage_engine -- Moteur utilisé ("MyISAM", "InnoDB", etc.)
     , row_format     -- Format de ligne ("Fixed", "Dynamic", etc.)
     , ...
  from information_schema.tables
 where schema = 'HR'
Oracle ne dispose pas d'information_schema, mais il possède , et il n'y a pas de grands problèmes :
select table_name
     , pct_free       -- Minimum d'espace libre dans le bloc de données (%)
     , pct_used       -- Minimum d'espace utilisé dans le bloc de données (%)
     , last_analyzed  -- Date du dernier recueil de statistiques
     , ...
  from all_tables
 where owner = 'HR'
ClickHouse n'est pas une exception :
select name
     , engine -- Moteur utilisé ("MergeTree", "Dictionary", etc.)
     , ...
  from system.tables
 where database = 'HR'
On peut faire quelque chose de similaire dans Cassandra (où il y a des columnfamilies au lieu de tables et des keyspaces au lieu de schémas) :
select columnfamily_name
     , compaction_strategy_class  -- Stratégie de compactage
     , gc_grace_seconds           -- Durée de vie des déchets
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
Pour la plupart des autres bases de données, on peut également concevoir des requêtes similaires (même dans Mongo, il existe , qui contient des informations sur toutes les collections du système).
Bien sûr, de cette manière, il est possible d'obtenir des informations non seulement sur les tables, mais aussi sur n'importe quel objet. De temps en temps, des personnes bienveillantes partagent ce type de code pour différentes bases de données, comme dans la série d'articles de Habr "Fonctions pour documenter les bases de données PostgreSQL" (, , ). Évidemment, garder toute cette montagne de requêtes en tête et les saisir constamment n'est pas vraiment un plaisir, c'est pourquoi dans mon IDE/éditeur préféré, j'ai un ensemble de snippets préparés pour les requêtes souvent utilisées, il ne reste plus qu'à saisir les noms des objets dans le modèle.
Ainsi, cette méthode de navigation et de recherche d'objets est beaucoup plus flexible, économise beaucoup de temps et permet d'obtenir précisément les informations dans la forme requise (comme décrit dans le post ).
Opérations sur les objets
Après avoir trouvé et étudié les objets nécessaires, il est temps de faire quelque chose d'utile avec eux. Naturellement, sans quitter le clavier.
Il n'est pas secret qu'il suffit de supprimer une table pour que cela ressemble presque pareil dans toutes les bases de données :
drop table hr.personsMais la création d'une table est déjà plus intéressante. Pratiquement tous les SGBD (y compris de nombreux NoSQL) savent, sous une forme ou une autre, exécuter "create table", et la majeure partie diffère peu (le nom, la liste des colonnes, les types de données), mais les autres détails peuvent varier considérablement en fonction de l'architecture interne et des possibilités de chaque SGBD. Mon exemple préféré – dans la documentation d'Oracle, il n'y a que des BNF "nues" pour la syntaxe "create table" . D'autres SGBD possèdent des fonctionnalités plus modestes, mais chacune d'elles a également de nombreuses caractéristiques intéressantes et uniques pour la création de tables (, , , ). Il est peu probable qu'un quelconque "assistant" graphique d'un énième IDE (surtout s'il est polyvalent) puisse couvrir toutes ces capacités de manière complète, et même s'il le pouvait, ce ne serait pas un spectacle pour les âmes sensibles. En même temps, un bon opérateur écrit au bon moment create table permettra de bénéficier facilement de tout cela, rendant le stockage et l'accès à vos données fiables, optimaux et aussi confortables que possible.
De nombreuses bases de données ont également leurs propres types d'objets spécifiques, qui sont absents dans d'autres bases de données. Nous pouvons effectuer des opérations non seulement sur les objets de la base de données, mais aussi sur la base de données elle-même, par exemple "terminer" un processus, libérer une zone de mémoire, activer le mode de traçage, passer en mode "lecture seule" et bien plus encore.
Et maintenant, dessinons un peu.
L'une des tâches les plus courantes consiste à construire un diagramme avec des objets de base de données, pour voir sur une belle image les objets et les liaisons entre eux. Pratiquement toutes les IDE graphiques, certaines utilitaires « ligne de commande », des outils graphiques spécialisés et des modélisateurs peuvent le faire. Ils vous dessineront « comme ils peuvent », et vous pourrez influencer un peu ce processus uniquement à l'aide de quelques paramètres dans le fichier de configuration ou de cases à cocher dans l'interface.
Mais ce problème peut être résolu de manière beaucoup plus simple, flexible et élégante, bien sûr, à l'aide de code. Pour construire des diagrammes de toute complexité, nous disposons de plusieurs langages de balisage spécialisés (DOT, GraphML, etc.), accompagnés d'une multitude d'applications (GraphViz, PlantUML, Mermaid), qui peuvent lire de telles instructions et les visualiser dans divers formats. Et nous savons déjà comment obtenir des informations sur les objets et les liaisons entre eux.
Prenons un petit exemple de ce à quoi cela pourrait ressembler, en utilisant PlantUML et (à gauche, la requête SQL qui générera l'instruction nécessaire pour PlantUML, et à droite, le résultat :)
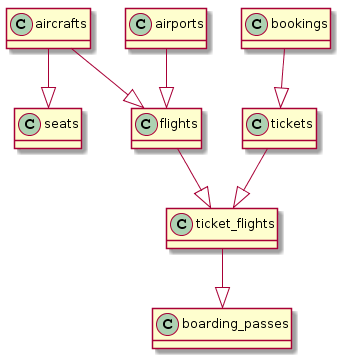
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
Et si l'on s'applique un peu, on peut obtenir quelque chose de très proche d'un vrai diagramme ER basé sur Il est possible d'obtenir quelque chose de fortement similaire à un véritable diagramme ER.
Une requête SQL un peu plus compliquée.
-- En-tête
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Tables
select format('Table(%s, "%s n information about %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Relations entre les tables
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "Un %s peut avoir plusieurs %s"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Pied de page
select '@enduml' 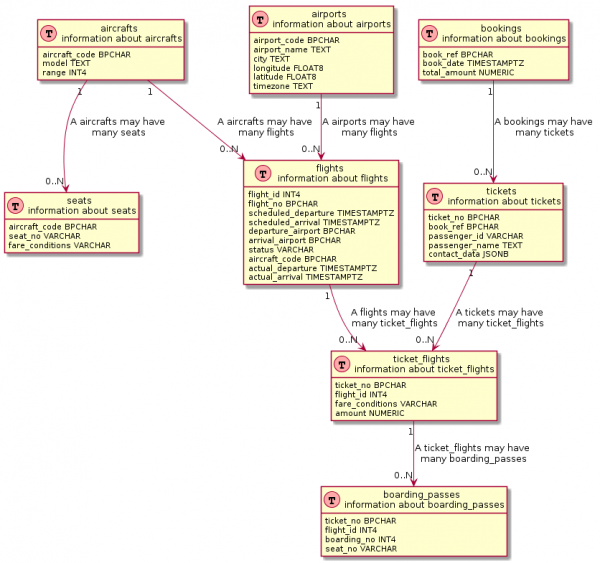
Si l'on regarde de près, de nombreux outils de visualisation utilisent également des requêtes similaires. Cependant, ces requêtes sont généralement profondément , sans parler de leur modification.
Métriques et surveillance.
Passons à un sujet traditionnellement complexe : la surveillance des performances des bases de données. Je me souviens d'une petite histoire vraie racontée par "un de mes amis". Dans un projet, il y avait un DBA tout puissant, et peu de développeurs le connaissaient personnellement, voire l'avaient jamais vu (bien qu'il travaillait, selon les rumeurs, quelque part dans le bâtiment voisin). À l'heure "X", lorsque le système de production d'un grand détaillant commençait à "avoir des problèmes", il envoyait en silence des captures d'écran des graphiques d'Oracle Enterprise Manager, mettant en évidence les points critiques en rouge pour "la clarté" (ce qui, pour le dire doucement, aidait peu). Et c'était à partir de cette "photo" qu'il fallait guérir. Personne n'avait accès au précieux (au sens propre comme au figuré) Enterprise Manager, car le système était complexe et coûteux ; après tout, "les devs pourraient cliquer sur quelque chose et tout casser". Les développeurs trouvaient donc par des méthodes "empiriques" l'emplacement et la cause des ralentissements, et sortaient un patch. Si une lettre menaçante du DBA ne revenait pas dans peu de temps, tout le monde respirait un soupir de soulagement et retournait à ses tâches en cours (jusqu'à la prochaine lettre).
Mais le processus de surveillance peut être plus joyeux et amical, et surtout — accessible et transparent pour tous. Au moins sa partie basique, en complément des systèmes de surveillance principaux (qui sont sans aucun doute utiles et souvent indispensables). Toute base de données est prête à partager librement et complètement sans frais des informations sur son état actuel et ses performances. Dans la même "sanguinaire" Oracle DB, presque toutes les informations sur les performances peuvent être obtenues à partir des vues système, allant des processus et sessions à l'état du cache tampon (par exemple, , section "Surveillance"). Dans PostgreSQL, il existe également un éventail complet de vues système pour , y compris des vues essentielles pour la vie quotidienne de tout DBA, telles que , , . Dans MySQL, il existe même un schéma distinct . Et dans Mongo, un agrège les données de performance dans une collection système .
Ainsi, en utilisant un collecteur de métriques (Telegraf, Metricbeat, Collectd) capable d'exécuter des requêtes SQL personnalisées, un stockage de ces métriques (InfluxDB, Elasticsearch, Timescaledb) et un visualiseur (Grafana, Kibana), on peut obtenir un système de surveillance assez léger et flexible, qui s'intégrera étroitement avec d'autres métriques système générales (obtenues, par exemple, à partir du serveur d'applications, du système d'exploitation, etc.). C'est, par exemple, ce qui est réalisé dans pgwatch2, où une combinaison InfluxDB + Grafana et un ensemble de requêtes aux vues systémiques sont utilisés, auxquels on peut également .
Au total
Et c’est seulement une liste approximative de ce que l’on peut faire avec notre base de données en utilisant du code SQL standard. Je suis sûr qu'il existe de nombreuses autres applications, n'hésitez pas à les partager dans les commentaires. Quant à comment (et surtout pourquoi) automatiser tout cela et l'intégrer dans votre pipeline CI/CD, nous en parlerons la prochaine fois.
Source : habr.com
