

DataHub open source : plateforme de recherche et de découverte de métadonnées de LinkedIn
Une recherche rapide des données nécessaires est essentielle pour toute entreprise qui s'appuie sur un grand volume de données pour prendre des décisions basées sur celles-ci. Cela affecte non seulement la productivité des utilisateurs de données (y compris les analystes, les développeurs de machine learning, les spécialistes du traitement des données et les ingénieurs en données), mais a également un impact direct sur les produits finaux qui dépendent d'un pipeline de machine learning (ML) de haute qualité. De plus, la tendance à adopter ou à créer des plateformes de machine learning soulève naturellement la question : quelle est votre méthode pour la découverte interne des fonctionnalités, des modèles, des indicateurs, des ensembles de données, etc.
Dans cet article, nous vous expliquerons comment nous avons publié sous une licence ouverte notre source de données dans notre plateforme de recherche et de découverte de métadonnées, depuis les premiers jours du projet . LinkedIn maintient sa propre version de DataHub distincte de la version open source. Nous commencerons par expliquer pourquoi nous avons besoin de deux environnements de développement distincts, puis nous discuterons de nos premières approches pour utiliser WhereHows en open source et comparerons notre version interne (de production) de DataHub avec la version sur . Nous partagerons également les détails concernant notre nouvelle solution automatisée pour envoyer et recevoir des mises à jour en open source afin de synchroniser les deux dépôts. Enfin, nous fournirons des instructions sur la façon de commencer à utiliser DataHub en open source et discuterons brièvement de son architecture.
WhereHows est désormais DataHub !
L'équipe de métadonnées de LinkedIn avait précédemment présenté (le successeur de WhereHows), la plateforme de recherche et de découverte de métadonnées de LinkedIn, et a partagé ses plans pour l'ouvrir. Peu après cette annonce, nous avons publié une version alpha de DataHub et l'avons partagée avec la communauté. Depuis, nous contribuons régulièrement au dépôt et travaillons avec les utilisateurs intéressés pour ajouter les fonctionnalités les plus demandées et résoudre les problèmes. Nous sommes maintenant ravis d'annoncer la sortie officielle de .
Approches open source
WhereHows, le portail original de LinkedIn pour la recherche de données et leur provenance, a été lancé comme un projet interne ; l'équipe de métadonnées a ouvert son . Depuis lors, l'équipe a toujours maintenu deux bases de code distinctes : l'une pour le code source ouvert et l'autre pour un usage interne chez LinkedIn, car toutes les fonctionnalités du produit conçues pour les cas d'utilisation de LinkedIn n'étaient pas toujours applicables à un public plus large. De plus, WhereHows a certaines dépendances internes (infrastructure, bibliothèques, etc.) dont le code source n'est pas ouvert. Au fil des ans, WhereHows a subi de nombreuses itérations et cycles de développement, rendant la synchronisation des deux bases de code un grand défi. L'équipe des métadonnées a tenté pendant des années d'utiliser différentes approches pour essayer de synchroniser le développement interne et le développement open source.
Première tentative : « D'abord le code ouvert »
Initialement, nous avons suivi un modèle de développement « d'abord le code source ouvert », où le développement principal se déroule dans un dépôt de code source ouvert, et des modifications sont apportées pour le déploiement interne. Le problème avec cette approche était que le code est toujours d'abord envoyé sur GitHub avant d'être entièrement vérifié en interne. Tant que les modifications du dépôt de code source ouvert n'étaient pas appliquées et qu'un nouveau déploiement interne n'était pas effectué, nous ne détecterions aucun problème de production. En cas de déploiement problématique, il était également très difficile de déterminer le coupable, car les modifications étaient apportées par lots.
De plus, ce modèle a réduit la productivité de l'équipe lors du développement de nouvelles fonctionnalités nécessitant des itérations rapides, car il obligeait à placer toutes les modifications d'abord dans le dépôt de code source ouvert, puis à les transférer dans le dépôt interne. Pour réduire le temps de traitement, toute correction ou modification pouvait être effectuée d'abord dans le dépôt interne, mais cela est devenu un énorme problème lors de la fusion de ces modifications dans le dépôt de code source ouvert, car les deux dépôts étaient désynchronisés.
Ce modèle est beaucoup plus facile à mettre en œuvre pour les plateformes communes, les bibliothèques ou les projets d'infrastructure que pour des applications web utilisateur entièrement fonctionnelles. De plus, ce modèle est idéal pour les projets qui commencent avec du code source ouvert dès le premier jour, mais WhereHows a été créé comme une application web entièrement interne. Il a été vraiment difficile de s'abstraire complètement de toutes les dépendances internes, donc nous avons dû conserver un fork interne, mais conserver un fork interne tout en développant principalement avec du code source ouvert n'a pas vraiment fonctionné.
Seconde tentative : « D'abord interne »
** En tant que seconde tentative, nous sommes passés à un modèle de développement « d'abord interne », où le développement principal se fait au sein de l'entreprise et les modifications sont régulièrement apportées au code source ouvert. Bien que ce modèle convienne le mieux à notre cas d'utilisation, il présente des problèmes. Envoyer directement toutes les différences dans le dépôt de code source ouvert, puis essayer de résoudre les conflits de fusion par la suite est une option, mais cela prend beaucoup de temps. Les développeurs essaient dans la plupart des cas d'éviter cela à chaque révision de code. Par conséquent, cela sera effectué beaucoup plus rarement, par lots, rendant ainsi plus difficile la résolution ultérieure des conflits de fusion.
Troisième fois, c'était la bonne !
Les deux tentatives infructueuses mentionnées ci-dessus ont conduit à ce que le dépôt WhereHows sur GitHub soit obsolète pendant un long moment. L'équipe a continué à affiner les fonctionnalités et l'architecture du produit, donc la version interne de WhereHows pour LinkedIn devenait de plus en plus aboutie que la version open source. Elle avait même un nouveau nom — DataHub. Sur la base des précédentes tentatives infructueuses, l'équipe a décidé de développer une solution évolutive et à long terme.
Pour tout nouveau projet à code source ouvert, l'équipe de développement open source de LinkedIn conseille et soutient un modèle de développement où les modules du projet sont entièrement développés en open source. Les artefacts avec prise en charge des versions sont déployés dans un dépôt public, puis renvoyés dans l'artefact interne de LinkedIn via Suivre ce modèle de développement n'est pas seulement bénéfique pour les utilisateurs de code ouvert, mais cela mène également à la création d'une architecture plus modulaire, extensible et intégrable.
Cependant, pour atteindre cet état pour une application interne mature comme DataHub, un temps considérable sera nécessaire. Cela exclut aussi la possibilité d'une mise en œuvre entièrement fonctionnelle en code ouvert avant que toutes les dépendances internes soient complètement abstraites. C'est pourquoi nous avons développé des outils qui nous aident à contribuer au code ouvert de manière plus rapide et beaucoup moins douloureuse. Cette solution est avantageuse tant pour l'équipe des métadonnées (développeur de DataHub) que pour la communauté du code ouvert. Les sections suivantes discuteront de cette nouvelle approche.
Automatisation de la publication en code ouvert
La dernière approche du groupe de métadonnées pour DataHub en code ouvert consiste à développer un outil qui synchronise automatiquement la base de code interne avec le dépôt de code ouvert. Les fonctionnalités de haut niveau de cet outil comprennent :
- Synchronisation du code LinkedIn avec / depuis le code ouvert, similaire à .
- La génération d'en-têtes de licence, similaire à .
- Création automatique de journaux de commits de code ouvert à partir des journaux de commits internes.
- Prévention des modifications internes qui interfèrent avec la construction du code ouvert par .
Les sections suivantes exploreront en détail les fonctionnalités susmentionnées, qui posent des problèmes intéressants.
Synchronisation du code source
Contrairement à la version de DataHub en code ouvert, qui est un dépôt unique sur GitHub, la version de DataHub pour LinkedIn est une combinaison de plusieurs dépôts (interne au sein de l'entreprise appelée ). L'interface de DataHub, la bibliothèque de modèles de métadonnées, le service de stockage de métadonnées et les tâches de streaming sont présents dans différents dépôts chez LinkedIn. Cependant, pour faciliter la tâche aux utilisateurs du code ouvert, nous avons un dépôt unique pour la version de DataHub en code ouvert.
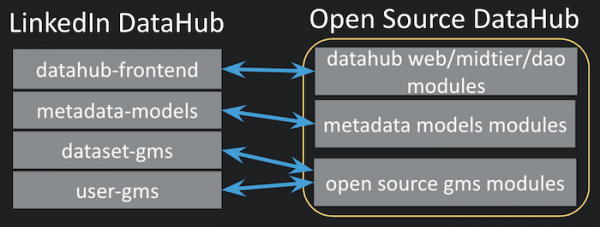
Figure 1 : Synchronisation entre les dépôts LinkedIn DataHub et un dépôt unique DataHub en code ouvert
Pour prendre en charge les flux de travail automatisés de construction, d'envoi et d'extraction, notre nouvel outil crée automatiquement un mappage au niveau des fichiers correspondant à chaque fichier source. Cependant, l'outil nécessite une configuration initiale, et les utilisateurs doivent fournir une vue d'ensemble des modules, comme indiqué ci-dessous.
{
  "datahub-dao": [
    "${datahub-frontend}/datahub-dao"
  ],
  "gms/impl": [
    "${dataset-gms}/impl",
    "${user-gms}/impl"
  ],
  "metadata-dao": [
    "${metadata-models}/metadata-dao"
  ],
  "metadata-builders": [
    "${metadata-models}/metadata-builders"
  ]
}
Le mappage au niveau des modules est un JSON simple, dont les clés sont les modules cibles dans le dépôt open source et les valeurs sont des listes de modules sources dans les dépôts LinkedIn. Tout module cible dans le dépôt open source peut être alimenté par n'importe quel nombre de modules sources. Pour désigner les noms internes des dépôts dans les modules sources, on utilise au style Bash. En utilisant le fichier de mappage au niveau des modules, les outils créent un fichier de mappage au niveau des fichiers en scannant tous les fichiers dans les répertoires liés.
{
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Foo.java":
"metadata-builders/src/main/java/com/linkedin/Foo.java",
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Bar.java":
"metadata-builders/src/main/java/com/linkedin/Bar.java",
  "${metadata-models}/metadata-builders/build.gradle": null,
}
Le mappage au niveau des fichiers est créé automatiquement par les outils ; cependant, il peut également être mis à jour manuellement par l'utilisateur. Ce mappage est un 1:1 du fichier source LinkedIn avec un fichier dans le dépôt open source. Il existe plusieurs règles concernant cette création automatique de mappage des fichiers :
- En cas de plusieurs modules sources pour un module cible dans le code source ouvert, des conflits peuvent survenir, par exemple, le même , existant dans plus d'un module source. Comme stratégie de résolution des conflits, nos outils utilisent par défaut l'option « dernier gagnant ».
- "null" signifie que le fichier source ne fait pas partie du dépôt open source.
- Après chaque envoi dans le code source ouvert ou extraction, cette correspondance est automatiquement mise à jour et un instantané est créé. Cela est nécessaire pour identifier les ajouts et suppressions de code source après la dernière action.
Création de journaux de commits
Les journaux de commits pour les commits de code source ouvert sont également créés automatiquement en combinant les journaux de commits des dépôts internes. Voici un exemple de journal de commit pour montrer la structure d'un journal de commit créé par notre outil. Le commit indique clairement quelles versions des dépôts sources sont emballées dans ce commit et fournit un résumé des informations du journal de commits. Vérifiez ce sur un exemple réel de journal de commit généré par notre outil.
metadata-models 29.0.0 -> 30.0.0
    Modèle d'aspect foo ajouté
    Problème bar corrigé

dataset-gms 2.3.0 -> 2.3.4
    API rest.li ajoutée pour servir l'aspect foo

MP_VERSION=dataset-gms:2.3.4
MP_VERSION=metadata-models:30.0.0
Tests de dépendance
LinkedIn dispose d , qui aide à garantir que les modifications internes aux multiproduits ne perturbent pas la construction des multiproduits dépendants. Le dépôt DataHub en code source ouvert n’est pas un multiproduit et ne peut pas être une dépendance directe d’un multiproduit, mais grâce à une coque multiproduit qui extrait le code source open-source de DataHub, nous pouvons tout de même utiliser ce système de tests de dépendance. Ainsi, toute modification (qui sera probablement ouverte plus tard) dans l'un des multiproduits qui alimentent le dépôt DataHub open-source déclenche un événement de construction dans la coque multiproduit. Par conséquent, toute modification qui ne permet pas la construction de la coque multiproduit ne passe pas les tests avant le commit de l'ancien multiproduit et est rejetée.
C'est un mécanisme utile qui aide à prévenir tout commit interne qui perturbe la construction du code source ouvert et à le détecter lors de la création du commit. Sans cela, il serait assez difficile de déterminer quel commit interne a causé l'échec de la construction du dépôt open-source, car nous plaçons des modifications internes batchées dans le dépôt DataHub open-source.
Différences entre DataHub open source et notre version de production
Jusqu'à présent, nous avons discuté de notre solution pour synchroniser les deux versions des dépôts DataHub, mais nous n'avons pas encore précisé les raisons pour lesquelles nous avons besoin de deux flux de développement différents. Dans cette section, nous énumérerons les différences entre la version publique de DataHub et la version de production sur les serveurs LinkedIn, ainsi que les raisons de ces différences.
Une des sources de divergence provient du fait que notre version de production dépend de code non open source, tel que Offspring de LinkedIn (la structure d'implémentation interne des dépendances de LinkedIn). Offspring est largement utilisé dans la base de code interne, car c'est la méthode privilégiée de gestion de la configuration dynamique. Mais cela n'est pas open source; donc, nous avons dû trouver des alternatives open source pour DataHub open source.
Il y a aussi d'autres raisons. À mesure que nous développons des extensions du modèle de métadonnées pour les besoins de LinkedIn, ces extensions sont généralement très spécifiques à LinkedIn et peuvent ne pas être directement applicables à d'autres environnements. Par exemple, nous avons des étiquettes très spécifiques pour les identifiants des participants et d'autres types de métadonnées de correspondance. Ainsi, nous avons actuellement exclu ces extensions du modèle de métadonnées de DataHub open source. Au fur et à mesure que nous interagissons avec la communauté et comprenons leurs besoins, nous travaillerons sur des versions communes de ces extensions open source lorsque cela sera nécessaire.
La facilité d'utilisation et une adaptation plus facile pour la communauté open source ont également inspiré certaines différences entre les deux versions de DataHub. Les différences dans l'infrastructure de traitement en continu en sont un bon exemple. Bien que notre version interne utilise une infrastructure de traitement en continu gérée, nous avons choisi d'utiliser un traitement en continu intégré (autonome) pour la version open source, car cela évite de créer une nouvelle dépendance infrastructurelle.
Un autre exemple de différence est la présence d'un seul GMS (Stockage Générique de Métadonnées) dans l'implémentation open source, au lieu de plusieurs GMS. GMA (Architecture Générique de Métadonnées) est le nom de l'architecture interne pour DataHub, tandis que GMS est le stockage de métadonnées dans le contexte de GMA. GMA est une architecture très flexible qui vous permet de répartir chaque structure de données (comme des ensembles de données, des utilisateurs, etc.) dans son propre stockage de métadonnées, ou de stocker plusieurs structures de données dans un même stockage de métadonnées tant que le registre contenant le mappage de la structure de données dans GMS est mis à jour. Pour simplifier l'utilisation, nous avons choisi une seule instance de GMS qui stocke toutes les différentes structures de données dans DataHub open source.
La liste complète des différences entre les deux implémentations est présentée dans le tableau ci-dessous.
Caractéristiques du produit
LinkedIn DataHub
Open Source DataHub
Structures de données prises en charge
1) Ensembles de données 2) Utilisateurs 3) Métriques 4) Fonctionnalités ML 5) Graphiques 6) Tableaux de bord
1) Ensembles de données 2) Utilisateurs
Sources de métadonnées prises en charge pour les ensembles de données
1) 2) Couchbase 3) 4) 5) HDFS 6) Hive 7) Kafka 8) MongoDB 9) MySQL 10) Oracle 11) 12) Presto 12) 13) Teradata 13) Vector 14)
Hive Kafka RDBMS
Pub-sub
Confluent Kafka
Traitement de flux
Géré
Incorporé (indépendant)
Injection de dépendances & Configuration dynamique
LinkedIn Offspring
Outils de construction
Ligradle (wrapper Gradle interne de LinkedIn)
CI/CD
CRT (CI/CD interne de LinkedIn)
and
Magasins de métadonnées
GMS distribués multiples : 1) GMS d'ensemble de données 2) GMS d'utilisateur 3) GMS de métriques 4) GMS de fonctionnalités 5) GMS de graphiques/tableaux de bord
GMS unique pour : 1) Ensembles de données 2) Utilisateurs
Microservices dans des conteneurs Docker
facilite le déploiement et la distribution des applications grâce à . Chaque partie du service dans DataHub open source, y compris les composants d'infrastructure comme Kafka, , et , a sa propre image Docker. Pour l'orchestration des conteneurs Docker, nous avons utilisé .
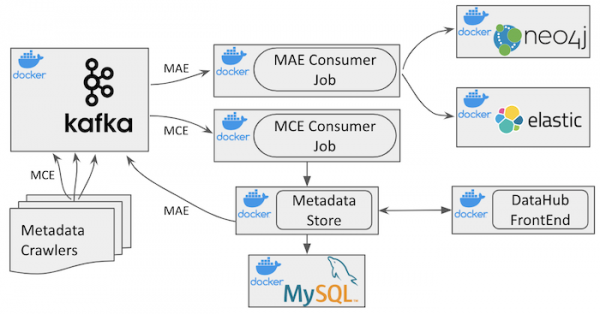
Figure 2 : Architecture DataHub *open source*
Vous pouvez voir l'architecture de haut niveau de DataHub sur l'image ci-dessus. En plus des composants d'infrastructure, elle comprend quatre conteneurs Docker différents :
datahub-gms : service de stockage de métadonnées
datahub-frontend : application , desservant l'interface de DataHub.
datahub-mce-consumer : application , qui utilise le flux d'événements de changement de métadonnées (MCE) et met à jour le stockage de métadonnées.
datahub-mae-consumer : application , qui utilise le flux d'événements d'audit de métadonnées (MAE) et crée une base de données d'index de recherche et de graphe.
Documentation sur le dépôt open source et contiennent des informations plus détaillées sur les fonctionnalités de divers services.
CI / CD dans DataHub avec code source ouvert
Le dépôt DataHub avec code source ouvert utilise pour l'intégration continue et pour le déploiement continu. Les deux offrent une bonne intégration avec GitHub et sont faciles à configurer. Pour la majeure partie de l'infrastructure à code source ouvert, développée par la communauté ou des entreprises privées (par exemple, ), des images Docker ont été créées et elles sont déployées sur Docker Hub pour faciliter l'utilisation par la communauté. Toute image Docker trouvée sur Docker Hub peut être facilement utilisée avec une simple commande .
À chaque commit dans le dépôt de code source ouvert de DataHub, toutes les images Docker sont automatiquement créées et déployées sur Docker Hub avec le tag "latest". Si un certain , tous les tags dans le dépôt de code source ouvert sont également publiés avec les noms de tags correspondants sur Docker Hub.
Utiliser DataHub
est très simple et se compose de trois étapes faciles :
- Clonez le dépôt de code source ouvert et exécutez tous les conteneurs Docker avec docker-compose à l'aide du script docker-compose fourni pour un démarrage rapide.
- Téléchargez des exemples de données disponibles dans le dépôt à l'aide de l'outil en ligne de commande qui est également fourni.
- Consultez DataHub dans votre navigateur.
Un est également configuré pour des questions rapides. Les utilisateurs peuvent également créer des problèmes directement dans le dépôt GitHub. Surtout, nous accueillons et apprécions tous les retours et suggestions !
Plans pour l'avenir
Actuellement, chaque infrastructure ou microservice pour DataHub avec code source ouvert est construit comme un conteneur Docker, et tout le système est orchestré avec . Étant donné la popularité et la large adoption , nous aimerions également fournir une solution basée sur Kubernetes dans un avenir proche.
Nous prévoyons également de fournir une solution prête à l'emploi pour le déploiement de DataHub dans un service cloud public comme , ou . Étant donné la récente annonce de LinkedIn concernant la migration vers Azure, cela correspondrait aux priorités internes du groupe de métadonnées.
Et enfin, mais non des moindres : merci à tous les premiers utilisateurs de DataHub dans la communauté open source qui ont apprécié les versions alpha de DataHub et nous ont aidés à identifier les problèmes et à améliorer la documentation.
Source : habr.com
