

Lors du traitement complexe de grands ensembles de données (divers : importations, conversions et synchronisations avec une source externe), il est souvent nécessaire de « mémoriser » temporairement et de traiter rapidement quelque chose de volumineux.
Une tâche typique de ce type est généralement formulée comme suit : « Voici ce que des derniers paiements reçus, il faut les télécharger rapidement sur le site et les lier aux comptes »
Mais lorsque le volume de ce « quelque chose » commence à atteindre des centaines de mégaoctets, et que le service doit continuer à fonctionner avec une base de données en mode 24×7, de nombreux effets secondaires apparaissent qui compliquent la vie.
Pour y faire face dans PostgreSQL (et pas seulement dans ce système), il est possible d'utiliser certaines capacités d'optimisation qui permettront de traiter le tout plus rapidement et avec moins de ressources.
1. Où charger ?
Commençons par déterminer où nous pouvons charger les données que nous souhaitons « traiter ».
1.1. Tables temporaires (TEMPORARY TABLE)
En principe, pour PostgreSQL, les tables temporaires sont comme toutes les autres tables. Par conséquent, les superstitions du type « là, tout est stocké uniquement en mémoire, et elle peut se remplir »sont incorrectes. Mais il existe également quelques différences essentielles.
Un « espace de noms » pour chaque connexion à la BDD
Si deux connexions tentent d'exécuter simultanément CREATE TABLE x, alors quelqu'un recevra certainement une erreur d'unicité des objets de la BDD.
En revanche, si les deux tentent d'exécuter CREATE TEMPORAIRE TABLE x, alors les deux le feront normalement, et chacun recevra sa propre instance de la table. Et il n'y aura rien en commun entre elles.
« Auto-destruction » lors de la déconnexion
Lors de la fermeture de la connexion, toutes les tables temporaires sont automatiquement supprimées, donc il n'y a aucun sens à exécuter DROP TABLE x , à part…
Si vous travaillez via pgbouncer en mode transactionnel, alors la base continue de penser que cette connexion est toujours active, et cette table temporaire existe toujours dans celle-ci.
Donc, essayer de la créer à nouveau, déjà à partir d'une autre connexion à pgbouncer, entraînera une erreur. Mais cela peut être contourné en utilisant CRÉER UNE TABLE TEMPORAIRE SI NON EXISSE x.
Il est vrai que mieux vaut ne pas faire cela, car vous pourriez alors « découvrir par surprise » des données laissées par le « précédent propriétaire ». Il est bien mieux de lire le manuel et de voir qu'il est possible d'ajouter des options lors de la création de la table. EN REMPLACEMENT DROP — c'est-à-dire qu'à la fin de la transaction, la table sera automatiquement supprimée.
Non-réplication
En raison de son appartenance à une seule connexion, les tables temporaires ne sont pas répliquées. Mais cela élimine le besoin d'écrire les données deux fois dans le heap + WAL, rendant ainsi les INSERT/UPDATE/DELETE beaucoup plus rapides.
Mais puisque la temporaire est tout de même une « presque ordinaire » table, il n’est pas possible de la créer sur la réplique non plus. Du moins, pas pour le moment, bien qu'un patch correspondant circule depuis longtemps.
1.2. Tables non journalisées (UNLOGGED TABLE)
Mais que faire, par exemple, si vous avez un processus ETL lourd, qui ne peut pas être réalisé dans le cadre d'une seule transaction, et que vous avez quand même pgbouncer en mode transactionnel?..
Ou si le flux de données est si important que la bande passante d'une seule connexion avec la base de données (lire, un processus sur le CPU) n'est pas suffisante ?..
Ou certaines opérations se déroulent de manière asynchrone dans différentes connexions ?..
Il n'y a qu'une seule option ici — créer temporairement une table non temporaire. Un jeu de mots, n'est-ce pas. En d'autres termes :
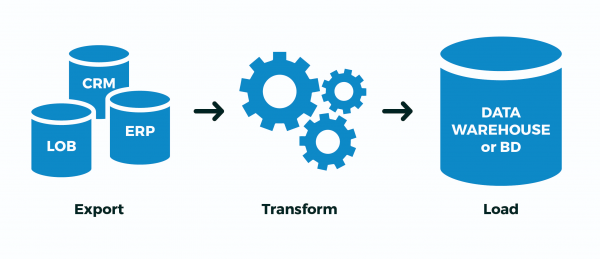
- j'ai créé « mes » tables avec des noms aussi aléatoires que possible, pour ne pas croiser celles des autres
- Extraire: j'y ai chargé des données provenant d'une source externe
- Transformer: j'ai traité, rempli les champs de liaison clés
- Charge: j'ai transféré les données prêtes dans les tables cibles
- j'ai supprimé « mes » tables
Et maintenant — une mauvaise nouvelle. En essence, toute écriture dans PostgreSQL se produit deux fois — , puis dans les corps des tables/indices. Tout cela est fait pour prendre en charge ACID et garantir la visibilité correcte des données entre COMMITles transactions imbriquées et ROLLBACKles transactions imbriquées.
Mais nous n'avons pas besoin de cela ! Tout notre processus a soit entièrement réussi, soit échoué.. Peu importe combien de transactions intermédiaires il y aura — nous ne sommes pas intéressés par « continuer le processus à partir du milieu », surtout quand il est difficile de savoir où il en était.
Pour cela, les développeurs de PostgreSQL ont introduit dès la version 9.1 quelque chose appelé :
Avec cette option, la table est créée comme non journalisée. Les données écrites dans des tables non journalisées ne passent pas par le journal de pré-écriture (cf. Chapitre 29), ce qui fait que ces tables fonctionnent beaucoup plus rapidement que les normales.Cependant, elles ne sont pas protégées contre les pannes ; en cas de panne ou de coupure accidentelle du serveur, la table non journalisée est automatiquement tronquée.De plus, le contenu d'une table non journalisée n'est pas répliqué. sur des serveurs responsables. Tous les index créés pour une table non journalisée deviennent automatiquement non journalisés.
En résumé, cela sera beaucoup plus rapide, mais si le serveur de base de données « tombe » - cela peut être désagréable. Mais cela arrive-t-il souvent, et votre processus ETL sait-il le gérer correctement « à partir du milieu » après le « réveil » de la base de données ?..
Si ce n'est pas le cas et que le cas ci-dessus ressemble au vôtre - utilisez UNLOGGED, mais ne jamais activer cet attribut sur des tables réelles, dont les données vous sont précieuses.
1.3. ON COMMIT { DELETE ROWS | DROP }
Cette construction permet de définir un comportement automatique lors de la fin de la transaction lors de la création de la table.
À propos de EN REMPLACEMENT DROP comme je l'ai déjà mentionné, elle génère DROP TABLE, mais ici avec EN REMPLACEMENT SUPPRIMER DES LIGNES la situation est plus intéressante - ici cela génère TRUNCATE TABLE.
Étant donné que toute l'infrastructure de stockage de la méta-description de la table temporaire est exactement la même que celle de la table normale, la création et la suppression constantes de tables temporaires entraînent un important « gonflement » des tables système pg_class, pg_attribute, pg_attrdef, pg_depend,…
Maintenant imaginez que vous avez un worker avec une connexion directe à la base de données, qui ouvre une nouvelle transaction chaque seconde, crée, remplit, traite et supprime une table temporaire… Des déchets s'accumuleront en excès dans les tables système, ce qui provoquera des ralentissements supplémentaires à chaque opération.
En général, ne faites pas cela ! Dans ce cas, il est beaucoup plus efficace CREATE TEMPORARY TABLE x ... ON COMMIT DELETE ROWS de le faire en dehors de la boucle des transactions - alors au début de chaque nouvelle transaction, les tables existeront déjà existera (économisons l'appel CREATE), mais elle sera vide, grâce à TRUNCATE (nous avons aussi économisé son appel) à la fin de la transaction précédente.
1.4. LIKE… INCLUDING …
Je l'ai mentionné au début, l'un des cas d'utilisation typiques pour les tables temporaires est les différents types d'importations - et le développeur copie et colle fatigué la liste des champs de la table cible dans la déclaration de sa table temporaire…
Mais la paresse est le moteur du progrès ! Donc vous pouvez créer une nouvelle table « à partir d'un modèle » beaucoup plus facilement :
CREATE TEMPORARY TABLE import_table(
  LIKE target_table
);
Étant donné que beaucoup de données peuvent ensuite être générées dans cette table, les recherches à son sujet ne seront absolument pas rapides. Mais il y a une solution traditionnelle à cela - les index ! Et, oui, une table temporaire peut aussi avoir des index.
Comme souvent, les index nécessaires coïncident avec les index de la table cible, il suffit d'écrire LIKE target_table Y COMPRIS INDEXES.
Si vous avez aussi besoin de DEFAULT- valeurs (par exemple, pour remplir les valeurs de la clé primaire), vous pouvez utiliser LIKE target_table Y COMPRIS LES DÉFAUTS. Ou simplement — LIKE target_table Y COMPRIS TOUT — copiera les valeurs par défaut, les index, les contraintes,…
Mais ici, il faut déjà comprendre que si vous avez créé une table d'importation directement avec des index, le chargement des données prendra plus de temps, que si vous chargez d'abord toutes les données, puis appliquez les index — regardez par exemple comment cela fait .
En général, !
2. Comment écrire ?
Je vais dire simplement — utilisez - flux au lieu de 'paquet' INSERT, . Vous pouvez même le faire directement à partir d'un fichier préalablement préparé.
3. Comment traiter ?
Ainsi, supposons que notre situation de départ ressemble à peu près à cela :
- vous avez une table dans la base contenant les données clients avec 1M d'enregistrements
- chaque jour le client vous envoie un nouveau image complète
- d'après l'expérience, vous savez que, d'une fois à l'autre, il ne change pas plus de 10K enregistrements
Un exemple classique de cette situation est — il y a beaucoup d'adresses, mais dans chaque extraction hebdomadaire de changements (renommage de localités, fusion de rues, apparition de nouveaux bâtiments), il y a très peu de changements même à l'échelle du pays.
3.1. Algorithme de synchronisation complète
Pour simplifier, supposons que vous n'avez même pas besoin de restructurer les données — il suffit de mettre la table dans le format requis, c'est-à-dire :
- à supprimer tout ce qui n'existe plus
- Les options pour les processeurs «Elbrus» sont disponibles sur tout ce qui existait déjà et doit être mis à jour
- insérer tout ce qui n'existait pas encore
Pourquoi effectuer les opérations dans cet ordre ? Parce que c'est précisément ainsi que la taille de la table augmentera au minimum ().
DELETE FROM dst
Non, bien sûr, il est possible de se contenter de deux opérations uniquement :
- à supprimer (
SUPPRIMER) la table entière - insérer tout du nouvel ensemble d'enregistrements
Mais en même temps, grâce au MVCC, la taille de la table doublera exactement! Obtenir +1M d'images d'enregistrements dans la table à cause de la mise à jour de 10K — ce n'est pas la redondance idéale…
TRUNCATE dst
Un développeur plus expérimenté sait qu'il est possible de nettoyer toute la table à un coût raisonnable :
- effacer (
TRUNCATE) la table entière - insérer tout du nouvel ensemble d'enregistrements
Méthode efficace, , mais il y a un problème… Nous allons insérer 1M d'enregistrements pendant un long moment, et donc nous ne pouvons pas nous permettre de garder la table vide tout ce temps (comme cela se produira sans envelopper le tout dans une seule transaction).
Cela signifie que :
- nous commençons une transaction longue
TRUNCATEimpose une- verrouillage- nous insérons longtemps, et tous les autres pendant ce temps ne peuvent même pas
SELECT
Ce n'est pas bon…
ALTER TABLE… RENAME… / DROP TABLE …
Une possibilité serait de tout placer dans une nouvelle table distincte, puis de la renommer à la place de l'ancienne. Quelques petits points désagréables :
- c'est aussi vrai une, même si cela prend beaucoup moins de temps
- tous les plans de requêtes/statistiques de cette table sont réinitialisés,
- toutes les clés étrangères (FK) sur la table sont cassées (FK) sur la table
Il y avait un patch WIP de Simon Riggs qui proposait de faire ALTER-l'opération pour remplacer le corps de la table au niveau des fichiers, sans toucher aux statistiques et aux FK, mais il n'a pas rassemblé le quorum.
DELETE, UPDATE, INSERT
Ainsi, nous nous arrêtons sur l'option non bloquante parmi les trois opérations. Presque trois… Comment procéder de la manière la plus efficace ?
-- nous faisons tout dans le cadre d'une transaction, afin que personne ne voie les "états intermédiaires"
BEGIN;

-- créons une table temporaire avec les données importées
CREATE TEMPORARY TABLE tmp(
  LIKE dst INCLUDING INDEXES -- sur le même modèle, y compris les index
) ON COMMIT DROP; -- en dehors de la transaction, elle ne nous est pas nécessaire

-- rapidement, nous injectons la nouvelle image via COPY
COPY tmp FROM STDIN;
-- ...
-- .

-- supprimons les absents
DELETE FROM
  dst D
USING
  dst X
LEFT JOIN
  tmp Y
    USING(pk1, pk2) -- champs de clé primaire
WHERE
  (D.pk1, D.pk2) = (X.pk1, X.pk2) AND
  Y IS NOT DISTINCT FROM NULL; -- "antijoin"

-- mettons à jour les restants
UPDATE
  dst D
SET
  (f1, f2, f3) = (T.f1, T.f2, T.f3)
FROM
  tmp T
WHERE
  (D.pk1, D.pk2) = (T.pk1, T.pk2) AND
  (D.f1, D.f2, D.f3) IS DISTINCT FROM (T.f1, T.f2, T.f3); -- pas besoin de mettre à jour les correspondances

-- insérons les absents
INSERT INTO
  dst
SELECT
  T.*
FROM
  tmp T
LEFT JOIN
  dst D
    USING(pk1, pk2)
WHERE
  D IS NOT DISTINCT FROM NULL;

COMMIT;
3.2. Post-traitement de l'import
Dans le même KAD, toutes les empreintes modifiées doivent être également soumises à un post-traitement — normaliser, extraire les mots-clés, les amener aux structures requises. Mais comment savoir — quelles modifications ont été apportées, sans compliquer le code de synchronisation, idéalement, sans même y toucher ?
S'il n'y a qu'un seul processus ayant accès en écriture au moment de la synchronisation, il est possible d'utiliser un déclencheur qui recueillera toutes les modifications pour nous :
-- tables cibles
CREATE TABLE kladr(...);
CREATE TABLE kladr_house(...);

-- tables avec l'historique des modifications
CREATE TABLE kladr$log(
  ro kladr, -- ici se trouvent les enregistrements anciens/nouveaux
  rn kladr
);

CREATE TABLE kladr_house$log(
  ro kladr_house,
  rn kladr_house
);

-- fonction générale de journalisation des modifications
CREATE OR REPLACE FUNCTION diff$log() RETURNS trigger AS $$
DECLARE
  dst varchar = TG_TABLE_NAME || '$log';
  stmt text = '';
BEGIN
  -- vérifie la nécessité de journaliser lors de la mise à jour d'un enregistrement
  IF TG_OP = 'UPDATE' THEN
    IF NEW IS NOT DISTINCT FROM OLD THEN
      RETURN NEW;
    END IF;
  END IF;
  -- crée un enregistrement de journal
  stmt = 'INSERT INTO ' || dst::text || '(ro,rn)VALUES(';
  CASE TG_OP
    WHEN 'INSERT' THEN
      EXECUTE stmt || 'NULL,$1)' USING NEW;
    WHEN 'UPDATE' THEN
      EXECUTE stmt || '$1,$2)' USING OLD, NEW;
    WHEN 'DELETE' THEN
      EXECUTE stmt || '$1,NULL)' USING OLD;
  END CASE;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;
Nous pouvons maintenant appliquer (ou activer via le début de la synchronisation) les déclencheurs : ALTER TABLE ... ENABLE TRIGGER ...):
CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();

CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr_house
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();
Et ensuite, nous extrayons tranquillement tous les changements nécessaires des tables de log et les passons par des gestionnaires supplémentaires.
3.3. Importation de jeux de données associés
Nous avons examiné ci-dessus les cas où les structures de données de la source et du destinataire sont identiques. Mais que faire si l'export d'un système externe a un format différent de la structure de stockage dans notre base ?
Prenons l'exemple du stockage des clients et de leurs factures, un cas classique de « plusieurs à un » :
CREATE TABLE client(
  client_id
    serial
      PRIMARY KEY
, inn
    varchar
      UNIQUE
, name
    varchar
);

CREATE TABLE invoice(
  invoice_id
    serial
      PRIMARY KEY
, client_id
    integer
      REFERENCES client(client_id)
, number
    varchar
, dt
    date
, sum
    numeric(32,2)
);
Et voici que l'export d'une source externe nous arrivera sous la forme « tout-en-un » :
CREATE TEMPORARY TABLE invoice_import(
  client_inn
    varchar
, client_name
    varchar
, invoice_number
    varchar
, invoice_dt
    date
, invoice_sum
    numeric(32,2)
);
Il est évident que les données des clients peuvent être dupliquées dans ce cas, et l'enregistrement principal est la « facture » :
0123456789;Vassia;A-01;2020-03-16;1000.00
9876543210;Petia;A-02;2020-03-16;666.00
0123456789;Vassia;B-03;2020-03-16;9999.00
Pour le modèle, nous allons simplement insérer nos données de test, mais gardons à l'esprit — COPY plus efficace !
INSERT INTO invoice_import
VALUES
  ('0123456789', 'Vassia', 'A-01', '2020-03-16', 1000.00)
, ('9876543210', 'Petia', 'A-02', '2020-03-16', 666.00)
, ('0123456789', 'Vassia', 'B-03', '2020-03-16', 9999.00);
Commençons par identifier les « segments » auxquels nos « faits » se réfèrent. Dans notre cas, les factures font référence aux clients :
CRÉER UNE TABLE TEMPORAIRE client_import COMME
SÉLECTIONNER DISTINCT SUR(client_inn)
-- on peut simplement SÉLECTIONNER DISTINCT si les données sont fondamentalement cohérentes
  client_inn inn
, client_name "nom"
DE
  invoice_import;
Pour lier correctement les factures aux ID des clients, nous devons d'abord connaître ou générer ces identifiants. Ajoutons des champs pour cela :
ALTER TABLE invoice_import AJOUTER UNE COLONNE client_id entier;
ALTER TABLE client_import AJOUTER UNE COLONNE client_id entier;
Nous allons utiliser la méthode de synchronisation des tables décrite ci-dessus avec un léger ajustement : nous ne mettrons rien à jour ni ne supprimerons dans la table cible, car l'import des clients est « append-only » :
-- attribuons dans la table d'importation les ID des enregistrements déjà existants
Mise à jour
  client_import T
RÉGLEZ
  client_id = D.client_id
DE
  client D
OÙ
  T.inn = D.inn; -- clé unique

-- insérons les enregistrements manquants et attribuons leurs ID
AVEC ins AS (
  INSÉRER DANS client(
    inn
  , nom
  )
  SÉLECTIONNER
    inn
  , nom
  DE
    client_import
  OÙ
    client_id EST NULL -- si l'ID n'a pas été attribué
  RETOURNANT *
)
Mise à jour
  client_import T
RÉGLEZ
  client_id = D.client_id
DE
  ins D
OÙ
  T.inn = D.inn; -- clé unique

-- attribuons les ID des clients aux enregistrements des factures
Mise à jour
  invoice_import T
RÉGLEZ
  client_id = D.client_id
DE
  client_import D
OÙ
  T.client_inn = D.inn; -- clé fonctionnelle
Tout est fait — dans invoice_import nous avons maintenant rempli le champ de liaison client_id, avec lequel nous allons insérer la facture.
Source : habr.com
