

La société Variti développe des protections contre les bots et les attaques DDoS, ainsi que des tests de résistance et de charge. Lors de la conférence HighLoad++ 2018, nous avons expliqué comment sécuriser les ressources contre différents types d'attaques. En résumé : isolez les parties du système, utilisez des services cloud et des CDN, et mettez-vous régulièrement à jour. Mais sans des entreprises spécialisées en protection, vous ne pourrez pas vous en sortir 🙂
Avant de lire le texte, vous pouvez consulter un bref résumé .
Et si vous n'aimez pas lire ou souhaitez simplement regarder une vidéo, l'enregistrement de notre présentation se trouve ci-dessous dans le spoiler.
Enregistrement de la présentation
De nombreuses entreprises savent déjà effectuer des tests de charge, mais peu réalisent des tests de stress. Certains de nos clients pensent que leur site est invulnérable parce qu'ils disposent d'un système haute charge, qui les protège bien des attaques. Nous montrons que ce n'est pas tout à fait vrai.
Bien sûr, avant d'effectuer des tests, nous obtenons l'autorisation du client, avec une signature et un cachet, et avec notre aide, il est impossible de lancer une attaque DDoS contre quiconque. Les tests sont réalisés à la demande du client, à un moment où la fréquentation de sa ressource est minimale, et où des problèmes d'accès n'impacteront pas les clients. De plus, comme des imprévus peuvent survenir pendant les tests, nous maintenons un contact constant avec le client. Cela permet non seulement de communiquer les résultats obtenus, mais aussi d'apporter des modifications au cours des tests. À l'issue des tests, nous rédigeons toujours un rapport mentionnant les défauts identifiés et fournissons des recommandations pour corriger les points faibles du site.
Comment nous travaillons
Lors des tests, nous émuleons un botnet. Comme nous travaillons avec des clients qui ne se trouvent pas dans nos réseaux, pour éviter que le test ne s'arrête dès la première minute à cause des limitations ou de la protection, nous générons la charge non pas à partir d'une seule IP, mais de notre propre sous-réseau. De plus, pour créer une charge significative, nous avons notre propre serveur de test assez puissant.
Postulats
Beaucoup — ne signifie pas bien
Plus la charge que nous pourrons mettre sur le système avant qu'il ne cesse de fonctionner est faible, mieux ce sera. S'il est possible de faire en sorte que le site cesse de fonctionner avec une requête par seconde, voire une requête par minute, c'est parfait. Car, selon la loi de Murphy, les utilisateurs ou les attaquants tomberont par hasard sur cette vulnérabilité.
Une panne partielle est préférable à une panne totale
Nous conseillons toujours de rendre les systèmes hétérogènes. De plus, il est important de les séparer au niveau physique, et pas seulement par la conteneurisation. En cas de séparation physique, même si quelque chose échoue sur le site, il y a de fortes chances qu'il ne cesse pas complètement de fonctionner, et que les utilisateurs puissent encore accéder à une partie des fonctionnalités.
Une architecture correcte est la clé de la résilience
La résilience d'une ressource et sa capacité à résister aux attaques et aux charges doivent être intégrées dès la phase de conception, en fait, dès l'étape de dessin des premiers diagrammes dans un carnet. Parce que si des erreurs fatales s'immiscent, il est possible de les corriger par la suite, mais c'est très difficile.
Le code doit être bon, tout comme la configuration
Beaucoup pensent qu'une bonne équipe de développement garantit la résilience du service. Une bonne équipe de développement est effectivement nécessaire, mais une bonne exploitation est également requise, ainsi qu'un bon DevOps. Cela signifie qu'il faut des spécialistes capables de configurer correctement Linux et le réseau, d'écrire correctement les configurations dans nginx, de définir les limites, etc. Sinon, la ressource fonctionnera bien en test, mais en production, à un moment donné, tout s'effondrera.
Différences entre les tests de charge et de stress
Les tests de charge permettent de déterminer les limites de fonctionnement du système. Les tests de stress visent à identifier les points faibles du système et sont utilisés pour tenter de le briser et observer son comportement lors de la défaillance de certaines parties. De plus, la nature de la charge reste généralement inconnue pour le client avant le début des tests de stress.
Caractéristiques distinctives des attaques de niveau 7
Nous classifions généralement les charges en charges de niveau L7 et L3&4. L7 fait référence à la charge au niveau des applications, le plus souvent entendue comme étant uniquement HTTP, mais nous entendons ici toute charge au niveau du protocole TCP.
Les attaques L7 présentent certaines caractéristiques distinctives. Premièrement, elles vont directement vers l'application, ce qui rend leur atténuation par des moyens réseau peu probable. Ces attaques exploitent la logique, ce qui leur permet de consommer efficacement des ressources CPU, mémoire, disque, base de données et autres, même avec un faible trafic.
HTTP Flood
Dans le cas de toute attaque, il est plus facile de générer une charge que de la traiter, et cela est également vrai pour L7. Le trafic d'attaque n'est pas toujours facile à distinguer du trafic légitime, et il est souvent possible de le faire en fonction de la fréquence. Cependant, si tout est bien planifié, il est impossible de comprendre, à partir des logs, où se trouve l'attaque et où se trouvent les requêtes légitimes.
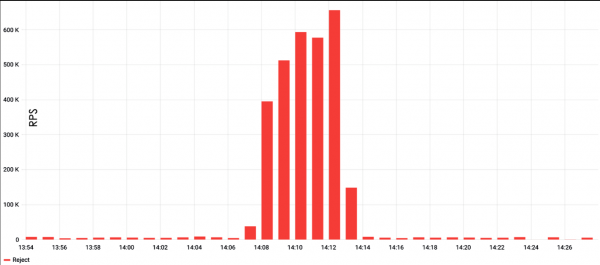
Pour donner un premier exemple, prenons l'attaque HTTP Flood. Le graphique montre que ces attaques sont généralement très puissantes ; dans l'exemple ci-dessous, le nombre de requêtes a dépassé 600 000 par minute au pic.
HTTP Flood est la manière la plus simple de générer une charge. Généralement, un outil de test de charge, comme ApacheBench, est utilisé, et une requête et une cible sont définies. Avec cette approche simple, il y a un risque élevé de rencontrer des problèmes de mise en cache du serveur, mais cette situation peut être facilement contournée. Par exemple, en ajoutant des chaînes aléatoires à la requête, ce qui obligera le serveur à délivrer constamment des pages fraîches.
Il ne faut pas non plus oublier le user-agent lors de la création de la charge. De nombreux user-agents des outils de test populaires sont filtrés par les administrateurs système, et dans ce cas, la charge peut tout simplement ne pas atteindre le backend. On peut considérablement améliorer les résultats en insérant dans la requête un en-tête plus ou moins valide d'un navigateur.
Malgré la simplicité de l'attaque, les HTTP Flood ont également leurs inconvénients. Premièrement, un important potentiel est nécessaire pour générer la charge. Deuxièmement, ces attaques sont très faciles à détecter, surtout si elles proviennent d'une même adresse. En fin de compte, les requêtes commencent immédiatement à être filtrées soit par des administrateurs système, soit même au niveau du fournisseur.
Que rechercher
Pour réduire le nombre de requêtes par seconde tout en maintenant l'efficacité, il faut faire preuve d'un peu d'imagination et explorer le site. On peut ainsi charger non seulement le canal ou le serveur, mais aussi des parties spécifiques de l'application, comme les bases de données ou les systèmes de fichiers. On peut également rechercher des endroits sur le site qui effectuent de grands calculs : calculateurs, pages de sélection de produits, etc. Enfin, il arrive souvent qu'il existe un script php sur le site qui génère une page à partir de plusieurs centaines de milliers de lignes. Un tel script surcharge également considérablement le serveur et peut devenir une cible pour une attaque.
Où chercher
Lorsque nous scannons une ressource avant de procéder à un test, nous examinons d'abord le site lui-même. Nous cherchons divers champs de saisie, des fichiers lourds — en gros tout ce qui peut poser des problèmes à la ressource et ralentir son fonctionnement. Des outils de développement simples dans Google Chrome et Firefox, montrant les temps de réponse de la page, sont utiles à cet égard.
Nous scannons également les sous-domaines. Par exemple, un certain magasin en ligne, abc.com, a un sous-domaine admin.abc.com. Il s'agit très probablement d'un panneau d'administration avec authentification, mais si nous y appliquons une charge, cela peut poser des problèmes au site principal.
Le site peut avoir un sous-domaine api.abc.com. Il s'agit probablement d'une ressource pour les applications mobiles. L'application peut être trouvée dans l'App Store ou Google Play, établir un point d'accès spécial, examiner l'API et enregistrer des comptes de test. Le problème est que les gens pensent souvent que tout ce qui est protégé par une authentification est invulnérable aux attaques par déni de service. On prétend que l'authentification est le meilleur CAPTCHA, mais ce n'est pas le cas. Créer 10-20 comptes de test est facile, et une fois créés, nous avons accès à des fonctionnalités complexes et non protégées.
Naturellement, nous examinons l'historique, le robots.txt et WebArchive, ViewDNS, à la recherche de vieilles versions de la ressource. Il arrive parfois que les développeurs aient déployé, disons, mail2.yandex.net, tandis qu'une ancienne version, mail.yandex.net, soit restée. Ce mail.yandex.net ne reçoit plus de support, les ressources de développement ne lui sont plus consacrées, mais il continue à consommer des données de la base. Par conséquent, nous pouvons efficacement exploiter les ressources de backend et tout ce qui se cache derrière le codage avec une ancienne version. Bien sûr, ce n'est pas toujours le cas, mais nous y faisons face assez souvent.
Évidemment, nous allons analyser tous les paramètres de la requête, la structure des cookies. On peut, par exemple, injecter dans un tableau JSON à l'intérieur des cookies une certaine valeur, créer une grande hiérarchie et faire en sorte que la ressource fonctionne de manière incroyablement lente.
Charge dans la recherche
La première chose qui vient à l'esprit lors de l'exploration d'un site est de surcharger la base de données, car presque tout le monde a une fonction de recherche, et malheureusement, presque tout le monde la protège mal. Pour une raison quelconque, les développeurs ne portent pas assez attention à la recherche. Cependant, il y a une recommandation : ne pas effectuer de requêtes identiques, car cela peut entraîner une mise en cache, tout comme dans le cas d'une inondation HTTP.
Effectuer des requêtes aléatoires sur la base de données n'est pas toujours efficace non plus. Il est beaucoup mieux de créer une liste de mots clés pertinents pour la recherche. Reprenons l'exemple d'un site de commerce en ligne : supposons que le site vend des pneus de voiture et permet de définir le diamètre des pneus, le type de voiture et d'autres paramètres. Par conséquent, des combinaisons de mots pertinents obligeront la base de données à fonctionner dans des conditions beaucoup plus complexes.
De plus, il est recommandé d'utiliser la pagination : il est beaucoup plus difficile pour le moteur de recherche de rendre l'avant-dernière page de résultats que la première. Ainsi, grâce à la pagination, on peut légèrement diversifier la charge.
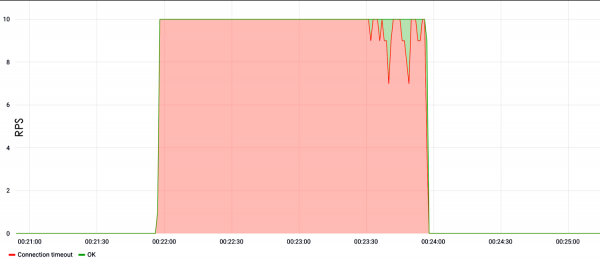
Dans l'exemple ci-dessous, nous montrons la charge dans la recherche. On voit qu'à partir de la première seconde du test, avec une vitesse de dix requêtes par seconde, le site s'est effondré et ne répondait plus.
Et s'il n'y a pas de recherche ?
S'il n'y a pas de recherche, cela ne signifie pas que le site ne contient pas d'autres champs d'entrée vulnérables. Un de ces champs peut être l'authentification. Actuellement, les développeurs aiment créer des hachages complexes pour protéger la base de connexions contre les attaques par tables de hachage. C'est une bonne chose, mais ces hachages consomment beaucoup de ressources CPU. Un grand flot de fausses authentifications conduit à un refus du processeur, et par conséquent, le site cesse de fonctionner.
La présence sur le site de diverses formulaires pour les commentaires et les retours est une occasion d'envoyer de très grands textes ou simplement de créer un flot massif. Parfois, les sites acceptent des fichiers joints, y compris au format gzip. Dans ce cas, nous prenons un fichier de 1 To, le compressons avec gzip jusqu'à quelques octets ou kilooctets et l'envoyons sur le site. Ensuite, il est décompressé, ce qui produit un effet très intéressant.
Rest API
Il conviendrait de consacrer un peu d'attention à des services aujourd'hui aussi populaires que Rest API. Protéger un Rest API est beaucoup plus compliqué qu'un simple site web. Même les méthodes de protection les plus élémentaires contre les tentatives de mot de passe ou d'autres activités illégitimes ne fonctionnent pas pour un Rest API.
Un Rest API est très facile à compromettre, car il accède directement à la base de données. De plus, une panne de ce service entraîne des conséquences assez graves pour l'entreprise. En effet, un Rest API est généralement lié non seulement au site principal, mais aussi à des applications mobiles, ainsi qu'à certains ressources internes de l'entreprise. Et si tout cela tombe en panne, l'effet est bien plus important que dans le cas d'un simple site.
Charge sur le contenu lourd
Lorsque l'on nous propose de tester un type d'application ordinaire comme une page d'accueil, un site vitrine ou tout autre site dépourvu de fonctionnalités complexes, nous recherchons un contenu lourd. Par exemple, de grandes images fournies par le serveur, des fichiers binaires, de la documentation PDF — nous essayons de tout télécharger. Ces tests sollicitent bien le système de fichiers et saturent les canaux, ce qui les rend efficaces. Même si vous ne parvenez pas à faire tomber le serveur en téléchargeant un gros fichier à des vitesses faibles, vous saturerez simplement le canal du serveur cible, entraînant par la suite une défaillance de service.
À titre d'exemple de ce test, on voit qu'à une vitesse de 30 RPS, le site a cessé de répondre, ou a renvoyé des erreurs serveur de type 500.
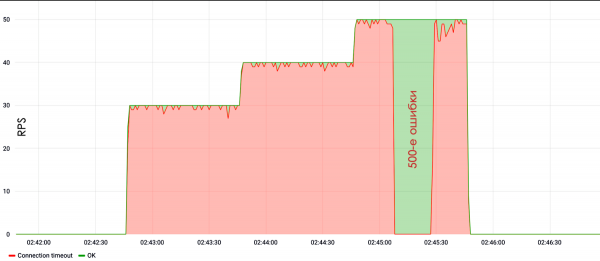
N'oublions pas non plus la configuration des serveurs. On rencontre souvent des situations où une personne a acheté une machine virtuelle, y a installé Apache, a tout configuré par défaut, et a déposé une application PHP, et ci-dessous on peut voir le résultat.
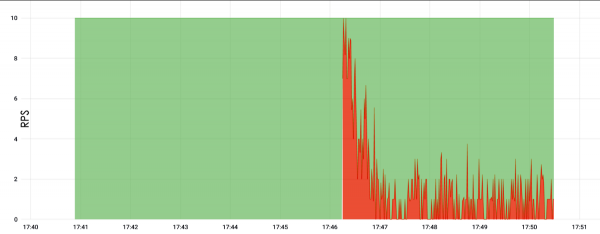
Ici, la charge était très faible, seulement 10 RPS. Nous avons attendu 5 minutes, et le serveur a planté. En fin de compte, il est difficile de dire pourquoi il a échoué, mais on suppose qu'il a tout simplement saturé sa mémoire, ce qui a causé son inactivité.
Basé sur les vagues
Au cours des dernières années, les attaques par vague sont devenues assez populaires. Cela est dû au fait que de nombreuses organisations achètent du matériel pour se protéger contre les attaques DDoS, ce qui nécessite un certain temps pour accumuler des statistiques avant de commencer à filtrer l'attaque. Cela signifie qu'elles ne filtrent pas l'attaque durant les 30 à 40 premières secondes, car elles collectent des données et s'entraînent. Par conséquent, durant ces 30 à 40 secondes, on peut lancer suffisamment d'attaques sur le site pour qu'il reste hors ligne pendant un certain temps, le temps que toutes les requêtes soient traitées.
Dans le cas de l'attaque ci-dessous, il y a eu un intervalle de 10 minutes, après quoi une nouvelle série modifiée d'attaques a eu lieu.
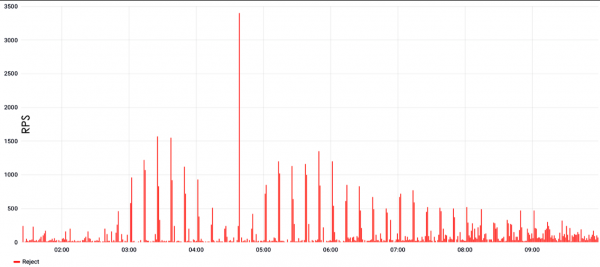
C'est-à-dire que la protection a appris, a commencé à filtrer, mais une nouvelle attaque totalement différente est arrivée, et la protection a recommencé son apprentissage. En fait, le filtrage cesse de fonctionner, la protection devient inefficace et le site devient inaccessible.
Les attaques par vague se caractérisent par des valeurs très élevées au pic, pouvant atteindre des centaines de milliers ou des millions de requêtes par seconde, dans le cas de L7. En ce qui concerne L3&4, il peut y avoir des centaines de gigabits de trafic, ou, par conséquent, des centaines de mpps si on les compte en paquets.
Le problème de ces attaques réside dans la synchronisation. Les attaques proviennent d'un botnet, et pour créer un pic unique très important, un haut niveau de synchronisation est nécessaire. Et cette coordination n'est pas toujours facile à obtenir : parfois, le résultat est une sorte de pic parabolique qui semble plutôt lamentable.
Pas que HTTP
En plus de HTTP au niveau L7, nous aimons exploiter d'autres protocoles. En général, un site web ordinaire, surtout un hébergement classique, expose des protocoles de messagerie et MySQL. Les protocoles de messagerie sont moins susceptibles d'être soumis à des charges que les bases de données, mais ils peuvent également être chargés de manière assez efficace, entraînant une surcharge du CPU du serveur.
Nous avons réussi, grâce à une vulnérabilité SSH de 2016. Actuellement, cette vulnérabilité est presque corrigée chez tous, mais cela ne signifie pas qu'on ne peut pas soumettre de charge via SSH. On peut. Il suffit de soumettre une énorme charge d'autorisations. SSH consomme presque tout le CPU du serveur et le site web est déjà compromis avec une ou deux requêtes par seconde. Par conséquent, ces une ou deux requêtes ne peuvent être distinguées des charges légitimes dans les journaux.
Il reste de nombreux connexions que nous ouvrons sur les serveurs. Auparavant, c'était un problème avec Apache, et maintenant, cela concerne également nginx, car il est souvent configuré par défaut. Le nombre de connexions que nginx peut maintenir ouvertes est limité, donc lorsque nous atteignons ce nombre de connexions, nginx n'accepte plus de nouvelles connexions, ce qui entraîne un dysfonctionnement du site.
Notre cluster de test dispose d'un CPU suffisant pour attaquer le handshake SSL. En pratique, les botnets aiment aussi parfois faire cela. D'une part, il est clair que l'on ne peut pas se passer du SSL, en raison de l'affichage Google, du référencement et de la sécurité. D'autre part, malheureusement, le SSL a un problème avec le CPU.
L3&4
Lorsque nous parlons d'attaques aux niveaux L3&4, nous faisons généralement référence à des attaques au niveau du canal. Cette charge est presque toujours distinguable d'une charge légitime, sauf s'il s'agit d'une attaque SYN-flood. Le problème des attaques SYN-flood pour les moyens de protection réside dans leur volume important. La taille maximale des attaques L3&4 était de 1,5 à 2 Tbit/s. Ce type de trafic est très difficile à traiter, même pour de grandes entreprises telles qu'Oracle et Google.
SYN et SYN-ACK sont des paquets utilisés lors de l'établissement d'une connexion. Par conséquent, il est difficile de distinguer une SYN-flood d'une charge légitime : il n'est pas clair s'il s'agit d'une SYN destinée à établir une connexion ou d'une partie du flood.
UDP-flood
En général, les attaquants n'ont pas les capacités que nous avons, donc pour organiser des attaques, une amplification peut être utilisée. Cela signifie que l'attaquant scanne Internet et trouve soit des serveurs vulnérables, soit mal configurés, qui, par exemple, répondent à un seul paquet SYN par trois SYN-ACK. En falsifiant l'adresse source de l'adresse du serveur cible, on peut, avec un seul paquet, multiplier la puissance par trois et rediriger le trafic vers la victime.
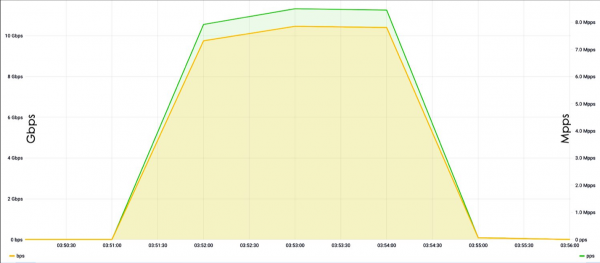
Le problème des amplifications réside dans leur détection complexe. Parmi les derniers exemples, on peut citer le cas médiatisé du memcached vulnérable. De plus, il existe maintenant de nombreux appareils IoT, des caméras IP, qui sont également principalement configurés par défaut, et généralement de manière incorrecte, c'est pourquoi les attaquants utilisent souvent ces appareils pour mener des attaques.
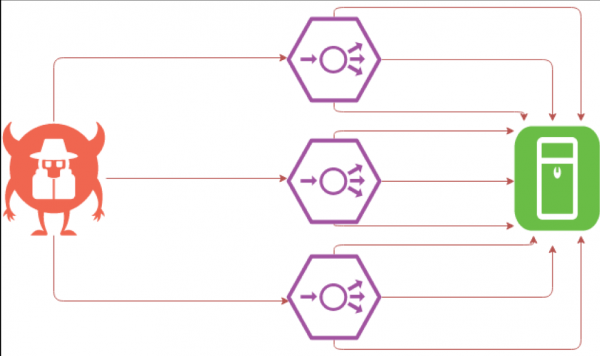
Une SYN-flood compliquée
L'attaque SYN-flood est probablement la plus intéressante de toutes les attaques du point de vue des développeurs. Le problème est que souvent, les administrateurs systèmes utilisent le blocage par IP pour se protéger. De plus, grâce à ce blocage par IP, ne souffrent pas seulement les sysadmins qui agissent selon des scripts, mais malheureusement aussi certains systèmes de protection qui sont achetés à prix élevé.
Cette méthode peut se retourner contre eux, car si des attaquants substituent adresses IP, l'entreprise va bloquer son propre sous-réseau. Lorsque le pare-feu bloque son propre cluster, les interactions externes vont échouer, et la ressource sera hors service.
Il est d'ailleurs facile d'atteindre le blocage de son propre réseau. Si le bureau du client dispose d'un réseau Wi-Fi, ou si la fonctionnalité des ressources est mesurée à l'aide de divers outils de monitoring, alors nous prenons l'adresse IP de ce système de monitoring ou du client Wi-Fi du bureau et l'utilisons comme source. En sortie, la ressource semble accessible, mais les adresses IP cibles sont bloquées. Ainsi, le réseau Wi-Fi de la conférence HighLoad, où un nouveau produit de l'entreprise est présenté, peut être bloqué, ce qui entraîne certains coûts commerciaux et économiques.
Lors des tests, nous ne pouvons pas utiliser l'amplification via memcached avec des ressources externes, car il y a des accords pour l'envoi de trafic uniquement vers des adresses IP autorisées. Par conséquent, nous utilisons l'amplification via SYN et SYN-ACK, où pour l'envoi d'un SYN, le système répond par deux ou trois SYN-ACK, et au final, l'attaque est multipliée par deux ou trois.
Outils
L'un des principaux outils que nous utilisons pour la charge au niveau L7 est Yandex-tank. En particulier, un phantom est utilisé comme arme, plus il y a plusieurs scripts pour générer des munitions et analyser les résultats.
Pour analyser le trafic réseau, nous utilisons Tcpdump, et pour l'analyse du serveur — Nmap. Pour créer une charge au niveau L3&4, nous utilisons OpenSSL et un peu de notre propre magie avec la bibliothèque DPDK. DPDK est une bibliothèque d'Intel qui permet de travailler avec l'interface réseau, en contournant la pile Linux, ce qui augmente ainsi l'efficacité. Bien entendu, nous utilisons DPDK non seulement au niveau L3&4, mais aussi au niveau L7, car elle permet de générer un très fort flux de charge, atteignant plusieurs millions de requêtes par seconde depuis une seule machine.
Nous utilisons également certains générateurs de trafic et des outils spéciaux que nous développons pour des tests spécifiques. En se souvenant de la vulnérabilité sous SSH, le jeu d'outils mentionné ci-dessus ne peut pas être exploité. Si nous attaquons le protocole de messagerie, nous utilisons des utilitaires de messagerie ou simplement nous écrivons des scripts pour eux.
Conclusions
En guise de conclusion, je voudrais dire :
- En plus du test de charge classique, il faut absolument effectuer des tests de stress. Nous avons un exemple réel, où un sous-traitant d'un partenaire a réalisé uniquement un test de charge. Cela a montré que la ressource supporte la charge normale. Mais ensuite, une charge anormale est apparue, et les visiteurs du site ont commencé à utiliser la ressource différemment — et au final, le sous-traitant a échoué. Ainsi, il est important de rechercher des vulnérabilités, même si vous êtes déjà protégé contre les attaques DDoS.
- Il est nécessaire d'isoler certaines parties du système des autres. Si vous avez une fonction de recherche, elle doit être mise sur des machines séparées, c'est-à-dire même pas dans Docker. Car si la recherche ou l'authentification échoue, au moins quelque chose continuera de fonctionner. Dans le cas d'une boutique en ligne, les utilisateurs continueront à trouver des produits dans le catalogue, à passer par l'agrégateur, à acheter, s'ils sont déjà authentifiés, ou à s'authentifier via OAuth2.
- Il ne faut pas négliger les divers services cloud.
- Utilisez un CDN non seulement pour optimiser les latences réseaux, mais aussi comme moyen de protection contre les attaques d'épuisement de bande passante et simplement le flood dans les fichiers statiques.
- Il est nécessaire d'utiliser des services de protection spécialisés. Vous ne vous protégerez pas vous-même contre les attaques L3&4 au niveau de la couche, car vous n'avez probablement tout simplement pas une bande passante suffisante. Vous ne pourrez pas non plus vous défendre contre les attaques L7, car elles peuvent être très volumineuses. De plus, détecter de petites attaques est quand même la prérogative de services spéciaux, d'algorithmes spéciaux.
- Mettez régulièrement à jour. Cela concerne non seulement le noyau, mais aussi le daemon SSH, surtout s'ils sont exposés à l'extérieur. En principe, il faut tout mettre à jour, car il est peu probable que vous puissiez suivre vous-même certaines vulnérabilités.
Source : habr.com
