

J'ai toujours été intéressé par la façon d'organiser au mieux mes livres dans ma bibliothèque numérique. Au final, j'ai opté pour une solution avec un comptage automatique des pages et d'autres fonctionnalités. Tous ceux qui sont intéressés, veuillez suivre.
Partie 1. Dropbox
Tous mes livres sont sur Dropbox. J'ai divisé en 4 catégories : Manuel, Référence, Fiction, Non-fiction. Mais je n'ajoute pas les ouvrages de référence dans le tableau.
La plupart des livres sont au format .epub, les autres sont en .pdf. Donc, la solution finale doit couvrir les deux options.
Les chemins vers les livres sont à peu près les suivants :
/Книги/Нехудожественное/Новое/Дизайн/Юрий Гордон/Книга про буквы от А до Я.epub Si le livre est de fiction, la catégorie (c'est-à-dire « Design » dans le cas précédent) est retirée.
J'ai décidé de ne pas me compliquer avec l'API de Dropbox, heureusement, j'ai installé leur application qui synchronise le dossier. Donc, le plan est le suivant : nous prenons les livres du dossier, passons chaque livre dans le compteur de mots, puis l'ajoutons dans Notion.
Partie 2. Ajoutons une ligne
Le tableau doit ressembler approximativement à ceci. ATTENTION : il est préférable d'écrire les noms des colonnes en lettres latines.
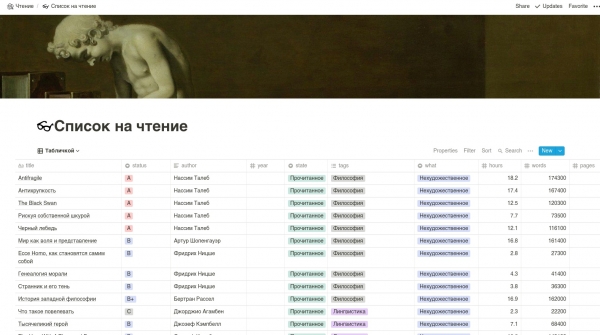
Nous allons utiliser l'API non officielle de Notion, car l'officielle n'est pas encore disponible.

Allons dans Notion, appuyons sur Ctrl + Shift + J, allons dans Application -> Cookies, copions token_v2 et appelons-le TOKEN. Ensuite, nous allons à la page de bibliothèque qui nous intéresse et copions le lien. Nous l'appellerons NOTION.
Puis nous écrivons le code de connexion à Notion.
database = client.get_collection_view(NOTION)
current_rows = database.default_query().execute()
Ensuite, écrivons une fonction pour ajouter une ligne dans le tableau.
def add_row(path, file, words_count, pages_count, hours):
    row = database.collection.add_row()
    row.title = file

    tags = path.split("/")

    if len(tags) >= 1:
        row.what = tags[0]

    if len(tags) >= 2:
        row.state = tags[1]

    if len(tags) >= 3:
        if tags[0] == "Fiction":
            row.author = tags[2]

        elif tags[0] == "Non-fiction":
            row.tags = tags[2]

        elif tags[0] == "Manuels":
            row.tags = tags[2]

    if len(tags) >= 4:
        row.author = tags[3]

    row.hours = hours
    row.pages = pages_count
    row.words = words_count
Que se passe-t-il ici. Nous prenons et ajoutons une nouvelle ligne dans le tableau à la première ligne. Ensuite, nous divisons notre chemin par « / » et récupérons les tags. Les tags concernent la « Fiction », le « Design », qui est l'auteur, etc. Puis nous remplissons tous les champs nécessaires du tableau.
Partie 3. Comptons les mots, les heures et autres détails.
C'est déjà un casse-tête plus complexe. Comme nous le savons, nous avons deux formats : ePub et PDF. Si tout est clair avec l'ePub — il y a probablement des mots, en ce qui concerne le PDF, tout n'est pas si sûr : il peut simplement être constitué d'images collées.
Donc, la fonction pour le comptage de mots dans le PDF ressemblera à ceci : nous prenons le nombre de pages et le multiplions par une constante déterminée (le nombre moyen de mots par page).
La voici :
def get_words_count(pages_number):
    return pages_number * WORDS_PER_PAGE
Le WORDS_PER_PAGE pour une page A4 est d'environ 300.
Maintenant, écrivons une fonction pour compter les pages. Nous allons utiliser .
def get_pdf_pages_number(path, filename):
    pdf = PdfFileReader(open(os.path.join(path, filename), 'rb'))
    return pdf.getNumPages()
Ensuite, écrivons une petite fonction pour compter les pages dans l'ePub. Utilisons . Ici, nous prenons le livre, le convertissons en lignes, et pour chaque ligne, nous comptons les mots.
def get_epub_pages_number(path, filename):
    book = open_book(os.path.join(path, filename))
    lines = convert_epub_to_lines(book)
    words_count = 0

    for line in lines:
        words_count += len(line.split(" "))

    return round(words_count / WORDS_PER_PAGE)
Maintenant faisons le calcul du temps. Prenons notre nombre préféré de mots et le divisons par votre vitesse de lecture.
def get_reading_time(words_count):
    return round(((words_count / WORDS_PER_MINUTE) / 60) * 10) / 10
Partie 4. Reliant toutes les parties
Nous devons explorer tous les chemins possibles dans notre dossier de livres. Vérifiez s'il existe déjà un livre dans Notion : s'il existe, nous n'avons pas besoin de créer la ligne.
Ensuite, nous devons déterminer le type de fichier ; en fonction de cela, calculons le nombre de mots. Enfin, ajoutons le livre.
Voici le code que nous obtenons :
for root, subdirs, files in os.walk(BOOKS_DIR):
    if len(files) > 0 and check_for_excusion(root):
        for file in files:
            array = file.split(".")
            filetype = file.split(".")[len(array) - 1]
            filename = file.replace("." + filetype, "")
            local_root = root.replace(BOOKS_DIR, "")

            print("Dir: {}, file: {}".format(local_root, file))

            if not check_for_existence(filename):
                print("Dir: {}, file: {}".format(local_root, file))

                if filetype == "pdf":
                    count = get_pdf_pages_number(root, file)

                else:
                    count = get_epub_pages_number(root, file)

                words_count = get_words_count(count)
                hours = get_reading_time(words_count)
                print("Pages: {}, Words: {}, Hours: {}".format(count, words_count, hours))
                add_row(local_root, filename, words_count, count, hours)
Et la fonction pour vérifier si le livre a été ajouté ressemble à ceci :
def check_for_existence(filename):
    for row in current_rows:
        if row.title in filename:
            return True

        elif filename in row.title:
            return True

    return False
Conclusion
Merci à tous ceux qui ont lu cet article. J'espère qu'il vous aidera à lire davantage 🙂
Source : habr.com
