

À l'approche du lancement d'un nouveau flux pour le cours Nous avons préparé une traduction d'un contenu intéressant.
Aperçu
Nous allons parler d'un modèle assez populaire que les applications utilisent pour gérer plusieurs bases de données, chacune étant utilisée à des fins spécifiques, par exemple, pour stocker la forme canonique des données (MySQL, etc.), fournir des capacités de recherche avancées (ElasticSearch, etc.), mettre en cache (Memcached, etc.) et bien d'autres. En général, lorsqu'on utilise plusieurs bases de données, l'une d'entre elles fonctionne comme base principale, tandis que les autres agissent comme des bases dérivées. Le seul problème réside dans la façon de synchroniser ces bases de données.
Nous avons examiné un certain nombre de modèles différents qui tentent de résoudre le problème de la synchronisation de plusieurs bases de données, tels que la double écriture, les transactions distribuées, etc. Cependant, ces approches présentent des limitations significatives en termes d'utilisation dans la vie réelle, de fiabilité et de maintenance technique. En plus de la synchronisation des données, certaines applications doivent également enrichir les données en appelant des services externes.
Pour résoudre ces problèmes, Delta a été développé. Delta représente finalement une plateforme cohérente et pilotée par les événements pour la synchronisation et l'enrichissement des données.
Solutions existantes
Double écriture
Pour synchroniser deux bases de données, on peut utiliser la double écriture qui effectue une écriture dans une base de données, puis immédiatement après, fait une écriture dans l'autre. La première écriture peut être répétée, et la seconde peut être interrompue si la première échoue après un certain nombre de tentatives. Cependant, les deux bases de données peuvent cesser de se synchroniser si l'écriture dans la seconde échoue. Ce problème est généralement résolu en créant une procédure de récupération qui peut périodiquement transférer à nouveau des données de la première base vers la seconde ou le faire uniquement si des différences sont détectées dans les données.
Problèmes :
L'exécution d'une procédure de restauration est un travail spécifique qui ne peut pas être réutilisé. De plus, les données entre les stockages restent désynchronisées jusqu'à ce que la procédure de restauration ait lieu. La situation se complique si plus de deux stockages de données sont utilisés. Enfin, la procédure de restauration peut ajouter une charge sur la source de données d'origine.
Table des journaux de modifications
Lorsque des modifications ont lieu dans un ensemble de tables (par exemple, l'insertion, la mise à jour et la suppression d'un enregistrement), les enregistrements de modifications sont ajoutés à la table des journaux, dans le cadre de la même transaction. Un autre flux ou processus interroge en permanence les événements dans la table des journaux et les enregistre dans un ou plusieurs stockages de données, supprimant les événements de la table des journaux après l'confirmation de l'enregistrement par tous les stockages.
Problèmes :
Ce modèle doit être implémenté comme une bibliothèque et idéalement sans modification du code de l'application qui l'utilise. Dans un environnement polyglotte, la réalisation de cette bibliothèque doit exister dans n'importe quel langage nécessaire, mais garantir une cohérence des fonctions et des comportements entre les langages est très difficile.
Un autre problème réside dans l'obtention des modifications de schéma, dans les systèmes qui ne prennent pas en charge les modifications de schéma transactionnelles [1][2], comme MySQL par exemple. Par conséquent, le modèle d'exécution d'une modification (par exemple, des modifications de schéma) et son enregistrement transactionnel dans la table des journaux de modifications ne fonctionnera pas toujours.
Transactions Distribuées
Les transactions distribuées peuvent être utilisées pour diviser une transaction entre plusieurs stockages de données hétérogènes de sorte que l'opération soit soit validée dans tous les stockages utilisés, soit ne soit validée dans aucun d'eux.
Problèmes :
Les transactions distribuées représentent un problème majeur pour les entrepôts de données hétérogènes. Par nature, elles ne peuvent s'appuyer que sur le plus petit dénominateur commun des systèmes participants. Par exemple, les transactions XA bloquent l'exécution en cas de défaillance de l'application lors de la préparation. De plus, XA ne garantit pas la détection des blocages et ne prend pas en charge les schémas de gestion du parallélisme optimiste. En outre, certains systèmes tels qu'ElasticSearch ne supportent pas XA ni aucun autre modèle de transactions hétérogène. Ainsi, garantir l'atomicité des écritures à travers diverses technologies de stockage de données demeure un défi considérable pour les applications [3].
Delta
Delta a été conçu pour surmonter les limitations des solutions de synchronisation de données existantes, tout en permettant d'enrichir les données à la volée. Notre objectif était d'abstraire tous ces aspects complexes des développeurs d'applications, afin qu'ils puissent se concentrer entièrement sur l'implémentation des fonctionnalités métier. Nous allons décrire ci-après « Movie Search », un cas d'utilisation concret de Delta par Netflix.
Netflix utilise largement une architecture de microservices, chaque microservice gérant généralement un seul type de données. Les informations clés sur les films sont extraites dans un microservice appelé Movie Service, tandis que les données associées, telles que les informations sur les producteurs, les acteurs, les fournisseurs, etc., sont gérées par plusieurs autres microservices (à savoir Deal Service, Talent Service et Vendor Service).
Les utilisateurs professionnels de Netflix Studios ont souvent besoin de rechercher des films selon divers critères, c’est pourquoi il est très important pour eux de pouvoir rechercher dans toutes les données liées aux films.
Avant l'apparition de Delta, l'équipe de recherche de films devait récupérer des données à partir de plusieurs microservices avant d'indexer les données des films. De plus, l'équipe devait développer un système qui mettait à jour périodiquement l'index de recherche en interrogeant les autres microservices, même s'il n'y avait pas de modifications. Ce système est rapidement devenu complexe et difficile à maintenir.
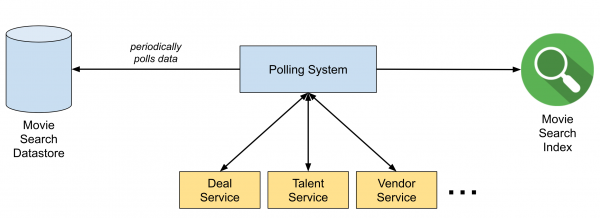
Figure 1. Système de polling avant Delta
Après le début de l'utilisation de Delta, le système a été simplifié en un système piloté par des événements, comme illustré dans la figure suivante. Les événements CDC (Change-Data-Capture) sont envoyés dans des sujets Keystone Kafka à l'aide de Delta-Connector. L'application Delta, construite à l'aide du Delta Stream Processing Framework (basé sur Flink), reçoit les événements CDC du sujet, les enrichit en appelant d'autres microservices, et enfin transmet les données enrichies dans l'index de recherche dans Elasticsearch. Tout le processus se déroule presque en temps réel, c'est-à-dire que dès que des modifications sont enregistrées dans le stockage de données, les index de recherche sont mis à jour.
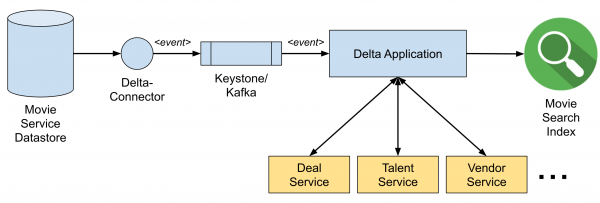
Figure 2. Pipeline de données lors de l'utilisation de Delta
Dans les sections suivantes, nous décrirons le fonctionnement de Delta-Connector, qui se connecte au stockage et publie des événements CDC au niveau de transport, qui constitue l'infrastructure de transfert de données en temps réel, orientant les événements CDC vers des sujets Kafka. Et enfin, nous parlerons de la structure de traitement des flux Delta, que les développeurs d'applications peuvent utiliser pour la logique de traitement et l'enrichissement des données.
CDC (Change-Data-Capture)
Nous avons développé un service CDC appelé Delta-Connector, qui peut enregistrer les modifications validées du stockage de données en temps réel et les écrire dans un flux. Les modifications en temps réel sont tirées du journal des transactions et des dumps de stockage. Les dumps sont utilisés car les journaux des transactions ne conservent généralement pas tout l'historique des modifications. Les modifications sont généralement sérialisées sous forme d'événements Delta, de sorte que le destinataire n'ait pas à se soucier de l'origine de la modification.
Delta-Connector prend en charge plusieurs fonctionnalités supplémentaires, telles que :
- La possibilité d'écrire dans des sorties personnalisées en contournant Kafka.
- La possibilité d'activer des dumps manuels à tout moment pour toutes les tables, une table spécifique ou pour des clés primaires spécifiques.
- Les dumps peuvent être récupérés par morceaux, il n'est donc pas nécessaire de tout recommencer depuis le début en cas d'échec.
- Aucune nécessité de verrouiller les tables, ce qui est très important pour que le trafic d'écriture dans la base de données ne soit jamais bloqué par notre service.
- Haute disponibilité grâce à des instances de sauvegarde dans les zones de disponibilité AWS.
Actuellement, nous prenons en charge MySQL et Postgres, y compris lors du déploiement sur AWS RDS et Aurora. Nous prenons également en charge Cassandra (multi-maître). Vous pouvez trouver plus de détails sur Delta-Connector dans cet .
Kafka et le niveau de transport
Le niveau de transport des événements Delta est construit sur le service de messagerie de la plateforme .
Il se trouve que la publication de messages chez Netflix a été optimisée pour une meilleure disponibilité plutôt que pour la durabilité (cf. ). Le compromis a été un potentiel désaccord des données du courtier dans divers scénarios limites. Par exemple, élection de leader non propre est responsable du fait que le destinataire double potentiellement ou perd des événements.
Avec Delta, nous souhaitions obtenir des garanties de durabilité plus solides pour assurer la livraison des événements CDC vers des entrepôts dérivés. Pour cela, nous avons proposé un cluster Kafka spécialement conçu comme objet de première classe. Vous pouvez consulter certains paramètres du courtier dans le tableau ci-dessous :
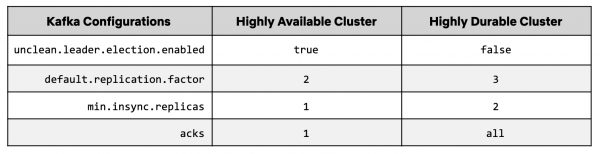
Dans les clusters Keystone Kafka, élection de leader non propre généralement activé pour assurer la disponibilité de l'éditeur. Cela peut entraîner une perte de messages si une réplique désynchronisée est élue comme leader. Pour un nouveau cluster Kafka hautement fiable, le paramètre élection de leader non propre est désactivé pour éviter la perte de messages.
Nous avons également augmenté le facteur de réplication de 2 à 3 et les réplicas minimums en synchronisation de 1 à 2. Les éditeurs écrivant dans ce cluster exigent des acks de tous les autres, garantissant que 2 des 3 réplicas auront les messages les plus récents envoyés par l'éditeur.
Lorsqu'une instance de courtier se termine, une nouvelle instance remplace l'ancienne. Cependant, le nouveau courtier doit rattraper les répliques non synchronisées, ce qui peut prendre plusieurs heures. Pour réduire le temps de récupération dans ce scénario, nous avons commencé à utiliser un stockage de blocs de données (Amazon Elastic Block Store) au lieu des disques locaux des courtiers. Lorsque la nouvelle instance remplace l'instance de courtier terminée, elle joint le volume EBS qui était attaché à l'instance terminée et commence à rattraper les nouveaux messages. Ce processus réduit le temps de liquidation du retard de plusieurs heures à quelques minutes, car la nouvelle instance n'a plus besoin de répliquer à partir d'un état vierge. En général, les cycles de vie distincts du stockage et du courtier réduisent considérablement l'impact de l'effet de changement de courtier.
Pour encore augmenter la garantie de livraison des données, nous avons utilisé pour détecter toute perte de messages dans des conditions extrêmes (par exemple, un désynchronisation des horloges dans le leader de la partition).
Framework de Traitement de Flux
Le niveau de traitement dans Delta est basé sur la plateforme Netflix SPaaS, qui intègre Apache Flink avec l'écosystème Netflix. La plateforme fournit une interface utilisateur qui gère le déploiement des tâches Flink et l' orchestration des clusters Flink sur notre plateforme de gestion de conteneurs Titus. L'interface gère également les configurations des tâches et permet aux utilisateurs d'apporter des modifications à la configuration de manière dynamique sans avoir à recompiler les tâches Flink.
Delta fournit un framework de traitement de flux de données basé sur Flink et SPaaS, qui utilise un DSL (Domain Specific Language) basé sur des annotations pour abstraire les détails techniques. Par exemple, pour définir l'étape à laquelle les événements seront enrichis en appelant des services externes, les utilisateurs doivent écrire le DSL suivant, et le framework générera un modèle à partir de celui-ci, qui sera exécuté par Flink. Figure 3. Exemple d'enrichissement en DSL dans Delta
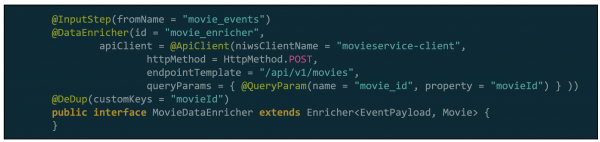
Le framework de traitement réduit non seulement la courbe d'apprentissage, mais fournit également des fonctions de traitement de flux communes, telles que la dé-duplication, la schématisation, ainsi que la flexibilité et la tolérance aux pannes pour résoudre des problèmes courants en production.
Le framework de traitement réduit non seulement la courbe d'apprentissage, mais offre également des fonctionnalités de traitement de flux communes, telles que la déduplique, la schématisation, ainsi que la flexibilité et la résistance aux pannes pour résoudre les problèmes courants en exploitation.
Le cadre de traitement de flux Delta se compose de deux modules clés : le module DSL & API et le module Runtime. Le module DSL & API fournit une API DSL et UDF (User-Defined Function) permettant aux utilisateurs d'écrire leur propre logique de traitement (par exemple, filtrage ou transformations). Le module Runtime fournit une implémentation du parseur DSL qui construit une représentation interne des étapes de traitement sous forme de modèles DAG. Le composant d'exécution interprète les modèles DAG pour initialiser les véritables opérateurs Flink et finalement exécuter l'application Flink. L'architecture du cadre est illustrée dans l'image ci-dessous.
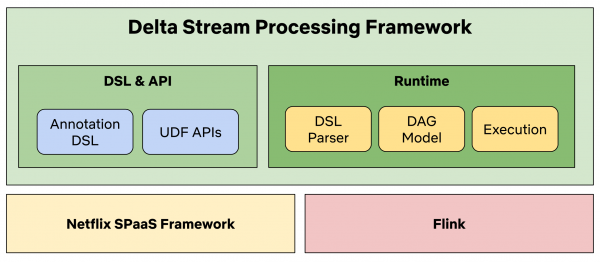
Figure 4. Architecture du cadre de traitement de flux Delta
Cette approche présente plusieurs avantages :
- Les utilisateurs peuvent se concentrer sur leur logique métier sans avoir à s'enfoncer dans les spécificités de Flink ou l'architecture SPaaS.
- L'optimisation peut être effectuée de manière transparente pour les utilisateurs, et les erreurs peuvent être corrigées sans nécessiter de modifications dans le code de l'utilisateur (UDF).
- L'utilisation d'applications Delta est simplifiée pour les utilisateurs, car la plateforme offre flexibilité et résilience par défaut et collecte de nombreuses métriques détaillées qui peuvent être utilisées pour des alertes.
Utilisation en production
Delta est en production depuis plus d'un an et joue un rôle clé dans de nombreuses applications de Netflix Studio. Elle a aidé les équipes à réaliser des cas d'utilisation tels que l'indexation de recherche, le stockage de données et les workflows pilotés par événements. Voici un aperçu de l'architecture de haut niveau de la plateforme Delta.
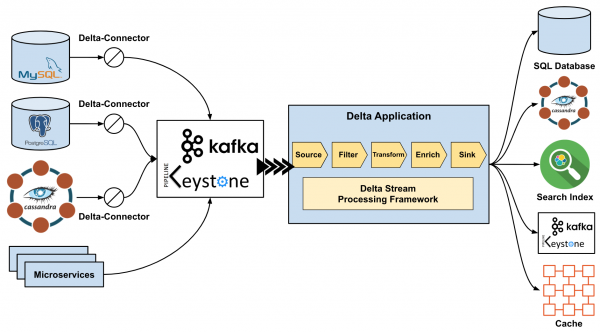
Figure 5. Architecture de haut niveau de Delta.
Remerciements
Nous tenons à remercier les personnes suivantes qui ont participé à la création et au développement de Delta chez Netflix : Allen Wang, Charles Zhao, Jaebin Yoon, Josh Snyder, Kasturi Chatterjee, Mark Cho, Olof Johansson, Piyush Goyal, Prashanth Ramdas, Raghuram Onti Srinivasan, Sandeep Gupta, Steven Wu, Tharanga Gamaethige, Yun Wang et Zhenzhong Xu.
Sources
- Martin Kleppmann, Alastair R. Beresford, Boerge Svingen : Traitement des événements en ligne. Commun. ACM 62(5) : 43–49 (2019). DOI :
: « Data Build Tool pour le stockage Amazon Redshift ».
Source : habr.com
