

Bonjour à tous ! Je m'appelle Pavel Agaletski. Je suis responsable d'équipe dans le groupe qui développe le système de livraison de Lamoda. En 2018, j'ai présenté à la conférence HighLoad++, et aujourd'hui, je souhaite vous présenter la transcription de ma présentation.
Mon thème est consacré à l'expérience de notre entreprise concernant le déploiement de systèmes et de services dans différents environnements. Nous allons passer de nos temps préhistoriques, où nous déployions tous nos systèmes sur des serveurs virtuels ordinaires, à la transition progressive de Nomad au déploiement sur Kubernetes. Je vais expliquer pourquoi nous avons fait cela et quels problèmes nous avons rencontrés au cours de ce processus.

Déploiement d'applications sur VM
Commençons par le fait qu'il y a 3 ans, tous les systèmes et services de l'entreprise étaient déployés sur des serveurs virtuels ordinaires. Tout était organisé de manière à ce que tout le code de nos systèmes était stocké et construit grâce à des outils d'assemblage automatique comme Jenkins. Grâce à Ansible, il était déployé depuis notre système de contrôle de version vers les serveurs virtuels. Chaque système au sein de notre société était déployé sur au moins 2 serveurs : l'un d'eux sur le head, l'autre sur le tail. Ces deux systèmes étaient absolument identiques dans tous leurs réglages, performances, configurations, et ainsi de suite. La seule différence entre eux était que le head recevait le trafic utilisateur, tandis que le tail n'en recevait jamais.
Pourquoi cela a-t-il été fait ?
Lorsque nous déployions de nouvelles versions de notre application, nous voulions garantir la possibilité d'un déploiement sans interruption, c'est-à-dire sans conséquences notables pour les utilisateurs. Cela a été réalisé de sorte que la nouvelle version construite soit déployée sur le tail grâce à Ansible. Là, les personnes chargées du déploiement pouvaient vérifier et s'assurer que tout fonctionnait correctement : toutes les métriques, sections et applications étaient opérationnelles ; les scripts nécessaires étaient exécutés. Ce n'est qu'après qu'ils se sont assurés que tout allait bien que le trafic était redirigé. Il a commencé à aller vers le serveur qui était précédemment en position de tail. Celui qui était auparavant en tête est resté sans trafic utilisateur, tout en conservant la version précédente de notre application.
Ainsi, pour les utilisateurs, cela s'est fait de manière transparente. Parce que le basculement est instantané, car il s'agit simplement d'un changement de load balancer. Il est très facile de revenir à la version précédente en remettant simplement le load balancer. Nous avons également pu nous assurer de la capacité de l'application en production avant même que le trafic utilisateur ne commence, ce qui était très pratique.
Quels ont été les avantages que nous avons constatés dans tout cela ?
- Tout d'abord, cela fonctionne assez bien. Cela fonctionne tout simplement. Il est clair pour tout le monde comment un tel schéma de déploiement fonctionne, car la plupart des gens ont déjà déployé sur des serveurs virtuels classiques.
- C'est assez fiable, car la technologie de déploiement est simple, éprouvée par des milliers d'entreprises. Des millions de serveurs sont déployés de cette façon. Il est difficile de casser quelque chose.
- Enfin, nous avons pu obtenir des déploiements atomiques. Des déploiements qui se produisent instantanément pour les utilisateurs, sans phase de transition perceptible entre la version ancienne et la nouvelle.
Cependant, nous avons également vu quelques inconvénients :
- En plus de l'environnement de production et de développement, il y a d'autres environnements. Par exemple, QA et préproduction. À l'époque, nous avions de nombreux serveurs et environ 60 services. Pour cette raison, nous devions maintenir une version de machine virtuelle appropriée pour chaque service. De plus, si vous souhaitez mettre à jour les bibliothèques ou ajouter de nouvelles dépendances, vous devez le faire dans tous les environnements. Il était également nécessaire de synchroniser le moment où vous souhaitez déployer la nouvelle version de votre application avec le moment où DevOps effectuera les configurations nécessaires. Dans ce cas, il est facile de se retrouver dans une situation où nos environnements diffèrent légèrement les uns des autres. Par exemple, dans l'environnement QA, il y aura une version des bibliothèques, et en production, une autre, ce qui entraînera des problèmes.
- La complexité de la mise à jour des dépendances de votre application. Cela ne dépend pas de vous, mais d'une autre équipe. À savoir, l'équipe DevOps, qui gère les serveurs. Vous devez leur assigner une tâche correspondante et leur donner une description de ce que vous souhaitez accomplir.
- À l'époque, nous voulions également diviser nos grands monolithes en petits services distincts, car nous réalisions qu'ils allaient de plus en plus se multiplier. À ce moment-là, nous en avions déjà plus de 100. Il était nécessaire de créer une nouvelle machine virtuelle pour chaque nouveau service, qui devait également être maintenue et déployée. De plus, il ne fallait pas une seule machine, mais au moins deux. À cela s'ajoutait un environnement de QA. Cela pose des problèmes et rend la création et le lancement de nouveaux systèmes plus complexes, coûteux et longs.
C'est pourquoi nous avons pris la décision qu'il serait plus pratique de passer du déploiement de machines virtuelles classiques au déploiement de nos applications dans des conteneurs Docker. Avec Docker, vous avez besoin d'un système capable de lancer l'application en cluster, car vous ne pouvez pas simplement lever un conteneur. En général, il est souhaitable de surveiller combien de conteneurs sont actifs pour qu'ils se lancent automatiquement. Pour cette raison, nous avions besoin de choisir un système de gestion.
Nous avons beaucoup réfléchi à celui que nous pouvions adopter. Le fait est qu'à ce moment-là, notre stack de déploiement sur des serveurs virtuels classiques était quelque peu obsolète, car les versions du système d'exploitation n'étaient pas les plus récentes. À un moment donné, même FreeBSD était installé, ce qui n'était pas très pratique à maintenir. Nous savions qu'il fallait migrer vers Docker le plus rapidement possible. Nos DevOps ont examiné leur expérience avec différentes solutions et ont choisi un système comme Nomad.
Transition vers Nomad
Nomad est un produit de l'entreprise HashiCorp. Ils sont également connus pour d'autres solutions :
"Consul" est un outil pour la découverte de services.
"Terraform" est un système de gestion des serveurs qui vous permet de les configurer via une infrastructure-as-code.
"Vagrant" vous permet de déployer des machines virtuelles localement ou dans le cloud grâce à des fichiers de configuration spécifiques.
À ce moment-là, Nomad semblait être une solution assez simple, vers laquelle nous pourrions rapidement migrer sans changer toute l'infrastructure. De plus, il est relativement facile à maîtriser. C'est pourquoi nous l'avons choisi comme système de filtrage pour notre conteneur.
Que faut-il pour déployer votre système dans Nomad ?
- Tout d'abord, il faut un docker image de votre application. Il est nécessaire de le compiler et de le placer dans un stockage de images Docker. Dans notre cas, cela sera Artifactory — un système qui permet de pousser divers artefacts de différents types. Il peut stocker des archives, des images Docker, des paquets composer PHP, des paquets NPM, et ainsi de suite.
- Il est également nécessaire le fichier de configuration, qui dira à Nomad ce que vous souhaitez déployer, où et en quelle quantité.
Lorsque nous parlons de Nomad, le format de fichier d'information qu'il utilise est le langage HCL, qui signifie HashiCorp Configuration Language. C'est un sur-ensemble de YAML qui vous permet de décrire votre service en termes de Nomad.
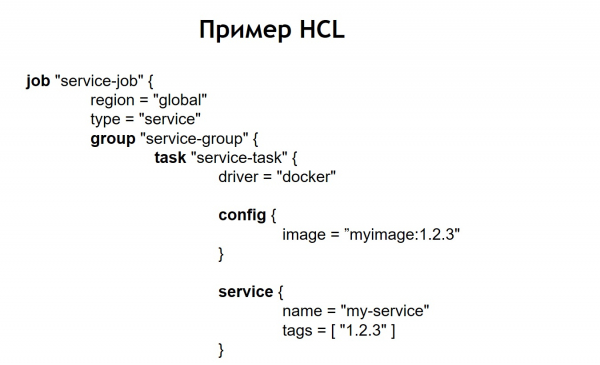
Il permet de spécifier combien de conteneurs vous souhaitez déployer, de quels images se servir et de transmettre divers paramètres lors du déploiement. Ainsi, vous fournissez ce fichier à Nomad, et il lance les conteneurs en production en accord avec celui-ci.
Dans notre cas, nous avons compris qu'il n'était pas très pratique de rédiger des fichiers HCL complètement identiques pour chaque service, car il y a beaucoup de services et il arrive parfois que nous souhaitions les mettre à jour. Il arrive qu'un service ne soit pas déployé qu'en un seul exemplaire, mais en plusieurs versions. Par exemple, l'un des systèmes que nous avons en production dispose de plus de 100 instances. Ils sont lancés à partir des mêmes images, mais diffèrent par leurs réglages de configuration et leurs fichiers de configuration.
C'est pourquoi nous avons décidé qu'il serait pratique de stocker tous nos fichiers de configuration pour le déploiement dans un dépôt commun. De cette manière, ils deviennent consultables : il est facile de les maintenir et de voir quels systèmes nous avons. En cas de besoin, il est également simple de mettre à jour ou de modifier quelque chose. Ajouter un nouveau système ne sera pas compliqué non plus — il suffit de créer un fichier de configuration dans un nouveau répertoire. À l'intérieur, il y a des fichiers : service.hcl, qui contient la description de notre service, et certains fichiers env qui permettent de configurer ce service une fois déployé en production.
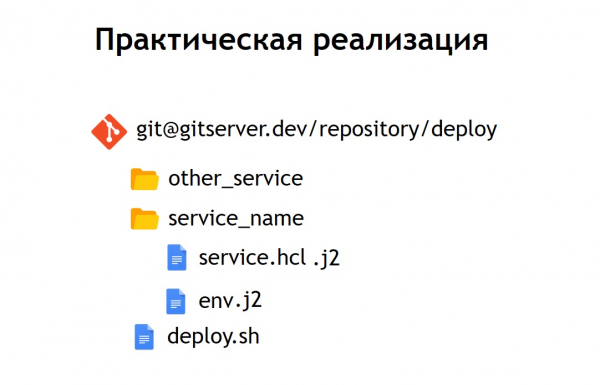
Cependant, certains de nos systèmes ne sont pas déployés en production en un seul exemplaire, mais en plusieurs simultanément. Par conséquent, nous avons décidé qu'il serait plus pratique pour nous de conserver non pas des configurations sous leur forme brute, mais plutôt sous forme de modèles. Et comme langage de modélisation, nous avons choisi jinja 2. Dans ce format, nous stockons à la fois les configs du service lui-même et les fichiers env nécessaires pour celui-ci.
De plus, nous avons placé dans le dépôt un script de déploiement commun à tous les projets, qui permet de démarrer et de déployer votre service en production, dans l'environnement souhaité, dans la cible adéquate. Lorsque nous avons transformé notre configuration HCL en modèle, le fichier HCL qui était auparavant une configuration Nomad a alors légèrement changé d'apparence.
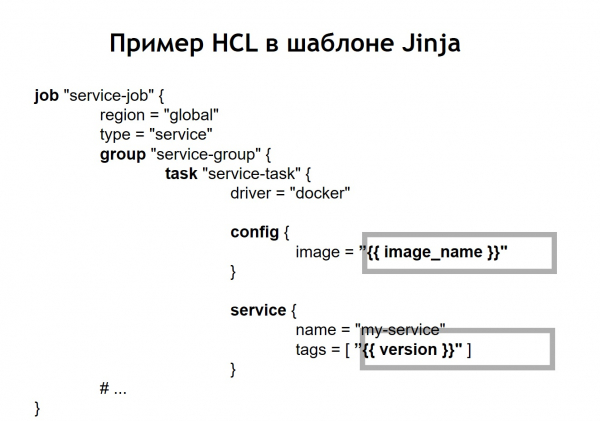
C'est-à-dire que nous avons remplacé certaines variables de la configuration par des insertions de variables, qui proviennent des fichiers env ou d'autres sources. En outre, nous avons obtenu la possibilité de générer des fichiers HCL dynamiquement, ce qui signifie que nous pouvons appliquer non seulement des insertions de variables ordinaires. Étant donné que Jinja prend en charge les boucles et les conditions, nous pouvons également créer des fichiers de configuration qui changent en fonction de l'endroit où vous déployez vos applications.
Par exemple, vous souhaitez déployer votre service en préproduction et en production. Supposons qu'en préproduction, vous ne souhaitiez pas exécuter de scripts cron, mais que vous vouliez simplement voir le service sur un domaine séparé, afin de vous assurer qu'il fonctionne. Pour quiconque déployant un service, le processus est très simple et transparent. Il suffit d'exécuter le fichier deploy.sh, d'indiquer quel service vous souhaitez déployer et dans quelle cible. Par exemple, vous souhaitez déployer un certain système en Russie, en Biélorussie ou au Kazakhstan. Il vous suffit de modifier l'un des paramètres, et un fichier de configuration correct sera généré.
Une fois que le service Nomad est déployé dans votre cluster, il apparaît comme suit.
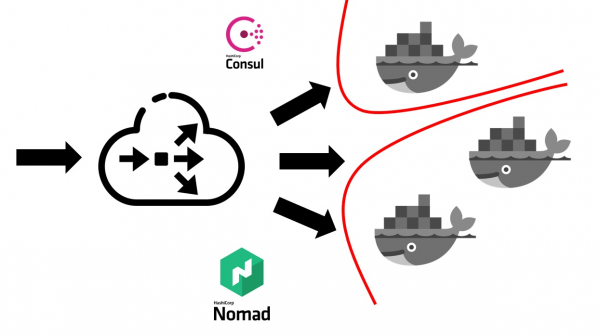
Tout d'abord, vous avez besoin d'un équilibrage de charge à l'extérieur, qui acceptera tout le trafic utilisateur. Il fonctionnera avec Consul et lui demandera où se trouve, sur quel nœud, spécifique service, qui correspond à tel ou tel nom de domaine. une adresse IP Les services dans Consul proviennent de Nomad lui-même. Étant donné qu'ils sont des produits de la même entreprise, ils sont bien liés entre eux. On peut dire que Nomad est capable de s'inscrire automatiquement pour tous les services lancés à l'intérieur de Consul.
Une fois que votre répartiteur de charge externe sait vers quel service acheminer le trafic, il le redirige vers le conteneur correspondant ou vers plusieurs conteneurs liés à votre application. Naturellement, il est également essentiel de réfléchir à la sécurité. Bien que tous les services soient lancés sur les mêmes machines virtuelles dans des conteneurs, cela nécessite généralement d'interdire l'accès libre de tout service à tout autre. Nous avons atteint cet objectif grâce à la segmentation. Chaque service était lancé dans son propre réseau virtuel, où des règles de routage et des règles de permis/refus d'accès aux autres systèmes et services étaient établies. Ceux-ci pouvaient se situer à l'intérieur comme à l'extérieur de ce cluster. Par exemple, si vous souhaitez interdire à un service de se connecter à une base de données spécifique, cela peut être accompli par la segmentation au niveau du réseau. C'est-à-dire qu'il est impossible, même par accident, de se connecter depuis un environnement de test à votre base de production.
Quel a été le coût humain du processus de transition?
La transition de toute l'entreprise vers Nomad a duré environ 5 à 6 mois. Nous avons migré service par service, mais à un rythme assez rapide. Chaque équipe devait créer ses propres conteneurs pour les services.
Nous avons adopté l'approche selon laquelle chaque équipe est responsable de ses propres images Docker. Les DevOps fournissent l'infrastructure générale nécessaire au déploiement, c'est-à-dire le support du cluster lui-même, le support du système CI, etc. À ce moment-là, plus de 60 systèmes avaient déménagé vers Nomad, ce qui a donné environ 2000 conteneurs.
Les DevOps sont responsables de l'infrastructure générale de tout ce qui concerne le déploiement et les serveurs. Chaque équipe de développement est responsable de la mise en œuvre des conteneurs pour son système spécifique, car c'est l'équipe qui sait exactement ce dont elle a besoin dans tel ou tel conteneur.
Raisons de l'abandon de Nomad
Quels avantages avons-nous obtenus en migrant vers un déploiement via Nomad et Docker, entre autres?
- Nous Nous avons assuré des conditions homogènes pour tous les environnements. Dans le développement, l'environnement QA, la préproduction et la production, les mêmes images de conteneurs avec les mêmes dépendances sont utilisées. Vous avez donc pratiquement aucune chance que ce qui parvienne en production soit différent de ce que vous avez testé localement ou dans un environnement de test.
- Nous avons également découvert qu'il suffit d'ajouter facilement un nouveau service. Tous les nouveaux systèmes en termes de déploiement sont lancés très simplement. Il suffit d'aller dans le référentiel où les configurations sont stockées, d'y ajouter une nouvelle configuration pour votre système, et vous êtes prêt. Vous pouvez déployer votre système en production sans effort supplémentaire de la part des DevOps.
- Tous fichiers de configuration dans un référentiel commun ont été examinés. Au moment où nous avons déployé nos systèmes à l'aide de serveurs virtuels, nous utilisions Ansible, où les configurations étaient dans le même référentiel. Cependant, pour la plupart des développeurs, travailler avec cela était un peu plus compliqué. Ici, le volume des configurations et du code que vous devez ajouter pour déployer le service a considérablement diminué. De plus, il est très facile pour les DevOps de le modifier ou de le changer. En cas de transitions, par exemple lors d'une nouvelle version de Nomad, ils peuvent mettre à jour massivement tous les fichiers d'exploitation qui se trouvent au même endroit.
Mais nous avons également rencontré plusieurs inconvénients :
Il s'est avéré que nous n'avons pas pu atteindre une transparence des déploiements dans le cas de Nomad. Lors du déploiement de conteneurs depuis différents environnements, il pouvait arriver qu'il soit lancé, et Nomad le considérait comme prêt à recevoir du trafic. Cela se produisait avant même que l'application à l'intérieur ait eu le temps de démarrer. Pour cette raison, le système a commencé à générer des erreurs 500 pendant une courte période, car le trafic commençait à aller vers un conteneur qui n'était pas encore prêt à l'accepter.
Nous avons rencontré certains bugs. Le principal problème réside dans le fait que Nomad ne gère pas très bien un grand cluster, surtout si vous avez beaucoup de systèmes et de conteneurs. Lorsque vous souhaitez retirer un des serveurs qui fait partie du cluster Nomad pour maintenance, il y a une probabilité assez élevée que le cluster ne fonctionne pas très bien et se désintègre. Une partie des conteneurs peut, par exemple, échouer et ne pas redémarrer – cela pourrait vous coûter cher si tous vos systèmes en production se trouvent dans le cluster géré par Nomad.
C'est pourquoi nous avons décidé de réfléchir à la direction à prendre. À ce moment-là, nous avons bien compris ce que nous voulions atteindre. En effet : nous cherchons de la fiabilité, un peu plus de fonctionnalités que ce que propose Nomad, et un système plus mature et plus stable.
Dans ce contexte, notre choix s'est porté sur Kubernetes, la plate-forme la plus populaire pour exécuter des clusters. Surtout étant donné que la taille et le nombre de nos conteneurs étaient suffisamment importants. Pour ces objectifs, Kubernetes s'est avérée être le système le plus adapté parmi ceux que nous avons envisagés.
Transition vers Kubernetes
Je vais expliquer les principaux concepts de Kubernetes et en quoi ils diffèrent de Nomad.
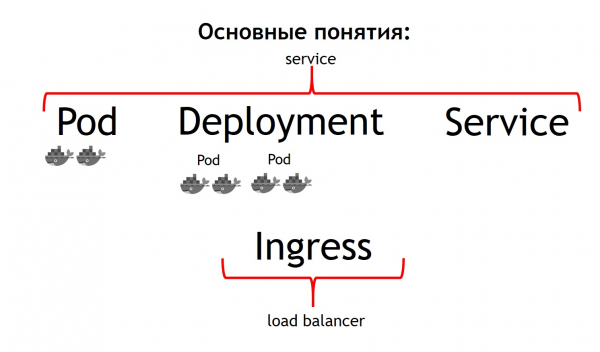
Tout d'abord, le concept le plus fondamental dans Kubernetes est celui de pod. Pod — c'est un groupe d'un ou plusieurs conteneurs qui sont toujours déployés ensemble. Ils fonctionnent comme s'ils étaient toujours strictement sur une seule machine virtuelle. Ils sont accessibles entre eux par l'adresse IP 127.0.0.1 sur différents ports.
Supposons que vous ayez une application PHP composée de nginx et php-fpm – un schéma classique. Il est probable que vous souhaitiez que les conteneurs nginx et php-fpm soient toujours ensemble. Kubernetes permet d'y parvenir en les décrivant comme un pod commun. C'est précisément ce que nous n'avons pas pu obtenir avec Nomad.
Le deuxième concept est celui de déploiement. En réalité, un pod en soi est une chose éphémère, il se lance et disparaît. Voulez-vous d'abord supprimer tous vos conteneurs précédents puis lancer directement de nouvelles versions, ou souhaitez-vous les déployer progressivement ? C'est ce processus qui est géré par le concept de déploiement. Il décrit comment vous déployez vos pods, en quelle quantité et comment les mettre à jour.
Le troisième concept est service. Votre service est en fait votre système qui reçoit un certain trafic et le redirige vers un ou plusieurs pods correspondant à votre service. Cela signifie qu'il permet de diriger tout le trafic entrant vers un service particulier avec un nom donné sur ces pods spécifiques. Il vous assure également un équilibrage de charge. Vous pouvez lancer deux pods de votre application, et tout le trafic entrant sera réparti de manière uniforme entre les pods associés à ce service.
Et le quatrième concept fondamental — Ingress. C'est un service qui s'exécute dans un cluster Kubernetes. Il agit en tant qu'équilibreur de charge externe qui reçoit toutes les requêtes. Grâce à l'API Kubernetes Ingress, il peut déterminer où ces requêtes doivent être envoyées. Il le fait de manière très flexible. Vous pouvez dire que toutes les requêtes à cet hôte et à cette URL doivent être envoyées à ce service. Et celles-ci, qui arrivent à cet hôte mais à une autre URL, doivent être envoyées à un autre service.
Ce qui est vraiment génial du point de vue du développeur d'application, c'est que vous pouvez gérer tout cela vous-même. En configurant Ingress, vous pouvez diriger tout le trafic entrant sur un API spécifique vers des conteneurs distincts, par exemple écrits en Go. Et ce trafic, qui arrive au même domaine mais à une autre URL, peut être dirigé vers des conteneurs écrits en PHP, où se trouve beaucoup de logique, mais qui ne sont pas très rapides.
Si l'on compare tous ces concepts avec Nomad, on peut dire que les trois premiers concepts constituent ensemble un Service. Quant au dernier concept, il n'existe pas dans Nomad. Nous avons utilisé un équilibreur de charge externe à sa place : cela peut être haproxy, nginx, nginx+ et ainsi de suite. Dans le cas de Kubernetes, vous n'avez pas besoin d'introduire ce concept supplémentaire séparément. Cependant, si l'on regarde Ingress en interne, c'est soit nginx, soit haproxy, soit traefik, mais intégré dans Kubernetes.
Tous les concepts que j'ai décrits sont essentiellement des ressources qui existent à l'intérieur d'un cluster Kubernetes. Pour les décrire, Kubernetes utilise un format yaml, qui est plus lisible et familier que les fichiers HCL dans le cas de Nomad. Mais structurellement, ils décrivent la même chose, par exemple pour les pods. Ils disent : je veux déployer ces pods là, avec ces images, en telle quantité.
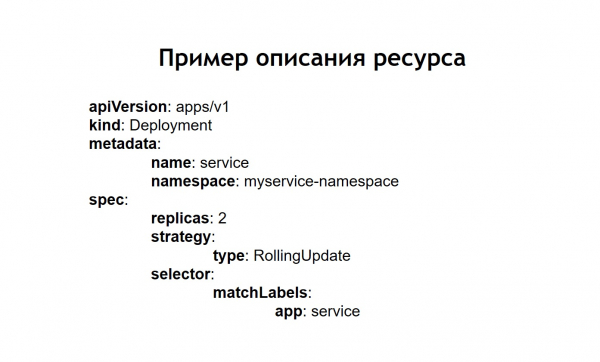
De plus, nous avons compris que nous ne souhaitions pas créer manuellement chaque ressource distincte : déploiement, services, Ingress et autres. Au lieu de cela, nous voulions, lors du déploiement, décrire chacun de nos systèmes en utilisant les termes de Kubernetes, afin de ne pas avoir à recréer manuellement toutes les dépendances nécessaires des ressources dans le bon ordre. Pour cela, nous avons choisi Helm comme système qui nous permettrait de le faire.
Concepts de base de Helm
Helm est un gestionnaire de paquets pour Kubernetes. Il est très similaire au fonctionnement des gestionnaires de paquets dans les langages de programmation. Ils vous permettent de stocker un service composé, par exemple, de déploiements nginx, de déploiements php-fpm, de configurations pour Ingress, de configmaps (c'est une entité qui vous permet de définir des env et d'autres paramètres pour votre système) sous forme des chartes appelées ainsi. Par ailleurs, Helm fonctionne au-dessus de Kubernetes. Donc, ce n'est pas un système séparé, mais juste un autre service qui s'exécute à l'intérieur du cluster. Vous interagissez avec lui via son API en utilisant une commande en ligne. Sa commodité et son attrait résident dans le fait que même si le helm plante ou si vous le supprimez du cluster, vos services ne disparaîtront pas, car le helm sert essentiellement uniquement à lancer le système. Kubernetes est ensuite responsable du bon fonctionnement et de l'état des services.
Nous avons également réalisé que la templatisation, que nous avions auparavant été contraints de réaliser nous-mêmes en intégrant jinja dans nos configurations, est l'une des principales fonctionnalités de helm. Tous les fichiers de configuration que vous créez pour vos systèmes sont stockés dans helm sous forme de modèles, semblables à jinja, mais utilisant en fait la templatisation du langage Go, dans lequel helm est écrit, tout comme Kubernetes.
Helm nous ajoute également quelques concepts supplémentaires.
Chart — c'est la description de votre service. Dans d'autres gestionnaires de paquets, cela serait appelé paquet, bundle ou quelque chose de similaire. Ici, cela s'appelle un chart.
Valeurs – ce sont les variables que vous souhaitez utiliser pour assembler vos configurations à partir des modèles.
Publication. Chaque fois qu’un service déployé avec helm reçoit une version incrémentale de la version. Helm se souvient de la configuration du service lors des précédentes versions, et ainsi de suite. Par conséquent, si vous devez revenir en arrière, il suffit d’exécuter la commande helm callback en spécifiant la version précédente. Même si la configuration correspondante n’est pas accessible dans votre dépôt au moment du retour, helm se souvient de ce qu’elle était et ramène votre système à l’état précédent.
Lorsqu’on utilise helm, les configurations habituelles pour Kubernetes se transforment également en modèles, permettant d’utiliser des variables, des fonctions et des opérateurs conditionnels. Ainsi, vous pouvez assembler la configuration de votre service en fonction de l’environnement.
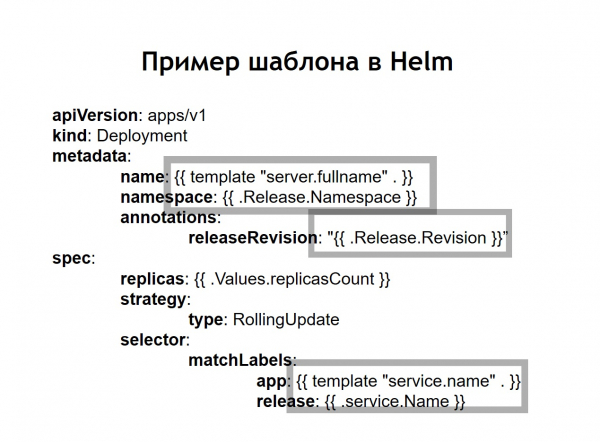
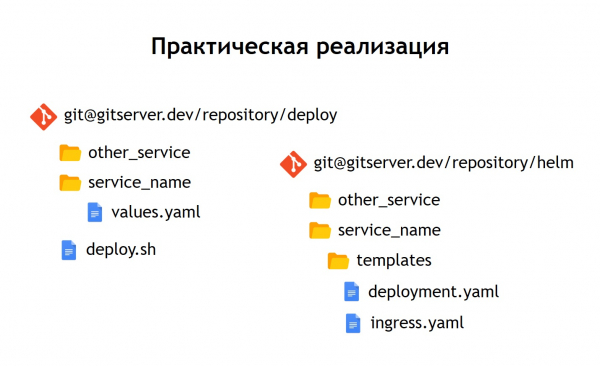
En pratique, nous avons décidé de procéder légèrement différemment par rapport à ce que nous avions fait avec Nomad. Dans Nomad, le même dépôt contenait à la fois les configurations de déploiement et les variables nécessaires pour déployer notre service. Ici, nous avons choisi de les séparer en deux dépôts distincts. Le dépôt « deploy » ne contient que les variables nécessaires pour le déploiement, tandis que le dépôt « helm » contient les configurations ou charts.
Qu'est-ce que cela nous a apporté ?
Bien que nous ne stockions pas de données réellement sensibles dans les fichiers de configuration, par exemple, les mots de passe des bases de données, qui sont stockés sous forme de secrets dans Kubernetes, il existe tout de même des éléments auxquels nous ne souhaitons pas donner un accès général. Ainsi, l’accès au dépôt « deploy » est plus restreint, tandis que le dépôt « helm » contient simplement la description du service. Pour cette raison, on peut donner un accès en toute sécurité à un plus grand nombre de personnes.
Étant donné que nous avons non seulement un environnement de production mais aussi d’autres environnements, grâce à cette séparation, nous pouvons réutiliser nos charts helm pour déployer des services non seulement en production, mais aussi, par exemple, dans un environnement QA. Même pour les déployer localement, en utilisant Minikube — c’est un outil pour le lancement local de Kubernetes.
Dans chaque référentiel, nous avons laissé une séparation en plusieurs répertoires pour chaque service. Autrement dit, chaque répertoire contient des modèles relatifs au graphique correspondant et décrivant les ressources à déployer pour lancer notre système. Dans le référentiel « deploy », nous avons laissé uniquement les en-têtes. Dans ce cas, nous n'avons pas utilisé la templatisation avec jinja, car helm fournit lui-même une templatisation par défaut – c'est l'une de ses principales fonctionnalités.
Nous avons laissé un script de déploiement – deploy.sh, qui simplifie et standardise le lancement du déploiement avec helm. Ainsi, pour quiconque souhaitant déployer, l'interface de déploiement ressemble exactement à celle utilisée lors d'un déploiement via Nomad. Le même deploy.sh, le nom de votre service, et l'endroit où vous souhaitez le déployer. Cela conduit à l'exécution de helm. Celui-ci rassemble les configurations à partir des modèles, insère les fichiers values nécessaires, puis déploie en les lançant dans Kubernetes.
Conclusions
Le service Kubernetes semble plus complexe que Nomad.
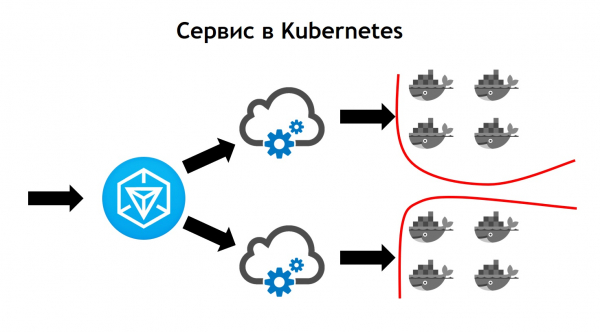
Ici, le trafic sortant arrive dans Ingress. C'est le contrôleur frontal qui prend en charge toutes les requêtes et les envoie ensuite aux services correspondant aux données de la requête. Il les détermine en fonction des configurations, qui font partie de la description de votre application dans helm et qui sont définies par les développeurs eux-mêmes. Le service envoie les requêtes à ses pods, c'est-à-dire des conteneurs spécifiques, équilibrant le trafic entrant entre tous les conteneurs liés à ce service. Et bien sûr, il ne faut pas oublier que nous ne devons pas négliger la sécurité au niveau du réseau. Ainsi, dans le cluster Kubernetes, une segmentation basée sur le balisage est mise en œuvre. Tous les services ont des balises spécifiques auxquelles sont attachés les droits d'accès des services à certaines ressources externes/internes à l'intérieur ou à l'extérieur du cluster.
En faisant la transition, nous avons constaté que Kubernetes possède toutes les fonctionnalités de Nomad, que nous utilisions auparavant, tout en ajoutant beaucoup de nouveautés. Il peut être étendu via des plugins, et en fait, via des types de ressources personnalisés. Cela signifie que vous avez la possibilité de ne pas seulement utiliser ce qui est standard dans Kubernetes, mais de créer votre propre ressource et service qui interagira avec votre ressource. Cela offre des possibilités d'extension supplémentaires pour votre système sans avoir besoin de réinstaller Kubernetes ou de procéder à des modifications.
Un exemple d'utilisation est Prometheus, qui s'exécute dans notre cluster Kubernetes. Pour qu'il commence à collecter des métriques d'un service donné, nous devons ajouter un type de ressource supplémentaire dans la description du service, appelé le service-monitor. Grâce au fait que Prometheus peut lire les types de ressources personnalisés lorsqu'il est lancé dans Kubernetes, il commence automatiquement à collecter des métriques de ce nouveau système. C'est assez pratique.
Le premier déploiement que nous avons effectué dans Kubernetes a eu lieu en mars 2018. Et pendant tout ce temps, nous n'avons jamais rencontré de problèmes. Il fonctionne de manière assez stable sans bugs significatifs. De plus, nous pouvons l'étendre davantage. À ce jour, nous disposons des fonctionnalités qu'il offre, et nous apprécions beaucoup la rapidité d'évolution de Kubernetes. Actuellement, plus de 3000 conteneurs sont exécutés dans Kubernetes. Le cluster couvre plusieurs nœuds. Il est en service, stable et très contrôlé.
Source : habr.com
