

Bonjour à tous ! Dans le cadre de mon travail de cours, j'ai étudié les possibilités d'une plateforme cloud nationale telle que . La plateforme propose divers services pour résoudre des problèmes pratiques. Cependant, il est parfois nécessaire de configurer votre propre application cloud avec une infrastructure assez complexe basée sur ces services. Dans cet article, je souhaite partager mon expérience de déploiement d'une telle application.
Que souhaite-t-on obtenir ?
— un outil puissant pour résoudre des tâches analytiques ou de surveillance de certains systèmes. Dans sa configuration de base, il s'agit d'une machine virtuelle avec un serveur web Grafana, ainsi qu'une base de données (ClickHouse, InfluxDB, etc.) avec un ensemble de données sur lequel l'analyse sera basée.
Après le démarrage de la machine virtuelle avec le serveur web, il sera possible d'accéder à son hôte et d'obtenir une interface utilisateur élégante, de spécifier des bases de données comme sources pour un travail ultérieur, de créer des tableaux de bord et des graphiques.
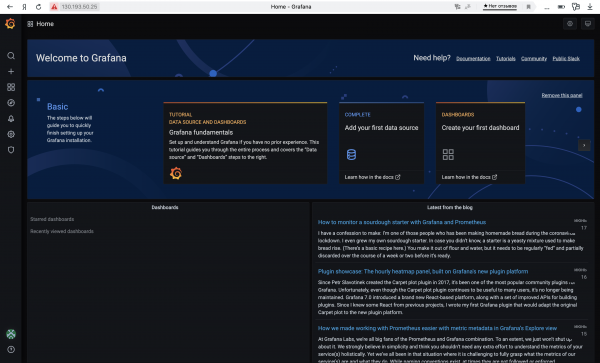
La version de base présente un inconvénient majeur : elle n'est pas du tout tolérante aux pannes. Cela signifie que le bon fonctionnement de l'application dépend de la viabilité d'une seule machine virtuelle. Si celle-ci tombe en panne ou si 10 personnes ouvrent simultanément l'interface utilisateur, des problèmes surgiront.
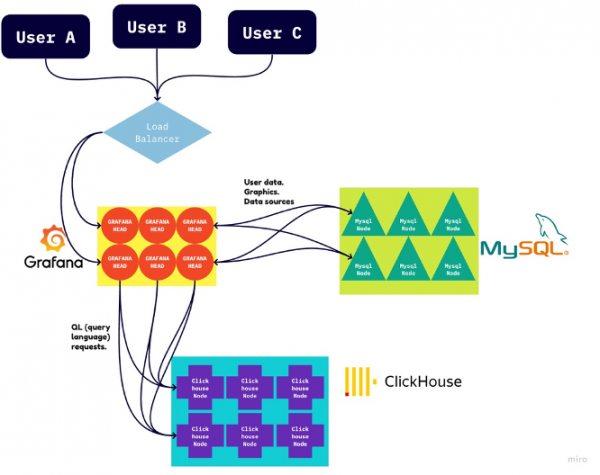
Ces problèmes se résolvent simplement : il suffit de… déployer plusieurs machines virtuelles identiques avec un serveur web et de les placer derrière un équilibreur de charge L3. Mais ici, ce n'est pas si simple. Grafana stocke les paramètres utilisateur (chemins vers les bases de données, tableaux de bord, graphiques, etc.) directement sur le disque de sa machine virtuelle. Ainsi, si vous modifiez certains paramètres dans l'interface utilisateur, ces modifications ne s'afficheront que sur la machine virtuelle à laquelle l'équilibreur de charge nous a envoyés. Cela entraînera des paramètres incohérents de notre application, provoquant des problèmes de lancement et d'utilisation.
Ici, une autre base de données, comme MySQL ou son équivalent, viendra à la rescousse. Nous disons à Grafana qu'elle doit stocker les paramètres utilisateur précisément dans cette base "de secours". Ensuite, il suffira de spécifier une fois à chaque machine le chemin vers cette base de données, et tous les autres paramètres utilisateur pourront être modifiés sur n'importe quelle machine virtuelle, ils seront répercutés sur les autres.
Voici le schéma de l'infrastructure finale de l'application :
Nous allons apprendre à déployer nous-mêmes
MySQL et ClickHouse
Avant de déployer une telle application par un simple clic, il fallait apprendre à monter chaque composant manuellement et à les intégrer les uns aux autres.
Ici, Yandex.Cloud nous aidera, offrant des équilibreurs L3, ClickHouse et MySQL en tant que services managés. L'utilisateur n'a qu'à spécifier les paramètres et attendre que la plateforme mette tout en état de fonctionnement.
Je me suis inscrit, j'ai créé un nuage et un compte de paiement. Ensuite, j'ai accédé au nuage et j'ai démarré des clusters MySQL et ClickHouse avec des réglages minimaux. J'ai attendu qu'ils deviennent actifs.
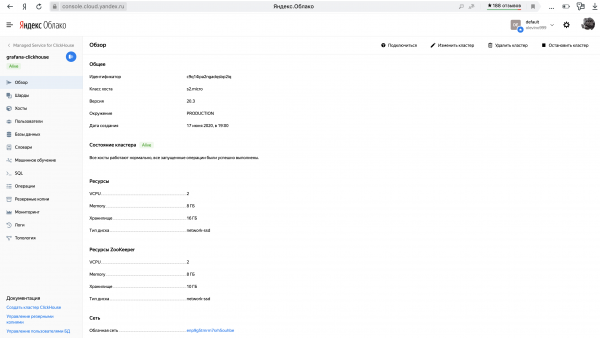
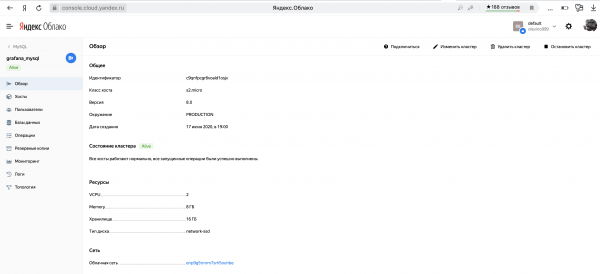
Il ne faut pas oublier de créer une base de données dans chaque cluster et de configurer l'accès avec un identifiant et un mot de passe. Je ne vais pas entrer dans les détails ici — l'interface est assez évidente.
Un détail moins évident était que ces bases de données avaient de nombreux hôtes qui assurent leur haute disponibilité. Cependant, Grafana nécessite exactement un hôte pour chaque base de données avec laquelle elle travaille. L'utilisation du cloud m'a conduit à la solution. Il s'avère que l'hôte du type c-<cluster_id>.rw.mdb.yandexcloud.net correspond à l'hôte maître actif actuel du cluster avec l'identifiant correspondant. C'est celui que nous transmettrons à Grafana.
Serveur web
Maintenant, il nous reste à configurer le serveur web. Nous allons démarrer une machine virtuelle classique sous Linux et configurer Grafana manuellement.
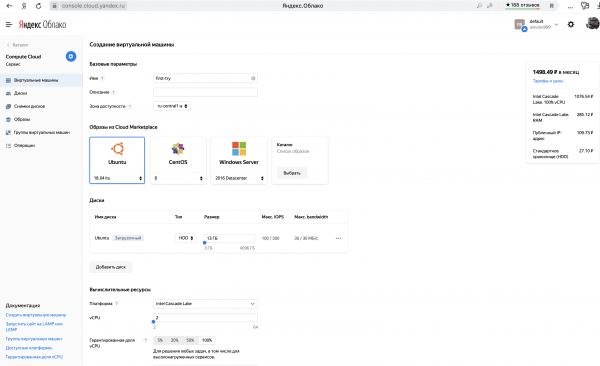
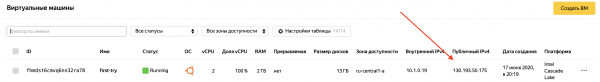
Connectons-nous par ssh et installons les paquets nécessaires.
sudo apt-get install -y apt-transport-https software-properties-common wget
wget -q -O - https://packages.grafana.com/gpg.key | sudo apt-key add -
sudo add-apt-repository "deb https://packages.grafana.com/enterprise/deb stable main"
sudo apt-get update
sudo apt-get install -y grafana-enterprise
Après cela, nous allons lancer Grafana avec systemctl et installer le plugin pour ClickHouse (oui, il n'est pas inclus dans la configuration de base).
sudo systemctl start grafana-server
sudo systemctl enable grafana-server
sudo grafana-cli plugins install vertamedia-clickhouse-datasource
C'est bon, après cela, avec la simple commande
sudo service grafana-server startnous allons démarrer le serveur web. Vous pourrez maintenant entrer l'adresse IP externe de la machine virtuelle dans le navigateur, spécifier le port 3000 et voir la belle interface de Grafana.
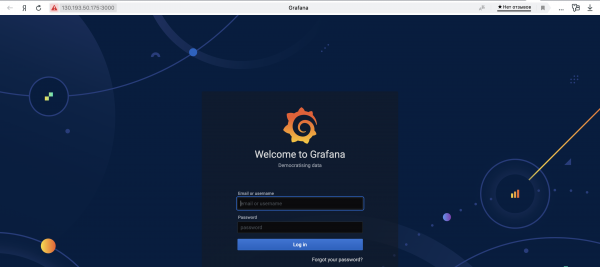
Mais ne soyez pas pressé, avant de configurer Grafana, n'oubliez pas de lui indiquer le chemin vers MySQL pour stocker les réglages là-bas.
Toute la configuration du serveur web de Grafana se trouve dans le fichier /etc/grafana/grafana.ini. La ligne à rechercher est la suivante :
;url =Nous configurons l'hôte pour le cluster MySQL. Dans ce fichier se trouvent le nom d'utilisateur et le mot de passe pour accéder à Grafana, comme indiqué dans l'image ci-dessus, qui sont tous deux par défaut identiques. admin.
Vous pouvez utiliser les commandes sed :
sudo sed -i "s#.*;url =.*#url = mysql://{MYSQL_USERNAME}:{MYSQL_PASSWORD}@{MYSQL_CLUSTER_URI}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = {GRAFANA_USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = {GRAFANA_PASSWORD}#" /etc/grafana/grafana.ini
C'est le moment de redémarrer le serveur web !
sudo service grafana-server restartMaintenant, dans l'interface utilisateur de Grafana, nous allons spécifier ClickHouse comme source de données.
J'ai réussi à obtenir une configuration fonctionnelle avec les paramètres suivants :
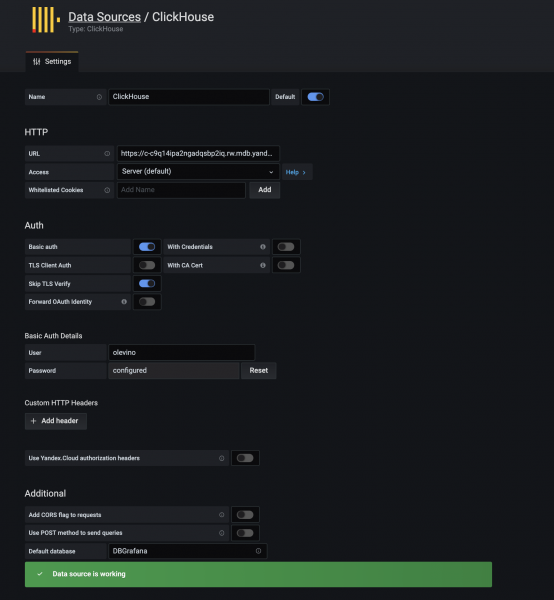
J'ai indiqué en tant qu'URL https://c-.rw.mdb.yandexcloud.net:8443
Voilà ! Nous avons une machine virtuelle opérationnelle avec un serveur web connecté à ClickHouse et MySQL. Nous pouvons déjà charger un ensemble de données dans ClickHouse et créer des tableaux de bord. Cependant, nous n'avons pas encore atteint notre objectif et nous n'avons pas déployé une infrastructure complète.
Packer
Yandex.Cloud permet de créer une image de disque d'une machine virtuelle existante et, sur cette base, de créer autant de machines identiques que souhaité. C'est exactement ce que nous allons faire. Pour rassembler l'image de manière pratique, nous allons utiliser l'outil de HashiCorp. Il prend en entrée un fichier JSON contenant les instructions pour créer l'image.
Notre fichier JSON sera composé de deux blocs : builders et provisioners. Le premier bloc décrit les paramètres de l'image elle-même en tant qu'entité, tandis que le second contient les instructions pour la remplir du contenu nécessaire.
Builders
{
"builders": [
    {
      "type": "yandex",
      "endpoint": "{{user `endpoint`}}",
      "folder_id": "",
      "subnet_id": "{{user `subnet_id`}}",
      "zone": "{{user `zone`}}",
      "labels": {},
      "use_ipv4_nat": true,
      "use_internal_ip": false,
      "service_account_key_file": "",
      "image_name": "grafana-{{timestamp}}",
      "image_family": "grafana",
      "image_labels": {},
      "image_description": "GRAFANA",
      "source_image_family": "ubuntu-1804-lts",
      "disk_size_gb": 3,
      "disk_type": "network-hdd",
      "ssh_username": "ubuntu"
    }
  ],
...
}
Dans ce modèle, vous devez définir l'identifiant de la section dans le cloud où vous souhaitez créer l'image, ainsi que le chemin vers le fichier contenant les clés du compte de service, préalablement configuré dans cette section. Pour en savoir plus sur la création de comptes de service et de clés sous forme de fichiers, vous pouvez lire la section correspondante. .
Cette configuration indique que l'image disque sera construite sur la base de la plateforme ubuntu-1804-lts, placée dans la section appropriée de l'utilisateur dans la famille d'images GRAFANA sous le nom grafana-{{timestamp}}.
Provisioners
Voici maintenant la partie la plus intéressante de la configuration. Elle décrira la séquence d'actions à réaliser sur la machine virtuelle avant de figer son état dans une image disque.
{
...,
"provisioners": [
    {
            "type": "shell",
            "pause_before": "5s",
            "scripts": [
                "prepare-ctg.sh"
            ]
        },
    {
            "type": "file",
            "source": "setup.sh",
            "destination": "\/opt\/grafana\/setup.sh"
        },
        {
            "type": "shell",
        "execute_command": "sudo {{ .Vars }} bash '{{ .Path }}'",
            "pause_before": "5s",
            "scripts": [
                "install-packages.sh",
                "grafana-setup.sh",
                "run-setup-at-reboot.sh"
        ]
        }
  ]
}
Toutes les actions sont ici divisées en 3 étapes. La première étape consiste à exécuter un simple script qui crée un répertoire auxiliaire.
prepare-ctg.sh :
#!/bin/bash
sudo mkdir -p /opt/grafana
sudo chown -R ubuntu:ubuntu /opt/grafana
À l'étape suivante, nous plaçons dans ce répertoire un script qui devra être exécuté immédiatement après le démarrage de la machine virtuelle. Ce script écrira les variables utilisateur qui doivent être enregistrées dans la configuration de Grafana et redémarrera le serveur web.
setup.sh :
#!/bin/bash
CLUSTER_ID="<cluster_id>"
USERNAME="<username>"
PASSWORD="<password>"
sudo sed -i "s#.*;url =.*#url = mysql://${USERNAME}:${PASSWORD}@c-${CLUSTER_ID}.rw.mdb.yandexcloud.net#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = ${USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = ${PASSWORD}#" /etc/grafana/grafana.ini
sudo service grafana-server restart
Il reste alors 3 choses à faire :
1) installer les paquets
2) démarrer Grafana avec systemctl et installer le plugin ClickHouse
3) placer le script setup.sh dans la file d'attente de démarrage immédiatement après la mise sous tension de la machine virtuelle.
install-packages.sh :
#!/bin/bash
sudo systemd-run --property='After=apt-daily.service apt-daily-upgrade.service' --wait /bin/true
sudo apt-get install -y apt-transport-https
sudo apt-get install -y software-properties-common wget
wget -q -O - https://packages.grafana.com/gpg.key | sudo apt-key add -
sudo add-apt-repository "deb https://packages.grafana.com/enterprise/deb stable main"
sudo apt-get update
sudo apt-get install -y grafana-enterprise
grafana-setup.sh :
#!/bin/bash
sudo systemctl start grafana-server
sudo systemctl enable grafana-server
sudo grafana-cli plugins install vertamedia-clickhouse-datasource
run-setup-at-reboot.sh :
#!/bin/bash
chmod +x /opt/grafana/setup.sh
cat > /etc/cron.d/first-boot <<EOF
PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin:/usr/games:/usr/local/games
@reboot root /bin/bash /opt/grafana/setup.sh > /var/log/yc-setup.log 2>&1
EOF
chmod +x /etc/cron.d/first-boot;
Il ne reste plus qu'à lancer Packer et à obtenir en sortie une image enregistrée dans la section spécifiée. Lors de la création de la machine virtuelle, il sera possible de la sélectionner comme disque de démarrage et d'obtenir un serveur web Grafana prêt à l'emploi après son démarrage.
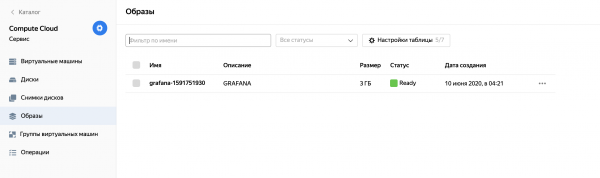
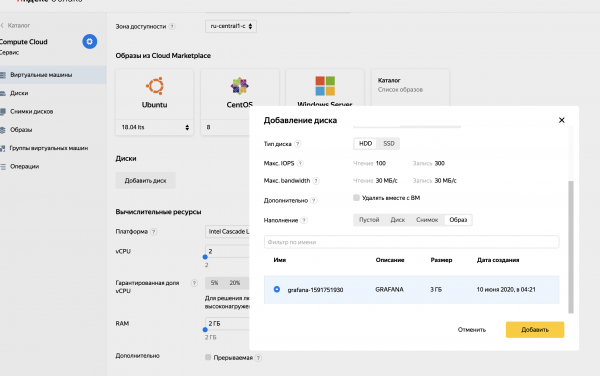
Groupe d'instances et équilibreur
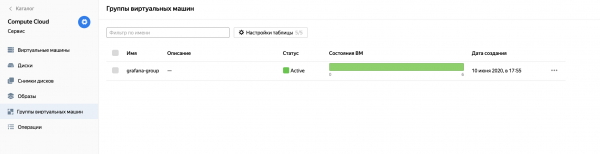
Une fois que l'image disque permettant de créer de nombreux serveurs web Grafana identiques est disponible, nous pouvons créer un groupe d'instances. Sur la plateforme Yandex.Cloud, ce terme désigne un ensemble de machines virtuelles ayant des caractéristiques identiques. Lors de la création d'un groupe d'instances, le prototype de toutes les machines de ce groupe est configuré, puis les caractéristiques du groupe lui-même (par exemple, le nombre minimum et maximum de machines actives). Si le nombre actuel ne respecte pas ces critères, le groupe d'instances supprimera les machines inutiles ou en créera de nouvelles à l'image et à la ressemblance de l'original.
Dans le cadre de notre tâche, nous allons créer un groupe d'instances de serveurs web qui seront générés à partir de l'image disque créée précédemment.
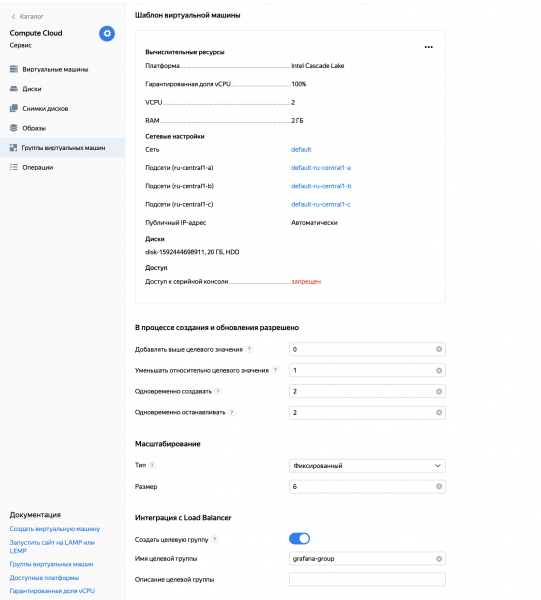
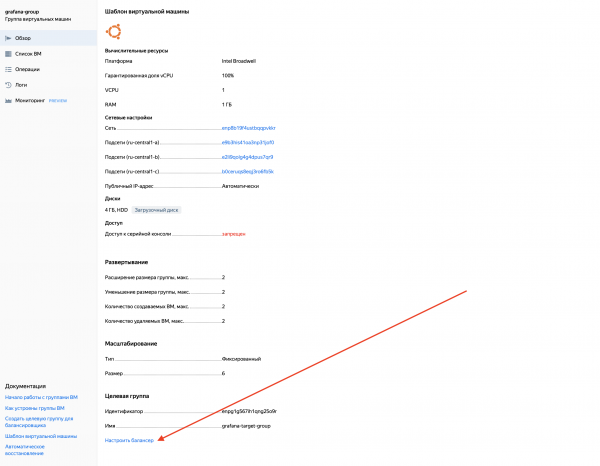
La dernière configuration du groupe d'instances est vraiment remarquable. Le groupe cible, en intégration avec le Load Balancer, permet de configurer un équilibrage L3 au-dessus des machines virtuelles de ce groupe d'un simple clic.
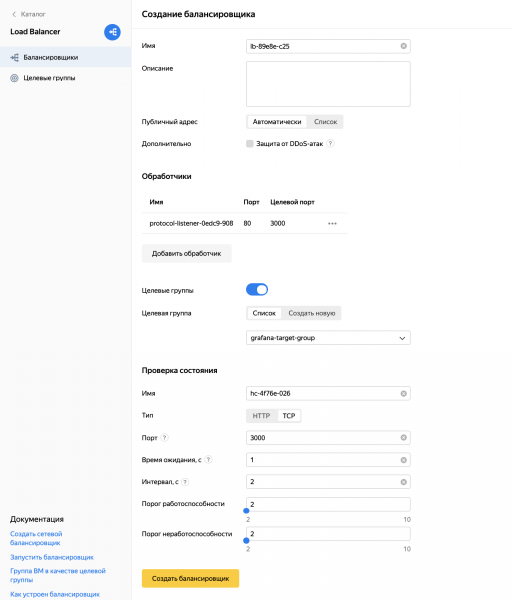
Lors de la configuration de l'équilibrage, j'ai mis en œuvre deux points importants :
- J'ai configuré le Load Balancer pour qu'il accepte le trafic utilisateur sur le port 80 et le redirige vers le port 3000 des machines virtuelles, là où se trouve Grafana.
- J'ai mis en place un contrôle de la disponibilité des machines en les pingant sur le port 3000.
Mini-bilan
Enfin, nous avons pu déployer manuellement l'infrastructure d'application souhaitée, et nous disposons maintenant d'un service Grafana hautement disponible. Il suffit de connaître l'adresse IP du Load Balancer comme point d'entrée dans l'application et l'hôte du cluster ClickHouse pour y charger le jeu de données.
Cela semble être une victoire ? Oui, une victoire. Mais quelque chose semble déranger. L'ensemble du processus ci-dessus nécessite beaucoup d'actions manuelles et n'est pas du tout évolutif, et il serait souhaitable de l'automatiser autant que possible. Cela sera le sujet de la section suivante.
Intégration avec Terraform
Nous allons à nouveau utiliser l'outil de HashiCorp nommé . Il permettra de déployer toute l'infrastructure de l'application d'un simple clic, en se basant sur plusieurs variables fournies par l'utilisateur. Rédigeons une recette qui pourra être exécutée plusieurs fois dans différentes sections de différents utilisateurs.
Tout le travail avec Terraform se résume à la rédaction d'un fichier de configuration (*.tf) et à la création d'infrastructure basée sur celui-ci.
Variables
Au début du fichier, nous allons définir les variables dont dépendra le déploiement de l'infrastructure future.
variable "oauth_token" {
    type = string
    default = ""
}
variable "cloud_id" {
    type = string
    default = ""
}
variable "folder_id" {
    type = string
    default = ""
}
variable "service_account_id" {
    type = string
    default = ""
}
variable "image_id" {
    type = string
    default = ""
}
variable "username" {
    type = string
    default = ""
}
variable "password" {
    type = string
    default = ""
}
variable "dbname" {
    type = string
    default = ""
}
variable "public_key_path" {
    type = string
    default = ""
}
L'ensemble du processus de déploiement de l'application se résumera à la création d'une image de disque et à l'attribution de ces variables. Je vais expliquer à quoi elles servent :
oauth_token — un token d'accès au cloud. Peut être obtenu via .
cloud_id — l'identifiant du cloud dans lequel nous déploierons l'application
folder_id — identifiant de la section où nous allons déployer l'application
service_account_id — identifiant du compte de service dans la section correspondante du cloud.
image_id — identifiant de l'image disque obtenue à l'aide de Packer
username et password — nom d'utilisateur et mot de passe pour accéder aux deux bases de données et au serveur web Grafana
dbname — nom de la base de données dans les clusters CH et MySQL
public_key_path — chemin vers le fichier contenant votre clé ssh publique, qui vous permettra de vous connecter au nom ubuntu aux machines virtuelles avec serveurs web
Configuration du fournisseur
Nous allons maintenant configurer le fournisseur Terraform — dans notre cas Yandex :
provider "yandex" {
  token     = var.oauth_token
  cloud_id  = var.cloud_id
  folder_id = var.folder_id
  zone      = "ru-central1-a"
}
On peut remarquer que nous utilisons ici des variables définies ci-dessus.
Réseau et clusters
Nous allons maintenant créer un réseau où les éléments de notre infrastructure vont communiquer, trois sous-réseaux (un dans chaque région) et déployer des clusters CH et MySQL.
resource "yandex_vpc_network" "grafana_network" {}

resource "yandex_vpc_subnet" "subnet_a" {
  zone           = "ru-central1-a"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.1.0.0\/24"]
}

resource "yandex_vpc_subnet" "subnet_b" {
  zone           = "ru-central1-b"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.2.0.0\/24"]
}

resource "yandex_vpc_subnet" "subnet_c" {
  zone           = "ru-central1-c"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.3.0.0\/24"]
}

resource "yandex_mdb_clickhouse_cluster" "ch_cluster" {
  name        = "grafana-clickhouse"
  environment = "PRODUCTION"
  network_id  = yandex_vpc_network.grafana_network.id

  clickhouse {
    resources {
      resource_preset_id = "s2.micro"
      disk_type_id       = "network-ssd"
      disk_size          = 16
    }
  }

  zookeeper {
    resources {
      resource_preset_id = "s2.micro"
      disk_type_id       = "network-ssd"
      disk_size          = 10
    }
  }

  database {
    name = var.dbname
  }

  user {
    name     = var.username
    password = var.password
    permission {
      database_name = var.dbname
    }
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }
}

resource "yandex_mdb_mysql_cluster" "mysql_cluster" {
  name        = "grafana_mysql"
  environment = "PRODUCTION"
  network_id  = yandex_vpc_network.grafana_network.id
  version     = "8.0"

  resources {
    resource_preset_id = "s2.micro"
    disk_type_id       = "network-ssd"
    disk_size          = 16
  }

  database {
    name = var.dbname
  }

  user {
    name     = var.username
    password = var.password
    permission {
      database_name = var.dbname
      roles         = ["ALL"]
    }
  }

  host {
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }
  host {
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }
  host {
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }
}
Comme on peut le constater, chacun des deux clusters est suffisamment tolérant aux pannes grâce à son déploiement dans trois zones de disponibilité.
Serveurs web
On pourrait penser que l'on peut continuer de cette manière, mais j'ai rencontré une difficulté. Auparavant, je configurais d'abord le cluster MySQL et uniquement après, connaissant son ID, je construisais l'image du disque avec la configuration souhaitée, dans laquelle je spécifiais l'hôte du cluster. Mais maintenant, nous ne connaissons pas l'ID du cluster avant l'exécution de Terraform, y compris au moment de la création de l'image. Il a donc fallu recourir à ce qui suit. .
En utilisant le service de métadonnées d'Amazon, nous allons transmettre certaines paramètres à la machine virtuelle, qu'elle va accepter et traiter. Nous devons nous assurer qu'après le démarrage, la machine aille chercher les métadonnées pour l'hôte du cluster MySQL ainsi que le nom d'utilisateur et le mot de passe que l'utilisateur a indiqués dans le fichier Terraform. Nous allons légèrement modifier le contenu du fichier. setup.sh, qui est exécuté au démarrage de la machine virtuelle.
setup.sh :
#!/bin/bash
CLUSTER_URI="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/mysql_cluster_uri)"
USERNAME="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/username)"
PASSWORD="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/password)"
sudo sed -i "s#.*;url =.*#url = mysql://${USERNAME}:${PASSWORD}@${CLUSTER_URI}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = ${USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = ${PASSWORD}#" /etc/grafana/grafana.ini
sudo service grafana-server restart
Groupe d'instances et équilibreur
Après avoir reconstruit la nouvelle image du disque, nous pouvons enfin compléter notre fichier pour Terraform.
Indiquons que nous voulons utiliser une image de disque existante :
data "yandex_compute_image" "grafana_image" {
  image_id = var.image_id
}
Créons maintenant le groupe d'instances :
resource "yandex_compute_instance_group" "grafana_group" {
  name               = "grafana-group"
  folder_id          = var.folder_id
  service_account_id = var.service_account_id
  instance_template {
    platform_id = "standard-v1"
    resources {
      memory = 1
      cores  = 1
    }
    boot_disk {
      mode = "READ_WRITE"
      initialize_params {
        image_id = data.yandex_compute_image.grafana_image.id
        size     = 4
      }
    }
    network_interface {
      network_id = yandex_vpc_network.grafana_network.id
      subnet_ids = [yandex_vpc_subnet.subnet_a.id, yandex_vpc_subnet.subnet_b.id, yandex_vpc_subnet.subnet_c.id]
      nat = "true"
    }
    metadata = {
      mysql_cluster_uri = "c-${yandex_mdb_mysql_cluster.mysql_cluster.id}.rw.mdb.yandexcloud.net:3306/${var.dbname}"
      username = var.username
      password = var.password
      ssh-keys = "ubuntu:${file("${var.public_key_path}")}"
    }
    network_settings {
      type = "STANDARD"
    }
  }

  scale_policy {
    fixed_scale {
      size = 6
    }
  }

  allocation_policy {
    zones = ["ru-central1-a", "ru-central1-b", "ru-central1-c"]
  }

  deploy_policy {
    max_unavailable = 2
    max_creating    = 2
    max_expansion   = 2
    max_deleting    = 2
  }

  load_balancer {
    target_group_name = "grafana-target-group"
  }
}
Il convient de noter comment nous avons passé dans les métadonnées cluster_uri, username et password. C'est ce que la machine virtuelle récupérera et mettra dans la configuration de Grafana au démarrage.
Il ne reste plus qu'à configurer l'équilibreur.
resource "yandex_lb_network_load_balancer" "grafana_balancer" {
  name = "grafana-balancer"

  listener {
    name = "grafana-listener"
    port = 80
    target_port = 3000
    external_address_spec {
      ip_version = "ipv4"
    }
  }

  attached_target_group {
    target_group_id = yandex_compute_instance_group.grafana_group.load_balancer.0.target_group_id

    healthcheck {
      name = "healthcheck"
      tcp_options {
        port = 3000
      }
    }
  }
}
Un peu de sucre
Il reste juste une petite tâche. Une fois l'infrastructure déployée, il faudra se rendre dans l'interface utilisateur de Grafana et ajouter manuellement le cluster CH (dont l'ID doit encore être récupéré) comme source de données. Mais Terraform connaît l'ID du cluster. Confions-lui la tâche de finaliser cela.
Nous allons ajouter un nouveau fournisseur — Grafana, et en tant qu'hôte, nous lui fournirons l'adresse IP du répartiteur de charge. Tous les changements que Terraform effectuera sur la machine déterminée par son répartiteur de charge se répercuteront dans MySQL, et donc sur toutes les autres machines.
provider "grafana" {
  url  = "http://${[for s in yandex_lb_network_load_balancer.grafana_balancer.listener: s.external_address_spec.0.address].0}"
  auth = "${var.username}:${var.password}"
}

resource "grafana_data_source" "ch_data_source" {
  type          = "vertamedia-clickhouse-datasource"
  name          = "grafana"
  url           = "https://c-${yandex_mdb_clickhouse_cluster.ch_cluster.id}.rw.mdb.yandexcloud.net:8443"
  basic_auth_enabled = "true"
  basic_auth_username = var.username
  basic_auth_password = var.password
  is_default = "true"
  access_mode = "proxy"
}
Peignez
Nous allons extraire l'adresse IP du répartiteur de charge et l'hôte du cluster ClickHouse
output "grafana_balancer_ip_address" {
  value = [for s in yandex_lb_network_load_balancer.grafana_balancer.listener: s.external_address_spec.0.address].0
}

output "clickhouse_cluster_host" {
  value = "https://c-${yandex_mdb_clickhouse_cluster.ch_cluster.id}.rw.mdb.yandexcloud.net:8443"
}
Prêt à démarrer
C'est tout ! Notre fichier de configuration est prêt et nous pouvons, en définissant les variables, dire à Terraform de déployer tout ce que nous avons décrit ci-dessus. Tout le processus m'a pris environ 15 minutes.
À la fin, vous pourrez voir un beau message :
Application complète ! Ressources : 9 ajoutées, 0 modifiées, 0 détruites.
Outputs:

clickhouse_cluster_host = https://c-c9q14ipa2ngadqsbp2iq.rw.mdb.yandexcloud.net:8443
grafana_balancer_ip_address = 130.193.50.25
Et dans le cloud, les éléments de l'infrastructure déployée seront visibles :
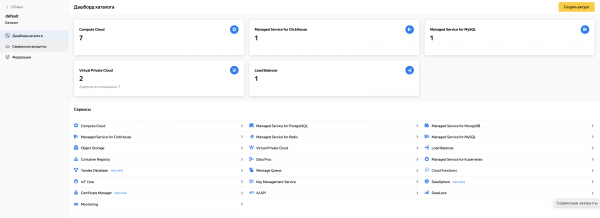
Pour résumer
Maintenant, avec l'exemple de Grafana, chacun de vous sait comment déployer des applications avec une architecture cloud distribuée sur la plateforme Yandex.Cloud. Des outils utiles de HashiCorp, comme Packer et Terraform, peuvent vous aider dans cette tâche. J'espère que cet article sera utile à quelqu'un 🙂
P.S. Je vais inclure ci-dessous un lien vers le référentiel où vous pouvez trouver des recettes prêtes à l'emploi pour Packer et Terraform, dont j'ai extrait des fragments dans cet article.
Source : habr.com
