

Partie 1 : Web / Android
Remarque: cet article est une traduction en français de l'article original Cependant, toutes les illustrations, références, citations et termes sont conservés dans leur langue d'origine pour éviter toute déformation de sens lors de la traduction en français. Je vous souhaite une bonne étude !
Actuellement, le métier DevOps est l'un des plus recherchés dans l'industrie informatique. Si vous consultez les sites web populaires de recherche d'emploi et appliquez un filtre sur les salaires, vous constaterez que les offres d'emploi liées à DevOps figurent en tête de liste. Cependant, il est important de comprendre que cela s'applique principalement au poste de 'Senior', ce qui implique que le candidat possède un haut niveau de compétences ainsi qu'une connaissance des technologies et des outils. Cela s'accompagne également d'un haut degré de responsabilité, lié à un fonctionnement ininterrompu de la production. Cependant, nous avons tendance à oublier ce qu'est DevOps. À l'origine, ce n'était pas une personne ou un département spécifique. Si nous cherchons des définitions de ce terme, nous trouverons de nombreux substantifs élégants et corrects, tels que méthodologie, pratiques, philosophie culturelle, ensemble de concepts, etc.
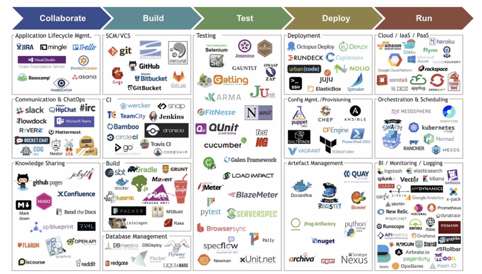
Ma spécialité est ingénieur en automatisation des tests (QA automation engineer), mais je considère qu'elle ne doit pas être seulement liée à l'écriture de tests automatisés ou à la conception de l'architecture d'un framework de tests. En 2020, les connaissances en infrastructure d'automatisation sont également nécessaires. Cela permet d'organiser le processus d'automatisation de manière autonome, depuis le lancement des tests jusqu'à la communication des résultats à toutes les parties prenantes conformément aux objectifs fixés. En conséquence, les compétences en DevOps sont un facteur essentiel pour accomplir ce travail. Et tout cela est très bien, mais malheureusement, il y a un problème (spoiler : cet article tente de simplifier ce problème). Il s'agit du fait que DevOps est complexe. Et c'est évident, car les entreprises ne paient pas cher pour quelque chose qui est facile à faire… Dans le monde de DevOps, il existe un grand nombre d'outils, de termes et de pratiques à maîtriser. Cela est particulièrement difficile au début de la carrière et dépend de l'expérience technique accumulée.
Source :
Nous allons donc conclure avec cette introduction et nous concentrer sur l'objectif de cet article.
De quoi parle cet article
Dans cet article, je vais partager mon expérience dans la création d'une infrastructure d'automatisation des tests. Il existe de nombreuses sources d'information sur les différents outils et leur utilisation sur Internet, mais je voudrais les examiner exclusivement dans le contexte de l'automatisation. Je pense que de nombreux ingénieurs en automatisation connaissent la situation où les tests développés ne sont exécutés et maintenus que par vous-même. En conséquence, les tests deviennent obsolètes et vous passez du temps à les mettre à jour. De plus, au début de votre carrière, il peut être assez difficile de déterminer quels outils devraient aider à résoudre ce problème, comment les choisir, les configurer et les maintenir. Certains testeurs se tournent vers DevOps (les personnes) et, soyons honnêtes, cette approche fonctionne. Dans de nombreux cas, cela peut être la seule option, car nous n'avons pas de visibilité sur toutes les dépendances. Mais, comme nous le savons, les DevOps sont des gars très occupés, car ils doivent penser à l'infrastructure de toute l'entreprise, au déploiement, à la surveillance, aux microservices et à d'autres tâches similaires en fonction de l'organisation/de l'équipe. Comme c'est souvent le cas, l'automatisation n'est pas une priorité. Dans ce cas, nous devons essayer de faire tout ce qui est en notre pouvoir, du début à la fin. Cela réduira les dépendances, accélérera le flux de travail, améliorera nos compétences et nous permettra d'avoir une vue d'ensemble de la situation.
Cet article présente les outils les plus demandés et populaires et montre comment les utiliser pour construire, étape par étape, une infrastructure d'automatisation. Chaque groupe est représenté par des outils qui ont été testés sur la base d'expériences personnelles. Mais cela ne signifie pas que vous devez utiliser exactement les mêmes outils. Les outils eux-mêmes ne sont pas importants, ils apparaissent et deviennent obsolètes. Notre tâche d'ingénieur est de comprendre les principes de base : pourquoi avons-nous besoin de ce groupe d'outils et quelles tâches pouvons-nous résoudre grâce à eux. C'est pourquoi, à la fin de chaque section, je laisse des liens vers des outils similaires qui peuvent être utilisés dans votre organisation.
Ce que cet article ne couvre pas
Je le répète encore, cet article n'est pas sur des outils spécifiques, donc il n'y aura pas d'extraits de code de la documentation ni de descriptions de commandes spécifiques. Mais à la fin de chaque section, je laisse des liens pour une étude approfondie.
C'est fait pour la raison suivante :
- ce matériel est très facile à trouver dans diverses sources (documentation, livres, cours vidéo);
- si nous commençons à approfondir, il nous faudra écrire 10, 20, 30 parties de cet article (alors que le plan est de 2-3);
- je ne veux tout simplement pas perdre votre temps, car, peut-être, vous souhaitez utiliser d'autres outils pour atteindre les mêmes objectifs.
Pratique
J'espère vraiment que ce matériel sera utile pour chaque lecteur, et ne sera pas juste lu et oublié. Dans tout apprentissage, la pratique est une composante très importante. Pour cela, j'ai préparé. Vous aurez également des devoirs pour vous assurer que vous n'avez pas simplement copié des lignes de commandes à l'aveugle.
Plan
Étape
Technologie
Outils
1
Exécution locale (préparer des tests de démonstration web / android et les exécuter localement)
Node.js, Selenium, Appium
2
Systèmes de contrôle de version
Git
3
Conteneurisation
Docker, Selenium grid, Selenoid (Web, Android)
4
CI / CD
Gitlab CI
5
Plateformes cloud
Google Cloud Platform
6
Orchestration
Kubernetes
7
Infrastructure en tant que code (IaC)
Terraform, Ansible
Structure de chaque section
Pour maintenir le récit de manière visuelle, chaque section est décrite selon le plan suivant :
- une brève description de la technologie,
- la valeur pour l'infrastructure d'automatisation,
- une illustration de l'état actuel de l'infrastructure,
- des liens pour l'étude,
- des outils similaires.
1. Exécution locale des tests
Brève description de la technologie
C'est simplement une étape préparatoire pour exécuter des tests de démonstration localement et pour vérifier qu'ils passent avec succès. Dans la partie pratique, Node.js est utilisé mais le langage de programmation et la plateforme ne sont pas nécessaires, vous pouvez utiliser ceux qui sont utilisés dans votre entreprise.
Cependant, pour les outils d'automatisation, je recommande d'utiliser Selenium WebDriver pour les plateformes web et Appium pour la plateforme Android respectivement, car dans les étapes suivantes, nous utiliserons des images Docker qui sont spécifiquement conçues pour travailler avec ces outils. De plus, en se référant aux exigences dans les annonces d'emploi, ces outils sont les plus demandés sur le marché.
Comme vous l'avez peut-être remarqué, nous ne considérons que les tests web et Android. Malheureusement, iOS est une toute autre histoire (merci Apple). Je prévois de démontrer les solutions et les pratiques liées à iOS dans les prochaines parties.
Valeur pour l'infrastructure d'automatisation
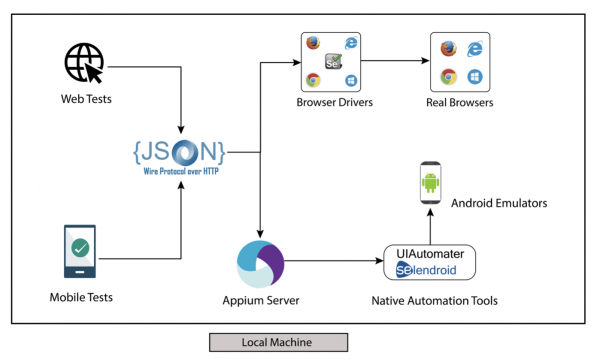
D'un point de vue infrastructurel, l'exécution locale n'a aucune valeur. Vous vérifiez simplement que les tests fonctionnent sur la machine locale dans les navigateurs et simulateurs locaux. Mais c'est néanmoins un point de départ nécessaire.
Illustration de l'état actuel de l'infrastructure
Liens à explorer
Outils similaires
- n'importe quel langage de programmation que vous aimez, associé à Selenium/Appium - des tests;
- tous les tests;
- n'importe quel framework de test.
2. Systèmes de contrôle de version (Git)
Brève description de la technologie
Il ne sera pas surprenant pour quiconque que je dise que le système de contrôle de version est une partie extrêmement importante de la développement, tant en équipe qu'individuellement. En se basant sur diverses sources, on peut affirmer avec confiance que Git est le représentant le plus populaire. Le système de contrôle de version offre de nombreux avantages, tels que le partage de code, le stockage de versions, la réversion vers des branches précédentes, le suivi de l'historique du projet, les sauvegardes. Nous ne discuterons pas de chaque point en détail, car je suis sûr que vous êtes bien familiarisé avec cela et l'utilisez dans votre travail quotidien. Mais si ce n'est pas le cas, je vous recommande de suspendre la lecture de cet article et de combler ce manque dès que possible.
Valeur pour l'infrastructure d'automatisation
Et ici, vous pourriez poser une question légitime : « Pourquoi nous parle-t-il de Git ? Tout le monde le connaît et l'utilise tant pour le développement de code que pour le code des tests automatisés ». Vous aurez absolument raison, mais dans cet article, nous parlons d'infrastructure et cette section sert de préambule à la section 7 : « Infrastructure en tant que Code (IaC) ». Pour nous, cela signifie que toute l'infrastructure, y compris celle des tests, est décrite sous forme de code, ce qui nous permet également d'appliquer des systèmes de versioning et d'obtenir des avantages similaires à ceux du code de développement et d'automatisation.
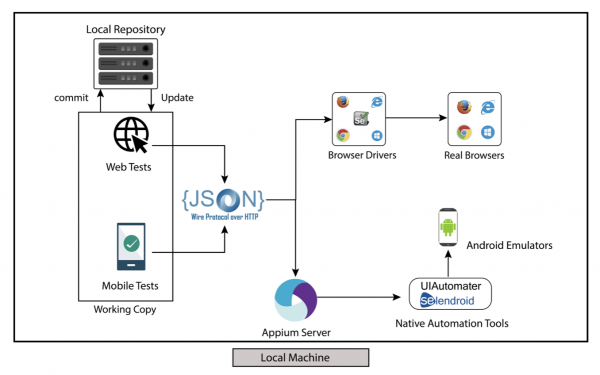
Nous examinerons IaC plus en détail à l'étape 7, mais dès maintenant, vous pouvez commencer à utiliser Git localement en créant un référentiel local. La vue d'ensemble sera élargie lorsque nous ajouterons un référentiel distant à l'infrastructure.
Illustration de l'état actuel de l'infrastructure
Liens à explorer
Outils similaires
3. Conteneurisation (Docker)
Brève description de la technologie
Pour démontrer comment la conteneurisation a changé la donne, retournons quelques décennies en arrière. À l'époque, les gens achetaient et utilisaient des serveurs pour exécuter des applications. Mais dans la plupart des cas, les ressources nécessaires pour faire fonctionner les applications n'étaient pas connues à l'avance. En conséquence, les entreprises dépensaient de l'argent pour acheter des serveurs puissants coûteux, mais une partie de ces capacités n'était pas pleinement utilisée.
L'étape suivante de l'évolution a été l'émergence des machines virtuelles (VM), qui ont résolu le problème des dépenses pour des ressources inutilisées. Cette technologie a permis d'exécuter des applications de manière indépendante les unes des autres au sein d'un même serveur, en allouant un espace complètement isolé. Mais, malheureusement, toute technologie a ses inconvénients. Le lancement de VM nécessite un système d'exploitation complet qui consomme CPU, RAM, stockage et, selon l'OS, il faut prendre en compte les frais de licence. Ces facteurs affectent la vitesse de démarrage et compliquent la portabilité.
Et voilà, nous sommes arrivés à la conteneurisation. Encore une fois, cette technologie a résolu le problème précédent, car les conteneurs n'utilisent pas de système d'exploitation complet, ce qui permet de libérer une grande quantité de ressources et offre une solution rapide et flexible pour la portabilité.
Bien sûr, la technologie de conteneurisation n'est pas nouvelle et a été introduite pour la première fois à la fin des années 70. À cette époque, de nombreuses recherches, travaux et tentatives étaient menées. Mais c'est Docker qui a adapté cette technologie et l'a rendue facilement accessible au grand public. Aujourd'hui, lorsque nous parlons de conteneurs, nous faisons généralement référence à Docker. Quand nous évoquons les conteneurs Docker, nous pensons aux conteneurs Linux. Nous pouvons utiliser des systèmes Windows et macOS pour exécuter des conteneurs, mais il est important de comprendre que dans ce cas, une couche supplémentaire apparaît. Par exemple, Docker sur Mac exécute discrètement des conteneurs à l'intérieur d'une VM Linux légère. Nous reviendrons sur ce sujet lorsque nous aborderons l'exécution d'émulateurs Android dans des conteneurs, car il y a une nuance très importante à traiter plus en détail.
Valeur pour l'infrastructure d'automatisation
Nous avons découvert que la conteneurisation et Docker, c'est génial. Voyons cela dans le contexte de l'automatisation, car chaque outil ou technologie doit résoudre un problème. Identifions les problèmes évidents de l'automatisation des tests dans le contexte des tests UI :
- un grand nombre de dépendances lors de l'installation de Selenium et en particulier d'Appium ;
- des problèmes de compatibilité entre les versions des navigateurs, des simulateurs et des pilotes ;
- l'absence d'un espace isolé pour les navigateurs/simulateurs, ce qui est particulièrement critique pour les exécutions parallèles ;
- il est difficile à gérer et à maintenir s'il est nécessaire de lancer 10, 50, 100 ou même 1000 navigateurs à la fois.
Mais étant donné que Selenium est l'outil d'automatisation le plus populaire et que Docker est l'outil de conteneurisation le plus utilisé, il ne devrait surprendre personne que quelqu'un ait essayé de les combiner pour obtenir un outil puissant pour résoudre les problèmes mentionnés ci-dessus. Examinons de plus près de telles solutions.
Selenium grid dans Docker
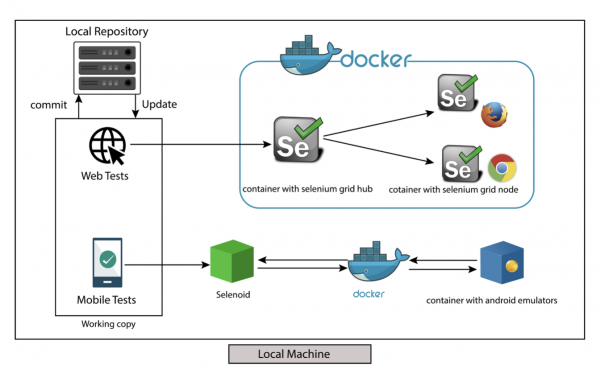
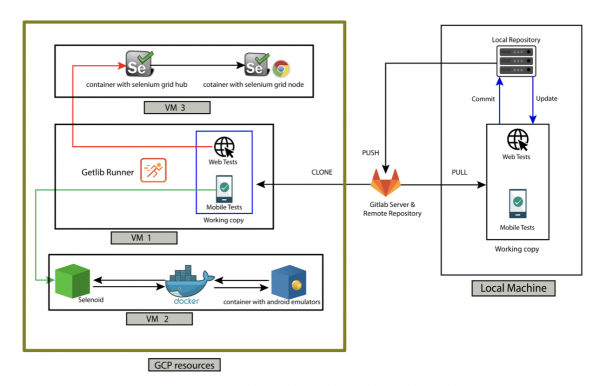
Cet outil est le plus populaire au monde pour Selenium, permettant de lancer plusieurs navigateurs sur plusieurs machines et de les gérer depuis un nœud central. Pour démarrer, il est nécessaire de configurer au minimum 2 parties : Hub et Node(s). Le Hub est le nœud central qui reçoit toutes les requêtes des tests et les répartit entre les Nodes correspondants. Pour chaque Node, nous pouvons configurer une configuration spécifique, par exemple, en spécifiant le navigateur requis et sa version. Cependant, nous devons toujours nous occuper nous-mêmes des pilotes compatibles pour les navigateurs et les installer sur les Nodes nécessaires. Pour cette raison, le Selenium grid n'est pas utilisé dans sa forme pure, sauf dans les cas où nous devons travailler avec des navigateurs qui ne peuvent pas être installés sur Linux OS. Pour tous les autres cas, une solution beaucoup plus flexible et appropriée serait d'utiliser des images Docker pour lancer le Selenium grid Hub et les Nodes. Cette approche facilite énormément la gestion des nœuds, car nous pouvons choisir l'image souhaitée avec les versions de navigateurs et de pilotes compatibles déjà installées.
Malgré les critiques négatives concernant la stabilité, en particulier lors du lancement d'un grand nombre de Nodes en parallèle, le Selenium grid demeure l'outil le plus populaire pour l'exécution parallèle des tests Selenium. Il est important de noter que dans le monde de l'open-source, diverses améliorations et modifications de cet outil continuent d'émerger, visant à résoudre divers goulets d'étranglement.
Selenoid pour le Web
Cet outil est révolutionnaire dans le monde de Selenium, car il fonctionne immédiatement sans configuration et a considérablement simplifié la vie de nombreux ingénieurs en automatisation. Tout d'abord, ce n'est pas une simple modification de Selenium Grid. Au lieu de cela, les développeurs ont créé une toute nouvelle version de Selenium Hub en langage Golang, ce qui, combiné avec des images Docker légères pour différents navigateurs, a propulsé le développement de l'automatisation des tests. De plus, dans le cas de Selenium Grid, nous devons définir tous les navigateurs nécessaires et leurs versions à l'avance, ce qui n'est pas un problème lorsque le travail se fait avec un seul navigateur. Mais quand il s'agit de plusieurs navigateurs pris en charge, Selenoid est la solution numéro un grâce à la fonctionnalité 'navigateur à la demande'. Tout ce que nous avons à faire est de précharger les images nécessaires avec les navigateurs et de mettre à jour le fichier de configuration avec lequel Selenoid interagit. Une fois que Selenoid reçoit une demande des tests, il lance automatiquement le conteneur avec le navigateur demandé. Lorsque le test est terminé, Selenoid va arrêter le conteneur, libérant ainsi des ressources pour les demandes suivantes. Cette approche élimine complètement le problème bien connu de 'dégradation des nœuds', que nous rencontrons souvent dans Selenium Grid.
Mais, hélas, Selenoid n'est toujours pas une solution miracle. Nous avons obtenu la fonctionnalité 'navigateur à la demande', mais la fonction 'ressources à la demande' n'est toujours pas disponible. Pour utiliser Selenoid, nous devons le déployer sur du matériel physique ou sur une VM, ce qui signifie que nous devons savoir à l'avance combien de ressources doivent être allouées. Je pense que cela ne pose pas de problème pour les petits projets qui exécutent 10, 20 ou même 30 navigateurs en parallèle. Mais que faire si nous avons besoin de 100, 500, 1000 ou plus ? Il n'a aucun sens de maintenir et de payer pour autant de ressources en permanence. Dans les sections 5 et 6 de cet article, nous discuterons des solutions qui permettent de scaler, réduisant ainsi significativement les coûts de l'entreprise.
Selenoid pour Android
Après le succès de Selenoid en tant qu'outil d'automatisation web, les gens souhaitaient quelque chose de similaire pour Android. Et cela a été réalisé : Selenoid a été lancé avec le support d'Android. Du point de vue de l'utilisateur, le principe de fonctionnement est similaire à l'automatisation web. La seule différence est qu'au lieu de conteneurs avec des navigateurs, Selenoid exécute des conteneurs avec des émulateurs Android. À mon avis, c'est actuellement l'outil gratuit le plus puissant pour exécuter des tests Android en parallèle.
Je préférerais ne pas parler des aspects négatifs de cet outil, car je l'apprécie vraiment beaucoup. Cependant, il existe certains des mêmes inconvénients liés à l'automatisation web, notamment en ce qui concerne l'évolutivité. En plus, il convient de mentionner une autre limitation qui pourrait être une surprise si nous configurons l'outil pour la première fois. Pour exécuter des images Android, nous avons besoin d'une machine physique ou d'une VM avec la prise en charge de la virtualisation imbriquée. Dans le guide pratique, je montre comment activer cela sur une VM Linux. Cependant, si vous êtes un utilisateur de macOS et souhaitez déployer Selenoid localement, il sera impossible d'exécuter des tests Android. Mais vous pouvez toujours exécuter une VM Linux localement avec la 'virtualisation imbriquée' configurée et déployer Selenoid à l'intérieur.
Illustration de l'état actuel de l'infrastructure
Dans le contexte de cet article, nous ajouterons 2 outils pour illustrer l'infrastructure. Il s'agit de Selenium grid pour les tests web et Selenoid pour les tests Android. Dans le guide sur GitHub, je montrerai également comment utiliser Selenoid pour exécuter des tests web.
Liens à explorer
Outils similaires
- Il existe d'autres outils de conteneurisation, mais Docker est le plus populaire. Si vous voulez essayer autre chose, sachez que les outils que nous avons examinés pour l'exécution parallèle des tests Selenium ne fonctionneront pas immédiatement.
- Comme déjà mentionné, il existe de nombreuses modifications de Selenium grid, par exemple,.
4. CI / CD
Brève description de la technologie
La pratique de l'intégration continue est assez populaire dans le développement et se situe au même niveau que les systèmes de contrôle de version. Pourtant, je sens qu'il existe une certaine confusion terminologique. Dans ce paragraphe, j'aimerais décrire trois modifications de cette technologie selon mon point de vue. Sur Internet, vous trouverez de nombreux articles avec différentes interprétations, et c'est tout à fait normal si votre opinion diffère. L'essentiel est d'être sur la même longueur d'onde que vos collègues.
Ainsi, il existe trois termes : CI — Continuous Integration (intégration continue), CD — Continuous Delivery (livraison continue) et à nouveau CD — Continuous Deployment (déploiement continu). (Ensuite, je vais utiliser ces termes en anglais). Chaque modification ajoute plusieurs étapes supplémentaires à votre pipeline de développement. Mais le mot continuous (continu) est le plus important. Dans ce contexte, nous entendons quelque chose qui se produit du début à la fin, sans interruptions ni intervention manuelle. Regardons ci et cd ainsi que cd dans ce contexte.
- L'intégration continue – c'est la première étape de l'évolution. Après avoir envoyé du nouveau code sur le serveur, nous nous attendons à recevoir un retour rapide indiquant que nos modifications sont correctes. En général, le CI implique l'exécution d'outils d'analyse statique de code et de tests API internes/modulaires. Cela permet d'obtenir des informations sur notre code quelques secondes/minutes après.
- Livraison continue est une étape plus avancée, où nous exécutons des tests d'intégration/UI. Cependant, à ce stade, nous n'obtenons pas de résultats aussi rapidement que pour le CI. Premièrement, ces types de tests nécessitent plus de temps pour être exécutés. Deuxièmement, avant le lancement, nous devons déployer nos modifications dans un environnement test/staging. De plus, si nous parlons de développement mobile, une étape supplémentaire est nécessaire pour créer une version de notre application.
- Déploiement continu sous-entend que nous déployons automatiquement nos modifications en production si tous les tests d'acceptation ont été validés lors des étapes précédentes. En complément de cela, après l'étape de déploiement, il est possible de configurer différentes étapes, telles que le lancement de tests de validation (smoke tests) en production et la collecte de métriques pertinentes. Le déploiement continu n'est possible qu'avec une bonne couverture de tests automatisés. Si des interventions manuelles sont nécessaires, y compris des tests, alors cela ne fait plus partie du Continu (continu). Dans ce cas, nous pouvons dire que notre pipeline correspond uniquement à la pratique de la Livraison Continue.
Valeur pour l'infrastructure d'automatisation
Dans cette section, je dois préciser que lorsque nous parlons de tests UI de bout en bout, cela implique que nous devons déployer nos modifications et les services associés dans des environnements de test. L'intégration continue — le processus n'est pas applicable à cette tâche et nous devons veiller à mettre en œuvre au moins des pratiques de Livraison Continue. Le déploiement continu a également du sens dans le contexte des tests UI, si nous prévoyons de les exécuter en production.
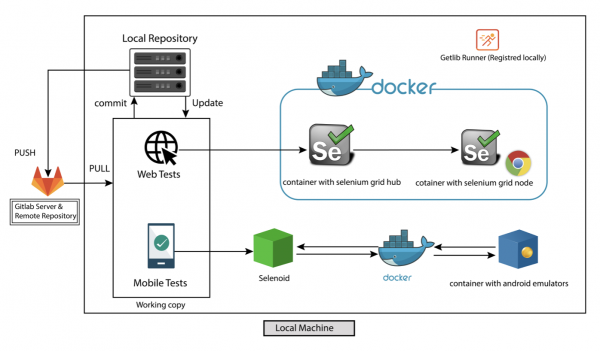
Et avant que nous examinions l'illustration des changements d'architecture, je voudrais dire quelques mots sur GitLab CI. Contrairement à d'autres outils CI/CD, GitLab offre un dépôt distant et de nombreuses autres fonctionnalités supplémentaires. Ainsi, GitLab est plus qu'un simple CI. Il inclut par défaut la gestion du code source, la gestion Agile, les pipelines CI/CD, les outils de journalisation et la collecte de métriques. L'architecture de GitLab se compose de GitLab CI/CD et de GitLab Runner. Voici une brève description provenant du site officiel :
GitLab CI/CD est une application web avec une API qui stocke son état dans une base de données, gère des projets/compilations et fournit une interface utilisateur. GitLab Runner est une application qui traite les compilations. Il peut être déployé séparément et fonctionne avec GitLab CI/CD via une API. Pour l'exécution des tests, vous avez besoin à la fois d'une instance GitLab et d'un Runner.
Illustration de l'état actuel de l'infrastructure
Liens à explorer
Outils similaires
- Et bien d'autres encore
5. Plateformes Cloud
Brève description de la technologie
Dans cette section, nous allons parler d'une tendance populaire appelée « nuages publics ». Malgré les énormes avantages offerts par les technologies de virtualisation et de containerisation évoquées précédemment, nous avons toujours besoin de ressources informatiques. Les entreprises acquièrent des serveurs coûteux ou louent des centres de données, mais dans ce cas, il est nécessaire d'effectuer des calculs (parfois irréalistes) pour déterminer combien de ressources nous aurons besoin, si nous allons les utiliser 24/7 et pour quel type d'objectifs. Par exemple, pour la production, un serveur opérationnel 24 heures sur 24 est requis, mais avons-nous besoin de ressources similaires pour les tests en dehors des heures de travail ? Cela dépend également du type de tests réalisés. Prenons l'exemple des tests de charge/stress que nous prévoyons de faire en dehors des heures de travail pour obtenir des résultats le lendemain. Cependant, il est évident que la disponibilité 24 heures sur 24 des serveurs n'est pas nécessaire pour les tests automatiques end-to-end, et encore moins pour les environnements de test manuel. Pour de telles situations, il serait idéal de bénéficier de ressources en fonction des besoins, de les utiliser et de cesser de payer lorsque nous n'en avons plus besoin. De plus, il serait merveilleux de pouvoir les obtenir instantanément, en effectuant quelques clics de souris ou en lançant quelques scripts. C'est précisément l'utilité des nuages publics. Examinons la définition :
« Le nuage public est défini comme des services de calcul offerts par des fournisseurs tiers via Internet public, les rendant disponibles à quiconque souhaite les utiliser ou les acheter. Ils peuvent être gratuits ou vendus à la demande, permettant aux clients de ne payer que pour l'utilisation des cycles CPU, du stockage ou de la bande passante consommée. »
Il est souvent dit que les nuages publics sont coûteux. Mais leur idée clé est de réduire les dépenses des entreprises. Comme mentionné précédemment, les nuages publics permettent d'obtenir des ressources à la demande et de ne payer que pour le temps d'utilisation. De plus, nous oublions parfois que les employés reçoivent un salaire et que les experts sont également une ressource coûteuse. Il est crucial de considérer que les nuages publics facilitent grandement le soutien de l'infrastructure, permettant ainsi aux ingénieurs de se concentrer sur des tâches plus importantes.
Valeur pour l'infrastructure d'automatisation
Quelles ressources spécifiques sont nécessaires pour des tests UI de bout en bout ? Principalement, ce sont des machines virtuelles ou des clusters (nous parlerons de Kubernetes dans la section suivante) pour exécuter des navigateurs et des émulateurs. Plus nous souhaitons exécuter de navigateurs et d'émulateurs en même temps, plus nous avons besoin de CPU et de mémoire, et plus cela coûtera cher. Ainsi, les clouds publics dans le contexte de l'automatisation des tests nous permettent d'exécuter un grand nombre (100, 200, 1000…) de navigateurs/émulateurs à la demande, d'obtenir des résultats de test aussi rapidement que possible et de cesser de payer pour de telles ressources excessivement coûteuses.
Les fournisseurs de cloud les plus populaires sont Amazon Web Services (AWS), Microsoft Azure, Google Cloud Platform (GCP). Le guide pratique présente des exemples d'utilisation de GCP, mais au final, peu importe ce que vous allez utiliser pour les tâches d'automatisation. Tous offrent des fonctionnalités à peu près identiques. En général, lors du choix d'un fournisseur, le guide se concentre sur l'ensemble de l'infrastructure de l'entreprise et sur les exigences commerciales, ce qui dépasse le cadre de cet article. Pour les ingénieurs en automatisation, il sera plus intéressant de comparer l'utilisation des fournisseurs de cloud avec celle des plateformes cloud spécifiquement pour les tests, comme Sauce Labs, BrowserStack, BitBar, etc. Alors faisons cela ! À mon avis, Sauce Labs est la ferme de tests cloud la plus connue, c'est pourquoi je l'ai choisie pour la comparaison.
GCP contre Sauce Labs pour les objectifs d'automatisation :
Imaginons que nous devons exécuter simultanément 8 tests web et 8 tests Android. Pour cela, nous allons utiliser GCP et lancer 2 machines virtuelles avec Selenoid. Sur la première, nous déploierons 8 conteneurs avec des navigateurs. Sur la seconde, 8 conteneurs avec des émulateurs. Regardons les prix :
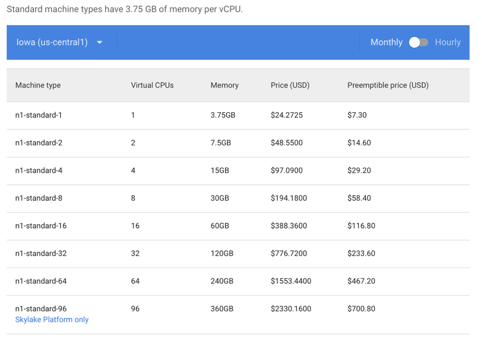
Pour exécuter un conteneur avec Chrome, nous aurons besoin de n1-standard-1 machine. Dans le cas d'Android, ce sera n1-standard-4 pour un émulateur. En réalité, un moyen plus flexible et économique consiste à spécifier des valeurs utilisateur pour le CPU/Mémoire, mais pour le moment, cela n'est pas fondamental pour comparer avec Sauce Labs.
Voici les tarifs d'utilisation de Sauce Labs :
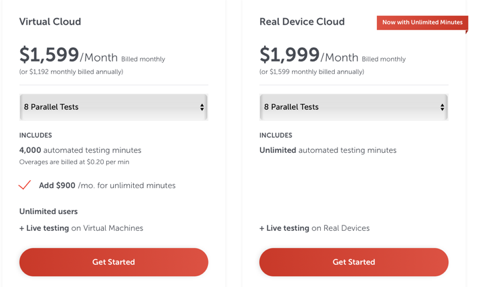
Je suppose que vous avez déjà remarqué la différence, mais je vais tout de même fournir un tableau avec des calculs pour notre tâche :
Ressources requises
Mensuel
Heures de travail(8 h — 20 h)
Heures de travail+ Préemptible
GCP pour le Web
n1-standard-1 x 8 = n1-standard-8
$194.18
23 jours * 12h * 0,38 = 104,88€
23 jours * 12h * 0,08 = 22,08€
Sauce Labs pour le Web
Tests parallèles Virtual Cloud8
$1.559
—
—
GCP pour Android
n1-standard-4 x 8 : n1-standard-16
$776.72
23 jours * 12h * 1,52 = 419,52€
23 jours * 12h * 0,32 = 88,32€
Sauce Labs pour Android
Tests parallèles sur des appareils réels Cloud 8
$1.999
—
—
Comme vous pouvez le voir, la différence de coût est énorme, surtout si vous exécutez des tests uniquement pendant la période de travail de douze heures. Mais vous pouvez réduire encore plus les coûts en utilisant des machines préemptibles. Qu'est-ce que c'est ?
Une VM préemptible est une instance que vous pouvez créer et exécuter à un prix beaucoup plus bas que les instances normales. Cependant, Compute Engine peut interrompre (préempter) ces instances si elle a besoin d'accéder à ces ressources pour d'autres tâches. Les instances préemptibles sont une capacité excédentaire de Compute Engine, donc leur disponibilité varie en fonction de l'utilisation.
Si vos applications sont tolérantes aux pannes et peuvent supporter d'éventuelles interruptions d'instances, alors les instances préemptibles peuvent réduire considérablement vos coûts sur Compute Engine. Par exemple, les tâches de traitement par lots peuvent s'exécuter sur des instances préemptibles. Si certaines de ces instances se terminent pendant le traitement, la tâche ralentit mais ne s'arrête pas complètement. Les instances préemptibles complètent vos tâches de traitement par lots sans alourdir vos instances existantes et sans exiger que vous payiez le prix fort pour des instances normales supplémentaires.
Et ce n'est toujours pas fini ! En réalité, je suis convaincu que personne ne lance des tests pendant 12 heures sans interruption. Et si c'est le cas, vous pouvez automatiser le démarrage et l'arrêt des machines virtuelles lorsqu'elles ne sont pas nécessaires. Le temps d'utilisation réel peut être réduit à 6 heures par jour. Dans ce cas, le paiement dans le contexte de notre tâche peut descendre à 11€ par mois pour 8 navigateurs. N'est-ce pas merveilleux ? Mais avec des machines préemptibles, nous devons être prudents et préparés aux interruptions et à un fonctionnement instable, bien que ces situations puissent être anticipées et gérées par programmation. Ça en vaut la peine !
Mais je ne dis en aucun cas 'ne jamais utiliser des fermes de tests dans le cloud'. Elles ont plusieurs avantages. Tout d'abord, ce n'est pas simplement une machine virtuelle, mais une solution complète pour l'automatisation des tests avec un ensemble de fonctionnalités prêtes à l'emploi : accès à distance, journaux, captures d'écran, enregistrement vidéo, différents navigateurs et appareils mobiles physiques. Dans de nombreuses situations, cela peut être une alternative magnifique et indispensable. En particulier, les plateformes de test sont utiles pour l'automatisation iOS, lorsque les clouds publics ne peuvent offrir que des systèmes Linux/Windows. Mais la discussion sur l'iOS viendra dans les prochains articles. Je recommande toujours d'évaluer la situation et de partir des tâches : dans certains cas, il est moins cher et plus efficace d'utiliser des clouds publics, tandis que dans d'autres, les plateformes de test valent définitivement l'argent dépensé.
Illustration de l'état actuel de l'infrastructure
Liens à explorer
Outils similaires :
6. Orchestration
Brève description de la technologie
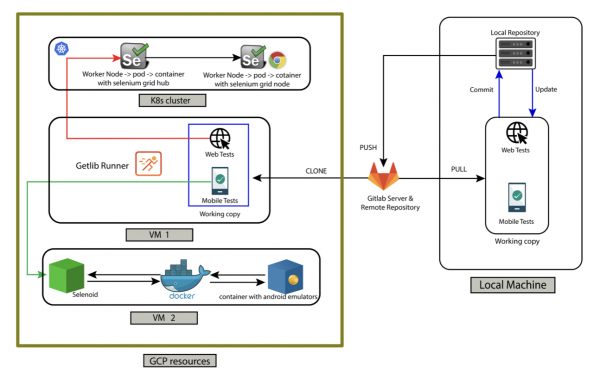
J'ai de bonnes nouvelles – nous avons presque atteint la fin de l'article ! Actuellement, notre infrastructure d'automatisation se compose de tests web et Android que nous exécutons via GitLab CI en parallèle, en utilisant des outils compatibles avec Docker : Selenium grid et Selenoid. De plus, nous utilisons des machines virtuelles créées via GCP pour héberger des conteneurs avec des navigateurs et des émulateurs. Pour réduire les coûts, nous lançons ces machines virtuelles uniquement à la demande et les arrêtons lorsque les tests ne sont pas effectués. Y a-t-il autre chose qui pourrait améliorer notre infrastructure ? La réponse est oui ! Accueillons Kubernetes (K8s) !
Pour commencer, examinons comment les mots orchestration, cluster et Kubernetes sont liés. À un niveau élevé, l'orchestration est un système qui déploie et gère des applications. Pour automatiser les tests, les applications conteneurisées sont Selenium grid et Selenoid. Docker et K8s se complètent. Le premier est utilisé pour déployer des applications, le second pour l'orchestration. En retour, K8s est un cluster. La tâche du cluster est d'utiliser des VMs comme Nodes, ce qui permet d'installer différentes fonctionnalités, programmes et services sur un même serveur (cluster). Si un Node échoue, d'autres Nodes prennent le relais, ce qui garantit un fonctionnement continu de notre application. De plus, K8s possède une fonctionnalité importante liée à la mise à l'échelle, ce qui nous permet d'obtenir automatiquement la quantité optimale de ressources, en fonction de la charge et des limites établies.
En réalité, le déploiement manuel de Kubernetes depuis zéro est une tâche tout sauf triviale. Je laisserai un lien vers le célèbre guide pratique "Kubernetes The Hard Way", et si cela vous intéresse, vous pouvez vous entraîner. Mais heureusement, il existe des méthodes et des outils alternatifs. La plus simple consiste à utiliser Google Kubernetes Engine (GKE) dans GCP, ce qui permet d'obtenir un cluster prêt après quelques clics. Pour commencer votre apprentissage, je recommande d'utiliser cette approche, car elle vous permettra de vous concentrer sur l'apprentissage de l'utilisation de K8s pour vos tâches plutôt que sur l'exploration de l'intégration des composants internes.
Valeur pour l'infrastructure d'automatisation
Examinons quelques fonctionnalités significatives offertes par K8s :
- déploiement d'applications : utilisation d'un cluster multi-nœuds au lieu de VMs ;
- scalabilité dynamique : réduit les coûts des ressources utilisées uniquement à la demande ;
- auto-récupération (Self-healing) : restauration automatique des pods (entrainant la restauration des conteneurs) ;
- déploiement d'une mise à jour et retour en arrière sans temps d'arrêt : la mise à jour des outils, navigateurs et émulateurs ne perturbe pas le travail des utilisateurs actuels.
Mais K8s n'est toujours pas une solution miracle. Pour comprendre tous les avantages et les limitations dans le contexte des outils que nous examinons (Selenium grid, Selenoid), discutons brièvement de la structure de K8s. Le cluster contient deux types de nœuds : les Master Nodes et les Workers Nodes. Les Master Nodes sont responsables de la gestion, du déploiement et des décisions de planification. Les Workers nodes sont là où les applications sont exécutées. Les nœuds contiennent également l'environnement d'exécution des conteneurs. Dans notre cas, c'est Docker, qui gère les opérations liées aux conteneurs. Mais il existe aussi des solutions alternatives, par exemple. Il est important de comprendre que la scalabilité ou l'auto-récupération ne concerne pas directement les conteneurs. Cela se réalise par l'ajout ou la réduction du nombre de pods, qui contiennent à leur tour des conteneurs (généralement un conteneur par pod, mais selon la tâche, il peut y en avoir plusieurs). La hiérarchie de haut niveau se compose de nœuds workers, à l'intérieur desquels se trouvent des pods, et à l'intérieur desquels sont lancés des conteneurs.
La fonction de mise à l'échelle est essentielle et peut être appliquée aussi bien aux nœuds à l'intérieur d'un pool de nœuds de cluster qu'aux pods à l'intérieur d'un nœud. Il existe deux types de mise à l'échelle, qui concernent à la fois les nœuds et les pods. Le premier type, horizontal, consiste à augmenter le nombre de nœuds/pods. Ce type est préféré. Le second type, vertical, consiste à augmenter la taille des nœuds/pods, plutôt que leur nombre.
Examinons maintenant nos outils dans le contexte des termes mentionnés ci-dessus.
Selenium grid
Comme mentionné précédemment, Selenium grid est un outil très populaire, et il n'est pas surprenant qu'il ait été containerisé. Il n'est donc pas surprenant que Selenium grid puisse être déployé dans K8s. Un exemple de la manière de procéder se trouve dans le dépôt officiel de K8s. Comme d'habitude, je joins des liens à la fin de la section. En outre, un guide pratique montre comment procéder avec Terraform. Il y a également des instructions sur la façon de mettre à l'échelle le nombre de pods contenant des conteneurs avec des navigateurs. Cependant, la fonction de mise à l'échelle automatique dans le contexte de K8s reste une tâche encore peu évidente. Lorsque j'ai commencé à étudier, je n'ai trouvé aucun guide pratique ou recommandations. Après plusieurs recherches et expérimentations avec le soutien de l'équipe DevOps, nous avons opté pour l'approche consistant à faire fonctionner les conteneurs avec les navigateurs requis dans un seul pod, situé dans un seul nœud de travail. Cette méthode nous permet d'appliquer une stratégie de mise à l'échelle horizontale des nœuds en augmentant leur nombre. J'espère qu'à l'avenir, la situation changera et que nous verrons de plus en plus de descriptions des meilleures approches et solutions prêtes à l'emploi, surtout après la sortie de Selenium grid 4 avec une architecture interne modifiée.
Selenoid:
Actuellement, le déploiement de Selenoid dans K8s est une grande déception. Ils ne sont pas compatibles. Théoriquement, nous pouvons lancer un conteneur Selenoid à l'intérieur d'un pod, mais lorsque Selenoid commence à exécuter des conteneurs avec des navigateurs, ceux-ci seront toujours à l'intérieur de ce même pod. Cela rend l'évolutivité impossible et, par conséquent, le fonctionnement de Selenoid à l'intérieur du cluster ne sera pas différent de celui à l'intérieur d'une machine virtuelle. Fin de l'histoire.
Moon:
Connaissant ce goulet d'étranglement lors de l'utilisation de Selenoid, les développeurs ont lancé un outil plus puissant appelé Moon. Cet outil a été initialement conçu pour fonctionner avec Kubernetes et, par conséquent, il est possible et nécessaire d'utiliser la fonction d'auto-scaling. De plus, je dirais qu'à l'heure actuelle, c'est seule l'outil dans le monde de Selenium qui prend en charge nativement le cluster K8s dès sa sortie de boîte (ce n'est plus le cas, voir l'outil suivant ). La caractéristique clé de Moon qui permet cette prise en charge est :
Complètement sans état. Selenoid stocke en mémoire des informations sur les sessions de navigateur actuellement en cours. Si, pour une raison quelconque, son processus plante, alors toutes les sessions en cours sont perdues. Moon, en revanche, n'a pas d'état interne et peut être répliqué à travers les centres de données. Les sessions de navigateur restent actives même si une ou plusieurs répliques tombent.
Ainsi, Moon est une solution formidable, mais avec un problème, il n'est pas gratuit. Le prix dépend du nombre de sessions. Vous pouvez exécuter gratuitement seulement 0 à 4 sessions, ce qui n'est pas très utile. Mais à partir de la cinquième session, il faudra payer 5 $ pour chacune. La situation peut varier d'une entreprise à l'autre, mais dans notre cas, l'utilisation de Moon n'est pas pertinente. Comme je l'ai décrit ci-dessus, nous pouvons lancer des VMs avec Selenium Grid à la demande ou augmenter le nombre de nœuds dans le cluster. Environ un pipeline exécute 500 navigateurs et arrête toutes les ressources une fois les tests terminés. Si nous utilisions Moon, nous devrions payer un supplément de 500 x 5 = 2500 $ par mois peu importe la fréquence à laquelle nous exécutons les tests. Et encore une fois, je ne dis pas « ne pas utiliser Moon ». Pour vos tâches, cela peut être une solution indispensable, en particulier si vous avez de nombreux projets ou équipes dans votre organisation et besoin d'un énorme cluster commun pour tous. Comme toujours, je laisse un lien à la fin et recommande de faire tous les calculs nécessaires dans le contexte de votre tâche.
Callisto: (Attention ! Cela n'est pas dans l'article original et est uniquement contenu dans la traduction russe.)
Comme je l'ai dit, Selenium est un outil très populaire et le domaine de l'informatique évolue très rapidement. Pendant que je travaillais sur la traduction, un nouvel outil prometteur, Callisto (salut à Cypress et aux autres concurrents de Selenium), est apparu sur le web. Il fonctionne nativement avec K8s et permet de lancer des conteneurs Selenoid dans des pods, répartis sur des nodes. Tout fonctionne tout de suite, y compris l'auto-scaling. Fantastique, mais il faut tester. J'ai déjà réussi à déployer cet outil et à mener quelques expériences. Mais il est trop tôt pour tirer des conclusions, après avoir obtenu des résultats sur le long terme, il est possible que je fasse une revue dans les prochains articles. Pour l'instant, je laisse juste des liens pour des recherches individuelles.
Illustration de l'état actuel de l'infrastructure
Liens à explorer
Liens à explorer
Outils similaires
7. Infrastructure comme code (IaC)
Brève description de la technologie
Et nous sommes arrivés à la dernière section. Habituellement, cette technologie et les tâches qui y sont liées ne relèvent pas de la responsabilité des ingénieurs en automatisation. Et il y a de bonnes raisons pour cela. Tout d'abord, dans de nombreuses organisations, les questions d'infrastructure sont sous le contrôle du département DevOps et l'équipe de développement ne se soucie pas vraiment de la manière dont fonctionne le pipeline et de la façon dont il faut maintenir tout ce qui y est associé. Deuxièmement, soyons honnêtes, la pratique « Infrastructure comme code (IaC) » n'est pas encore appliquée dans de nombreuses entreprises. Mais cela reste définitivement une tendance populaire et il est important d'essayer d'être impliqué dans les processus, approches et outils qui y sont liés. Ou, au moins, de rester informé des événements.
Commençons par la motivation d'utiliser cette approche. Nous avons déjà discuté qu'il nous fallait, pour exécuter des tests dans GitlabCI, au moins des ressources pour lancer Gitlab Runner. Et pour démarrer des conteneurs avec des navigateurs/émulateurs, nous devons réserver une VM ou un cluster. En plus des ressources pour les tests, nous avons besoin d'une puissance significative pour maintenir les environnements de développement, de staging et de production, ce qui inclut également des bases de données, des programmes automatiques, des configurations réseau, un équilibre de charge, des droits d'utilisateur, et ainsi de suite. Le principal problème réside dans les efforts nécessaires pour soutenir tout cela. Il existe plusieurs méthodes par lesquelles nous pouvons apporter des modifications et déployer des mises à jour. Par exemple, dans le contexte de GCP, nous pouvons utiliser la console UI dans le navigateur et effectuer toutes les actions en cliquant sur des boutons. Un autre moyen pourrait être d'utiliser des appels API pour interagir avec des entités cloud ou d'utiliser l'outil en ligne de commande gcloud pour effectuer les manipulations nécessaires. Mais avec un grand nombre d'entités et d'éléments d'infrastructure, il devient difficile, voire impossible, d'effectuer toutes les opérations manuellement. De plus, toutes ces actions manuelles ne sont pas contrôlées. Nous ne pouvons pas les soumettre à une revue avant l'exécution, utiliser un système de contrôle de version et revenir rapidement sur des modifications qui ont conduit à un incident. Pour résoudre ces problèmes, les ingénieurs ont créé et continuent de créer des scripts bash/shell automatiques, ce qui n'est guère mieux que les méthodes précédentes, car il est assez difficile de les lire rapidement, de les comprendre, de les maintenir et de les modifier dans un style procédural.
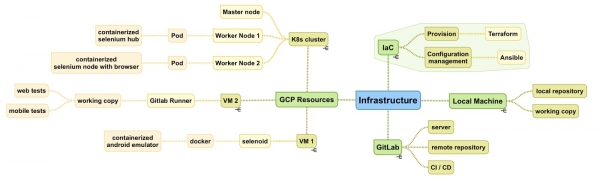
Dans cet article et ce guide pratique, j'utilise deux outils liés à la pratique de l'IaC. Ce sont Terraform et Ansible. Certains estiment qu'il n'est pas utile de les utiliser simultanément, car leurs fonctionnalités sont similaires et elles sont interchangeables. Cependant, la réalité est qu'ils sont conçus pour répondre à des tâches totalement différentes. Le fait que ces outils doivent se compléter a été confirmé lors d'une présentation conjointe par des développeurs représentant les entreprises HashiCorp et RedHat. La différence conceptuelle réside dans le fait que Terraform est un outil de provisioning pour gérer les serveurs eux-mêmes. Pendant que Ansible est un outil de gestion de configurations, dont la tâche est d'installer, configurer et gérer le logiciel sur ces serveurs.
Une autre caractéristique clé qui distingue ces outils est le style d’écriture du code. Contrairement à bash et Ansible, Terraform utilise un style déclaratif, basé sur la description de l'état final souhaité qui doit être atteint à l’issue de l'exécution. Par exemple, si l’on souhaite créer 10 VMs et appliquer des modifications via Terraform, nous obtiendrons 10 VMs. Si le script est réappliqué, rien ne se produira, car nous avons déjà 10 VMs, et Terraform en a connaissance, car il conserve l'état actuel de l'infrastructure dans un fichier d'état. En revanche, Ansible utilise une approche procédurale et, si on lui demande de créer 10 VMs, lors de la première exécution nous obtiendrons 10 VMs, tout comme avec Terraform. Mais après une nouvelle exécution, nous aurons déjà 20 VMs. C'est là qu'est la différence importante. Dans le style procédural, nous ne conservons pas l'état actuel et décrivons simplement la séquence des étapes à réaliser. Bien sûr, nous pouvons gérer différentes situations, ajouter plusieurs vérifications sur l'existence des ressources et de l'état actuel, mais il est inutile de perdre notre temps et de faire des efforts pour contrôler cette logique. De plus, cela augmente le risque d'erreurs.
Pour résumer tout ce qui précède, on peut conclure que pour le provisioning de serveurs, l'outil le mieux adapté est Terraform avec une notation déclarative. Tandis que la gestion des configurations est mieux déléguée à Ansible. Cela étant clair, examinons des exemples d'utilisation dans le contexte de l'automatisation.
Valeur pour l'infrastructure d'automatisation
Il est important de comprendre que l'infrastructure d'automatisation des tests doit être considérée comme une partie de l'ensemble de l'infrastructure de l'entreprise. Cela signifie que toutes les pratiques IaC doivent être appliquées de manière globale aux ressources de l'ensemble de l'organisation. La responsabilité de cela dépend de vos processus. L'équipe DevOps a plus d'expérience sur ces questions, elle voit l'ensemble du tableau. Cependant, les ingénieurs QA sont plus impliqués dans le processus de construction de l'automatisation et la structure du pipeline, ce qui leur permet de mieux voir tous les changements nécessaires et les possibilités d'amélioration. Le meilleur choix est de travailler ensemble, d'échanger des connaissances et des idées pour atteindre le résultat attendu.
Voici quelques exemples d'utilisation de Terraform et d'Ansible dans le contexte de l'automatisation des tests et des outils que nous avons discutés précédemment :
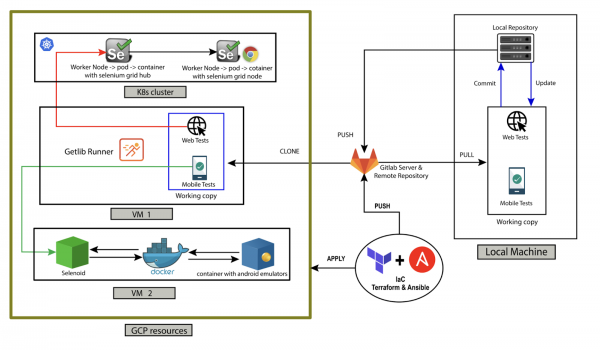
1. Décrire via Terraform les caractéristiques et paramètres nécessaires des VMs et des clusters.
2. Installer avec Ansible les outils nécessaires pour les tests : docker, Selenoid, Selenium Grid et charger les versions nécessaires des navigateurs/émulateurs.
3. Décrire via Terraform les caractéristiques de la VM sur laquelle le GitLab Runner sera exécuté.
4. Installer avec Ansible GitLab Runner et les outils associés nécessaires, définir les paramètres et configurations.
Illustration de l'état actuel de l'infrastructure
Liens pour étude :
Outils similaires
Récapitulons !
Étape
Technologie
Outils
Valeur pour l'infrastructure d'automatisation
1
Exécution locale
Node.js, Selenium, Appium
- Outils les plus populaires pour le web et le mobile
- Support de nombreux langages et plateformes (y compris Node.js)
2
Systèmes de contrôle de version
Git
- Avantages similaires avec le code de développement
3
Conteneurisation
Docker, Selenium grid, Selenoid (Web, Android)
- Exécution parallèle des tests
- Environnements isolés
- Mise à jour des versions simple et flexible
- Arrêt dynamique des ressources inutilisées
- Facilité de configuration
4
CI / CD
Gitlab CI
- Les tests font partie du pipeline
- Retour d'information rapide
- Visibilité pour l'ensemble de l'entreprise / de l'équipe
5
Plateformes cloud
Google Cloud Platform
- Ressources à la demande (nous payons uniquement quand nécessaires)
- Facile à gérer et à mettre à jour
- Visibilité et contrôle de toutes les ressources
6
Orchestration
Kubernetes
Dans le contexte des conteneurs avec navigateurs/émulateurs à l'intérieur des pods :
- Mise à l'échelle / autoscaling
- Auto-récupération
- Mises à jour et retours en arrière sans interruptions
7
Infrastructure en tant que code (IaC)
Terraform, Ansible
- Avantages similaires avec l'infrastructure de développement
- Tous les avantages de la versionnage du code
- Facilité d'apporter des modifications et de maintenir
- Entièrement automatisé
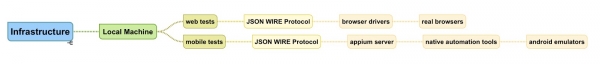
Diagrammes de cartes heuristiques : l'évolution de l'infrastructure
étape 1 : Local
étape 2 : VCS
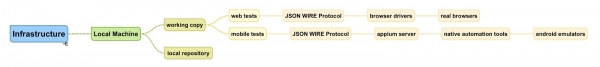
étape 3 : Conteneurisation
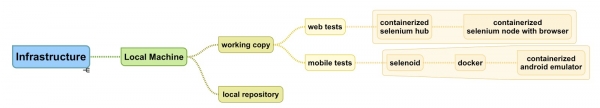
étape 4 : CI/CD
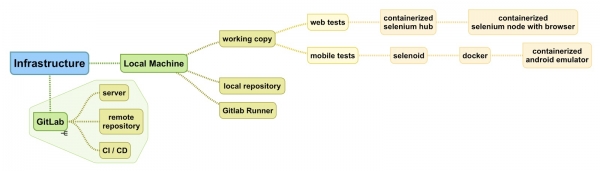
étape 5 : Plateformes Cloud
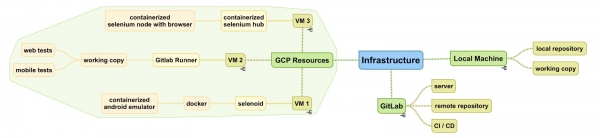
étape 6 : Orchestration
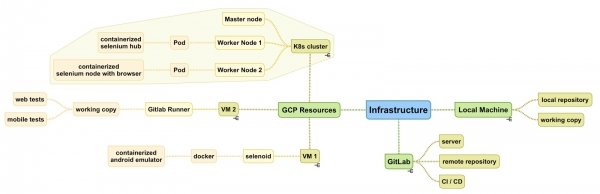
étape 7 : IaC
Et après ?
Ainsi, c'est la fin de l'article. Mais en conclusion, j'aimerais établir avec vous quelques accords.
De votre part
Comme mentionné au début, je souhaite que l'article soit utile et vous aide à appliquer les connaissances acquises dans le travail réel. Je pense à nouveau à.
Mais même après cela, ne vous arrêtez pas, pratiquez, étudiez les liens pertinents et les livres, découvrez comment cela fonctionne dans votre entreprise, trouvez des domaines à améliorer et participez-y. Bonne chance !
De ma part
Comme le titre l'indique, ce n'était que la première partie. Bien que ce soit assez long, d'importants sujets demeurent à explorer. Dans la deuxième partie, je prévois d'examiner l'infrastructure d'automatisation dans le contexte d'IOS. En raison des restrictions d'Apple concernant le lancement des simulateurs IOS uniquement sur des systèmes macOS, notre ensemble de solutions est limité. Par exemple, nous ne pouvons pas utiliser Docker pour exécuter le simulateur ni des clouds publics pour lancer des machines virtuelles. Mais cela ne signifie pas qu'il n'y a pas d'autres alternatives. Je vais essayer de vous tenir informés des solutions de pointe et des outils modernes !
Je n'ai également pas mentionné certains sujets assez vastes liés à la surveillance. Dans la partie 3, je vais examiner les outils de surveillance les plus populaires pour l'infrastructure, ainsi que les données et métriques à prendre en compte.
Et enfin. À l'avenir, je prévois de publier un cours vidéo sur la construction d'une infrastructure de test et des outils populaires. Actuellement, il y a pas mal de cours et de conférences sur le DevOps sur Internet, mais tout le contenu est présenté dans le contexte du développement, pas de l'automatisation des tests. J'ai vraiment besoin de retours sur l'intérêt et la valeur d'un tel cours pour la communauté des testeurs et des automatiseurs. Merci d'avance !
Source : habr.com
