

Introduction
Un système d'information, du point de vue de l'utilisateur, est bien défini dans la norme GOST RV 51987 comme un « système automatisé dont le résultat est la présentation d'informations de sortie pour une utilisation ultérieure ». En considérant la structure interne, toute SI est essentiellement un système d'algorithmes interconnectés réalisés en code. Au sens large de la thèse de Turing et Church, un algorithme (et donc une SI) effectue la transformation d'un ensemble de données d'entrée en un ensemble de données de sortie.
On peut même dire que la transformation des données d'entrée est le sens d'existence d'un système d'information. Par conséquent, la valeur de la SI et de l'ensemble du complexe SI est déterminée par la valeur des données d'entrée et de sortie.
Sur cette base, la conception doit commencer par les données, adaptant l'architecture et les méthodes à la structure et à la signification des données.
Données stockées
Une étape clé dans la préparation à la conception est l'obtention des caractéristiques de tous les ensembles de données prévus pour le traitement et le stockage. Ces caractéristiques incluent :
— Volume des données;
— Informations sur le cycle de vie des données (croissance des nouvelles données, durée de vie, traitement des données obsolètes);
— Classification des données en fonction de leur impact sur le principal business de l'entreprise (sur les trois axes de la confidentialité, de l'intégrité et de la disponibilité), accompagnée d'indicateurs financiers (par exemple, le coût de la perte de données sur la dernière heure);
— Géographie du traitement des données (emplacement physique des systèmes de traitement);
— Exigences des régulateurs pour chaque classe de données (par exemple, la loi FZ-152, PCI DSS).
Systèmes d'information
Les données ne sont pas seulement stockées mais également traitées (transformées) par les systèmes d'information. L'étape suivante après l'obtention des caractéristiques des données est l'inventaire le plus complet possible des systèmes d'information, de leurs caractéristiques architecturales, de leurs interdépendances et de leurs exigences en matière d'infrastructure en unités conditionnelles pour quatre types de ressources :
— Puissance de calcul du processeur;
— Volume de mémoire vive;
— Exigences en matière de capacité et de performance du système de stockage de données;
— Exigences du réseau de transmission de données (canaux externes, canaux entre les composants de la SI).
Les exigences doivent être définies pour chaque service/microservice au sein du système d'information.
Il est également nécessaire de noter l'obligation d'avoir des données sur l'impact du système d'information sur l'activité principale de l'entreprise sous forme de coûts d'arrêt du système d'information (roubles par heure).
Modèle de menace
Il est impératif d'avoir un modèle formel des menaces dont on prévoit de protéger les données/services. Ce modèle de menace doit inclure non seulement des aspects de confidentialité, mais aussi d'intégrité et de disponibilité. Par exemple :
— Panne d'un serveur physique ;
— Panne d'un commutateur top-of-the-rack ;
— Rupture de la liaison optique entre les centres de données ;
— Panne complète d'un système de stockage de données opérationnel.
Dans certains cas, des modèles de menace sont écrits non seulement pour les composants d'infrastructure, mais aussi pour des systèmes d'information spécifiques ou leurs composants, comme la défaillance d'une base de données avec destruction logique de la structure des données.
Toutes les décisions dans le cadre du projet pour se protéger contre une menace non décrite sont superflues.
Exigences des régulateurs
Si les données traitées sont soumises à des règles spéciales fixées par les régulateurs, des informations sur les ensembles de données et les règles de traitement/de stockage sont impérativement nécessaires.
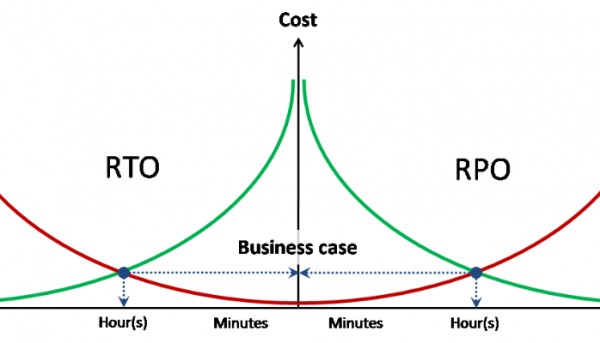
Indicateurs cibles RPO/RTO
La conception de tout type de protection nécessite des indicateurs de perte de données cible et de temps de restauration cible du service pour chacune des menaces décrites.
Idéalement, les indicateurs RPO et RTO devraient avoir des coûts associés à la perte de données et à l'arrêt par unité de temps.
Séparation en pools de ressources
Après avoir collecté toutes les informations de base, la première étape consiste à grouper les ensembles de données et les systèmes d'information en pools, en fonction des modèles de menace et des exigences des régulateurs. Le type de séparation des différents pools est déterminé : par logiciel au niveau du système d'exploitation ou physiquement.
Exemples :
— Le périmètre traitant des données personnelles est complètement physiquement séparé des autres systèmes ;
— Les sauvegardes sont conservées sur un système de stockage distinct.
D'autre part, les pools peuvent avoir une indépendance incomplète, par exemple, deux pools de ressources de calcul (puissance de traitement + mémoire vive) peuvent partager un pool de stockage de données commun et un pool de ressources de transmission de données commun.
Puissance de traitement
Les besoins abstraits en puissance de calcul des centres de données virtualisés sont mesurés en nombre de processeurs virtuels (vCPU) et en coefficient de leur consolidation sur les processeurs physiques (pCPU). Dans ce cas précis, 1 pCPU = 1 cœur physique de processeur (sans tenir compte du Hyper-Threading). Le nombre de vCPU est totalisé sur tous les pools de ressources définis (chacun pouvant avoir son propre coefficient de consolidation).
Le coefficient de consolidation pour les systèmes chargés est obtenu empiriquement, à partir de l'infrastructure existante, ou lors d'une installation pilote et de tests de charge. Pour les systèmes non chargés, des « best practices » sont appliquées. En particulier, VMware indique un coefficient moyen de 8:1.
Mémoire vive
Le besoin total en mémoire vive est obtenu par simple addition. L'utilisation de la surallocation de mémoire vive n'est pas recommandée.
Ressources de stockage
Les exigences en matière de ressources de stockage sont obtenues par simple addition de tous les pools en termes de volume et de performance.
Les exigences de performance sont exprimées en IOPS en combinaison avec le ratio moyen de lecture/écriture et, si nécessaire, la latence de réponse maximale.
Les exigences en matière de qualité de service (QoS) doivent être spécifiquement indiquées pour des pools ou systèmes particuliers.
Ressources de réseau de données
Les exigences en matière de réseau de données sont obtenues par simple addition de tous les pools de bande passante.
Les exigences en matière de qualité de service (QoS) et de latences (RTT) pour des pools ou systèmes particuliers doivent être spécifiquement indiquées.
Dans le cadre des exigences relatives aux ressources réseau, il convient également d'indiquer les exigences en matière d'isolation et/ou de cryptage du trafic réseau et les mécanismes préférés (802.1q, IPSec, etc.).
Choix de l'architecture
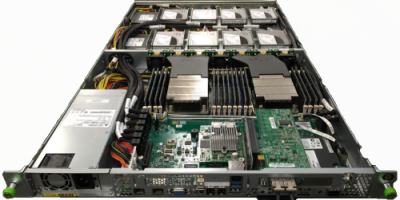
Dans le cadre de ce guide, aucun autre choix que l'architecture x86 et 100 % de virtualisation des serveurs n'est considéré. Ainsi, le choix de l'architecture du sous-système de calcul se réduit à celui de la plateforme de virtualisation des serveurs, au facteur de forme des serveurs et aux exigences générales en matière de configuration des serveurs.
Un point clé dans le choix est la certitude d'utiliser une approche classique de séparation des fonctions de traitement, de stockage et de transmission des données, ou convergente.
Architecture classique implique l'utilisation de systèmes de stockage et de transmission de données externes intelligents, tandis que les serveurs n'apportent au pool commun de ressources physiques que la puissance du processeur et la mémoire vive. Dans le cas extrême, les serveurs deviennent complètement anonymes, ne possédant ni disques durs, ni même d'identifiant système. Dans ce cas, le démarrage du système d'exploitation ou de l'hyperviseur s'effectue à partir de supports flash intégrés ou d'un système de stockage externe (boot from SAN).
Dans l'architecture classique, le choix entre les modules (blade) et les serveurs en rack (rack) se fait principalement selon les principes suivants :
— Efficacité économique (en moyenne, les serveurs en rack sont moins chers);
— Densité de calcul (plus élevée pour les blades);
— Consommation d'énergie et émission de chaleur (plus élevée par unité pour les blades);
— Scalabilité et gestionabilité (les blades nécessitent généralement moins d'efforts lors de grandes installations);
— Utilisation de cartes d'extension (choix très limité pour les blades).
Architecture convergente (également connue sous le nom de hyperconvergente) combine les fonctions de traitement et de stockage des données, ce qui entraîne l'utilisation de disques locaux dans les serveurs et, par conséquent, l'abandon du format classique des blades. Pour les systèmes convergents, on utilise soit des serveurs en rack, soit des systèmes en cluster qui combinent plusieurs serveurs blades et des disques locaux dans un seul boîtier.
CPU / Mémoire
Pour le calcul correct de la configuration, il est nécessaire de comprendre le type de charge pour l'environnement ou chacun des clusters indépendants.
Limité par le CPU – un environnement limité par la puissance de traitement du processeur. L'augmentation de la mémoire vive ne changera rien en termes de performance (nombre de VM sur le serveur).
Limité par la mémoire – un environnement limité par la mémoire vive. Une plus grande quantité de mémoire sur le serveur permet de lancer plus de VM sur le serveur.
GB / MHz (GB / pCPU) – le rapport moyen de consommation de la mémoire vive et de la puissance de traitement pour cette charge spécifique. Peut être utilisé pour le calcul du volume de mémoire nécessaire pour une performance donnée et vice versa.
Calcul de la configuration du serveur
Tout d'abord, il est nécessaire de définir tous les types de charge et de décider d'intégrer ou de diviser différents pools de calcul sur divers clusters.
Ensuite, pour chaque cluster défini, on détermine le rapport GB / MHz en fonction de la charge connue à l'avance. Si la charge n'est pas connue à l'avance, mais qu'on a une idée approximative du niveau de charge du processeur, on peut utiliser les coefficients standards vCPU:pCPU pour traduire les exigences des pools en physiques.
Pour chaque cluster, on divise la somme des exigences de vCPU par le coefficient :
vCPUtotal / vCPU:pCPU = pCPUtotal – nombre requis de cœurs physiques
pCPUtotal / 1.25 = pCPUht – nombre de cœurs ajusté pour le Hyper-Threading
Supposons qu'il soit nécessaire de calculer un cluster avec 190 cœurs / 3,5 To de RAM. Dans ce cas, nous prenons une charge cible de 50 % de capacité processeur et 75 % pour la mémoire vive.
pCPU
190
Utilisation du CPU
50%
Mem
3500
Utilisation de la mémoire
75%
Socket
Noyau
Srv / CPU
Srv Mémoire
Srv / Mémoire
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
Dans ce cas, nous utilisons toujours un arrondi au nombre entier supérieur (=ROUNDUP(A1;0)).
Le tableau montre clairement que plusieurs configurations de serveurs sont équilibrées par rapport aux indicateurs cibles :
— 26 serveurs 2*6c / 192 Go
— 19 serveurs 2*10c / 256 Go
— 10 serveurs 2*18c / 512 Go
Le choix entre ces configurations doit ensuite se faire en fonction de facteurs supplémentaires, tels que le package thermique et le refroidissement disponible, les serveurs déjà utilisés, ou le coût.
Caractéristiques du choix de la configuration du serveur
Machines virtuelles larges. En cas de nécessité de déployer des machines virtuelles larges (comparables à 1 nœud NUMA et plus), il est recommandé, dans la mesure du possible, de choisir un serveur avec une configuration permettant à ces VM de rester dans la limite du nœud NUMA. Avec un grand nombre de VM larges, il existe un risque de fragmentation des ressources du cluster, et dans ce cas, on choisit des serveurs permettant de déployer les VM larges aussi densément que possible.
Taille du domaine de défaillance unique.
Le choix de la taille du serveur se fait également sur le principe de minimisation du domaine de défaillance unique. Par exemple, lors du choix entre :
— 3 x 4*10c / 512 Go
— 6 x 2*10c / 256 Go
Si toutes choses sont égales par ailleurs, il faut choisir la deuxième option, car en cas de défaillance (ou de maintenance) d'un serveur, ce ne sont pas 33 % des ressources du cluster qui sont perdues, mais 17 %. De même, le nombre de VM et de services impactés par l'incident est réduit de moitié.
Calcul du stockage classique en fonction des performances
Le stockage classique est toujours calculé selon le pire scénario, en excluant l'impact du cache mémoire et l'optimisation des opérations.
Nous prenons comme indicateurs de référence la performance mécanique du disque (IOPSdisk) :
— 7.2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
Le nombre de disques dans le pool de disques est calculé avec la formule suivante : = TotalIOPS * ( RW + (1 – RW) * RAIDPen) / IOPSdisk. Où :
— TotalIOPS – performance totale requise en IOPS du pool de disques
— RW – pourcentage des opérations de lecture
— RAIDpen – pénalité RAID pour le niveau RAID choisi
Pour plus d'informations sur les dispositifs RAID et la pénalité RAID, voir ici — et et
En fonction du nombre de disques calculés, nous évaluons les différentes options répondant aux exigences en matière de capacité de stockage, y compris des options avec stockage hiérarchique.
Le calcul des systèmes utilisant des SSD comme niveau de stockage est traité séparément.
Particularités du calcul des systèmes avec Flash Cache
Flash Cache – terme générique pour toutes les technologies propriétaires utilisant la mémoire flash comme cache de deuxième niveau. Lors de l'utilisation du cache flash, le stockage est généralement calculé pour prendre en charge la charge établie des disques magnétiques, tandis que la charge de pointe est gérée par le cache.
Il est également nécessaire de comprendre le profil de charge et le degré de localisation des accès aux blocs des volumes de stockage. Le cache flash est une technologie pour les charges avec une haute localisation des requêtes, et pratiquement inapplicable pour les volumes avec une charge uniforme (comme par exemple pour les systèmes d'analyse).
Calcul des systèmes hybrides low-end / mid-range
Les systèmes hybrides de classe inférieure et intermédiaire utilisent un stockage à plusieurs niveaux avec un déplacement des données entre les niveaux selon un calendrier. Dans ce cas, la taille de bloc de stockage à plusieurs niveaux des meilleurs modèles atteint 256 Mo. Ces caractéristiques ne permettent pas de considérer la technologie de stockage à plusieurs niveaux comme une technologie d'amélioration des performances, comme beaucoup l'estiment à tort. Le stockage à plusieurs niveaux dans les systèmes de classe inférieure et intermédiaire est une technologie d'optimisation des coûts de stockage pour des systèmes présentant une charge inégale.
Pour le stockage hiérarchique, nous calculons d'abord les performances du niveau supérieur, tandis que le niveau inférieur n'est considéré que comme contribuant à la capacité de stockage manquante. Pour un système hybride à plusieurs niveaux, l'utilisation de la technologie de cache flash pour le pool hiérarchique est indispensable afin de compenser la chute de performance des données soudainement sollicitées du niveau inférieur.
Utilisation de SSD dans le pool de disques hiérarchique
L'utilisation de SSD dans le pool de disques hiérarchique varie en fonction des spécificités des algorithmes de cache flash de ce fabricant.
La pratique générale de la politique de stockage pour un pool de disques avec niveau SSD est — SSD first.
Read Only Flash Cache. Pour le cache flash en mode lecture seule, le niveau de stockage sur SSD apparaît lors d'une localisation significative des opérations d'écriture, indépendamment du cache.
Cache Flash en Lecture / Écriture. Dans le cas d'un cache flash en écriture, un maximum de taille de cache est d'abord établi, et le niveau de stockage sur SSD n'apparaît que lorsque la taille du cache est insuffisante pour traiter toute la charge localisée.
La performance du SSD et du cache est toujours calculée en fonction des recommandations du fabricant, mais toujours pour le pire des cas.
Source : habr.com
