

(merci pour l'idée du titre Sergey G. Brester )
Chers collègues, l'objectif de cet article est de partager mon expérience d'une année d'exploitation test d'une nouvelle catégorie de solutions IDS basées sur les technologies de tromperie.
Pour maintenir la cohérence logique de l'exposé, je pense qu'il est nécessaire de commencer par les préjugés. Ainsi, la problématique :
- Les attaques ciblées sont le type d'attaque le plus dangereux, bien que leur part dans le nombre total de menaces soit faible.
- Il n'existe pas encore de moyen de protection du périmètre (ou de complexe de tels moyens) garantissant une efficacité.
- En général, les attaques ciblées se déroulent en plusieurs étapes. La pénétration du périmètre n'est qu'une des étapes initiales, qui (vous pouvez me lancer des pierres) ne cause pas de grands dommages à la "victime", à moins bien sûr qu'il ne s'agisse d'attaques DEoS (Destruction of service) (ransomware, etc.). La véritable douleur commence plus tard, lorsque les actifs saisis commencent à être utilisés pour le pivotement et le développement de l'attaque "en profondeur", et que nous ne l'avons pas remarqué.
- Étant donné que nous commençons à subir de véritables pertes quand les attaquants parviennent à atteindre leurs cibles (serveurs d'applications, SGBD, stockage de données, dépôts, éléments d'infrastructure critique), il est logique que l'une des tâches du service de sécurité de l'information soit d'interrompre les attaques avant cet événement malheureux. Mais pour pouvoir interrompre quelque chose, il faut d'abord en avoir connaissance. Et plus tôt c'est fait, mieux c'est.
- En conséquence, pour une gestion efficace des risques (c'est-à-dire la réduction des dommages causés par des attaques ciblées), il est essentiel de disposer d'outils qui garantissent un TTD minimal (time to detect – temps entre l'intrusion et la découverte de l'attaque). Selon l'industrie et la région, cette période est en moyenne de 99 jours aux États-Unis, 106 jours dans la région EMEA, 172 jours dans la région APAC (M-Trends 2017, A View From the Front Lines, Mandiant).
- Que propose le marché ?
- "Sables mouvants". Un autre contrôle préventif qui est loin d'être idéal. Il existe de nombreuses techniques efficaces pour détecter et contourner les environnements sandbox ou les solutions de liste blanche. Les gars du "côté obscur" sont encore un pas en avant ici.
- UEBA (systèmes de profilage du comportement et de détection des anomalies) peut être très efficace en théorie. Mais, à mon avis, cela relève d'un avenir lointain. En pratique, c'est encore très coûteux, peu fiable et nécessite une infrastructure informatique et de sécurité de l'information très mature et stable, où tous les outils nécessaires à la génération de données pour l'analyse comportementale sont déjà en place.
- SIEM est un bon outil pour les enquêtes, mais il ne peut pas détecter et montrer quelque chose de nouveau et d'original à temps, car les règles de corrélation restent les mêmes signatures.
- Ainsi, il est devenu essentiel d'avoir un outil qui :
- fonctionne efficacement dans un périmètre déjà compromis,
- détecte des attaques réussies en quasi temps réel, indépendamment des outils et des vulnérabilités utilisées,
- ne dépend pas des signatures/règles/scénarios/politiques/profils et d'autres éléments statiques,
- ne nécessite pas de grands ensembles de données et de sources pour l'analyse,
- permet de définir les attaques non pas comme un risque à évaluer, résultant d'une "mathématique fermée, brevetée et donc secrète", nécessitant une enquête supplémentaire, mais pratiquement comme un événement binaire – "Oui, nous sommes attaqués" ou "Non, tout va bien",
- soit universel, évolutif de manière efficace et réellement déployable dans n'importe quel environnement hétérogène, indépendamment de la topologie réseau physique et logique utilisée.
Les solutions de déception prétendent actuellement répondre à ce besoin. Il s'agit de solutions basées sur le vieux concept de honeypots, mais avec un tout autre niveau de mise en œuvre. Ce sujet est actuellement sans aucun doute en plein essor.
Selon les résultats de Les solutions de déception figurent parmi les trois principales stratégies et outils recommandés.
Selon le rapport La déception est l'une des principales directions de développement des solutions IDS (systèmes de détection des intrusions).
Une section entière du dernier , dédiée à SCADA, est basée sur les données d'un des leaders de ce marché, TrapX Security (Israël), dont la solution fonctionne déjà depuis un an dans notre zone de test.
Le TrapX Deception Grid permet de configurer et d'exploiter des IDS distribués massifs de manière centralisée, sans augmenter la charge de licence et les exigences en matière de ressources matérielles. En fait, TrapX est un constructeur qui permet de créer, à partir d'éléments de l'infrastructure informatique existante, un grand mécanisme de détection des attaques à l'échelle de l'entreprise, une sorte de « système d'alerte » réseau distribué.
Structure de la Solution
Dans notre laboratoire, nous étudions et testons constamment diverses nouveautés dans le domaine de la cybersécurité. Actuellement, environ 50 serveurs virtuels différents sont déployés ici, y compris les composants du TrapX Deception Grid.
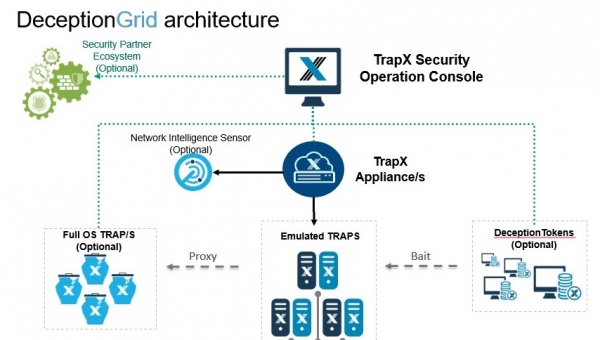
Alors, de haut en bas :
- TSOC (TrapX Security Operation Console) – le cerveau du système. C'est la console de gestion centrale à travers laquelle se fait la configuration, le déploiement de la solution et l'ensemble des opérations quotidiennes. Étant un service web, il peut être déployé n'importe où – dans le périmètre, dans le cloud ou chez un fournisseur MSSP.
- TrapX Appliance (TSA) – un serveur virtuel, auquel nous connectons, via un port trunk, les sous-réseaux que nous souhaitons surveiller. En fait, tous nos capteurs réseau « vivent » ici.
Un TSA (mwsapp1) est déployé dans notre laboratoire, mais en réalité, il peut y en avoir plusieurs. Cela peut être nécessaire dans les grands réseaux où il n'y a pas de connectivité L2 entre les segments (un exemple typique est « la société mère et ses filiales » ou « le siège d'une banque et ses agences ») ou si le réseau a des segments isolés, par exemple, en automatisation de processus industriels. Dans chaque filiale/segment, un TSA peut être déployé et connecté à un TSOC unique, où toutes les informations seront traitées de manière centralisée. Cette architecture permet de construire des systèmes de surveillance distribués sans avoir besoin d'une refonte radicale du réseau ou de compromettre la segmentation existante.
De plus, nous pouvons transmettre une copie du trafic sortant via TAP/SPAN sur le TSA. En cas de détection de connexions avec des botnets connus, des serveurs de commande, des sessions TOR, nous obtiendrons également un résultat dans la console. Cela est géré par le Network Intelligence Sensor (NIS). Dans notre environnement, cette fonctionnalité est réalisée sur le pare-feu, donc nous ne l'avons pas utilisée ici.
- Application Traps (Full OS) – des honeypots traditionnels basés sur des serveurs Windows. Il n'en faut pas beaucoup, car la tâche principale de ces serveurs est de fournir des services informatiques au niveau suivant des capteurs ou d'identifier les attaques sur des applications métiers qui peuvent être déployées dans un environnement Windows. Dans notre laboratoire, nous avons installé un tel serveur (FOS01)

- Les pièges émulés – le composant clé de la solution, qui nous permet de créer, à l'aide d'une seule machine virtuelle, un champ de mines très dense pour les attaquants et de saturer le réseau de l'entreprise, tous ses VLAN, avec nos capteurs. L'attaquant voit ce capteur, ou hôte fantôme, comme un véritable PC ou serveur Windows, un serveur Linux ou un autre appareil que nous choisissons de lui montrer.

Pour le bien de la cause et par curiosité, nous avons déployé « une paire de chaque espèce » – des PC Windows et des serveurs de différentes versions, des serveurs Linux, un distributeur automatique avec Windows embedded, SWIFT Web Access, une imprimante réseau, un switch Cisco, une caméra IP Axis, un MacBook, un dispositif PLC et même une ampoule intelligente. En tout, 13 hôtes. En général, le fournisseur recommande de déployer un tel capteur en quantité d'au moins 10 % du nombre d'hôtes réels. Le plafond supérieur est l'espace d'adresses disponible.Un point très important est que chaque hôte de ce type n'est pas une machine virtuelle à part entière, nécessitant des ressources et des licences. C'est une « tromperie », une émulation, un seul processus sur le TSA, qui a un ensemble de paramètres et une adresse IP. Ainsi, même avec un seul TSA, nous pouvons saturer le réseau avec des centaines de ces hôtes fantômes, qui fonctionneront comme des capteurs dans le système d'alarme. C'est précisément cette technologie qui permet de mettre en œuvre de manière économiquement efficace le concept de « honeypots » à l'échelle de toute grande entreprise distribuée.
Ces hôtes sont du point de vue de l'attaquant attrayants, car ils contiennent des vulnérabilités et apparaissent comme des cibles relativement faciles. L'attaquant voit les services sur ces hôtes et peut interagir avec eux, les attaquer, en utilisant des outils et protocoles standard (smb/wmi/ssh/telnet/web/dnp/bonjour/Modbus, etc.). Mais il est impossible d'utiliser ces hôtes pour faire évoluer l'attaque ou exécuter son code.
- La combinaison de ces deux technologies (FullOS et pièges émulés) permet d'atteindre une probabilité statistique élevée que l'attaquant soit tôt ou tard confronté à un élément de notre réseau de signalisation. Mais comment faire en sorte que cette probabilité soit proche de 100 % ?
Entrent en jeu les soi-disant jetons (Deception tokens). Grâce à eux, nous pouvons intégrer tous les PC et serveurs de l'entreprise dans notre IDS distribué. Les jetons sont placés sur de vrais PC utilisateurs. Il est important de comprendre que les jetons ne sont pas des agents qui consomment des ressources et peuvent provoquer des conflits. Les jetons sont des éléments d'information passifs, une sorte de "miettes de pain" pour l'attaquant, qui le mènent dans un piège. Par exemple, des disques réseau connectés, des favoris vers des faux panneaux d'administration dans le navigateur et des mots de passe enregistrés pour ceux-ci, des sessions ssh/rdp/winscp sauvegardées, nos pièges avec des commentaires dans les fichiers hosts, des mots de passe enregistrés en mémoire, des identifiants d'utilisateurs inexistants, des fichiers de bureau dont l'ouverture déclencherait le système, et bien d'autres. Ainsi, nous plaçons l'attaquant dans un environnement distordu, saturé des vecteurs d'attaque qui, en réalité, ne représentent pas une menace pour nous, mais plutôt le contraire. Et il n'a pas la possibilité de déterminer où se trouve l'information vraie et où se trouve le faux. Ainsi, nous assurons non seulement une détection rapide de l'attaque, mais ralentissons également considérablement sa progression.
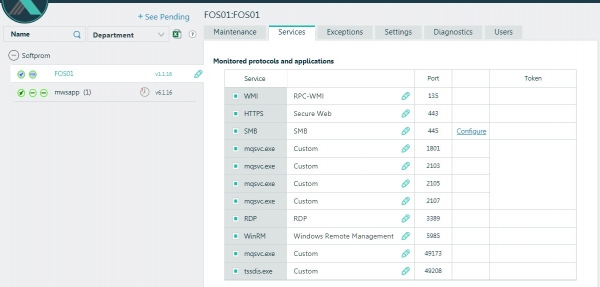
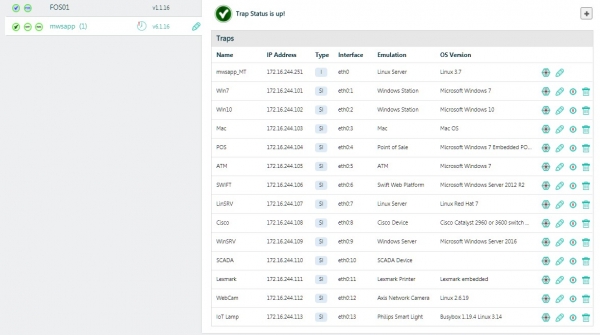
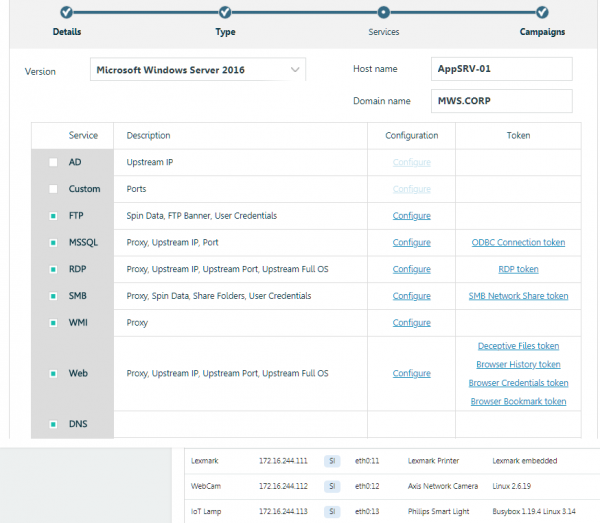
Exemple de création d'un piège réseau et de configuration des jetons. Interface conviviale et aucune modification manuelle des configurations, scripts, etc.
Dans notre environnement, nous avons configuré et placé un certain nombre de ces jetons sur FOS01 sous Windows Server 2012R2 et sur un PC de test sous Windows 7. Sur ces machines, RDP est actif et nous les "exposons" périodiquement dans la DMZ, où se trouvent également plusieurs de nos capteurs (pièges émulés). Ainsi, nous obtenons un flux constant d'incidents, en quelque sorte de manière naturelle.
Alors, un bref aperçu des statistiques de l'année :
56 208 – incidents enregistrés,
2 912 – hôtes sources d'attaques détectés.
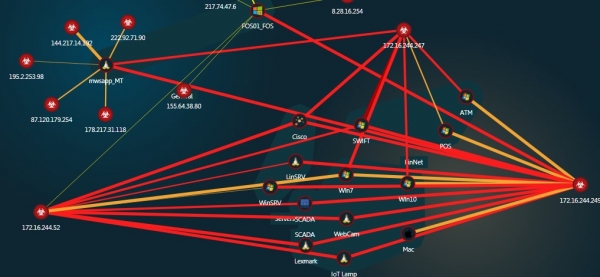
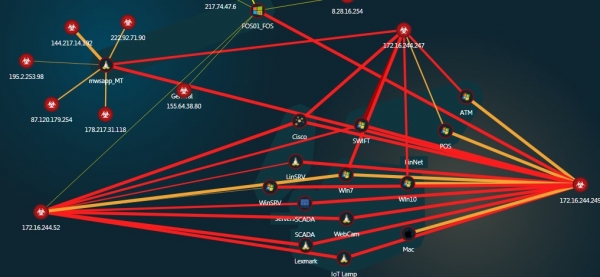
Carte interactive et cliquable des attaques
Ainsi, la solution ne génère pas de méga-log ou de flux d'événements à analyser en profondeur. Au lieu de cela, la solution classe elle-même les événements par type et permet à l'équipe de sécurité de se concentrer d'abord sur les plus dangereux – lorsque l'attaquant tente d'établir des sessions de contrôle (interaction) ou lorsque des charges utiles binaires apparaissent dans notre trafic (infection).
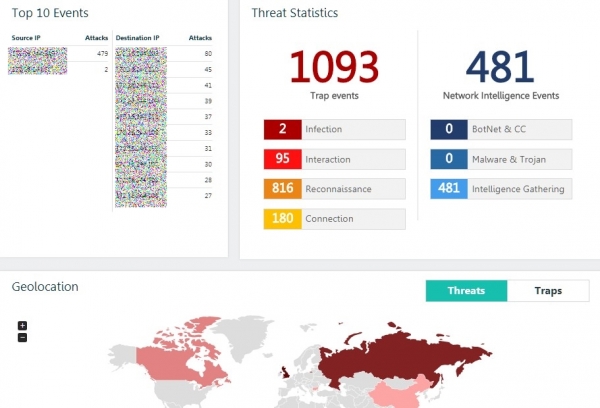
Toutes les informations sur les événements sont lisibles et, à mon avis, présentées de manière facile à comprendre même pour un utilisateur avec des connaissances de base en sécurité informatique.
La plupart des incidents enregistrés sont des tentatives de scan de nos hôtes ou d'établissements de connexions uniques.
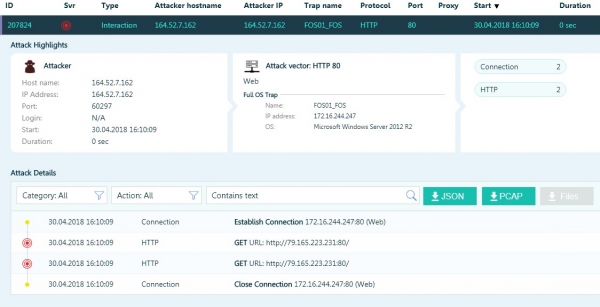
Ou des tentatives de bruteforce pour RDP.
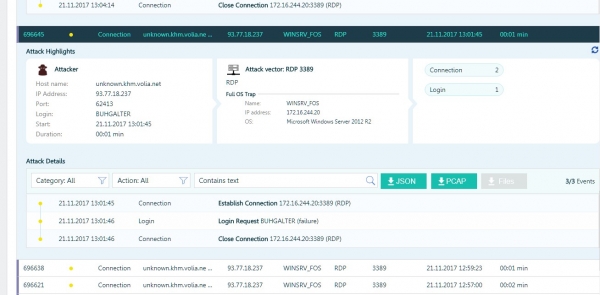
Mais il y a eu des cas plus intéressants, surtout lorsque les attaquants réussissaient à trouver le mot de passe pour RDP et à accéder au réseau local.
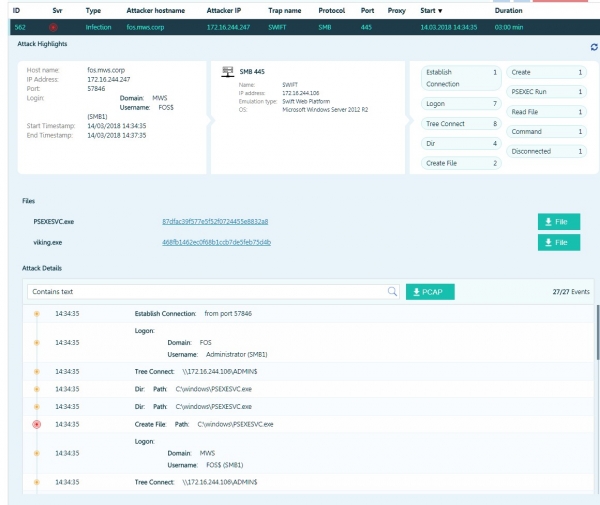
L'attaquant tente d'exécuter du code à l'aide de psexec.
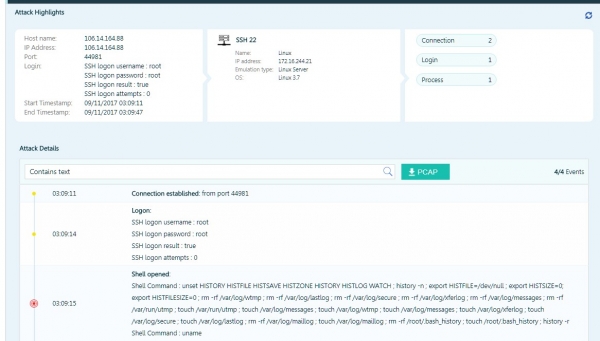
L'attaquant a trouvé une session sauvegardée, qui l'a piégé sur un serveur Linux. Dès la connexion, avec un ensemble de commandes préenregistrées, il a tenté de détruire tous les fichiers journaux et les variables système correspondantes.
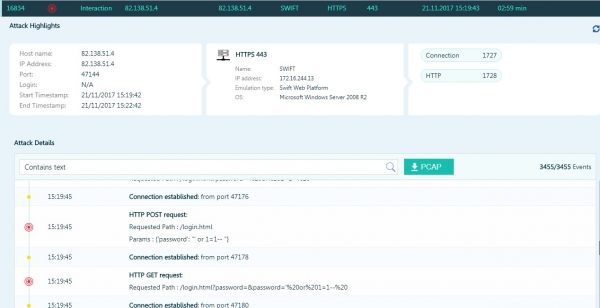
L'attaquant essaie de réaliser une injection SQL sur un piège qui imite SWIFT Web Access.
Outre ces attaques « naturelles », nous avons également mené plusieurs tests de notre propre initiative. L'un des plus révélateurs est le test de temps de détection d'un ver réseau dans le réseau. Pour cela, nous avons utilisé un outil de GuardiCore, qui s'appelle . C'est un ver réseau capable d'infecter Windows et Linux, mais sans charge utile « utile ».
Nous avons déployé un centre de commande local, sur l'une des machines, nous avons lancé le premier échantillon de ver et avons reçu la première alerte dans la console TrapX en moins d'une minute et demie. TTD 90 secondes contre 106 jours en moyenne…
Grâce à la possibilité d'intégration avec d'autres types de solutions, nous pouvons passer d'une détection rapide des menaces à une réponse automatique à celles-ci.
Ainsi, par exemple, l'intégration avec des systèmes NAC (Network Access Control) ou avec CarbonBlack permettra de déconnecter automatiquement les PC compromis du réseau.
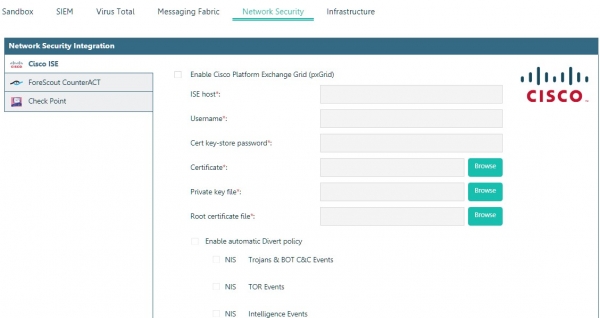
L'intégration avec des sandbox permet de transmettre automatiquement pour analyse les fichiers impliqués dans l'attaque.
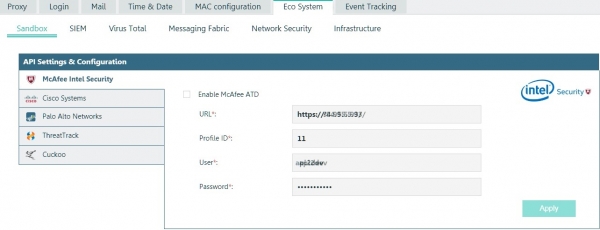
Intégration avec McAfee
La solution comprend également un système de corrélation des événements intégré.
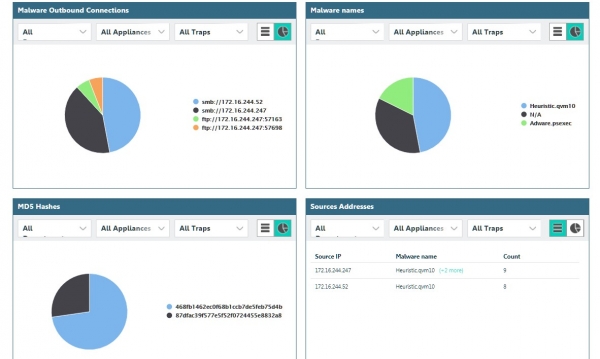
Mais ses capacités ne nous ont pas satisfait, alors nous l'avons intégré avec HP ArcSight.
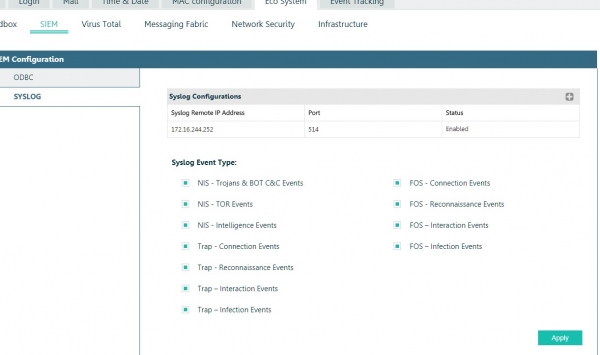
Gérer les menaces détectées « en équipe » est facilité par un système de ticketing intégré.
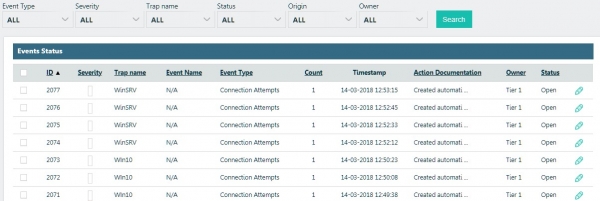
Comme la solution a été conçue dès le départ pour les besoins des organes gouvernementaux et du grand segment d'entreprise, elle intègre naturellement un modèle d'accès basé sur les rôles, l'intégration avec AD, un système de rapports avancé et des déclencheurs (notifications d'événements), ainsi que l'orchestration pour les grandes structures holdings ou les fournisseurs MSSP.
Au lieu d'un résumé
S'il existe un tel système de surveillance qui, pour ainsi dire, nous couvre le dos, alors la compromission du périmètre n'est que le début. Ce qui est le plus important, c'est qu'il devient réellement possible de lutter contre les incidents de sécurité de l'information, et non de se contenter de gérer leurs conséquences.
Source : habr.com
