

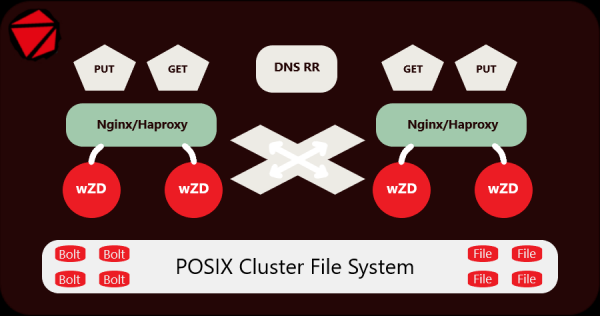
Chère communauté, cet article sera consacré à la gestion efficace de centaines de millions de petits fichiers. À ce stade, une solution finale est proposée pour les systèmes de fichiers compatibles POSIX, avec un soutien complet pour les verrous, y compris les verrous clusterisés, et apparemment même sans béquilles cette fois-ci.
C'est pourquoi j'ai écrit mon propre serveur spécialisé pour cet objectif.
Au cours de la mise en œuvre de cette tâche, nous avons pu résoudre le problème principal et économiser de l'espace disque et de la mémoire vive, que notre système de fichiers en cluster consommait sans relâche. En effet, une telle quantité de fichiers est nuisible pour n'importe quel système de fichiers en cluster.
L'idée est simple :
En termes simples, les petits fichiers sont téléchargés via le serveur, ils sont enregistrés directement dans une archive, puis également lus à partir de celle-ci, tandis que les gros fichiers sont stockés séparément. Schéma : 1 dossier = 1 archive, ce qui nous donne plusieurs millions d'archives contenant de petits fichiers, et non pas plusieurs centaines de millions de fichiers. Et tout cela est réalisé pleinement, sans aucun script ni dispersion de fichiers dans des archives tar/zip.
Je vais essayer de résumer, je m'excuse d'avance si le post s'avère dense.
Tout a commencé lorsque je n'ai pas pu trouver de serveur adéquat capable de stocker des données reçues via le protocole HTTP directement dans des archives, afin qu'il n'y ait pas d'inconvénients typiques des archives ordinaires et des stockages d'objets. La raison de cette recherche était un cluster Origin en pleine expansion de 10 serveurs, qui avait accumulé 250 000 000 petits fichiers, et la tendance à la hausse ne semblait pas vouloir s'arrêter.
Pour ceux qui n'aiment pas lire les articles, voici une documentation simplifiée :
et .
Et docker au passage, actuellement il n'y a d'option qu'avec nginx à l'intérieur à tout hasard :
docker run -d --restart=always -e host=localhost -e root=\/var\/storage
-v \/var\/storage:\/var\/storage --name wzd -p 80:80 eltaline\/wzd
Suivant :
Lorsque le nombre de fichiers est très élevé, des ressources considérables sont nécessaires, et, ce qui est le plus frustrant, une partie de celles-ci est gaspillées. Par exemple, lors de l'utilisation d'un système de fichiers en cluster (dans ce cas, MooseFS), un fichier, quelle que soit sa taille réelle, occupe toujours au minimum 64 Ko. Donc, pour des fichiers de 3, 10 ou 30 Ko, 64 Ko sont nécessaires sur le disque. Avec un quart de milliard de fichiers, nous perdons de 2 à 10 téraoctets. Il est impossible de continuer à créer de nouveaux fichiers indéfiniment, car dans MooseFS, il y a une limitation : pas plus d'un milliard avec une réplique de chaque fichier.
À mesure que le nombre de fichiers augmente, il faut beaucoup de mémoire vive pour les métadonnées. De plus, des copies de métadonnées fréquentes et volumineuses contribuent à l'usure des disques SSD.
Serveur wZD. Nous mettons de l'ordre sur les disques.
Le serveur est écrit en Go. Tout d'abord, j'avais besoin de réduire le nombre de fichiers. Comment faire cela ? Grâce à l'archivage, mais dans ce cas, sans compression, car mes fichiers sont des images compressées. BoltDB m'a aidé, bien que j'aie dû corriger certains défauts, ce qui est mentionné dans la documentation.
Au total, au lieu d'un quart de milliard de fichiers, il ne reste que 10 millions d'archives Bolt dans mon cas. Si j'avais eu la possibilité de modifier la structure actuelle de remplissage des répertoires, il serait peut-être possible de réduire cela à environ 1 million de fichiers.
Tous les petits fichiers sont empaquetés dans des archives Bolt, qui obtiennent automatiquement les noms des répertoires dans lesquels ils se trouvent, tandis que tous les gros fichiers restent à côté des archives, car il n'est pas judicieux de les emballer. C'est configurable. Les petits fichiers sont archivés, les gros restent inchangés. Le serveur fonctionne de manière transparente avec les deux types.
Architecture et caractéristiques du serveur wZD.
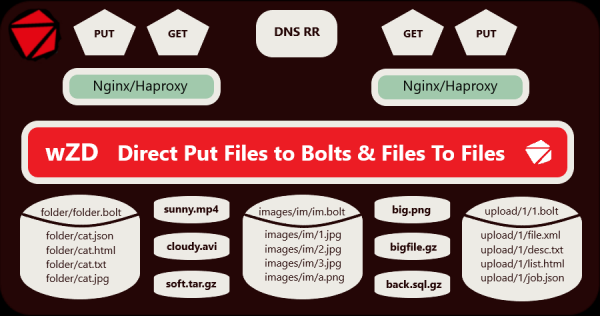
Le serveur fonctionne sous les systèmes d'exploitation Linux, BSD, Solaris et OSX. J'ai testé uniquement pour l'architecture AMD64 sous Linux, mais il devrait également convenir pour ARM64, PPC64, MIPS64.
Les principales fonctionnalités :
- Multithreading ;
- Multi-serveurs, assurant la tolérance aux pannes et l'équilibrage de la charge ;
- Transparence maximale pour l'utilisateur ou le développeur ;
- Méthodes HTTP prises en charge : GET, HEAD, PUT et DELETE ;
- Contrôle du comportement lors de la lecture et de l'écriture via des en-têtes clients ;
- Support de l'hébergement virtuel flexible ;
- Support de l'intégrité des données CRC lors de l'écriture/lecture ;
- Buffers semi-dynamiques pour une consommation minimale de mémoire et un réglage optimal des performances réseau ;
- Compactage des données à la demande ;
- En complément, un archiveur multithreadé wZA est proposé pour la migration des fichiers sans arrêter le service.
Expérience réelle :
J'ai développé et testé un serveur et un archiveur sur des données en direct pendant une durée assez longue, et maintenant il fonctionne avec succès sur un cluster comprenant 250 000 000 de petits fichiers (images), répartis dans 15 000 000 de répertoires sur des disques SATA séparés. Le cluster de 10 serveurs représente un serveur d'origine, installé derrière un réseau CDN. Pour son entretien, on utilise 2 serveurs Nginx + 2 serveurs wZD.
Pour ceux qui décident d'utiliser ce serveur, il est judicieux de planifier la structure des répertoires avant utilisation, si cela est applicable. Je précise immédiatement que le serveur n'est pas conçu pour tout entasser dans un seul archive Bolt.
Test de performance :
Plus la taille du fichier archivé est petite, plus les opérations GET et PUT sont rapides. Comparons le temps total d'écriture d'un client HTTP dans des fichiers normaux et dans des archives Bolt, ainsi que la lecture. Nous comparons le travail avec des fichiers de tailles 32 Ko, 256 Ko, 1024 Ko, 4096 Ko et 32768 Ko.
Lors de l'utilisation des archives Bolt, l'intégrité des données de chaque fichier est vérifiée (un CRC est utilisé), et avant l'écriture ainsi qu'après l'écriture, une lecture à la volée et un nouveau calcul ont lieu, ce qui entraîne naturellement des délais, mais l'essentiel est la sécurité des données.
J'ai effectué les tests de performance sur des SSD, car sur des disques SATA, les tests ne montrent pas de différence claire.
Graphiques des résultats des tests :
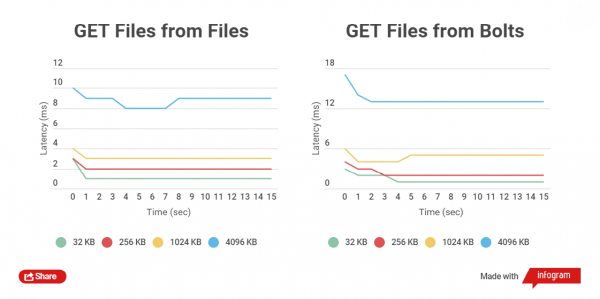
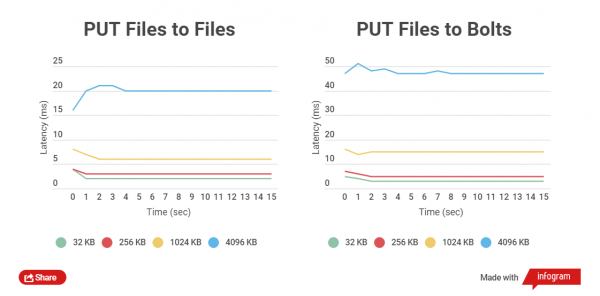
Comme on peut le voir, pour les petits fichiers, la différence de temps de lecture et d'écriture entre les fichiers archivés et non archivés est faible.
Nous obtiendrons une image complètement différente lors du test de lecture et d'écriture de fichiers de 32 Mo :
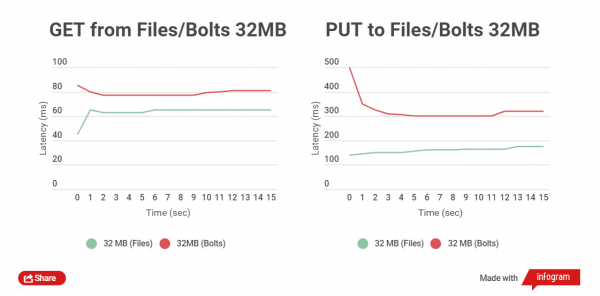
La différence de temps entre la lecture des fichiers est d'environ 5 à 25 ms. Pour l'écriture, la situation est pire, la différence est d'environ 150 ms. Mais dans ce cas, il n'est pas nécessaire de télécharger de gros fichiers, cela n'a tout simplement pas de sens, ils peuvent vivre séparément des archives.
*Techniquement, ce serveur peut également être utilisé pour des tâches nécessitant NoSQL.
Principales méthodes de travail avec le serveur wZD :
Téléchargement d'un fichier normal :
curl -X PUT --data-binary @test.jpg http://localhost/test/test.jpgTéléchargement d'un fichier dans une archive Bolt (si la parameter serveur fmaxsize, qui détermine la taille maximale du fichier pouvant être inclus dans l'archive, n'est pas dépassé; si elle est dépassée, le fichier sera téléchargé normalement à côté de l'archive) :
curl -X PUT -H "Archive: 1" --data-binary @test.jpg http://localhost/test/test.jpgTéléchargement de fichier (si le disque et l'archive contiennent des fichiers avec les mêmes noms, par défaut, la priorité est donnée au fichier non archivé) :
curl -o test.jpg http://localhost/test/test.jpgTéléchargement forcé d'un fichier depuis l'archive Bolt :
curl -o test.jpg -H "FromArchive: 1" http://localhost/test/test.jpgLa description d'autres méthodes se trouve dans la documentation.
Le serveur ne prend pour l'instant en charge que le protocole HTTP, HTTPS n'est pas encore opérationnel. La méthode POST n'est pas non plus supportée (il n'est pas encore déterminé si elle est nécessaire ou non).
Quiconque fouille dans le code source y découvrira une petite friandise, que tout le monde n'apprécie pas, mais je n'ai pas lié le code principal aux fonctions du framework web, à part le gestionnaire d'interruptions, donc je peux le réécrire rapidement sur presque n'importe quel moteur par la suite.
À faire :
- Développement d'un réplica et d'un distributeur personnalisés + géo pour une utilisation dans de grands systèmes sans systèmes de fichiers en cluster (tout en grand)
- Possibilité de restauration complète des métadonnées en cas de perte totale (en cas d'utilisation du distributeur)
- Protocole natif pour permettre l'utilisation de connexions réseau constantes et pilotes pour différents langages de programmation
- Fonctionnalités avancées d'utilisation de la composante NoSQL
- Compression de différents types (gzip, zstd, snappy) pour des fichiers ou des valeurs à l'intérieur des archives Bolt et pour des fichiers ordinaires
- Chiffrement de différents types pour des fichiers ou des valeurs à l'intérieur des archives Bolt et pour des fichiers ordinaires
- Conversion vidéo serveur différée, y compris sur GPU
C'est tout pour moi, j'espère que ce serveur sera utile à quelqu'un, licence BSD-3, copyright double, car sans l'entreprise où je travaille, je n'aurais pas écrit ce serveur. Je suis le seul développeur. Je serais reconnaissant pour les bugs trouvés et les demandes de fonctionnalités.
Source : habr.com
