

Comme ClickHouse est un système spécialisé, il est important de prendre en compte les particularités de son architecture lors de son utilisation. Dans cette présentation, Alexey évoquera des exemples d'erreurs typiques liées à l'utilisation de ClickHouse, qui peuvent entraîner une performance inefficace. Des exemples pratiques montreront comment le choix d'un schéma de traitement des données peut changer la performance de manière significative.
Bonjour à tous ! Je m'appelle Alexey, je travaille avec ClickHouse.
Tout d'abord, je suis heureux de vous annoncer que je ne vais pas vous expliquer aujourd'hui ce qu'est ClickHouse. Honnêtement, j'en ai assez de le faire. Je le présente à chaque fois. Et, probablement, tout le monde est déjà au courant.
À la place, je vais aborder les pièges possibles, c'est-à-dire comment ClickHouse peut être mal utilisé. En réalité, il n'y a pas de quoi s'inquiéter, car nous développons ClickHouse comme un système simple, pratique, qui fonctionne dès l'installation. Il suffit de l'installer, et tout est prêt, sans aucun problème.
Cependant, il faut garder à l'esprit que ce système est spécialisé, et il est facile de tomber sur un scénario d'utilisation inhabituel qui sortira le système de sa zone de confort.
Alors, quels sont ces pièges ? Je vais principalement aborder les points évidents. Tout le monde comprend tout, et peut se réjouir d'être intelligent, et ceux qui ne comprennent pas apprendront quelque chose de nouveau.
Le premier exemple très simple, qui, malheureusement, se rencontre souvent, c'est un grand nombre d'inserts avec de petits lots, c'est-à-dire une multitude de petits inserts.
Si l'on considère comment ClickHouse effectue un insert, vous pouvez envoyer un flux de données d'un téraoctet en une seule requête. Ce n'est pas un problème.
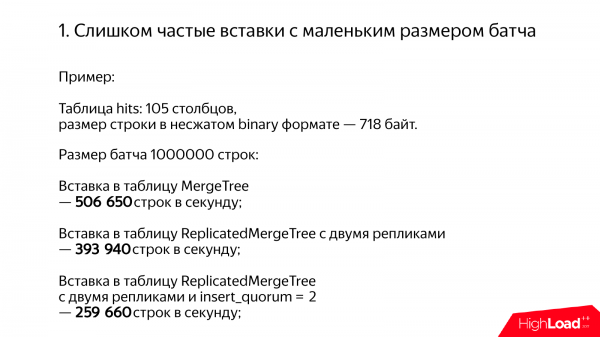
Jetons un œil à la performance typique. Par exemple, nous avons une table avec des données de Yandex.Metrica. Des hits. 105 colonnes diverses. 700 octets en brut. Et nous allons insérer correctement des lots d'un million de lignes.
Nous insérons dans une table MergeTree, ce qui donne un demi-million de lignes par seconde. Excellent. Dans une table répliquée, ce sera un peu moins, environ 400 000 lignes par seconde.
Et si nous activons l'insertion par quorum, nous obtenons un peu moins, mais tout de même une performance respectable, 250 000 lignes par seconde. L'insertion par quorum est une fonctionnalité non documentée dans ClickHouse*.
* au 2020 .
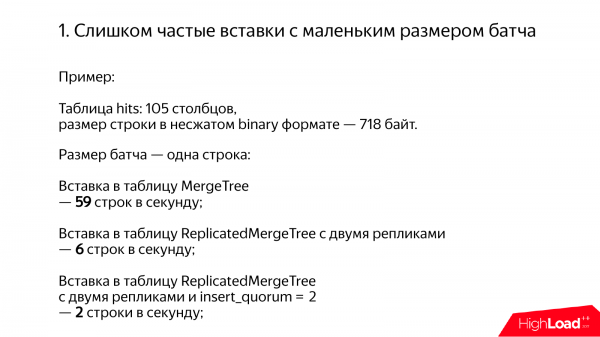
Que se passe-t-il si cela se fait mal ? Nous insérons une ligne à la fois dans la table MergeTree et cela donne 59 lignes par seconde. C'est 10 000 fois plus lent. Avec ReplicatedMergeTree, c'est 6 lignes par seconde. Et si en plus le quorum est activé, cela tombe à 2 lignes par seconde. À mon avis, c'est un véritable désastre. Comment peut-on avoir un tel ralentissement ? Même sur mon T-shirt, il est écrit que ClickHouse ne doit pas ramer. Pourtant, cela arrive parfois.
En réalité, c'est notre défaut. Nous aurions pu faire en sorte que tout fonctionne correctement, mais nous ne l'avons pas fait. Et nous ne l'avons pas fait parce que pour notre scénario, ce n'était pas nécessaire. Nous avions déjà des lots. Les données arrivaient sous forme de lots, sans aucun problème. Nous insérons et tout fonctionne bien. Mais bien sûr, divers scénarios sont possibles. Par exemple, lorsque vous avez plusieurs serveurs sur lesquels les données sont générées. Et ils insèrent des données pas si souvent, mais les insertions restent fréquentes. Il faut donc éviter cela d'une manière ou d'une autre.
D'un point de vue technique, l'essentiel est qu'au moment où vous effectuez un insert dans ClickHouse, les données n'atterrissent dans aucune memtable. Nous n'avons même pas de MergeTree à structure de journal véritable, mais simplement un MergeTree, car il n'y a ni journal ni memTable. Nous écrivons directement les données dans le système de fichiers, déjà disposées par colonnes. Et si vous avez 100 colonnes, il faudra écrire plus de 200 fichiers dans un répertoire distinct. Tout cela est assez lourd.
Et la question se pose : « Comment faire correctement ? », si nous devons quand même enregistrer des données dans ClickHouse.
Méthode 1. C'est la méthode la plus simple. Utiliser une sorte de file d'attente distribuée. Par exemple, Kafka. Vous extrayez simplement les données de Kafka, vous les regroupez toutes les secondes. Et tout ira bien, vous insérez, tout fonctionne correctement.
Les inconvénients sont que Kafka est encore un système distribué encombrant. Je peux comprendre si votre entreprise dispose déjà de Kafka. C'est bien, c'est pratique. Mais s'il n'est pas là, il vaut mieux réfléchir à deux fois avant d'introduire un autre système distribué dans votre projet. C'est pourquoi il vaut la peine d'envisager des alternatives.
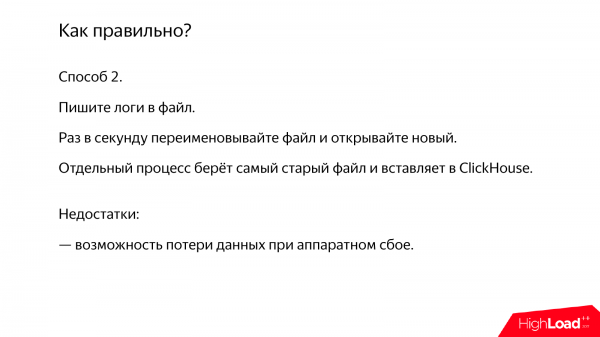
Méthode 2. Voici une alternative old-school qui est très simple. Vous avez un serveur qui génère vos journaux. Il enregistre simplement vos journaux dans un fichier. Vous renommez ce fichier une fois par seconde, par exemple, et ouvrez un nouveau. Un script distinct, soit via cron, soit un daemon, prend le fichier le plus ancien et l'enregistre dans ClickHouse. Si vous enregistrez les journaux une fois par seconde, tout ira bien.
Mais l'inconvénient de cette méthode est que si le serveur qui génère les journaux disparaît, les données disparaîtront aussi.
Méthode 3. Il existe une autre méthode intéressante qui ne nécessite pas de fichiers temporaires. Par exemple, vous avez une sorte de service publicitaire ou un autre daemon intéressant qui génère des données. Vous pouvez accumuler un ensemble de données directement en mémoire, dans un tampon. Lorsque suffisamment de temps s'est écoulé, vous mettez ce tampon de côté, créez un nouveau, et dans un fil distinct, vous insérez ce qui a déjà été accumulé dans ClickHouse.
D'un autre côté, les données disparaissent également avec un kill -9. Si votre serveur s'effondre, ces données seront perdues. Et un autre problème est que si vous ne parvenez pas à les enregistrer dans la base, vous accumulerez des données en mémoire. Cela peut soit épuiser votre mémoire vive, soit simplement entraîner une perte de données.
Méthode 4. Voici une autre méthode intéressante. Vous avez un processus serveur. Il peut envoyer des données directement à ClickHouse, mais le faire dans une seule connexion. Par exemple, envoyer une requête http avec transfer-encoding: chunked avec un insert. Et il génère des chunks pas trop rarement, vous pouvez envoyer chaque ligne, bien qu'il y ait un overhead lié à l'encodage de ces données.
Cependant, dans ce cas, les données seront immédiatement envoyées à ClickHouse. Et ClickHouse les mettra lui-même en mémoire tampon.
Mais il y a également des problèmes. Vous perdrez des données, notamment lorsque votre processus se termine et si le processus ClickHouse se termine, car cela sera un insert inachevé. Les inserts dans ClickHouse sont atomiques jusqu'à un certain seuil spécifié en nombre de lignes. En principe, c'est une méthode intéressante. On peut également l'utiliser.
Méthode 5. Voici une autre méthode intéressante. Il s'agit d'un serveur conçu par la communauté pour le traitement par lots de données. Je ne l'ai pas examiné moi-même, donc je ne peux rien garantir. Cela dit, aucune garantie n'est fournie pour ClickHouse non plus. C'est également open source, mais d'un autre côté, vous avez peut-être pris l'habitude d'un certain standard de qualité que nous nous efforçons de respecter. Quant à cette fonctionnalité – je ne sais pas, allez sur GitHub, consultez le code. Peut-être ont-ils écrit quelque chose de correct.
* à partir de 2020, il convient également d'inclure à l'examen .
Méthode 6. Une autre méthode consiste à utiliser des tables Buffer. Les avantages de cette méthode sont qu'il est très facile de commencer à l'utiliser. Vous créez une table Buffer et vous y insérez vos données.
L'inconvénient est que le problème n'est pas complètement résolu. Si, lors de l'insertion avec MergeTree, vous devez grouper les données par un seul lot par seconde, lors de l'insertion dans une table Buffer, vous devez grouper au moins jusqu'à quelques milliers par seconde. Si cela dépasse 10 000 par seconde, cela ne fonctionnera toujours pas correctement. En insérant par lots, vous pourriez constater que cela atteint des centaines de milliers de lignes par seconde. Et cela même avec des données relativement lourdes.
Et aussi, les tables Buffer n'ont pas de journal. Et si quelque chose ne va pas avec votre serveur, les données seront perdues.
Et en bonus, récemment, nous avons ajouté la possibilité de récupérer des données de Kafka dans ClickHouse. Il existe un moteur de table – Kafka. Vous n'avez qu'à le créer. Et vous pouvez y attacher des vues matérialisées. Dans ce cas, il extraira automatiquement les données de Kafka et les insérera dans les tables dont vous avez besoin.
Ce qui est particulièrement réjouissant dans cette fonctionnalité, c'est qu'elle n'a pas été développée par nous. C'est une fonctionnalité de la communauté. Et quand je dis « fonctionnalité de la communauté », je le dis sans aucun mépris. Nous avons consulté le code, fait des revues, cela devrait fonctionner normalement.
* à partir de 2020, un support similaire a été ajouté pour .
Qu'est-ce qui peut encore être inconfortable ou inattendu lors de l'insertion de données ? Si vous effectuez une requête insert values et que dans values vous écrivez des expressions calculées. Par exemple, now() – c'est aussi une expression calculée. Et dans ce cas, ClickHouse doit exécuter l'interpréteur de ces expressions pour chaque ligne, ce qui va considérablement dégrader les performances. Il vaut mieux éviter cela.
* Le problème est maintenant entièrement résolu, il n'y a plus de régression de performance lors de l'utilisation d'expressions dans VALUES.
Un autre exemple où des problèmes peuvent survenir est lorsque vous avez des données d'un seul lot qui concernent de nombreuses partitions. Par défaut, ClickHouse partitionne par mois. Et si vous insérez un lot d'un million de lignes contenant des données sur plusieurs années, vous aurez plusieurs dizaines de partitions. Cela équivaut à avoir des lots de tailles considérablement réduites, car à l'intérieur, ils sont d'abord divisés par partitions.
* Récemment, ClickHouse a ajouté en mode expérimental le support d'un format compact pour les morceaux et les morceaux en mémoire avec un journal de pré-écriture, ce qui résout presque complètement le problème.
Passons maintenant au deuxième type de problème – le typage des données.
Le typage des données peut être strict ou basé sur des chaînes. Le typage basé sur des chaînes signifie que vous avez simplement déclaré que tous vos champs sont de type string. C'est inacceptable. Il ne faut pas faire ça.
Voyons comment faire correctement dans les cas où vous souhaitez dire qu'un champ est une chaîne, et laissez ClickHouse s'en occuper, sans vous inquiéter. Mais il vaut quand même la peine de faire un effort.
Par exemple, nous avons une adresse IP. Dans un cas, nous l'avons enregistrée en tant que chaîne. Par exemple, 192.168.1.1. Dans un autre cas, cela sera un nombre de type UInt32*. 32 bits suffisent pour une adresse IPv4.
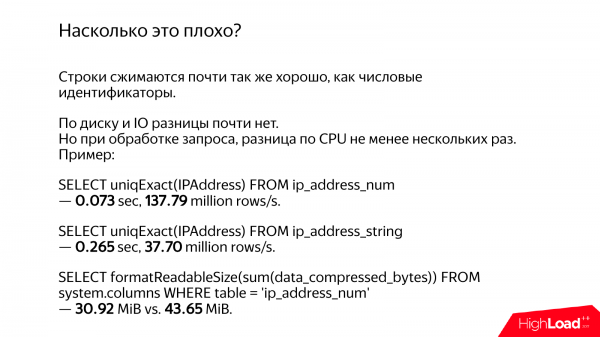
Tout d'abord, étrangement, les données seront compressées de manière à peu près identique. Il y aura des différences, bien sûr, mais elles ne seront pas si importantes. Donc, il n'y a pas de problèmes majeurs concernant l'entrée/sortie disque.
Cependant, il y a une différence significative en termes de temps processeur et de temps d'exécution des requêtes.
Calculons le nombre d'adresses IP uniques si elles sont stockées sous forme de nombres. On obtient 137 millions de lignes par seconde. Si c'est la même chose sous forme de chaînes, alors c'est 37 millions de lignes par seconde. Je ne sais pas pourquoi cette coïncidence s'est produite. J'ai réalisé ces requêtes moi-même. Mais néanmoins, c'est environ 4 fois plus lent.
Et si nous comparons la différence en espace disque, il y a aussi une différence. Et cette différence est d'environ un quart, car il y a suffisamment d'adresses IP uniques. Et s'il y avait des lignes avec un faible nombre de valeurs différentes, elles auraient facilement été compressées par dictionnaire en un volume à peu près identique.
Et il n'y a pas de différence de temps sur la route, peu importe dans quelle mesure cela vous importe. Mais quand je vois une telle différence, cela me rend triste.
Examinons différents cas.
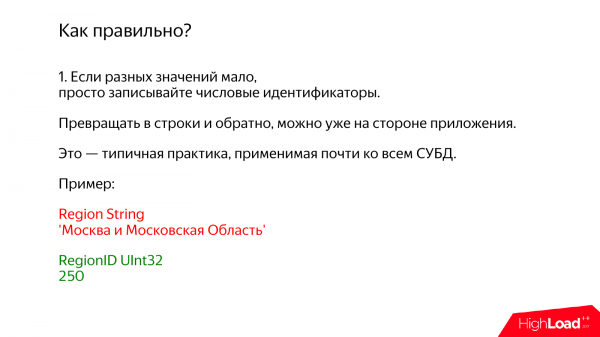
1. Un cas où vous avez peu de valeurs uniques. Dans ce cas, nous utilisons une pratique simple que vous connaissez sûrement et que vous pouvez appliquer à n'importe quel SGBD. Cela a du sens non seulement pour ClickHouse. Vous enregistrez simplement des identifiants numériques dans la base. La conversion en chaînes et vice versa peut être effectuée déjà du côté de votre application.
Par exemple, vous avez une région. Et vous essayez de la sauvegarder sous forme de chaîne. Cela va s'écrire : Moscou et MO. Et quand je vois qu'il est écrit « Moscou », c'est encore rien, mais quand c'est aussi MO, cela devient un peu triste. Combien de bytes cela représente.
Au lieu de cela, nous enregistrons simplement le nombre Ulnt32 et 250. Nous avons 250 dans Yandex, et chez vous, cela peut être différent. Au cas où je préciserais que ClickHouse dispose d'une fonctionnalité intégrée pour travailler avec une base géographique. Vous enregistrez simplement un répertoire des régions, y compris hiérarchique, c'est-à-dire qu'il y aura Moscou, MO et tout ce dont vous avez besoin. Et vous pouvez convertir au niveau de la requête.
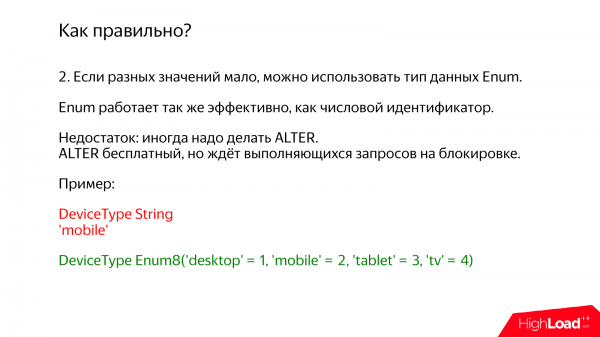
La deuxième option est à peu près la même, mais avec le soutien interne de ClickHouse. C'est le type de données Enum. Vous définissez simplement toutes les valeurs dont vous avez besoin à l'intérieur de l'Enum. Par exemple, le type d'appareil et là, vous écrivez : ordinateur de bureau, mobile, tablette, télévision. Au total, 4 variantes.
L'inconvénient est qu'il faut parfois faire un alter. Vous avez ajouté seulement une variante. Nous effectuons un alter table. En réalité, l'alter table dans ClickHouse est gratuit. Surtout pour Enum, car les données sur disque ne changent pas. Néanmoins, l'alter bloque la table et doit attendre que toutes les sélections soient exécutées. Ce n'est qu'après que l'alter sera exécuté, c'est-à-dire qu'il y a tout de même certains inconvénients.
* Dans les versions récentes de ClickHouse, l'ALTER est complètement non-bloquant.
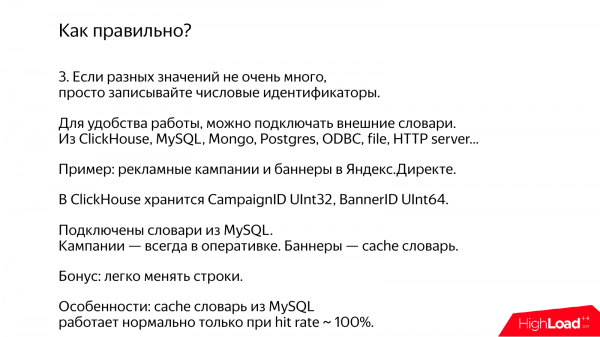
Une autre option assez unique pour ClickHouse est la connexion de dictionnaires externes. Vous pouvez écrire des nombres dans ClickHouse, tandis que vos dictionnaires peuvent être maintenus dans n'importe quel système qui vous convient. Par exemple, vous pouvez utiliser : MySQL, Mongo, Postgres. Vous pouvez même créer votre propre microservice qui fournira ces données via http. Et au niveau de ClickHouse, vous écrivez une fonction qui convertira ces données des nombres en chaînes.
C'est une méthode spécialisée mais très efficace pour effectuer un join avec une table externe. Il y a deux options. Dans une option, ces données seront complètement mises en cache, totalement présentes en mémoire et mises à jour à certaines intervalles. Dans l'autre option, si ces données ne tiennent pas en mémoire, il est possible de les mettre en cache partiellement.
Voici un exemple. Il y a Yandex.Direct. Et là, il y a des campagnes publicitaires et des bannières. Il y a probablement environ dix millions de campagnes publicitaires. Et elles peuvent tenir en mémoire. Mais il y a des milliards de bannières, elles ne peuvent pas tenir. Nous utilisons donc un dictionnaire cachable de MySQL.
Le seul problème est que le dictionnaire cachable fonctionnera correctement si le taux de réussite est proche de 100 %. S'il est plus faible, lors du traitement des requêtes pour chaque lot de données, il faudra réellement récupérer les clés manquantes et aller récupérer les données dans MySQL. En ce qui concerne ClickHouse, je peux garantir qu'il ne ralentit pas, mais pour d'autres systèmes, je ne me prononcerai pas.
Et en bonus, les dictionnaires sont un moyen très simple de mettre à jour les données dans ClickHouse rétroactivement. C'est-à-dire que si vous aviez un rapport sur des campagnes publicitaires, et que l'utilisateur change simplement de campagne publicitaire, alors toutes ces anciennes données, dans tous les rapports, seront également modifiées. Si vous écrivez directement dans la table, il sera impossible de les mettre à jour.
Une autre méthode, lorsque vous ne savez pas d'où obtenir les identifiants pour vos lignes, est de simplement les hacher. Et la méthode la plus simple consiste à utiliser un hachage 64 bits.
Le seul problème est que si le hachage est de 64 bits, alors les collisions seront presque inévitables. Parce que si vous avez un milliard de lignes, la probabilité devient significative.
Il ne serait pas très sage de hacher ainsi les noms des campagnes publicitaires. Si les campagnes publicitaires de différentes entreprises se mélangent, cela deviendra incompréhensible.
Il existe un truc simple. Bien sûr, ce n’est pas très adapté pour des données critiques, mais si ce n'est pas très sérieux, il suffit d'ajouter l'identifiant du client à la clé du dictionnaire. Ainsi, vous aurez des collisions, mais uniquement dans le cadre d'un seul client. Cette méthode est utilisée pour la carte des liens dans Yandex.Metrica. Nous avons des URLs, nous stockons des hachages. Nous savons qu'il y a, bien sûr, des collisions. Mais quand la page est affichée, la probabilité qu'un utilisateur ait des URLs qui se chevauchent sur une même page et que cela soit remarqué peut être négligée.
En bonus, pour de nombreuses opérations, des hachages suffisent et il n'est pas nécessaire de stocker les chaînes elles-mêmes.
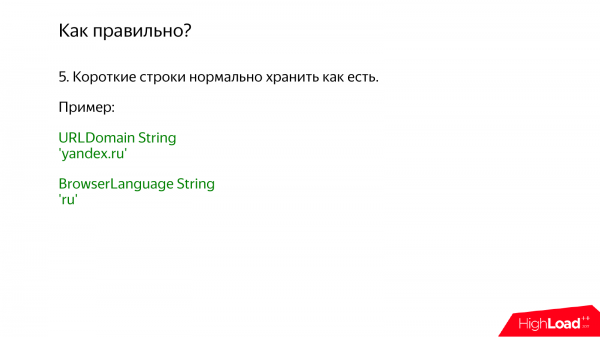
Un autre exemple, si les chaînes sont courtes, par exemple, les domaines de sites. Elles peuvent être stockées telles quelles. Ou, par exemple, la langue du navigateur ru – 2 octets. Bien sûr, je suis un peu désolé pour les octets, mais ne vous inquiétez pas, 2 octets ne sont pas un problème. S'il vous plaît, stockez-les telles quelles, ne vous cassez pas la tête.
Un autre cas, c'est quand il y a beaucoup de chaînes et qu'elles contiennent beaucoup d'éléments uniques, avec un nombre potentiellement illimité. Un exemple typique – les phrases de recherche ou les URLs. Les phrases de recherche, notamment à cause des fautes de frappe. Voyons combien de phrases de recherche uniques il y a par jour. Cela représente presque la moitié de tous les événements. Dans ce cas, vous pourriez penser qu'il faut normaliser les données, calculer des identifiants et les stocker dans une table séparée. Mais ce n'est pas nécessaire. Il suffit de conserver ces chaînes telles quelles.
Mieux vaut ne rien inventer, car si vous stockez séparément, vous devrez faire un join. Et ce join – dans le meilleur des cas – nécessitera un accès aléatoire à la mémoire, si cela y tient encore. Si cela ne tient pas, cela posera effectivement des problèmes.
Et si les données sont stockées in place, elles seront simplement lues dans le bon ordre depuis le système de fichiers et tout ira bien.
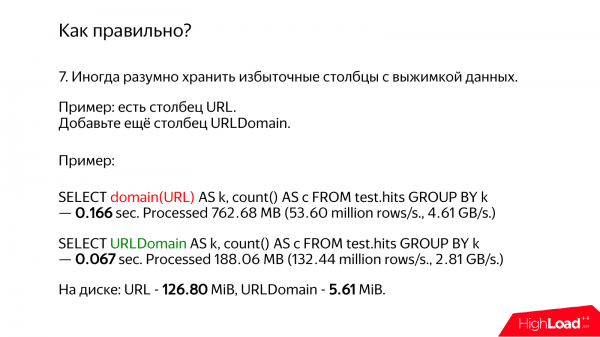
Si vous avez des URLs ou une autre chaîne complexe et longue, il peut être utile de penser à calculer une sorte de résumé à l'avance et à le stocker dans une colonne séparée.
Pour les URLs, par exemple, il est possible de stocker le domaine séparément. Et si vous avez vraiment besoin du domaine, utilisez simplement cette colonne, tandis que les URLs resteront alors où elles sont, et vous n'aurez même pas à y toucher.
Comparons la différence. ClickHouse dispose d'une fonction spécialisée qui calcule le domaine. Elle est très rapide, nous l'avons optimisée. Et, pour être honnête, elle ne respecte même pas la RFC, mais elle calcule néanmoins tout ce dont nous avons besoin.
Dans un cas, nous allons simplement extraire les URL et calculer le domaine. Cela prend 166 millisecondes. Si nous prenons un domaine déjà prêt, cela ne prend que 67 millisecondes, soit presque trois fois plus vite. Et ce n'est pas parce que nous avons besoin de faire des calculs, mais parce que nous lisons moins de données.
Étonnamment, pour une requête plus lente, nous obtenons un plus grand débit en gigaoctets par seconde. Parce qu'elle lit plus de gigaoctets. Ce sont des données totalement inutiles. La requête fonctionne plus rapidement, mais prend plus de temps à s'exécuter.
Si nous regardons la taille des données sur le disque, l'URL fait 126 mégaoctets, tandis que le domaine ne fait que 5 mégaoctets. Cela représente 25 fois moins. Pourtant, la requête s'exécute seulement 4 fois plus vite. Mais c'est parce que les données sont chaudes. Si elles étaient froides, cela aurait probablement été 25 fois plus rapide en raison des entrées-sorties disque.
D'ailleurs, si nous évaluons à quel point le domaine est plus petit que l'URL, nous nous retrouvons avec environ 4 fois moins. Pourtant, sur le disque, les données occupent 25 fois moins. Pourquoi ? À cause de la compression. Tant l'URL que le domaine sont compressés. Mais souvent, l'URL contient beaucoup de déchets.
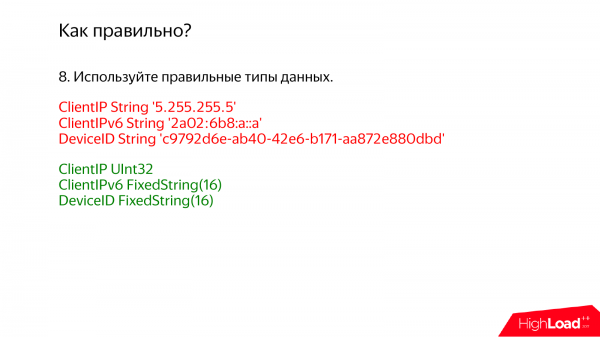
Bien sûr, il est essentiel d'utiliser les bons types de données, spécifiquement conçus pour les valeurs nécessaires ou les types appropriés. Si vous utilisez IPv4, stockez en UInt32*. Si c'est IPv6, utilisez FixedString(16), car une adresse IPv6 fait 128 bits, donc stockez directement au format binaire.
Que faire si vous avez parfois des adresses IPv4 et parfois des IPv6 ? Oui, vous pouvez stocker les deux. Une colonne pour IPv4, une autre pour IPv6. Il existe également une option pour afficher IPv4 sous IPv6. Cela fonctionnera aussi, mais si vous avez souvent besoin d'une adresse IPv4 spécifique dans vos requêtes, il serait préférable de la mettre dans une colonne séparée.
* Maintenant, ClickHouse dispose de types de données distincts pour IPv4 et IPv6, qui stockent les données aussi efficacement que les nombres, tout en les présentant de manière aussi pratique que des chaînes.
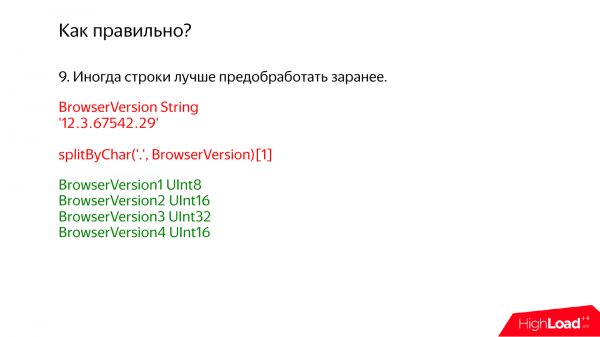
Il est également important de noter qu'il vaut mieux prétraiter les données à l'avance. Par exemple, vous recevez des journaux bruts. Peut-être qu'il n'est pas sage de les envoyer directement dans ClickHouse, même s'il est très tentant de ne rien faire et de laisser tout fonctionner. Mais il vaut mieux effectuer les calculs possibles.
Par exemple, la version du navigateur. Dans un département voisin, que je préfère ne pas pointer du doigt, la version du navigateur est conservée de cette manière, c'est-à-dire comme une chaîne : 12.3. Ensuite, pour faire un rapport, ils prennent cette chaîne, la divisent en tableau, puis prennent le premier élément du tableau. Évidemment, tout ralentit. J'ai demandé pourquoi ils faisaient cela. Ils m'ont répondu qu'ils n'aimaient pas l'optimisation prématurée. Personnellement, je n'aime pas la pessimisation prématurée.
Dans ce cas, il serait donc plus judicieux de diviser en 4 colonnes. N'ayez pas peur, car c'est ClickHouse. ClickHouse est une base de données orientée colonne. Plus vous avez de petites colonnes soignées, mieux c'est. Si vous avez 5 BrowserVersion, faites 5 colonnes. C'est normal.
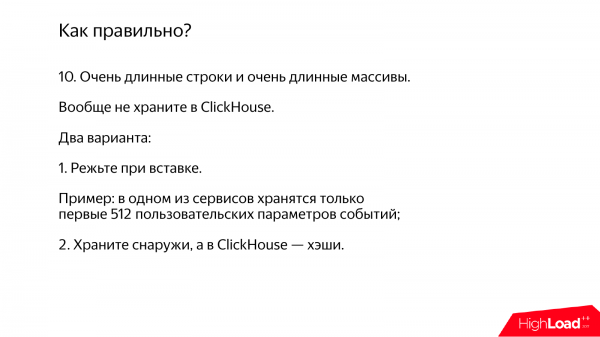
Voyons maintenant que faire si vous avez beaucoup de chaînes très longues, des tableaux très longs. Ils n'ont pas besoin d'être stockés dans ClickHouse du tout. À la place, vous pouvez enregistrer uniquement un identifiant dans ClickHouse. Et stockez ces longues chaînes dans un autre système.
Par exemple, dans l'un de nos services d'analytique, nous avons certains paramètres d'événements. Et si de nombreux paramètres arrivent pour les événements, nous nous contentons de sauvegarder les premiers 512. Parce que 512, ça ne fait pas de mal.
Et si vous ne savez pas quel type de données utiliser, vous pouvez également enregistrer les données dans ClickHouse, mais dans une table temporaire de type Log, spécialement conçue pour les données temporaires. Ensuite, vous pouvez analyser la distribution des valeurs que vous avez là, et identifier les types appropriés.
* Actuellement, ClickHouse a un type de données qui permet de stocker efficacement les chaînes avec moins de coûts en ressources.
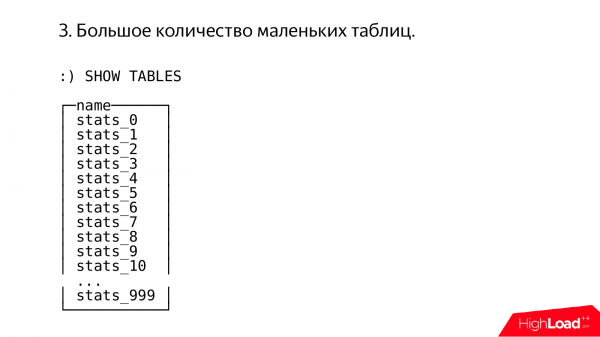
Examinons maintenant un autre cas intéressant. Parfois, les choses semblent fonctionner de manière étrange pour certaines personnes. Je me connecte et je vois cela. Et je suppose immédiatement que cela a été fait par un administrateur très expérimenté, intelligent, ayant une grande expérience dans la configuration de MySQL version 3.23.
Ici, nous voyons mille tables, chacune contenant un reste de la division de quelque chose d'incompréhensible par mille.
En principe, je respecte l'expérience des autres et je comprends également quelles souffrances cette expérience peut engendrer.
Les raisons sont plus ou moins claires. Ce sont de vieux stéréotypes qui ont pu se former lors de l'utilisation d'autres systèmes. Par exemple, dans les tables MyISAM, il n'y a pas de clé primaire clusterisée. Et cette façon de diviser les données peut être une tentative désespérée d'obtenir la même fonctionnalité.
Une autre raison est que toutes les opérations de type alter sur de grandes tables sont difficiles à réaliser. Tout sera bloqué. Bien que dans les versions modernes de MySQL, ce problème ne soit plus si sérieux.
Ou, par exemple, le micro-sharding, mais j'en parlerai un peu plus tard.
Dans ClickHouse, cela n'est pas nécessaire, car premièrement, la clé primaire est clusterisée et les données sont ordonnées selon cette clé primaire.
Et parfois, on me demande : « Comment la performance des requêtes par plage dans ClickHouse varie-t-elle selon la taille de la table ? ». Je réponds qu'elle ne varie pas. Par exemple, si vous avez une table d'un milliard de lignes et que vous lisez une plage d'un million de lignes, tout fonctionne bien. Si la table contient un trillion de lignes et que vous lisez un million de lignes, ce sera presque la même chose.
Deuxièmement, il n'est pas nécessaire d'avoir des trucs comme des partitions manuelles. Si vous allez voir ce qu'il y a sur le système de fichiers, vous verrez que la table est un élément assez sérieux. Et il y a quelque chose comme des partitions à l'intérieur. C'est-à-dire que ClickHouse fait tout pour vous et vous n'avez pas à souffrir.
La commande alter dans ClickHouse est gratuite si vous effectuez un alter add/drop column.
Et il n'est pas judicieux de créer de petites tables, car si votre table contient 10 lignes ou 10 000 lignes, cela n'a absolument aucun intérêt. ClickHouse est un système qui optimise le throughput, pas la latence, donc traiter 10 lignes n'a pas de sens.
Il est préférable d'utiliser une grande table. Éliminez les vieux stéréotypes, tout ira bien.
En bonus, notre dernière version a introduit la possibilité de créer une clé de partitionnement arbitrée pour effectuer diverses opérations de maintenance sur des partitions spécifiques.
Par exemple, vous avez besoin de beaucoup de petites tables, par exemple lorsque vous devez traiter certaines données intermédiaires, vous recevez des chunks et devez effectuer des transformations sur celles-ci avant de les enregistrer dans la table finale. Pour ce cas, il existe un moteur de table remarquable – StripeLog. C'est un peu comme TinyLog, mais en mieux.
* ClickHouse dispose également maintenant de .
Un autre anti-pattern est le micro-sharding. Par exemple, vous devez shard les données et vous avez 5 serveurs, mais demain il y en aura 6. Et vous réfléchissez à la manière de rééquilibrer ces données. Au lieu de cela, vous divisez non pas en 5 shards, mais en 1 000 shards. Ensuite, vous assignez chacun de ces micro-shards à un serveur distinct. Ainsi, vous pouvez vous retrouver avec par exemple 200 ClickHouse sur un seul serveur. Des instances séparées sur des ports distincts ou des bases de données distinctes.
Mais dans ClickHouse, c'est pas très bien. Parce qu'une seule instance de ClickHouse essaie d'utiliser toutes les ressources disponibles du serveur pour traiter une seule requête. C'est-à-dire que si vous avez un serveur avec par exemple 56 cœurs de processeur. Vous effectuez une requête qui dure une seconde, et elle utilisera 56 cœurs. Si vous avez placé 200 ClickHouse sur un serveur, cela signifie qu'il y aura 10 000 threads qui démarre. En gros, tout ira très mal.
Une autre raison est que la répartition du travail entre ces instances sera inégale. Certaines termineront plus tôt, d'autres plus tard. Si tout cela se déroulait dans une seule instance, ClickHouse saurait lui-même répartir correctement les données entre les threads.
Et une autre raison est que vous aurez une interaction interprocessus via TCP. Les données devront être sérialisées, désérialisées et cela implique un nombre énorme de micro-shards. Ce sera tout simplement inefficace.
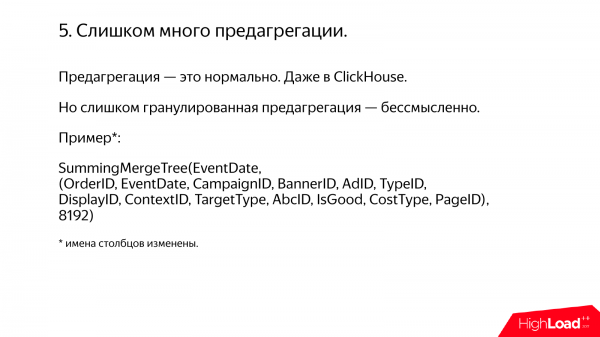
Un autre anti-pattern, bien qu'il soit difficile de le qualifier d’anti-pattern. C'est une grande quantité de pré-agrégation.
En général, la pré-agrégation, c'est bien. Vous aviez un milliard de lignes, vous l'avez agrégé et cela a donné 1 000 lignes, ce qui fait que la requête s'exécute instantanément. Tout est merveilleux. C'est possible. Et pour cela, ClickHouse dispose même d'un type de table spécial, AggregatingMergeTree, qui effectue une agrégation incrémentale lors de l'insertion des données.
Mais il arrive que vous pensiez que nous allons agréger les données de cette manière et encore de cette manière. Et dans un département voisin, sans vouloir dire lequel, ils utilisent des tables SummingMergeTree pour faire des sommes par clé primaire, et comme clé primaire, ils utilisent une vingtaine de colonnes. J'ai changé par précaution les noms de certaines colonnes pour des raisons de confidentialité, mais c'est à peu près ça.
Et cela pose certains problèmes. Tout d'abord, le volume de données ne diminue pas beaucoup. Par exemple, il est réduit par trois. Trois fois — ce serait un bon rapport pour permettre des possibilités d'analyse illimitées qui émergent si vos données ne sont pas agrégées. Si les données sont agrégées, vous recevez au lieu de l'analyse, une simple statistique misérable.
Et ce qui est particulièrement agaçant ? C'est que ces personnes du département voisin viennent parfois et demandent d'ajouter encore une colonne à la clé primaire. C'est-à-dire que nous avions agrégué les données de cette manière, et maintenant nous en voulons un peu plus. Mais dans ClickHouse, il n'y a pas de commande pour modifier la clé primaire. Donc, il faut écrire des scripts en C++. Et je n'aime pas les scripts, même s'ils sont en C++.
Et si l'on regarde à quoi ClickHouse a été conçu, les données non agrégées sont exactement le scénario pour lequel il a été créé. Si vous utilisez ClickHouse pour des données non agrégées, vous faites tout correctement. Si vous agglomérez, c'est parfois pardonnable.
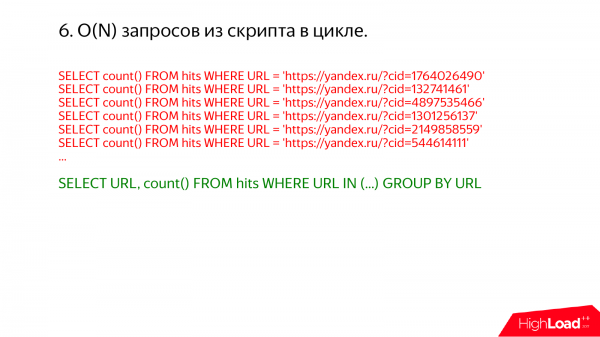
Un autre cas intéressant concerne les requêtes en boucle infinie. Il m'arrive parfois de me connecter à un serveur de production et de vérifier la liste des processus. Et à chaque fois, je découvre que quelque chose d'horrible se produit.
Par exemple, cela. Ici, il est évident que tout aurait pu être exécuté dans une seule requête. Il suffit d'écrire là-dedans url in et la liste.
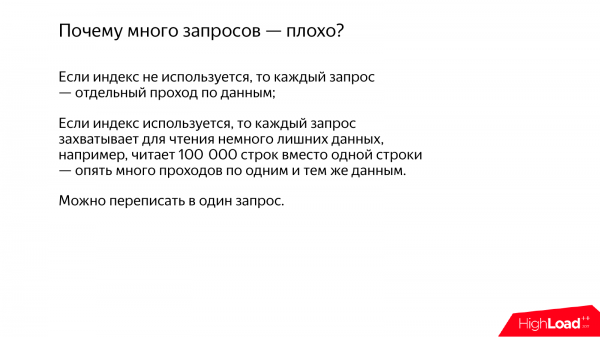
Pourquoi avoir beaucoup de telles requêtes en boucle infinie est-il mauvais ? Si l'index n'est pas utilisé, vous aurez de nombreux passages sur les mêmes données. Mais si l'index est utilisé, par exemple, vous avez une clé primaire sur ru et vous écrivez url = quelque chose. Et vous pensez qu'il sera lu précisément un url de la table, cela ira. Mais en réalité, non. Parce que ClickHouse fait tout par lots.
Lorsqu'il doit lire une certaine plage de données, il en lit un peu plus, car l'index dans ClickHouse est sparse. Cet index ne permet pas de trouver une seule ligne individuelle dans la table, seulement une certaine plage. De plus, les données sont compressées par blocs. Pour lire une ligne, il faut prendre un bloc entier et le décompresser. Et si vous exécutez beaucoup de requêtes, il y aura de nombreux chevauchements et une grande quantité de travail sera effectuée encore et encore.
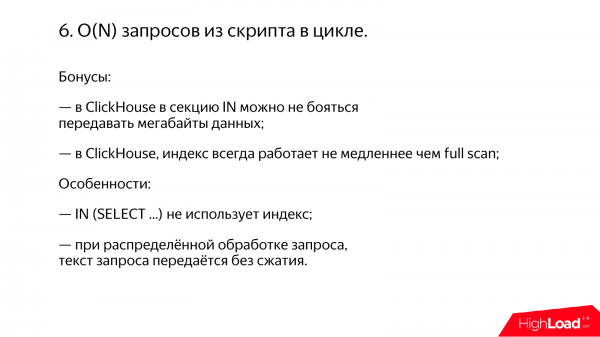
Et en bonus, on peut noter qu'il n'est pas nécessaire d'avoir peur de transmettre même des mégaoctets, voire des centaines de mégaoctets dans la section IN dans ClickHouse. Je me souviens de notre expérience, que si dans MySQL on transmet une multitude de valeurs dans la section IN, par exemple, si l'on y met 100 mégaoctets de chiffres, MySQL consume 10 gigaoctets de mémoire et ensuite rien ne se passe, tout fonctionne mal.
Et la deuxième chose est que dans ClickHouse, si vos requêtes utilisent un index, cela n'est jamais plus lent qu'un scan complet, c'est-à-dire que si presque toute la table doit être lue, il va le faire de manière séquentielle et lire toute la table. En général, il comprend tout lui-même.
Cependant, il y a certaines difficultés. Par exemple, le fait que IN avec une sous-requête n'utilise pas l'index. Mais c'est notre problème et nous devons le corriger. Il n'y a rien de fondamental ici. Nous allons le réparer.
Et une autre chose intéressante est que si vous avez une très longue requête et que le traitement des requêtes est distribué, alors cette très longue requête sera envoyée à chaque serveur sans compression. Par exemple, 100 mégaoctets et 500 serveurs. Et, par conséquent, vous aurez 50 gigaoctets transmis sur le réseau. Ils seront transmis et ensuite tout s'exécutera avec succès.
* utilise déjà ; tout est réparé, comme promis.
Et c'est assez fréquent que les requêtes viennent de l'API. Par exemple, vous avez créé votre propre service. Et si votre service est nécessaire à quelqu'un, vous avez ouvert une API et littéralement deux jours plus tard, vous voyez que quelque chose d'incompréhensible se produit. Tout est surchargé et des requêtes horribles arrivent, qui n'auraient jamais dû exister.
Et la solution ici est simple. Si vous avez ouvert l'API, vous devrez la limiter. Par exemple, introduire des quotas. Il n'y a pas d'autres options normales. Sinon, quelqu'un écrira immédiatement un script et il y aura des problèmes.
ClickHouse dispose d'une fonctionnalité spéciale : le comptage des quotas. Vous pouvez également transmettre votre clé de quota, par exemple, un identifiant interne d'utilisateur. Les quotas seront comptés indépendamment pour chacun d'eux.
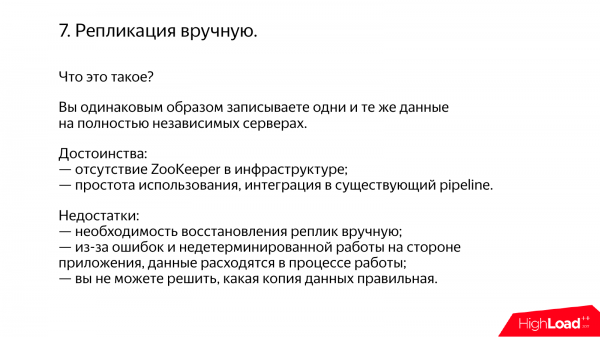
Maintenant, une autre chose intéressante. C'est la réplication manuelle.
Je connais de nombreux cas où, même si ClickHouse prend en charge la réplication intégrée, les gens répliquent ClickHouse manuellement.
Quel est le principe ? Vous avez un pipeline de traitement des données qui fonctionne indépendamment, par exemple, dans différents centres de données. Vous enregistrez les mêmes données de la même manière dans ClickHouse. Cependant, en pratique, il s'avère que les données vont quand même diverger en raison de certaines particularités de votre code. J'espère que cela ne sera pas le cas dans le vôtre.
Et périodiquement, vous devrez quand même synchroniser manuellement. Par exemple, une fois par mois, les administrateurs effectuent un rsync.
En réalité, il est beaucoup plus simple d'utiliser la réplication intégrée à ClickHouse. Mais cela peut avoir certaines contre-indications, car cela nécessite d'utiliser ZooKeeper. Je ne dirai rien de mal sur ZooKeeper, en principe, c'est un système fonctionnel, mais il arrive que les gens ne l'utilisent pas en raison d'une phobie de Java, car ClickHouse est un bon système écrit en C++, qui fonctionne très bien. Et ZooKeeper est en Java. Il est donc parfois difficile de regarder cela, mais dans ce cas, vous pouvez utiliser la réplication manuelle.
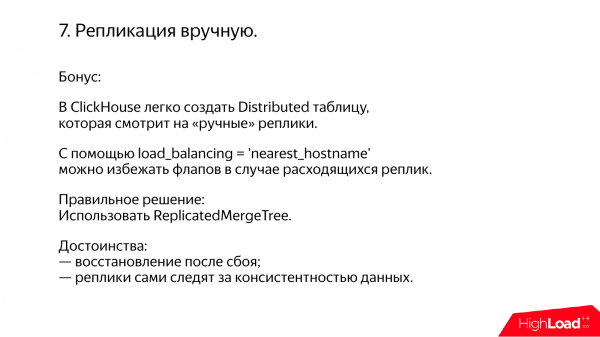
ClickHouse est un système pragmatique. Il prend en compte vos besoins. Si vous avez une réplication manuelle, vous pouvez créer une table Distributed qui regarde vos répliques manuelles et effectue elle-même un failover entre elles. Il existe même une option spéciale qui permet d'éviter les flaps, même si vos répliques divergent systématiquement.
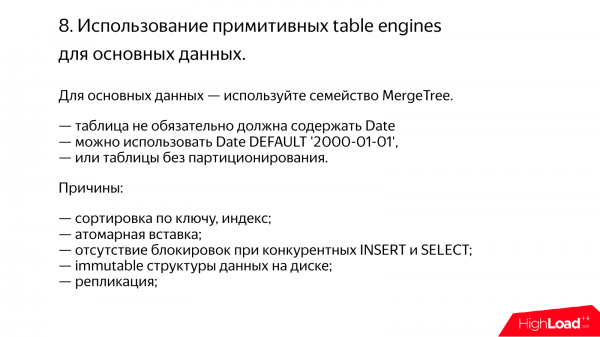
Par la suite, des problèmes peuvent survenir si vous utilisez des moteurs de table primitifs. ClickHouse est un constructeur qui dispose d'une multitude de différents moteurs de table. Pour tous les cas sérieux, comme indiqué dans la documentation, utilisez des tables de la famille MergeTree. Les autres options sont juste pour des cas spécifiques ou pour des tests.
Dans une table MergeTree, il n'est pas nécessaire d'avoir une date et une heure. Vous pouvez utiliser cette option. Si vous n'avez pas de date et d'heure, indiquez que la valeur par défaut est l'année 2000. Cela fonctionnera et ne nécessitera pas beaucoup de ressources.
Dans la nouvelle version du serveur, vous pouvez même spécifier que vous souhaitez un partitionnement personnalisé sans clé de partition. Ce sera la même chose.
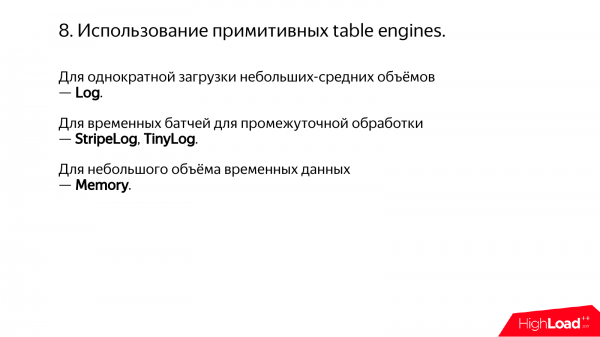
D'un autre côté, vous pouvez utiliser des moteurs de table primitifs. Par exemple, chargez les données une fois et regardez, manipulez et supprimez. Vous pouvez utiliser Log.
Ou stocker de petits volumes pour un traitement intermédiaire – c'est StripeLog ou TinyLog.
Memory peut être utilisé si le volume de données est petit et que vous devez simplement manipuler quelque chose en mémoire.
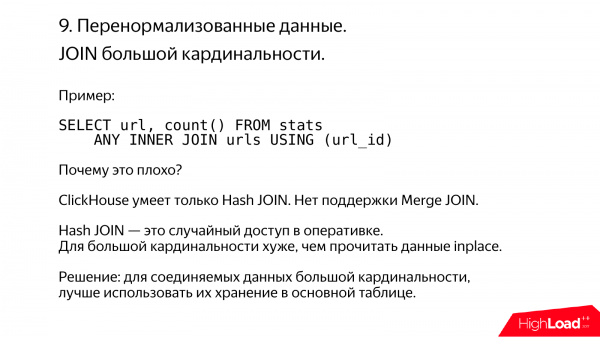
ClickHouse n'aime pas vraiment les données sur-normalisées.
Voici un exemple typique. Il s'agit d'un énorme nombre d'URLs. Vous les avez mises dans une table adjacente. Ensuite, vous avez décidé de faire un JOIN avec elles, mais cela ne fonctionnera généralement pas, car ClickHouse ne prend en charge que les Hash JOIN. Si vous manquez de mémoire pour un grand volume de données à relier, le JOIN ne pourra pas être effectué*.
Si les données ont une grande cardinalité, ne vous inquiétez pas, conservez-les sous une forme dénormalisée, les URLs directement inplace dans la table principale.
* En fait, ClickHouse dispose maintenant également d'un merge join, et il fonctionne lorsque les données intermédiaires ne tiennent pas en mémoire. Mais ce n'est pas efficace, et la recommandation reste valable.
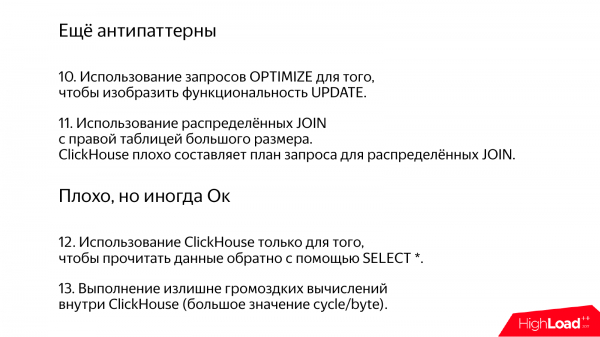
Encore quelques exemples, mais je commence à douter s'ils sont antipattern ou non.
ClickHouse a un inconvénient bien connu. Il ne prend pas en charge les mises à jour*. D'une certaine manière, c'est même une bonne chose. Si vous avez des données importantes, par exemple la comptabilité, personne ne pourra les modifier, car il n'y a pas de mises à jour.
* Le support des mises à jour et des suppressions en mode batch a été ajouté depuis longtemps.
Mais il existe quelques méthodes spéciales qui permettent de faire des mises à jour en quelque sorte en arrière-plan. Par exemple, les tables de type ReplaceMergeTree. Elles effectuent des mises à jour lors des fusions en arrière-plan. Vous pouvez forcer cela en utilisant optimize table. Mais ne le faites pas trop souvent, car cela entraînera une réécriture complète de la partition.
Les JOIN distribués dans ClickHouse sont également mal gérés par le planificateur de requêtes.
C'est mauvais, mais parfois ça va.
Utiliser ClickHouse uniquement pour lire les données avec un select*.
Je ne recommanderais pas d'utiliser ClickHouse pour des calculs intensifs. Cependant, cela ne reflète pas tout à fait la réalité, car nous nous éloignons déjà de cette recommandation. Nous avons récemment ajouté la possibilité d'appliquer des modèles d'apprentissage automatique dans ClickHouse – Catboost. Cela m'inquiète, car je me dis : « Quel désastre. Combien de cycles par octet cela représente-t-il ! ». Je déteste voir des cycles utilisés pour des octets.
Mais ne vous inquiétez pas, installez ClickHouse, tout ira bien. En cas de problème, nous avons une communauté. N'oubliez pas, cette communauté, c'est vous. Et si vous rencontrez des difficultés, vous pouvez au moins rejoindre notre chat, et j'espère que vous recevrez de l'aide.
Questions
Merci pour la présentation ! Où puis-je signaler une chute de ClickHouse ?
Vous pouvez me signaler personnellement dès maintenant.
J'ai récemment commencé à utiliser ClickHouse. J'ai immédiatement planté l'interface CLI.
Vous avez de la chance.
Un peu plus tard, j'ai fait planter le serveur avec une simple requête SELECT.
Vous avez un talent.
J'ai ouvert un bug sur GitHub, mais il a été ignoré.
Nous verrons.
Alexey m'a trompé pour me convaincre d'assister à la présentation en promettant de montrer comment vous compressez les données.
C'est très simple.
Je l'ai compris hier. Plus de précision.
Il n'y a pas de trucs horribles. C'est simplement une compression par blocs. Par défaut, LZ4 est utilisé, ZSTD peut être activé. Les blocs vont de 64 Ko à 1 Mo.
* il existe également un soutien pour des codecs de compression spécialisés qui peuvent être utilisés en chaîne avec d'autres algorithmes.
Les blocs contiennent simplement des données brutes ?
Pas tout à fait brutes. Cela contient des tableaux. Si vous avez une colonne numérique, les nombres seront organisés dans un tableau.
Compris.
Alexey, l'exemple avec uniqExact sur les adresses IP, c'est-à-dire le fait que uniqExact prend plus de temps à calculer sur des chaînes que sur des nombres, etc. Et si nous utilisons un stratagème et castons au moment de la lecture ? C'est-à-dire, vous avez dit que sur le disque, cela ne diffère pas beaucoup. Si nous lisons des chaînes sur le disque et castons, alors nos agrégats seront-ils plus rapides ou non ? Ou allons-nous tout de même gagner ici de manière négligeable ? J'ai l'impression que vous avez testé cela, mais vous ne l'avez pas mentionné dans le benchmark.
Je pense que cela sera plus lent qu'en dehors du cast. Dans ce cas, l'adresse IP doit être analysée à partir de la chaîne. Bien sûr, dans ClickHouse, l'analyse des adresses IP est également optimisée. Nous avons vraiment fait des efforts, mais vous avez des nombres écrits en forme de dizaines de milliers. C'est très peu pratique. D'un autre côté, la fonction uniqExact va fonctionner plus lentement sur des chaînes, non seulement parce que ce sont des chaînes, mais aussi parce qu'une autre spécialisation de l'algorithme est choisie. Les chaînes sont simplement traitées différemment.
Et si on prenait un type de données plus primitif ? Par exemple, on a écrit l'user id, qui est dans notre cas, on l'a écrit sous forme de chaîne, et puis on a fait un cast, ce sera plus amusant ou pas ?
J'en doute. Je pense que ce sera même plus triste, car analyser des nombres est un véritable problème. Il me semble que l'un de mes collègues avait même fait une présentation sur la difficulté d'analyser des nombres sous la forme de dizaines de milliers, ou peut-être pas.
Alexey, merci beaucoup pour ta présentation ! Et encore merci pour ClickHouse ! J'ai une question concernant les fonctionnalités. Y a-t-il des projets pour une mise à jour partielle des dictionnaires ?
C'est-à-dire un rechargement partiel ?
Oui, oui. Une sorte de possibilité de définir un champ MySQL, c'est-à-dire de mettre à jour après, pour que seules ces données soient chargées, si le dictionnaire est très volumineux.
C'est une fonction très intéressante. Et, il me semble qu'une personne l'a proposée dans notre chat. C'était peut-être même vous.
Je ne pense pas.
Super, donc cela fait deux requêtes. Et on peut commencer à le faire tranquillement. Mais je veux vous prévenir tout de suite que cette fonctionnalité est assez simple à mettre en œuvre. C'est-à-dire qu'en théorie, il suffit d'écrire le numéro de version dans la table et ensuite d'écrire : version inférieure à telle version. Et cela signifie que, très probablement, nous proposerons de le faire aux enthousiastes. Êtes-vous un enthousiaste ?
Oui, mais, malheureusement, pas en C++.
Vos collègues savent-ils écrire en C++ ?
Je vais trouver quelqu'un.
Super*.
* la fonctionnalité a été ajoutée deux mois après la présentation – elle a été développée par l'auteur de la question et a été envoyé .
Merci!
Bonjour ! Merci pour la présentation ! Vous avez mentionné que ClickHouse consomme très bien toutes les ressources qui lui sont disponibles. Et le présentateur voisin de Luxoft a parlé de sa solution pour la Poste de Russie. Il a dit qu'ils aimaient beaucoup ClickHouse, mais qu'ils ne l'avaient pas utilisé à la place de leur principal concurrent précisément parce qu'il utilisait tout le processeur. Et ils n'ont pas pu l'intégrer dans leur architecture, dans leur ZooKeeper avec des Docker. Existe-t-il un moyen de limiter ClickHouse afin qu'il ne consomme pas tout ce qui lui est accessible ?
Oui, c'est possible et très facile. Si vous souhaitez qu'il consomme moins de cœurs, il suffit d'écrire set max_threads = 1. Et voilà, il exécutera la requête sur un seul cœur. De plus, vous pouvez indiquer cette configuration différente pour divers utilisateurs. Donc, aucun problème. Et dites à vos collègues de Luxoft qu'il n'est pas bon qu'ils n'aient pas trouvé cette option dans la documentation.
Alexei, bonjour ! J'aimerais poser une question. Je n'entends pas pour la première fois que beaucoup commencent à utiliser ClickHouse comme stockage pour les journaux. Lors de votre présentation, vous avez dit de ne pas faire cela, c'est-à-dire qu'il ne faut pas stocker de longues chaînes. Que pensez-vous de cela ?
Tout d'abord, les journaux ne sont généralement pas de longues chaînes. Il y a bien sûr des exceptions. Par exemple, un service écrit en Java génère une exception qui est enregistrée. Et cela dans une boucle infinie, et l'espace sur le disque dur se termine. La solution est très simple. Si les chaînes sont très longues, coupez-les. Et que signifie longues ? Des dizaines de kilo-octets, c'est mauvais*.
* dans les versions récentes de ClickHouse, "la granularité adaptative de l'index" a été intégrée, ce qui résout en grande partie le problème de stockage des longues chaînes.
Et un kilo-octet, c'est normal ?
C'est normal.
Bonjour ! Merci pour la présentation ! J'ai déjà demandé cela dans le chat, mais je ne me souviens pas si j'ai reçu une réponse. Prévoyez-vous d'élargir la section WITH à la manière des CTE ?
Pas pour l'instant. La section WITH n'est pas très sérieuse chez nous. C'est une petite fonctionnalité.
J'ai compris. Merci !
Merci pour la présentation ! C'était très intéressant ! Une question globale. Prévoyez-vous de faire, peut-être sous forme de quelques placeholders, une modification pour la suppression de données ?
C'est sûr. C'est notre première tâche dans notre file d'attente. Nous avons actuellement réfléchi de manière active à la manière de tout faire correctement. Il est temps de commencer à frapper sur le clavier*.
*Nous avons appuyé sur les touches du clavier et tout est fait.
Cela va-t-il affecter la performance du système ou non ? L'insertion sera-t-elle aussi rapide qu'actuellement ?
Il est possible que les suppressions et les mises à jour soient très lourdes, mais cela n'affectera pas les performances des sélections et des insertions.
Et une petite question. Lors de la présentation, vous avez parlé de la clé primaire. Donc, nous avons un partitionnement qui est par défaut mensuel, n'est-ce pas ? Et quand nous spécifions une plage de dates qui rentre dans le mois, seule cette partition est lue, c'est bien ça ?
Oui.
Une question. Si nous ne pouvons pas выделить de clé primaire, est-il correct de la faire sur le champ « Date » afin de réduire la réorganisation des données en arrière-plan pour qu'elles soient mieux ordonnées ? Si vous n'avez pas de requêtes par plages et que vous ne pouvez pas choisir de clé primaire, vaut-il mieux mettre la date en clé primaire ?
Oui.
Peut-être que cela vaut la peine d'inclure dans la clé primaire un champ qui permettra une meilleure compression des données si elles sont triées par celui-ci. Par exemple, l'identifiant d'un utilisateur. Un utilisateur, par exemple, visite le même site. Dans ce cas, vous mettez l'identifiant de l'utilisateur et le temps. Ainsi, vos données seront mieux compressées. Concernant la date, si vous n'avez vraiment jamais de requêtes par plages de dates, il n'est pas nécessaire d'inclure la date dans la clé primaire.
Bien, merci beaucoup !
Source : habr.com
