

La recherche de dépendances fonctionnelles dans les données est appliquée dans différents domaines de l'analyse des données : gestion de bases de données, nettoyage des données, rétro-ingénierie de bases de données et exploration des données. Nous avons déjà publié sur ces dépendances. Anastasia Birillo et Nikita Bobrov. Cette fois, Anastasia — diplômée du Computer Science Center de cette année — partage le développement de ce travail dans le cadre de son projet de recherche, qu'elle a présenté au centre.
Choix de la tâche
Pendant mes études au centre CS, j'ai commencé à étudier en profondeur les bases de données, plus précisément, la recherche de dépendances fonctionnelles et différentes dépendances. Ce sujet était lié au thème de mon mémoire à l'université, donc pendant que je travaillais sur le mémoire, j'ai commencé à lire des articles sur les différentes dépendances dans les bases de données. J'ai rédigé une revue sur ce domaine — l'une de mes premières. en anglais et je l'ai soumise à la conférence SEIM-2017. J'étais très heureuse d'apprendre qu'elle avait été acceptée, et j'ai décidé d'approfondir le sujet. Le concept lui-même n'est pas nouveau — il a commencé à être appliqué dès les années 90, mais il trouve encore des applications dans de nombreux domaines aujourd'hui.
Au deuxième semestre de mes études au centre, j'ai commencé un projet de recherche sur l'amélioration des algorithmes de recherche de dépendances fonctionnelles. J'ai travaillé dessus avec le doctorant de l'Université d'État de Saint-Pétersbourg, Nikita Bobrov, chez JetBrains Research.
Complexité computationnelle de la recherche de dépendances fonctionnelles
Le principal problème est la complexité computationnelle. Le nombre de dépendances minimales et non triviaux possibles est limité par la valeur  , où
 — le nombre d'attributs dans la table. Le temps d'exécution des algorithmes dépend non seulement du nombre d'attributs, mais aussi du nombre de lignes. Dans les années 90, les algorithmes de recherche de dépendances fonctionnelles sur un PC de bureau normal pouvaient traiter des ensembles de données contenant jusqu'à 20 attributs et des dizaines de milliers de lignes pendant plusieurs heures. Les algorithmes modernes, fonctionnant sur des processeurs multicores, détectent des dépendances pour des ensembles de données composés de centaines d'attributs (jusqu'à 200) et de centaines de milliers de lignes, en un temps similaire. Pourtant, cela reste insuffisant : ce temps est inacceptable pour la plupart des applications réelles. C'est pourquoi nous avons développé des approches pour accélérer les algorithmes existants.
Schémas de mise en cache pour l'intersection des partitions
Dans la première partie de notre travail, nous avons développé des schémas de mise en cache pour une classe d'algorithmes utilisant une méthode d'intersection des partitions. Une partition pour un attribut représente un ensemble de listes, où chaque liste contient les numéros de ligne avec les mêmes valeurs pour cet attribut. Chaque liste est appelée un cluster. De nombreux algorithmes modernes utilisent des partitions pour déterminer si une dépendance est maintenue ou non, en se basant sur le lemme : La dépendance  est maintenue si
 . Ici
 la partition est désignée et on utilise le concept de taille de partition — le nombre de clusters qu'elle contient. Les algorithmes utilisant des partitions, lorsqu'une dépendance est rompue, ajoutent des attributs supplémentaires dans la partie gauche de la dépendance, puis la recalculent en effectuant une opération d'intersection des partitions. Cette opération est appelée spécialisation dans les articles. Cependant, nous avons remarqué que les partitions pour les dépendances qui ne seront maintenues qu'après plusieurs tours de spécialisation peuvent être activement réutilisées, ce qui peut considérablement réduire le temps de fonctionnement des algorithmes, car l'opération d'intersection est coûteuse.
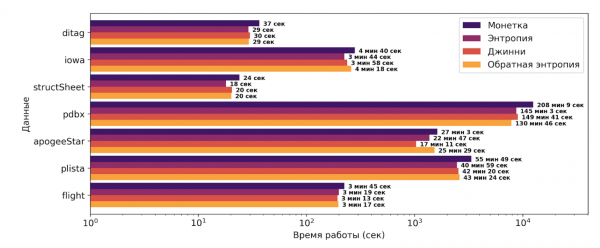
C'est pourquoi nous avons proposé une heuristique basée sur l'Entropie de Shannon et l'incertitude de Gini, ainsi que notre métrique, que nous avons appelée Entropie Inversée. C'est une légère modification de l'Entropie de Shannon et elle augmente à mesure que l'unicité de l'ensemble de données croît. L'heuristique proposée est la suivante :

Ici  — le degré d'unicité de la partition récemment calculée
 , et
 est la médiane des degrés d'unicité pour certains attributs. Pour la métrique d'unicité, toutes les trois métriques décrites ci-dessus ont été testées. On peut également noter que l'heuristique contient deux modificateurs. Le premier indique à quel point la partition actuelle est proche de la clé primaire et permet de mettre en cache dans une plus grande mesure les partitions qui sont éloignées de la clé potentielle. Le second modificateur permet de suivre l'occupation du cache et incite ainsi à ajouter plus de partitions dans le cache lorsqu'il y a de la place libre. La résolution réussie de cette tâche a permis d'accélérer l'algorithme PYRO de 10 à 40 % selon le jeu de données. Il convient de noter que l'algorithme PYRO est le plus performant dans ce domaine.
La figure ci-dessous montre les résultats de l'application de l'heuristique proposée par rapport à l'approche de base de mise en cache, qui est basée sur le lancer de dés. L'axe X est logarithmique.
Méthode alternative de stockage des partitions
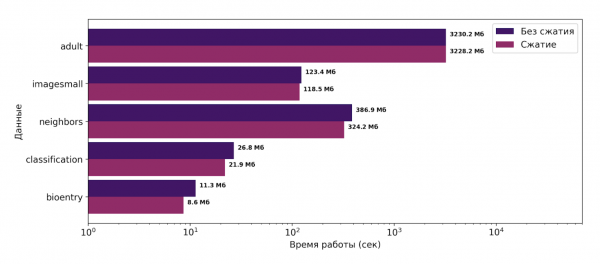
Nous avons ensuite proposé une méthode alternative de stockage des partitions. Les partitions représentent un ensemble de clusters, dans chacun desquels sont stockés les numéros de tuples ayant les mêmes valeurs pour certains attributs. Ces clusters peuvent contenir de longues séquences de numéros de tuples, par exemple, si les données du tableau sont ordonnées. Par conséquent, nous avons proposé un schéma de compression pour le stockage des partitions, à savoir le stockage par intervalles des valeurs dans les clusters de partition :
$$display$$pi(X) = {{underbrace{1, 2, 3, 4, 5}_{Premier~intervalle}, underbrace{7, 8}_{Deuxième~intervalle}, 10}}\ downarrow{Compression}\ pi(X) = {{underbrace{$, 1, 5}_{Premier~intervalle}, underbrace{7, 8}_{Deuxième~intervalle}, 10}}$$display$$
Cette méthode a pu réduire la consommation de mémoire lors de l'exécution de l'algorithme TANE de 1 à 25 %. L'algorithme TANE est un algorithme classique de découverte de dépendances fonctionnelles, il utilise des partitions pendant son fonctionnement. Dans le cadre de la pratique, c'est précisément l'algorithme TANE qui a été choisi, car il était beaucoup plus simple d'y intégrer le stockage par intervalles que, par exemple, dans PYRO, afin d'évaluer si l'approche proposée fonctionne. Les résultats obtenus sont présentés dans la figure ci-dessous. L'axe X est logarithmique.
Conférence ADBIS-2019
Suite aux résultats de la recherche en septembre 2019, j'ai présenté un article Lors de la 23e Conférence Européenne sur les Avancées dans les Bases de Données et les Systèmes d'Information (ADBIS-2019), Bernhard Thalheim, une figure marquante dans le domaine des bases de données, a souligné mon travail. Les résultats de ma recherche ont servi de base à ma thèse de maîtrise en mathématiques appliquées à l'Université d'État de Saint-Pétersbourg, au cours de laquelle les deux approches proposées (la mise en cache et la compression) ont été intégrées dans les deux algorithmes : TANE et PYRO. Ces résultats ont montré que les approches proposées sont universelles, car une réduction significative de la mémoire utilisée et du temps d'exécution des algorithmes a été observée dans les deux cas.
Source : habr.com
